
AgentHop: A Diagnostic Benchmark for Agentic Multi-Hop Question Answering over Scientific Citation Graphs
CoworkOS:Scaling Agent Coworkers for Real-world Automation
AttentionIndex: Accelerating Learned Sparse Attention with a Causal Inverted-File Index
LARK: Lean-Assisted Reasoning for LLM-Generated GPU Kernels
\textsc{ChatDify}: Automating End-to-End Dify Workflow Synthesis from Natural Language via Multi-Agent Collaboration
The Agent Said It Was Done. The Database Disagreed.
Welcome Le Chonk: Mistral Large 4 on Hugging Face
Deep Principle Releases Hydrogen-1.0: A 753B Open-Weight Model for Scientific Discovery
Deep Principle has released Hydrogen-1.0, an open-weight scientific model for chemistry, materials science and life sciences. It is built by post-training Z.ai’s GLM-5.3 on domain data, laboratory records and agent discovery trajectories. For developers, it offers open weights that report a FrontierScience-Research win over GPT-6-Astra. The weights ship under the MIT License.
TL;DR
- Size: 753B parameters (MoE, ~40B active per the GLM-5.3 base), 1M-token context, 128K max output.
- Runs on: 8 GPUs with SGLang (tested); NVFP4 for NVIDIA B200/B300, MXFP4 for AMD MI350X/MI355X.
- Performance: Beats GPT-6-Astra on FrontierScience-Research; roughly matches Kimi-K3 on GPQA-Diamond.
- Best: 38.3% on FrontierScience-Research vs 33.3% for GPT-6-Astra (self-reported).
- Worst: Trails GPT-6-Astra (max thinking) by 3.33 points on NMR structure elucidation.
What is Hydrogen-1.0?
Hydrogen-1.0 is a scientific research assistant model from Deep Principle, a Hangzhou-based AI-for-materials company. The model card describes it as a GLM-5.3 derivative for scientific problem solving. It targets question framing, experiment planning, results analysis and open-ended discovery. Deep Principle team states that proprietary models produced recent AI science results, but their discovery capabilities are not open. Hydrogen-1.0 is its attempt at a reproducible, inspectable alternative.
How was Hydrogen-1.0 trained?
The pipeline combines supervised fine-tuning (SFT) with reinforcement learning (RL). Data comes from 4 sources:
- Domain knowledge: chemistry, materials science and life sciences data.
- Research scenarios: task-specific feedback from Deep Principle scientists.
- Laboratory records: full-cycle electronic lab notebook records captured through Mira.
- Discovery trajectories: sequences of choices and feedback, including failed attempts.
Infrastructure builds on Megatron and SGLang across NVIDIA CUDA and AMD ROCm. The team keeps dynamic sparse attention causal across context-parallel shards. Muon optimizer state is moved between CPU, GPU and disk per backend. RL uses resumable rollouts, and each token keeps its original behavior log-probability for importance correction. A layout adapter converts training checkpoints into BF16 and 128×128 blockwise FP8 inference weights. Full datasets and recipes are not released.
How does Hydrogen-1.0 perform on benchmarks?
On public benchmarks, Deep Principle reports Hydrogen-1.0 outperforms GPT-6-Astra on FrontierScience-Research. The tweet thread from one of the founders’ report 93.0% on GPQA-Diamond. That improves on GLM-5.3 and roughly matches Kimi-K3, per the blog.
Internal research-task evals compare it with GPT-6-Astra at maximum thinking:
- Scientific computing: Hydrogen-1.0 leads by 5.13 percentage points.
- Forward reaction prediction: Hydrogen-1.0 leads by 4.76 percentage points.
- NMR structure elucidation: GPT-6-Astra leads by 3.33 points.
In transition metal complex design, models chased a larger HOMO-LUMO gap over 5 rounds. By round 5, Hydrogen-1.0 reached a mean best-so-far gap of 4.318 eV. GPT-6-Astra reached 3.689 eV and Kimi-K3 reached 3.353 eV. On 117 experiment-planning questions, Hydrogen-1.0 scored above Kimi-K3. GPT-6-Astra and Opus-5.5 were excluded after refusing more than 50% of requests.
&What can it do in a real lab workflow?
The technical post shows 4 demos. Hydrogen-1.0 writes Python to build a polyethylene melt and runs GROMACS. It detects a topology error, repairs it, and analyzes the corrected 40 ns trajectory. It grows an Ireland-Claisen reaction network of 27 structures through 30 plausible reactions. It ranks 7 candidate monoformylation products of 2-bromonaphthalene from a 1H NMR trace. It also writes a JSON protocol for a 12-vial Suzuki coupling study. A virtual lab compilation step catches an aspiration without a fresh tip before execution.
How do you deploy Hydrogen-1.0?
Weights are on Hugging Face and ModelScope. Deep Principle team tested BF16 serving with SGLang on 8 GPUs using tensor parallelism of 8. NVFP4 targets NVIDIA B200 and B300. MXFP4 targets AMD Instinct MI350X and MI355X. The server exposes an OpenAI-compatible API with a reasoning_effort setting.
Hydrogen-1.0 vs GLM-5.3, Kimi K3 and GPT-6-Astra
| Feature | Hydrogen-1.0 | GLM-5.3 | Kimi K3 | GPT-6-Astra |
|---|---|---|---|---|
| Developer | Deep Principle | Z.ai | Moonshot AI | OpenAI |
| Total params | 753B | 753B (HF) | 2.8T | Not disclosed |
| Active params | ~40B (inherited) | 40B (LM Studio) | 16 of 896 experts | Not disclosed |
| Context | 1M | 1M | 1M | 1.05M |
| Weights / license | Open, MIT | Open, GLM-5.3 License | Open | Proprietary |
| Modality | Text | Text | Text + vision | Not disclosed here |
| Science focus | Chemistry, materials, life sciences | Coding, agents | General | General |
| FrontierScience-Research | 38.3% | Not disclosed | Not disclosed | 33.3% (per Deep Principle) |
| GPQA-Diamond | 93.0% | Not disclosed | Not disclosed | 96.0% (OpenAI-reported) |
| API price (in/out per 1M)< |

Here are some the internets best Halloween costumes
If you're an adult, you're probably not going to spend your night getting candy from strangers, but that doesn't mean Halloween can't be magical for you as well. Whether you're going to a costume party or taking your own kids trick-or-treating, there are plenty of good reasons to dress up tonight, and plenty of great costume ideas floating around social media.
Here are some of our favorite costumes, either because they're creative or funny or just incredibly well executed:
A throwback to one of the greatest children's shows of all time
This Tweet is currently unavailable. It might be loading or has been removed.
The Total Drama Island fit we didn't know we needed
This Tweet is currently unavailable. It might be loading or has been removed.
The Godfather of Soul himself
This Tweet is currently unavailable. It might be loading or has been removed.
So cute you could eat them
This Tweet is currently unavailable. It might be loading or has been removed.
And the streamers went all out
This Tweet is currently unavailable. It might be loading or has been removed.
An homage to Willem Defoe
This Tweet is currently unavailable. It might be loading or has been removed.
The Silver Surfer rides tonight
This Tweet is currently unavailable. It might be loading or has been removed.

REA「逆向一切」实测:Gemini 4 Argon和GLM 5.3 复刻故宫名画记,细节决定还原度
逆向工具可以帮模型找出软件的结构与行为,但哪些功能该保留、哪些细节不能省,仍要由模型判断。 作者丨吴海明
编辑丨李娜 岑峰

01
软件已死?AI开始逆向复刻显示世界
“Software is done.(软件已死)。”
10 月初,知名 AI 科技博主 Matthew Berman 在 X 上留下这句惊叹,将一款名为 REA(Reverse Engineer Anything)的开源逆向分析工具推上了风口浪尖。

REA(Reverse Engineer Anything)是 10 月 GitHub 上最热的项目之一,它的可怕之处在于,它为 AI Agent 赋予了“反汇编”的视野,将 AI 编程的目标直接扩展到了现成软件。 它把二进制、应用与运行行为的分析能力,通过统一接口交给 Agent:原生程序可接 Ghidra、IDA、Hopper 等引擎,网页则可检查结构、脚本、网络与截图。分析结果附带证据和已知限制,供模型追查。

它吸引人的地方,是把研究现成软件接进了编码会话,使开发者看到一个功能,可以要求 Agent 调查组件与(雷峰网)行为,再把发现写进实现规格。这使得过去要人工来回传递的材料,在现在有机会在同一任务里继续使用。
这极大地降低了逆向工程的门槛。10 月 16 日,Perplexity 联合创始人兼 CEO Aravind Srinivas 宣布把 REA Skill 集成进 Computer,并给出体验额度,这使得逆向分析开始被当作 Agent 产品的功能之一;紧接着就有开发者演示如何用 Codex 与 REA 重建了功能接近完整的 Claude Slides 编辑器。


狂欢之中也不乏冷水。有媒体和行业观察者尖锐地指出:查出线索,和完美重建一个能长期维护的软件,中间还隔着一条巨大的鸿沟。这会不会又是一场“AI 幻觉”?

02
Omniprediction for All Mixable Proper Losses and Beyond
Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention
[分享发现] 终于轮到我被封号了,顺便问下 argon
两个 Claude 老号,网络环境一直很稳定,pure 检测全绿。去年年底一直用到现在都没事。
过了个周末,早上来两个号都被干了。
问一下大伙 Gemini 前端设计和思考能力怎么样,我现在有 codex pro20x 和 glmmax 订阅 这俩干活还行,搞页面和设计审美实在太拉胯了。 argon 有没有实测过的
[推广] 受不了官方 Claude 的价格和封号,自己搭了个聚合中转,分享下
起因就是官方 Claude / ChatGPT 的 API 又贵、又要国外卡、挂 agent 跑一跑额度就见底,还时不时风控。干脆做了个聚合中转自用,现在开放出来。
几个我觉得有用的点:
一个 key 调 80+ 模型,Claude / GPT / Gemini / Grok 和国产的 DeepSeek / Kimi / GLM / Qwen 都在。保留原生协议,代码只换 base_url 和 key ,不用改。
OpenAI 兼容: https://api.kevoryn.com/v1
Anthropic 原生: https://api.kevoryn.com (客户端补 /v1/messages)
Gemini 原生: https://api.kevoryn.com (客户端补 /v1beta)
分组按渠道质量分层,官方直连贵但稳,特价/第三方渠道便宜,按需求选。价格和官方价对照在 kevoryn.com/model-plaza ,文档 kevoryn.com/docs 。
按量计费没月费。支持 Claude Code 、Codex 、Gemini CLI 这些,也接了 CC Switch 一键导入。
主要想听听大家对这类网关还想要什么功能,有问题回帖

天数智芯天垓300实测对标H200,国产GPU接下来拼什么?
在实测场景中达到H200的性能水平后,国产GPU的竞争,开始进一步转向系统效率、软件适配与实际交付。
本周的天数智芯媒体开放日上,最新一代天垓300与H200的实机对比,是最直观的性能展示。让GPU与专用芯片组成异构系统,是对推理效率的新探索。软件栈引入Agent与Skills,则试图解决客户部署、适配和优化的工程难题。
天数智芯表示,今年完成的一组第三方测试中,在典型PD分离部署下,天垓300折算单卡端到端吞吐达到H200的1.05倍。这表明国产通用GPU在特定高端推理负载中,已经拥有与H200直接竞争的性能基础。

但从性能接近到客户采购,再到持续扩容,中间仍隔着系统效率、软件适配和稳定交付。当硬件具备竞争力,国产GPU怎样把这种能力转化为客户持续使用的理由?当推理催生更多专用芯片,通用GPU的独特价值是什么?
从云端天垓300到端侧彤央系列,天数智芯也在拓展产品布局,将竞争延伸到不同形态的算力需求中。
天垓300对比H200实测,性能小幅领先
过去很长一段时间,峰值算力是国产AI芯片受到关注的重要指标。但对最终用户而言,设备每秒真正产出多少有效Token,比参数表上的理论算力更接近采购决策。
天数智芯披露的第三方测试覆盖四大主流模型、三类场景。其中,1.05倍指典型PD分离部署下,折算单卡的整体端到端吞吐,反映的是特定模型与部署条件下的系统表现。

另外,根据天数智芯性能实验室的数据,在GLM-5.3的64K长上下文场景下,保障同等用户体验时,天垓300的MoE吞吐达到H200的1.15倍。在8K至128K长上下文的Agent场景中,首字延迟较H200降低约10%至30%。

前者关系到系统能够承接多少请求,后者关系到用户发出请求后需要等待多久,它们对应不同工作负载与性能指标。
天垓300能够在这些场景中取得性能领先,一个关键是针对实际负载进行了架构优化。
基于天枢架构的天垓300,单卡显存容量达到144GB,并围绕Attention、MoE等计算环节进行优化。长上下文需要容纳更多状态,也增加了Attention计算压力。MoE虽然通过激活部分专家控制计算量,却带来了小规模矩阵计算、专家分配和数据交换等新问题。
为此,天垓300让Tensor Core与Vector Core并行处理Attention中的矩阵运算和Softmax等向量操作,同时针对MoE中的小规模矩阵、低精度计算与通信协同进行优化。

这些针对性设计,有助于减少不同计算环节之间的等待,把更多硬件资源转化为实际产出。

此次披露的测试与现场演示,展现了天垓300进入高端推理实际竞争区间的能力。对客户而言,下一步要比较的,是在同样的响应要求下,系统能承接多少请求、持续运行表现如何,以及需要付出多少设备、电力和运维成本。
推理需求催生专用芯片,GPU的价值会被削弱吗?
随着推理需求快速增加,以LPU为代表的专用推理芯片备受关注,不同计算环节对硬件的要求也进一步分化。
Prefill处理输入,通常更偏向计算密集型任务;Decode逐步生成Token,更容易受到访存、任务启动和同步开销的影响。进一步拆开,Attention与FFN对计算、带宽和存储的需求也不相同。
当某类任务足够稳定、规模足够大,专用芯片就有机会通过针对性设计,获得更好的性能或能效。让一种通用GPU处理所有环节,未必始终对应最低的成本。
天数智芯展示的AFD分离方案,就是对这种分工的回应。
它在Prefill与Decode分离的基础上,继续拆分Decode阶段的Attention与FFN:天垓300承担Prefill全流程计算,以及Decode中的Attention;合作厂商的XPU承担FFN专家网络计算。

运行过程中,GPU把中间激活数据发送给XPU,XPU完成计算后返回结果,继续推进模型生成。天数智芯给出的对比结果显示,在所展示的方案中,Decode推理延迟降低60%。

天数智芯AI与加速计算负责人单天逸表示:“未来的AI算力系统,不一定由一种芯片包打天下。关键是如何把它们高效组织起来,让整个系统发挥更大的价值。”
异构分工为不同芯片提供了合作空间,GPU的通用性则关系到系统能否持续适应模型变化。

天数智芯副总裁邹翾对雷峰网表示,专用硬件可以在固定工作负载中实现较大的性能提升,但模型与算法仍在快速迭代,公司坚持以通用框架为基础,结合专用加速能力。


一天造300万个沙盒,10万张卡自己写系统:2026年国产 RSI 到底有多野?
国产 RSI 的真实水位:没人敢真动模型权重,但所有人都在改 "造 AI 的机器"。 作者丨高允毅
编辑丨岑 峰
RSI,即 AI 造 AI,成为了 2026 年各家模型厂商争相晒的内部成绩单,也是国内一级市场最热的方向之一。只要BP带上 "Self-Training" 的字眼,估值至少多两成。
但真正的 RSI ,不止是 AI 改进 AI ,它还得把经验沉淀下来,让学习方法本身跟着进化。
今年 9 月,上海交大、清华、字节、商汤等机构的 35 位研究者发了篇论文《The Last AI Built by Humans》,给整个行业立了把标尺,它 RSI 分 L1 到 L5 五层,结论令人扎心:
全球前沿大厂的系统大多处于 L1 到 L2 的过渡阶段,L3、L4 在特定垂直领域(如软件工程、科学发现)有零星雏形,而真正的 L5 闭环仅存在于极少数受限的实验室原型中。

如果用这把尺子去丈量九、十月份国内模型厂商晒出的RSI实验成果,包括训练流程、推理系统、 GPU 算子、 Agent 脚手架;但目前没有一家厂商敢去用AI真正改写底层模型权重。也就是说,目前大家距离传说中的“AI 自己发明下一代 AI(L5)”,甚至连门槛都还没摸到。
那么在这场RSI热潮中,国内各大厂与明星创业公司究竟各自卡在了什么生态位?他们分别在让 AI 改进什么、做到哪一步了?以下我们梳理了国内模型厂商最新 RSI 情况。


01
智谱 RSI :跑在 10 万张国产卡上,
能自我优化的推理系统
智谱是国内首个把 RSI 真正跑进生产环境的案例。它的 RSI 第一步没碰模型权重,先落在了最脏最累的底层推理系统上;跑通之后,智谱又把目光放到了 Agent 的 Harness上。前者降本,后者增效,全是实打实的工程活。
先说推理基础设施。一个新模型要真给用户用起来,中间隔着一大堆脏活累活,怎么榨干芯片的算力,怎么把庞大的任务拆分给成千上万张卡同时跑,怎么高效管理对话时产生的海量临时数据等等,这些事过去是 Infra 工程师一行一行调出来的。
智谱这次直接让 GLM-5.3 驱动的“Infra Agent”接管了这一切。9 月 17 日,唐杰在 X 上发了一篇长文《通往递归自我改进》,表示由 GLM-5.3 驱动的 Infra Agent,在 10 万张国产芯片组成的集群上,仅用两周就从零搭起了 GLM-5.3-Flash 的生产级推理服务。
PPTV创始人再创业做“算力版滴滴”,日均消耗token超万亿,却难赚到钱?
(本文作者为 创业最前线,钛媒体经授权发布)
文 | 创业最前线,作者 | 于莹,编辑 | 王亚静
当AI大模型开始收费,卖Token的“工厂”逐渐成为市场最“吸金”的AI赛道之一。
在海外,被黄仁勋称为“AI工厂的台积电”的Fireworks AI7月拿到15.05亿美元融资,估值升至175亿美元;在国内,10月12日,上海AI Infra(人工智能基础设施)企业无问芯穹确认已完成23亿元C轮融资,累计融资额达43亿元。
资本追捧之下,做Token“工厂”的企业,开始走向大众视野,硅基流动、派想未来等企业纷纷向港交所递交上市申请。
其中,派想未来的创始人是曾创立了PPTV的“80后”学霸姚欣,他在退出ppvt后,在AI算力爆发前悄悄布局了算力赛道。
派想未来是一家独立分布式云计算服务商,业务始于边缘云计算服务领域,2025年营收已经达到7.7亿元。按灼识咨询口径,公司是中国最大的独立AI云计算服务商。
不过,公司至今尚未盈利,经营现金流也呈现净流出状态。而在可转股的条件压力下,公司上市需求十分迫切。
只是,这门在资本市场陆续拿到“大结果”的Token生意,底色究竟如何呢?
1、打造token工厂,要做“算力版滴滴”
通俗来说,Token工厂就是专门规模化生产推理服务的“车间”,把电力、芯片、模型和数据,持续转化为可计量、可调度、可定价的模型调用能力。
而一般的传统云计算巨头,主要是“中心化大厂”逻辑,在全国建几个超级数据中心,通过长途光纤把算力输送给用户。这种模式,在需要超低时延、海量并发的5G和智能化时代,容易遇到物理瓶颈。
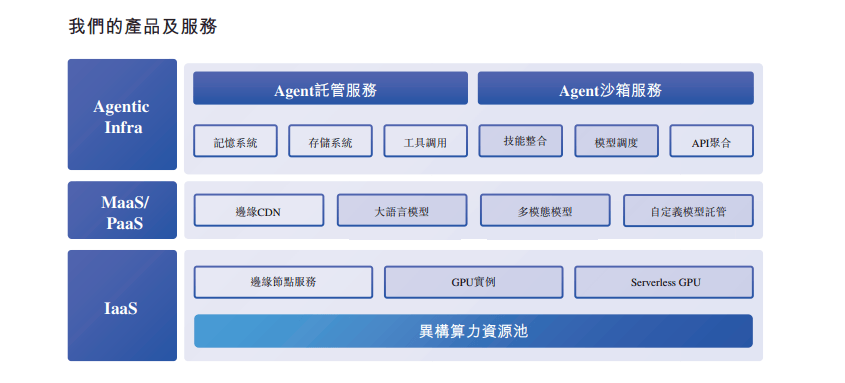
与阿里云、腾讯云等公有云平台不同,派想未来并非自建数据中心,而是通过“蜂群思维”搭建起中国最大的分布式算力网络。
公司发现,社会上存在大量分散、闲置、异构的第三方闲置算力资源,海量的算力需求与分散且尚未充分利用的算力供给之间存在重大错配。
所以,公司搭建了算力调度平台,把它们当成“私家车”,汇聚和管理异构资源的闲置算力,以最优方式向客户部署,从而加速内容传输及提升低延迟计算体验。
在接受采访时,创始人姚欣将公司比作“算力版滴滴”,称公司不采购、不持有大规模GPU服务器与数据中心,不自主搭建自有智算园区,全部算力资源向外采购整合,再通过自研分布式调度系统匹配供需。
(图 / 招股书)

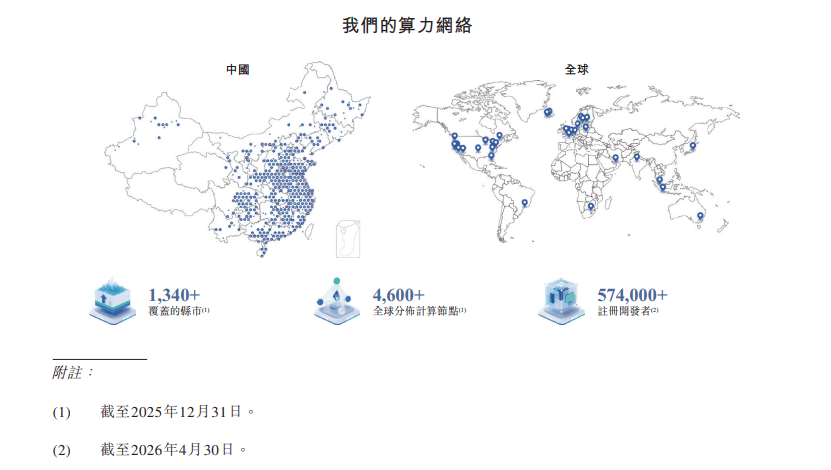
可以说,派想未来的核心资产不是硬件,而是一套极度聪明的分布式云计算架构和统一调度平台。正是通过这种调度能力,公司把全国1340多个县市的4600多个闲置节点盘活,成功构建起了一个边缘算力网络,把算力直接下沉到网络的最边缘。
(图 / 招股书)
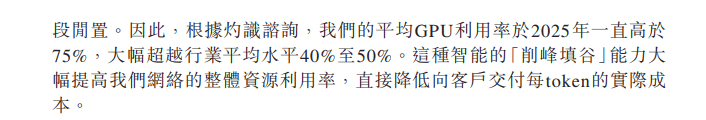
这种“轻资产、重调度”的模式,在2023年撞上了大模型爆发的超级风口。招股书显示,公司通过分布式调度后,GPU利用率在2025年一直超过75%,远高于行业40%-50%的平均水平,模型推理成本理论上可以下降超过80%。当AI时代来临的时候,这种优势被放大。
(图 / 招股书)
而打造派想未来,并非是姚欣的首次创业。
2004年,正在华中科技大学读研一的姚欣,为了解决同学们在宿舍看球赛直播卡顿的痛点,敏锐地捕捉到了P2P技术“人越多越快”的特性,索性休学创办了PPTV的前身PPLive。
在那个宽带和分发基础设施极度匮乏的互联网黄金年代,PPTV一度坐拥4.5亿全球用户,成了仅次于优酷的全国第二大视频平台,2014年PPTV最终被苏宁集团收购。
2018年,姚欣与当年的老搭档、华科学弟王闻宇再度联手,成立了派欧云计算(上海)有限公司(以下简称派欧云,派想未来在中国的合并联属实体之一),如今一起带领着派想未来冲刺资本市场。
招股书显示,IPO前,姚欣及其配偶吕姗姗,通过数家实体合计控制约48.05%的股份投票权;王闻宇间接持股10.17%,其他投资者包括Millennium、IMO Ventures、CCV Fund、华业天成、磐霖、沸点等。
2、营收2年翻倍,但为何越卖越亏?
目前,派想未来的商业模式采用云计算的收费模式,即按算力使用量或使用时长计费,主要付费客户包括大型互联网企业,以及中小型AI创业企业。
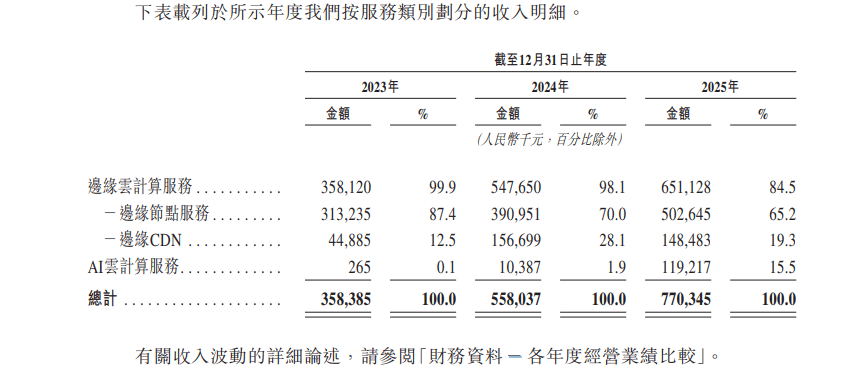
2023年至2025年(以下简称报告期内),公司收入从3.58亿元迅速增长至7.70亿元,复合年增长率达46.6%。
其中,边缘云计算服务收入(包括边缘节点服务、边缘CDN)分别为3.58亿元、5.48亿元、6.51亿元,长期占据总收入84%以上。
而AI云计算服务收入从2023年的26.5万元暴涨至1.19亿元,2025年同比增长超过10倍,占比提升至15.5%,成为招股书重点渲染的第二增长曲线。
(图 / 招股书)
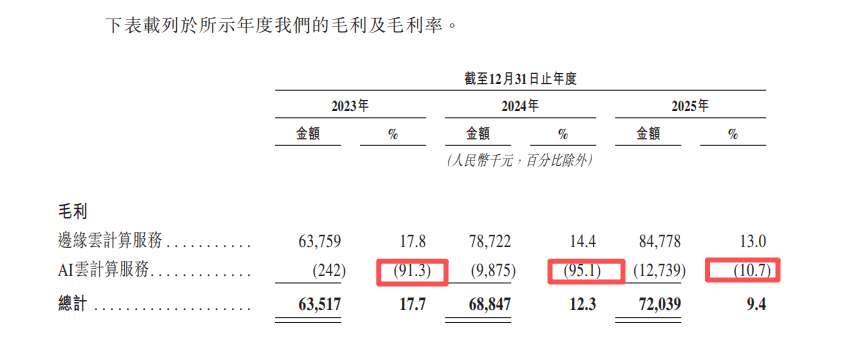
营收高增,毛利率却明显下滑。报告期内,其综合毛利率从2023年的17.7%滑落到2024年的12.3%,再到2025年的9.4%,近乎腰斩。
(图 / 招股书)
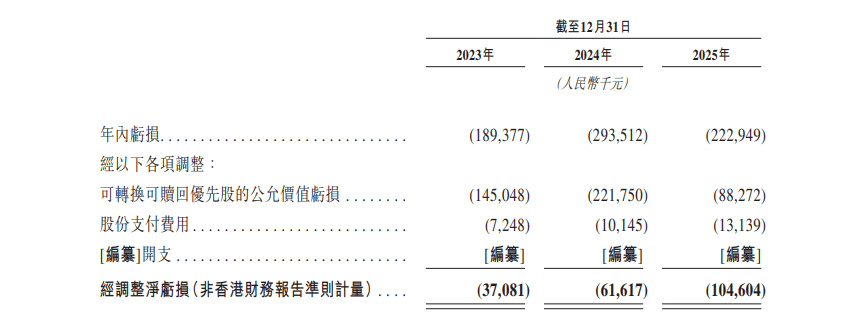
在这背后,公司一直深陷亏损之中。报告期内,其净亏损分别为1.89亿元、2.94亿元和2.23亿元。如果剔掉可转换可赎回优先股公允价值变动等非现金项,经调整净亏损仍从0.37亿元扩大到1.05亿元,陷入了“卖得越多,亏得越多”的境地。
(图 / 招股书)
造成亏损的根源,主要出在公司快速增长的AI云计算业务上。
2025年,其AI云计算毛利率为-10.7%,而2023年、2024年则分别为-91.3%和-95.1%,虽然毛利率亏损收窄,但至今仍是一笔“亏本买卖”,而其收入占比越来越高,拖累了整体毛利率表现。
「创业最前线」了解到,公司边缘云业务,主要是把算力放到离用户最近的地方,专门给视频、直播、文件下载做加速(也就是边缘CDN)。
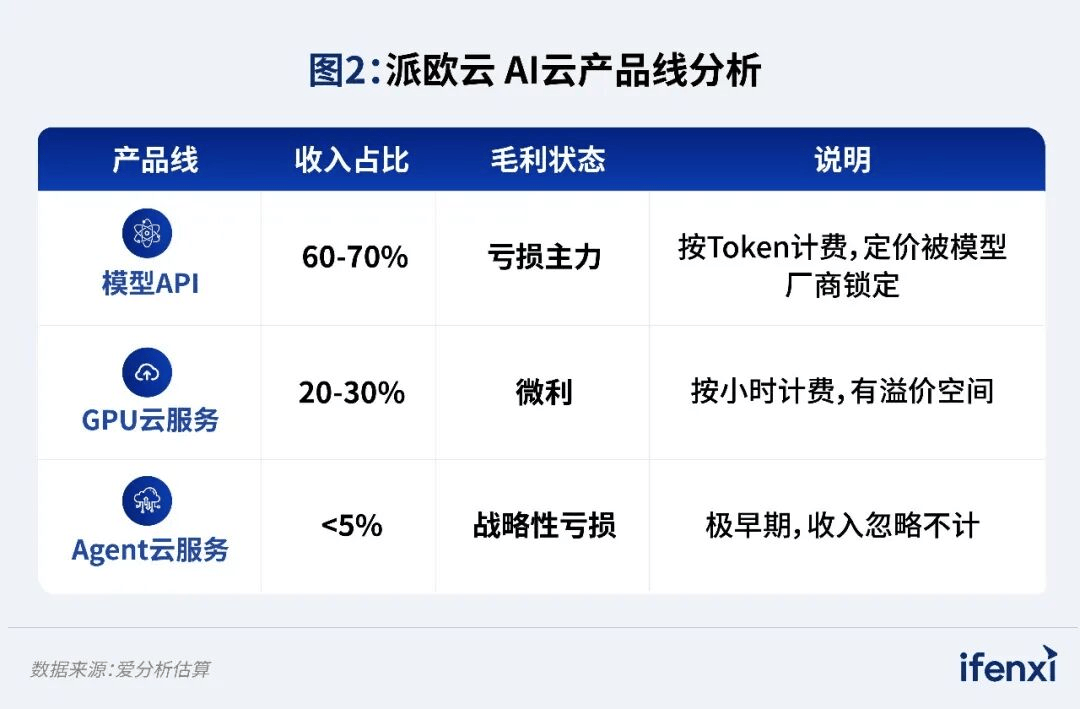
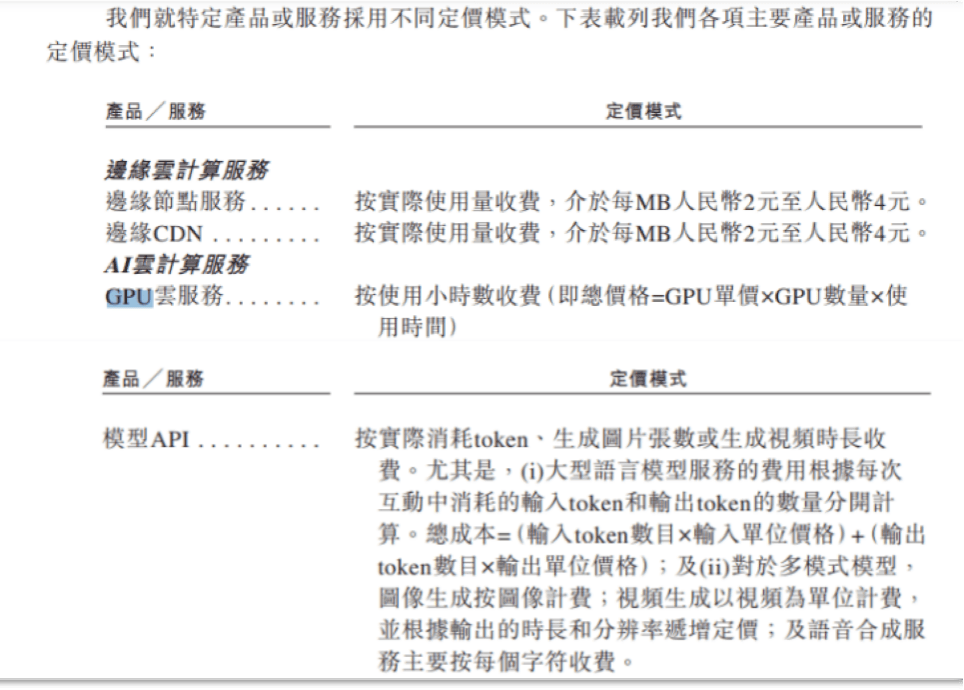
而AI云业务,则提供的是GPU算力和现成大模型接口(MaaS),客户不用自己买显卡、搭环境就能跑AI推理。但这块收入,主要来源于模型API,其为客户调大模型、按Token收费。
但Token价格并非为派想未来所定,而是模型官方定价。根据爱分析的报道,派欧云的定价页面和DeepSeek、GLM、Kimi等官方API文档定价一致。
(图 / 爱分析(上)、招股书(下))
原因在于,定价权在模型厂商手里。Token API是同质化商品,用户切换Token供给方的成本、门槛极低。因此,即使大模型厂商的推理算力供给不足,派想未来也难以溢价收费。
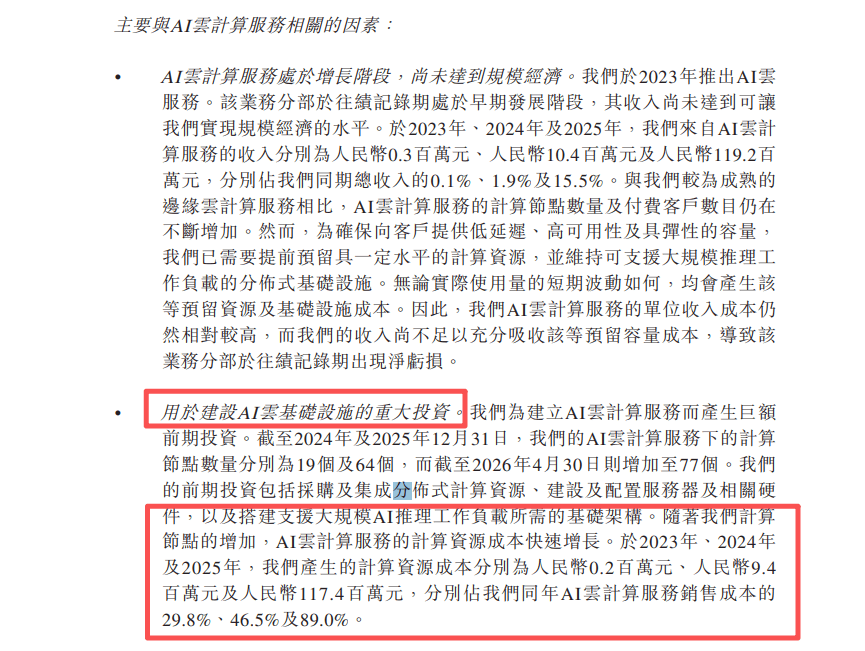
而在成本端,派想未来的GPU算力多是租赁而来,2025年GPU资源成本1.17亿元,几乎追平了整体的AI云收入(1.19亿元)。可以说,公司每多提供一个Token,就要多付一笔GPU租金。
(图 / 招股书)
从这点看,虽然公司把自身比喻成“算力版滴滴”,但滴滴的抽佣定价权在自己手里,而派想未来上游是掌握定价权的模型厂商,下游是可以一键切换的客户,两头都被挤压。
不过,需求端确实是十分紧俏,公司披露的日均Token消耗早已破万亿,说明市场确实存在广泛需求,只是需求旺盛并不等于赚钱能力,公司的利润空间尚未打开。
在招股书中,公司也提示:“随着对公司产品及服务的使用量增加,客户可能要求降低定价,部分客户可能出于商业、合规或其他原因选择使用其他云服务提供商。为此,公司为维持或增加收入,或需要在销售及营销方面投入更多的支出,这些都会对公司的毛利率产生不利影响。”
可见,公司的低毛利率并非一时阵痛,是这套“租卡—转售Token”模式的天然限制。另外,算力中介赛道门槛低、同质化严重,派想未来若想突围并不容易。
3、上市倒计时,仅剩两个月时间
值得注意的是,公司的经营命脉,压在极少数大客户身上。
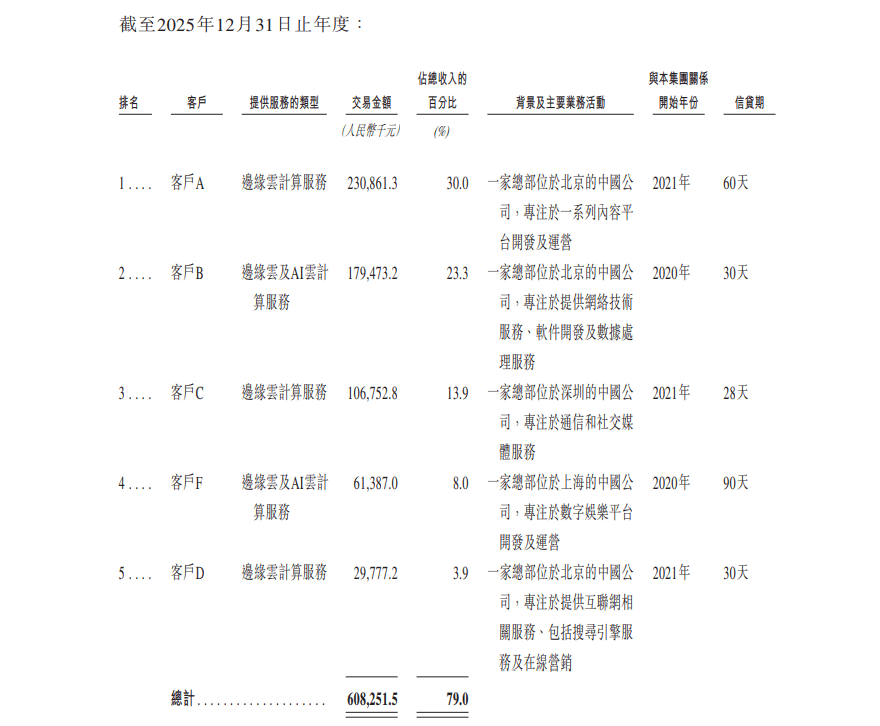
2023至2025年,公司的前五大客户收入占总营收比重分别达92.5%、89.5%、79.0%,营收高度依赖大客户。
(图 / 招股书)
面对大客户,派想未来的回款周期较长,导致公司经营现金流持续为负。
招股书显示,公司通常向边缘云计算服务客户授予一至三个月的信贷期,2023年至2025年,贸易应收款项分别为0.9亿元、1.5亿元、1.68亿元。
同期,贸易应收账款周转天数分别为83天、79天及75天。报告期内,贸易应收款项中分别有93.6%、88.1%及74.9%为应收五大客户款项。
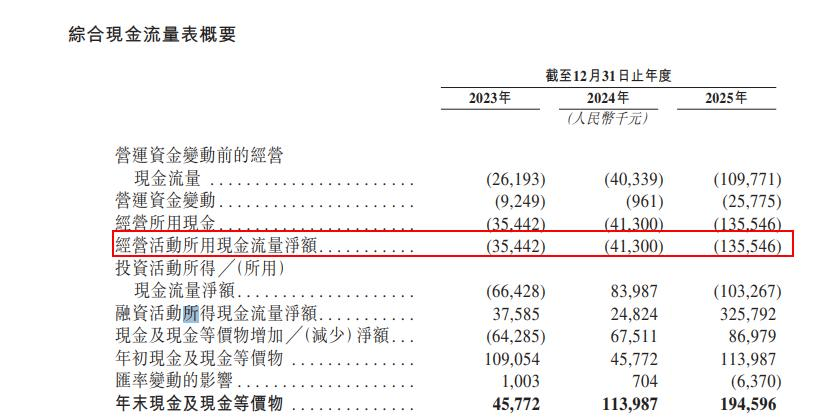
而从客户收取按使用量计算的费用,与向供应商付款之间通常存在时间差,从而导致潜在的经营现金流错配。报告期内,其经营现金流净额分别为-0.35亿元、-0.41亿元、-1.36亿元。
(图 / 招股书)
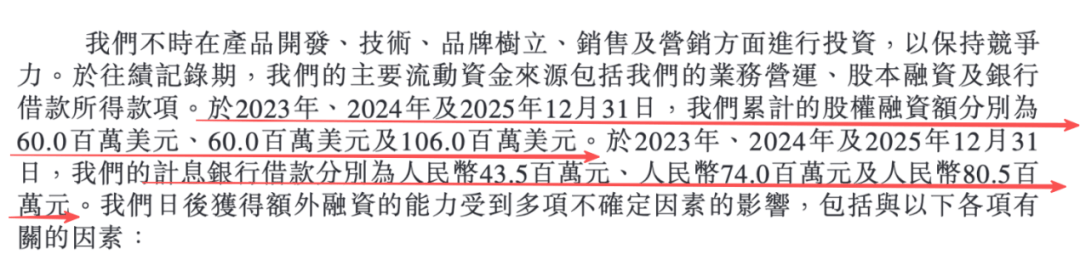
而公司运营颇为依赖融资。2023年至2025年,其累计股权融资额分别为0.6亿美元、0.6亿美元及1.06亿美元,计息银行借款分别为0.44亿元、0.74亿元及0.81亿元,逐年攀升。
(图 / 招股书)
此次港股IPO,公司拟将募资用于,提升公司于分布式云计算服务的技术能力及升级AI云计算服务;海外扩张,特别是在成熟市场及潜力尚未开发的新兴市场;战略投资及收购;营运资金及一般企业用途。
除了营运资金的压力,目前派想未来着急上市的原因,还有来自于悬在头顶的“赎回压力”。
招股书显示,派想未来的背后站着蓝驰创投、创世伙伴、华业天成等投资机构,以及早期重仓的百川智能王小川、前微软Azure中国区总裁申元庆、元气森林唐彬森。
从2021年天使轮后的4600万美元估值,到2025年B轮融资后的4.69亿美元,再到2026年5月底6月初刚完成的B-2轮,派想未来的投后估值已经达到5.76亿美元。
融来的钱虽然撑起了业务扩张,但也可能变成到期要还的债。当初为它背书的投资天团,此刻也正是手握赎回权的人。
2023年至2025年,公司分别录得可转换可
一夜之间,GPT-6.2 Astra 和 Fable 5.5 双双曝光,AI 圈疯狂 11 月要来了
刚进入 11 月,AI 圈又开始热闹起来了。
过去十几个小时里,Anthropic 和 OpenAI 接连传出新模型消息。有人在 Anthropic 官网源代码中发现了 Claude Mythos 5.5 的名字,还有开发者晒出疑似 Claude Fable 5.5 生成的 3D 游戏和交互作品。
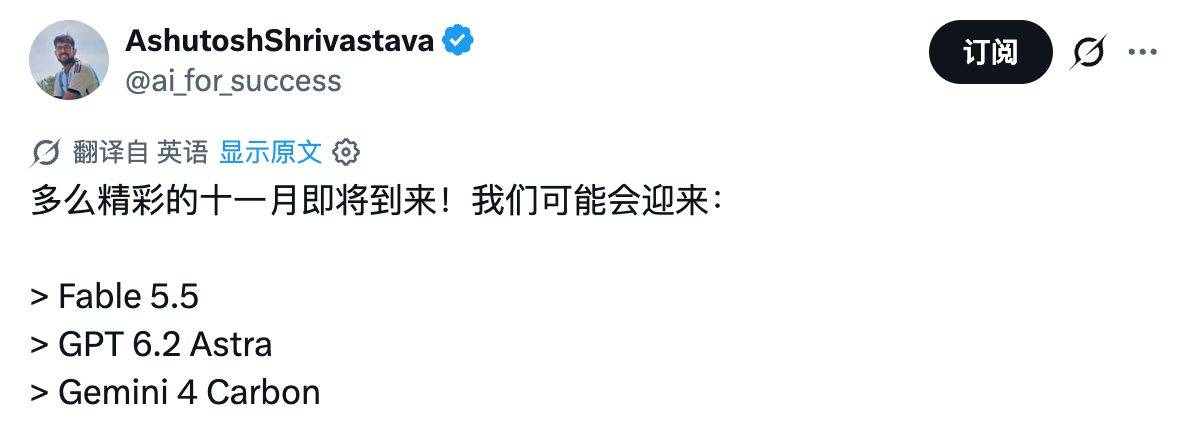
另一边,OpenAI 尚未官宣的 GPT-6.2 Astra,也出现在部分用户的 Codex 使用统计和 API 响应记录中,甚至有人声称已经成功调用。
两家公司的新模型线索几乎同时出现,结合此前关于 Qwen4、GLM-5.5 和 Hy4 的传闻,也让 AI 社区开始猜测,11 月是否又会迎来一轮旗舰模型集中更新。
Claude 5.5 官网意外曝光,新模型要来了?
事情要从 Anthropic 官网的一次意外发现说起。
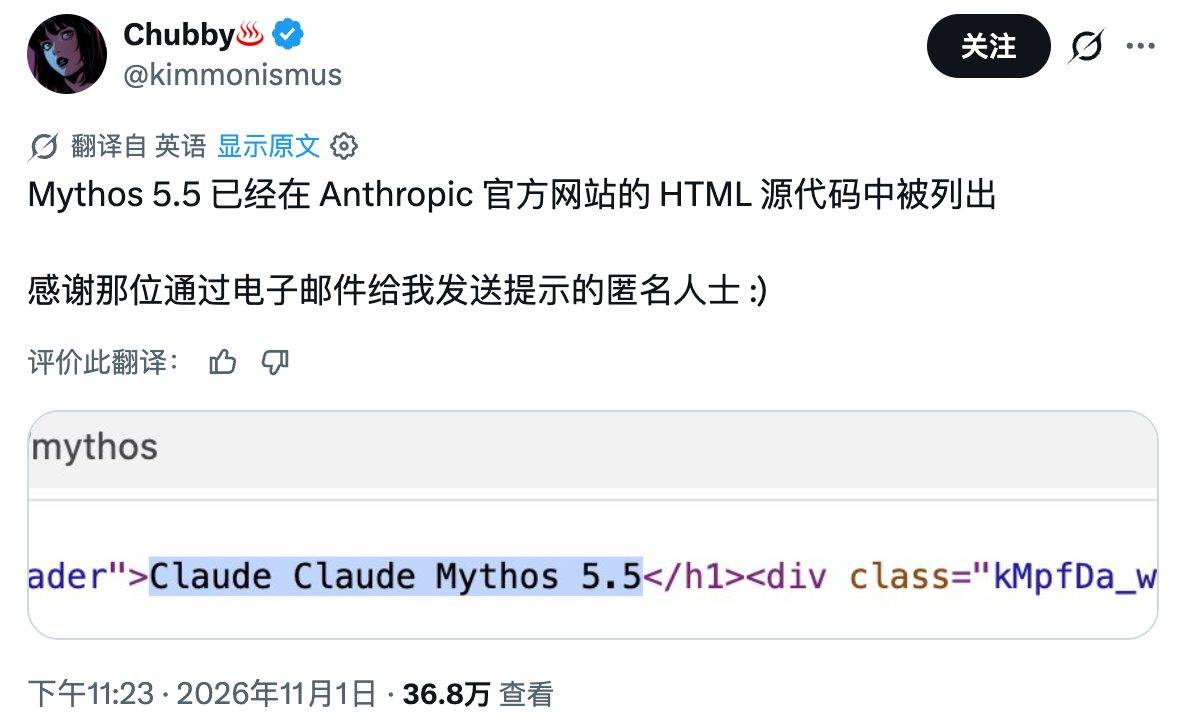
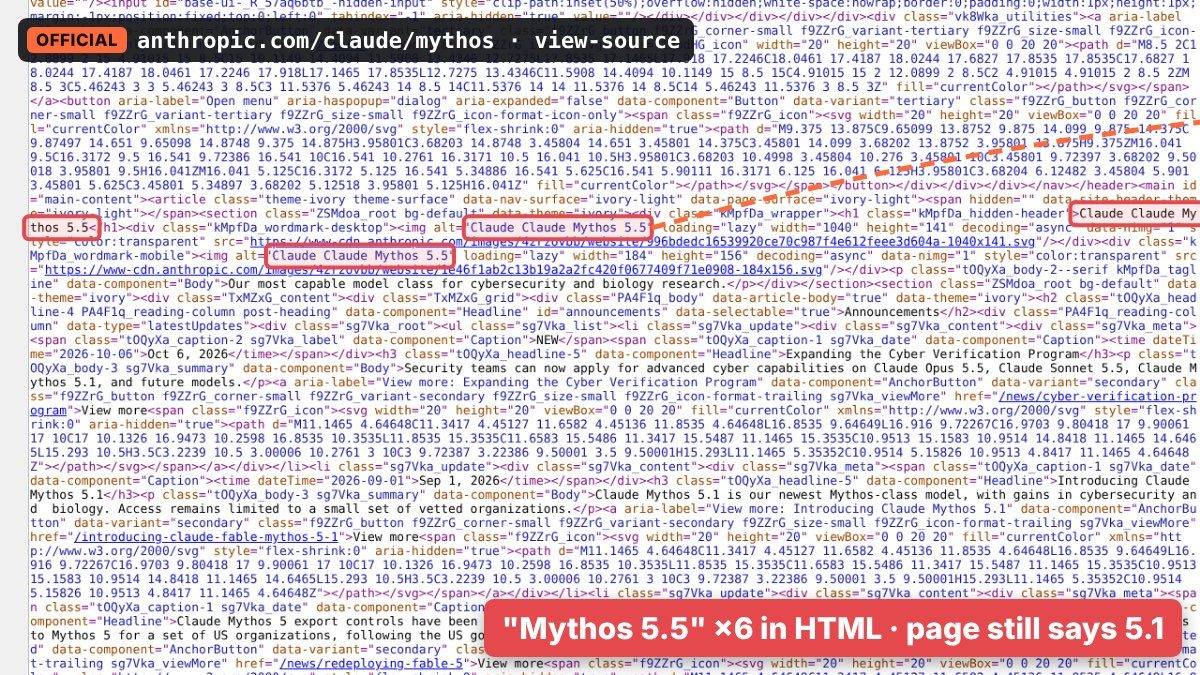
11 月 1 日深夜,科技博主 @kimmonismus 在 X 平台发帖称,Anthropic 官方网站的 HTML 源代码中,出现了尚未正式公布的 Claude Mythos 5.5。
根据截图,Anthropic 的 Mythos 产品页面中,隐藏的 H1 标题以及图片的 alt 属性,都包含 Mythos 5.5 字样。
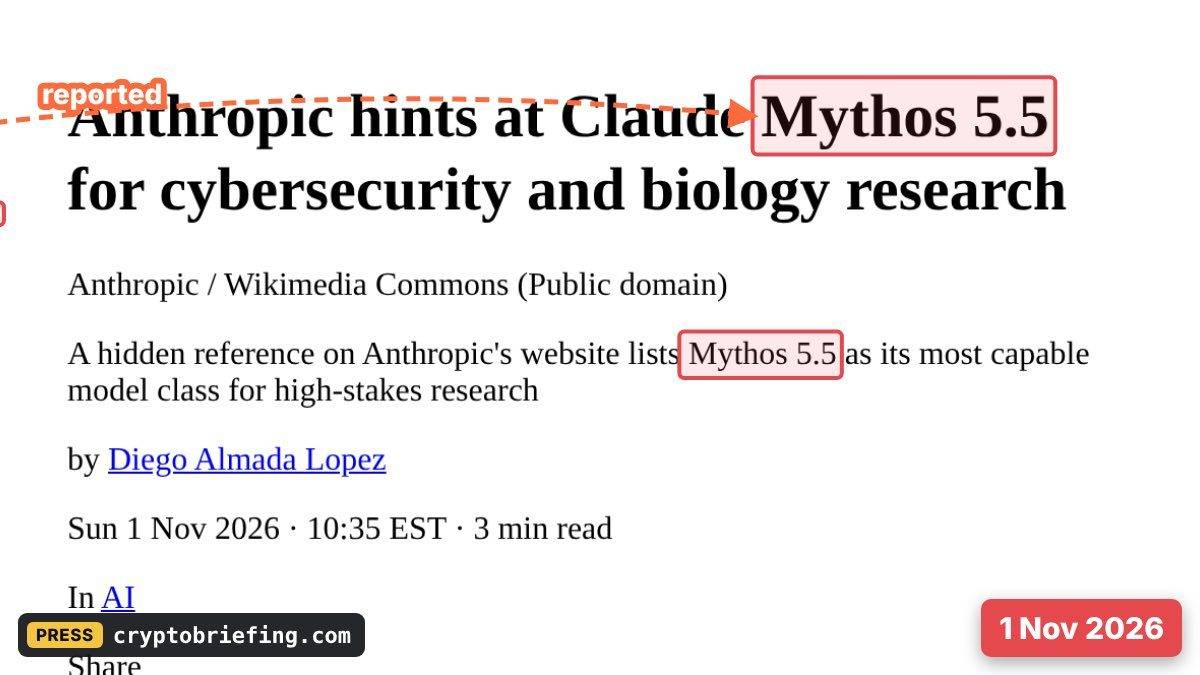
随后,科技媒体 TestingCatalog 也关注到这一变化,并推测 Anthropic 可能正在筹备新一代模型。
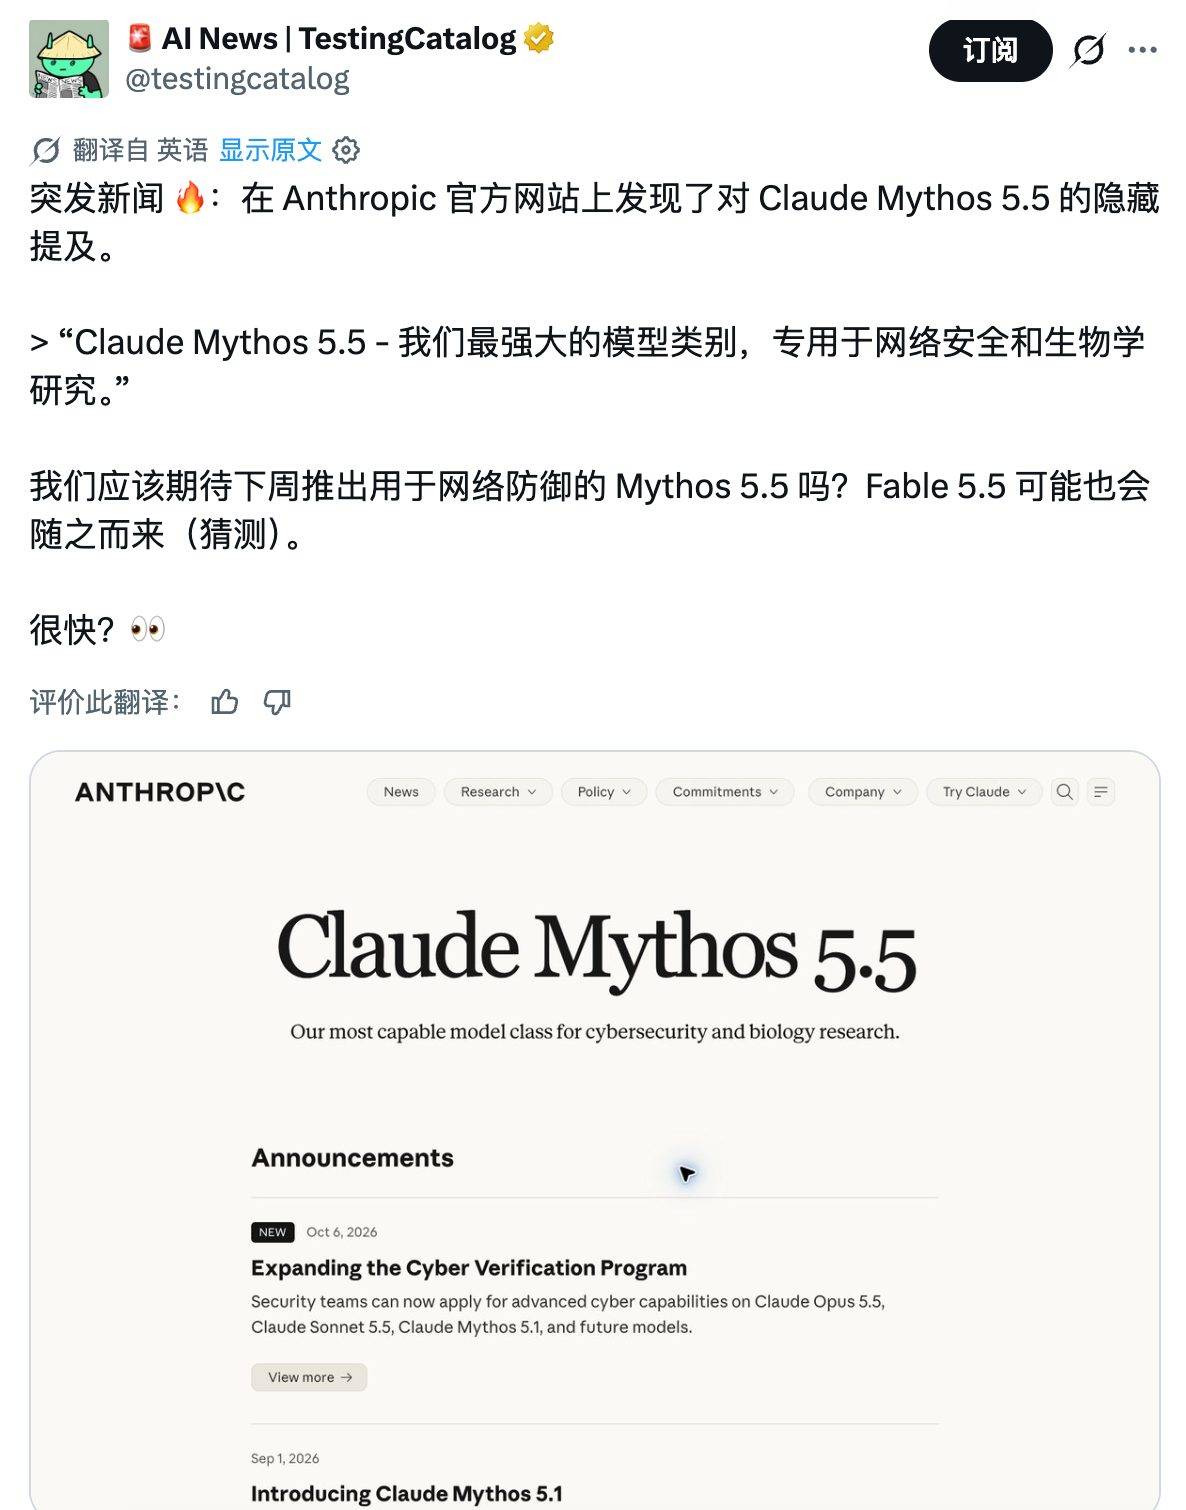
对于不熟悉 Anthropic 产品线的读者,可以简单理解为,Mythos 主要面向网络安全和生物学等高风险研究领域,访问权限受到严格限制;Fable 则在相同底层模型基础上加入安全防护,面向更广泛的用户提供服务。
因此,Mythos 5.5 的名称意外现身官网,也让外界开始猜测,面向普通用户的 Fable 5.5 是否即将登场。
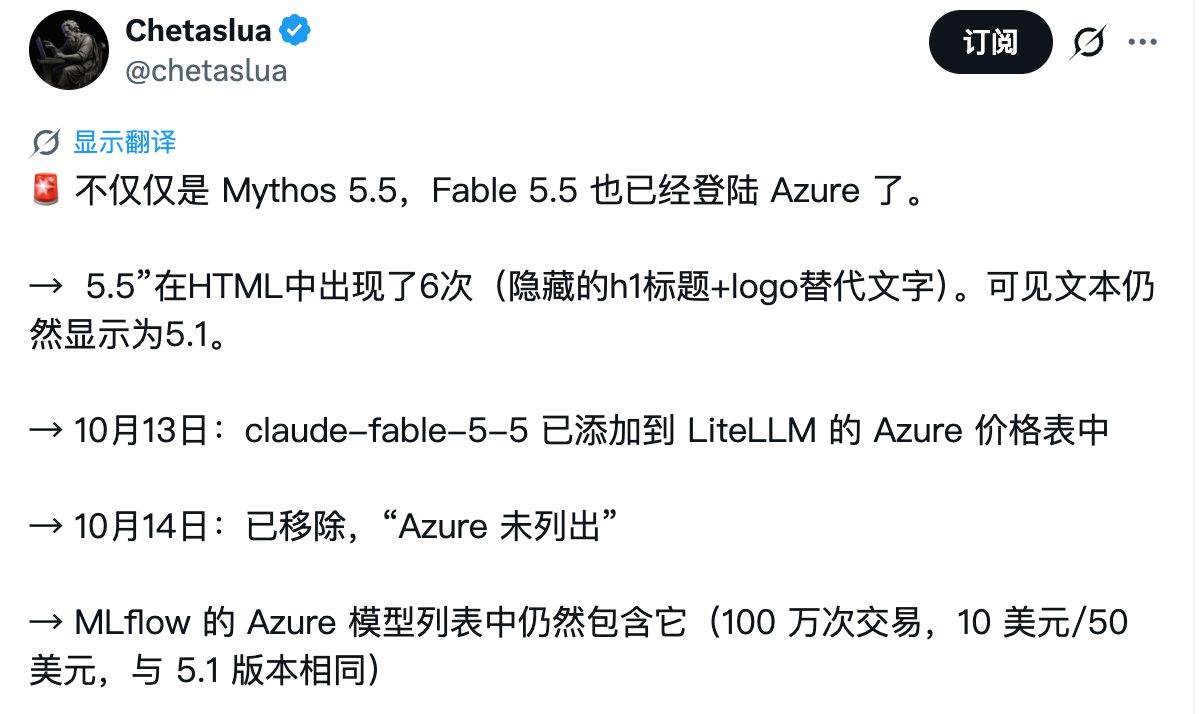
值得注意的是,今天凌晨,开发者 @chetaslua 进一步发现,Mythos 5.5 曾在官网 HTML 中出现六次,但正文介绍仍然停留在 Mythos 5.1。
向左滑动查看更多内容
随后,另一位用户 @pankajkumar_dev 表示,Anthropic 已经删除了涉及 Mythos 5.5 的网页内容。
与此同时,另一条关于 Fable 5.5 的线索也被翻了出来。
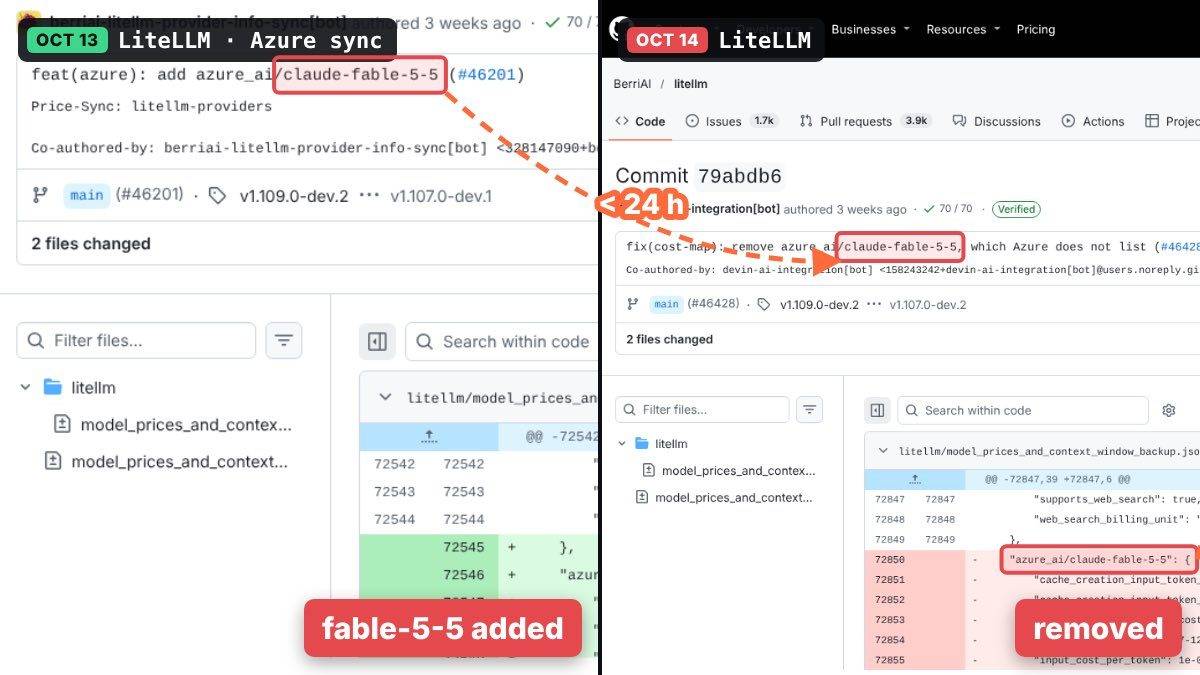
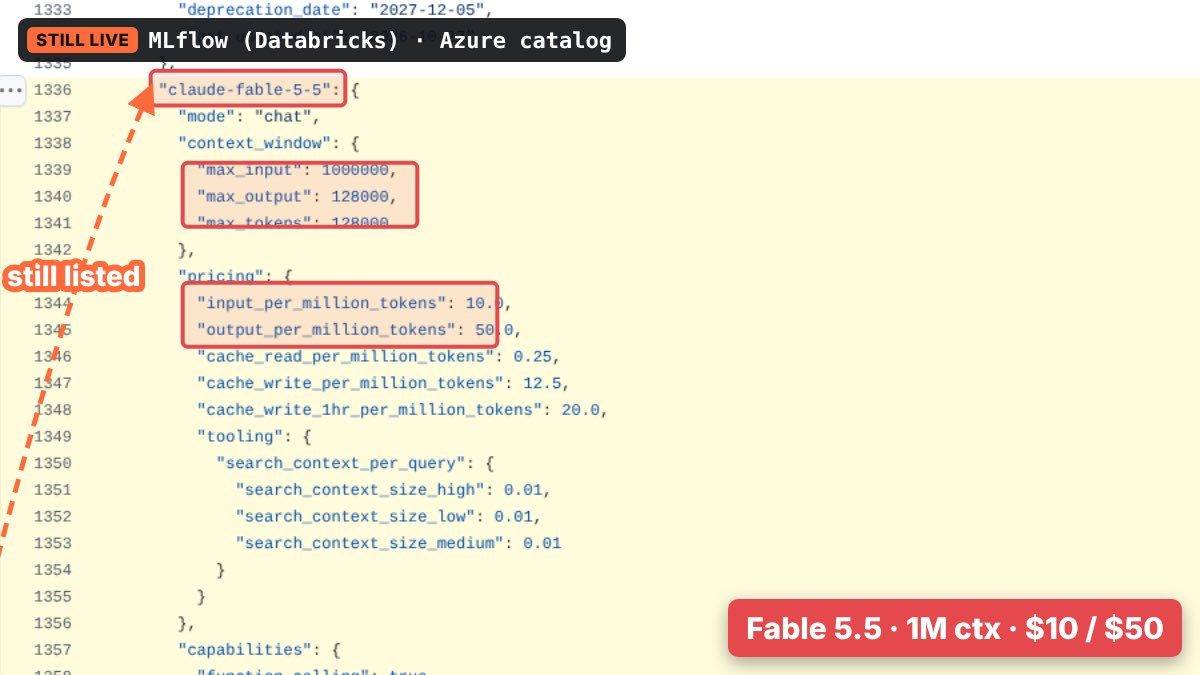
早在 10 月 13 日,开源大模型 API 网关 LiteLLM 的 Azure 价格配置中,就曾出现过 azure_ai/claude-fable-5-5 的模型标识。相关配置随后被移除,但第三方 MLflow 模型目录仍保留了对应记录。
根据流传的配置信息,Fable 5.5 可能支持 100 万 token 输入上下文、12.8 万 token 最大输出,每百万输入 token 为 10 美元,输出为 50 美元,缓存读取价格则为 0.25 美元。
至于新模型究竟什么时候发布,社区同样众说纷纭,有人预测本周,有人预测下周,也有人认为要等到 11 月中旬,因为这可能是 Anthropic 上市的最佳献礼。
Claude Fable 5.5 编程能力曝光,3D 游戏都能一句话生成?
相比官网源代码里的几个字符,更让开发者兴奋的,是 X 平台上接连出现的 Fable 5.5 演示视频。
11 月 1 日,开发者 @notjazii 发布了一段约 36 秒的对比视频,声称使用相同提示词,让 Claude Opus 5.5 和 Fable 5.5 分别生成 3D 场景。
画面中,Opus 5.5 主要呈现湖泊、公园、喷泉以及四季变化的自然景观,整体更接近微缩模型展示。而 Fable 5.5 一侧则出现了农场四季变化、城市建筑逐渐生长、港湾昼夜交替,甚至还有火山喷发、火箭升空等动态事件。
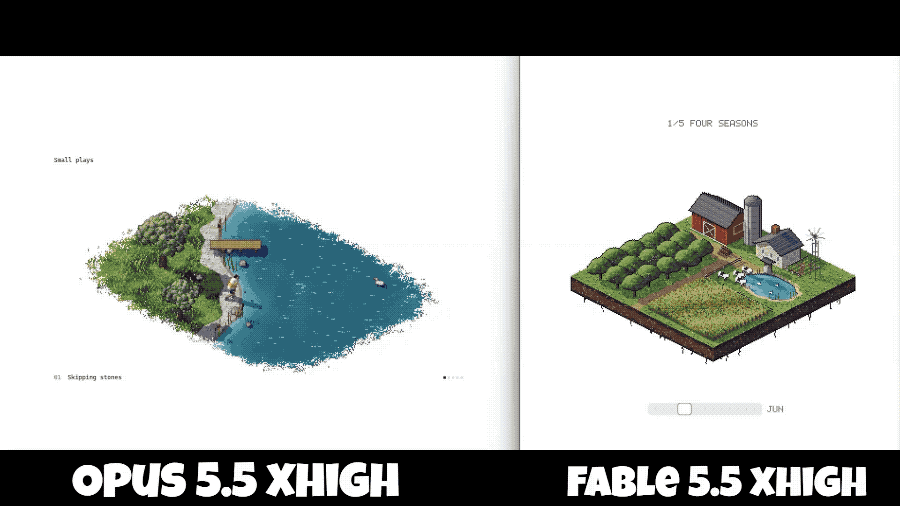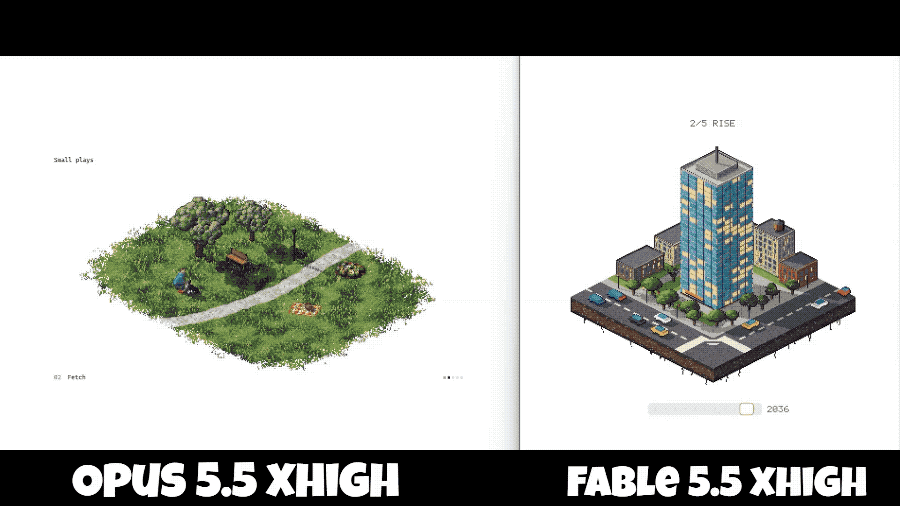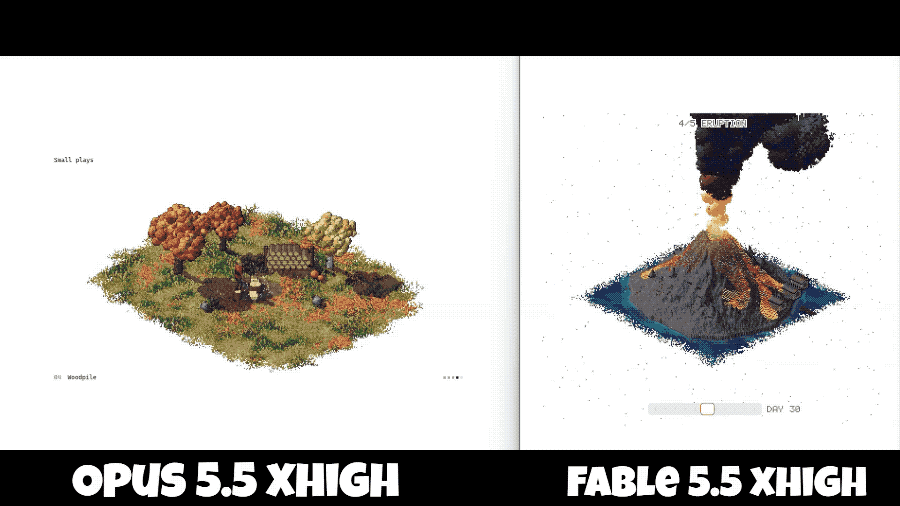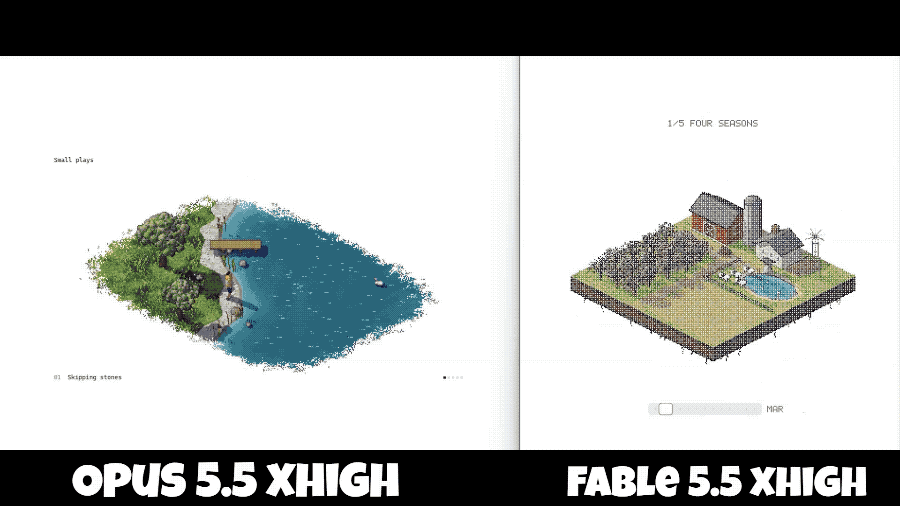
相比静态场景,Fable 5.5 的作品更强调连续动画、时间变化和物体状态。
发布者认为,新模型在此次对比中全面胜出。
紧接着,他又展示了一款据称由 Fable 5.5 生成的 Minecraft 风格游戏。
在约 92 秒的视频中,玩家能够以第一人称视角探索方块世界,穿过森林、洞穴、海岸和沙漠河流,甚至还能看到熔岩区域、粉色树冠森林,以及水面上的动态光照。
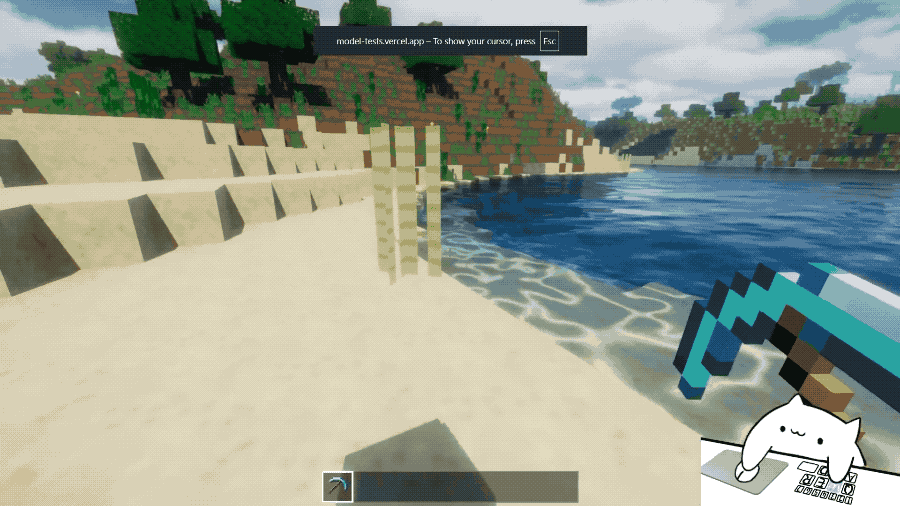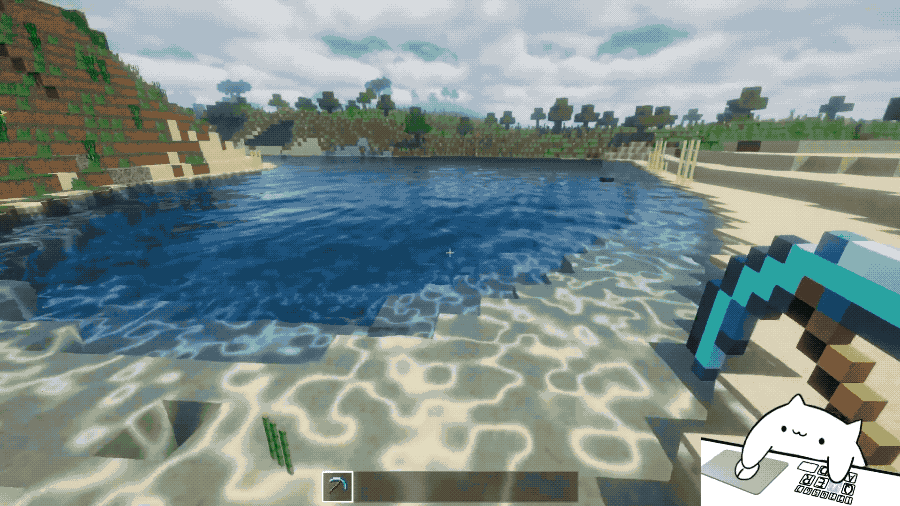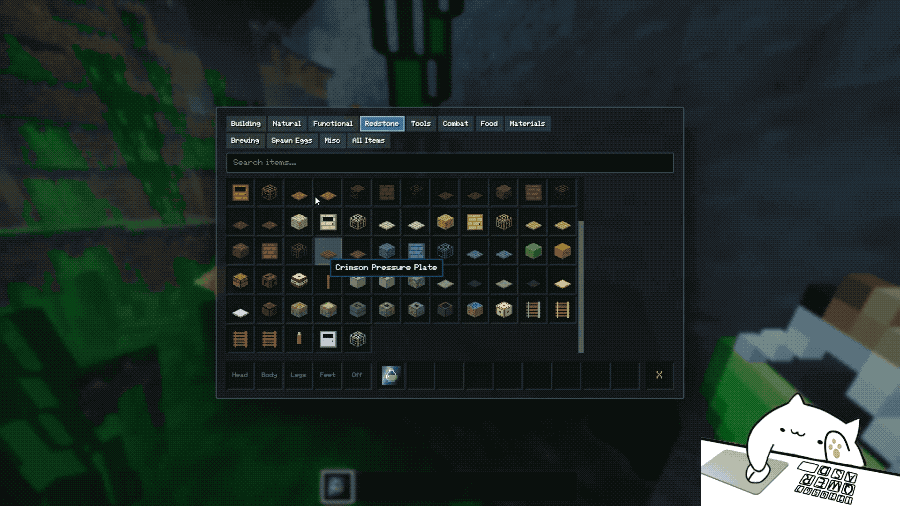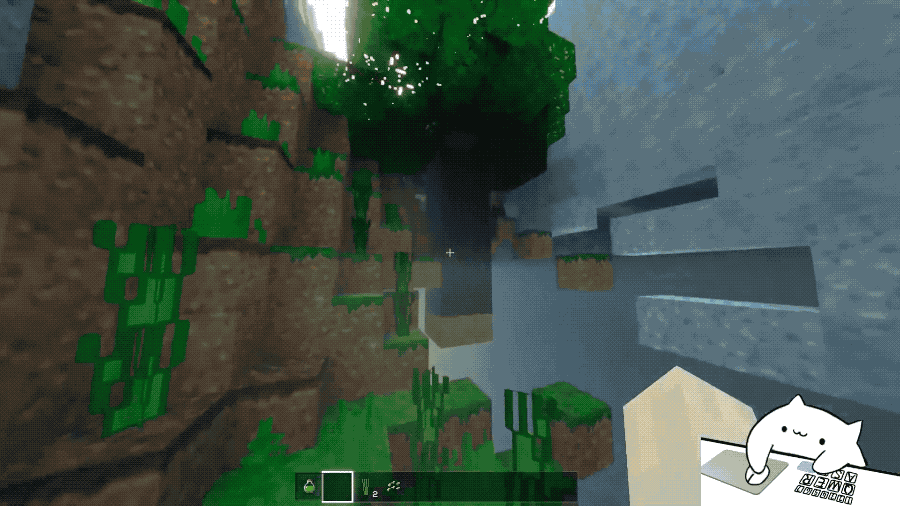
游戏界面同样相当完整,包括镐子、物品快捷栏和分类背包等常见元素。作者声称,整个作品只用了一个提示词,花费一到两个小时便完成生成。
另外两段演示也颇有看点。
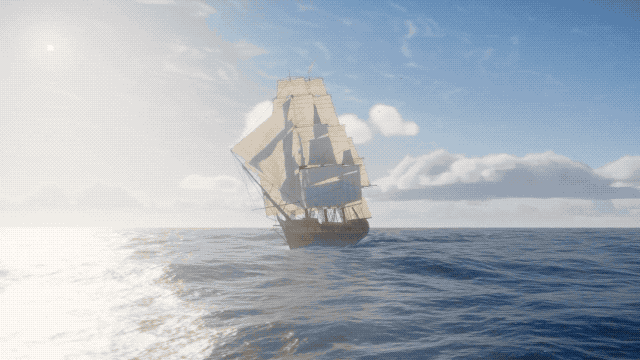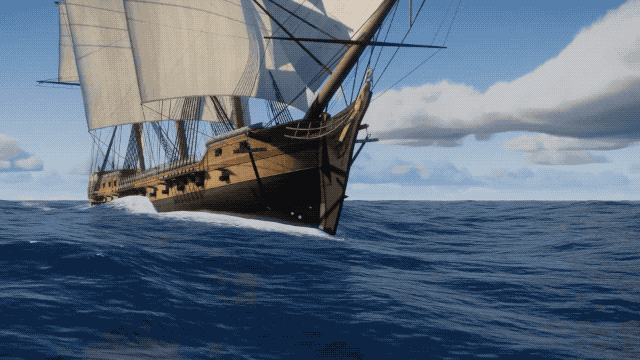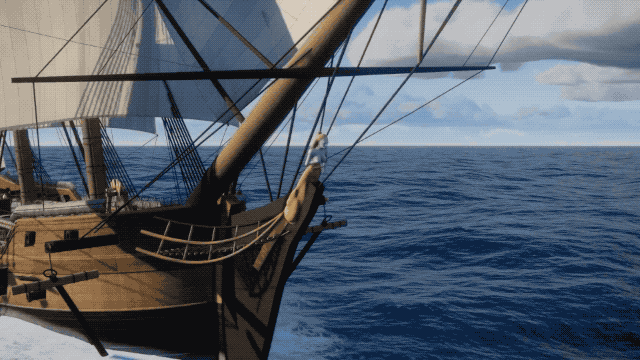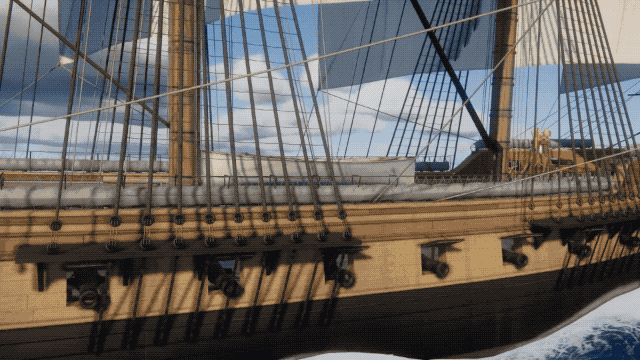
开发者 @abhinavflac 展示了一艘据称由 Fable 5.5 通过 zero-shot 提示词生成的交互式历史帆船。
镜头能够围绕船身移动,观察甲板、炮门、帆面和绳索结构,海浪、船尾尾流以及夕阳下的水面反光也被呈现出来。
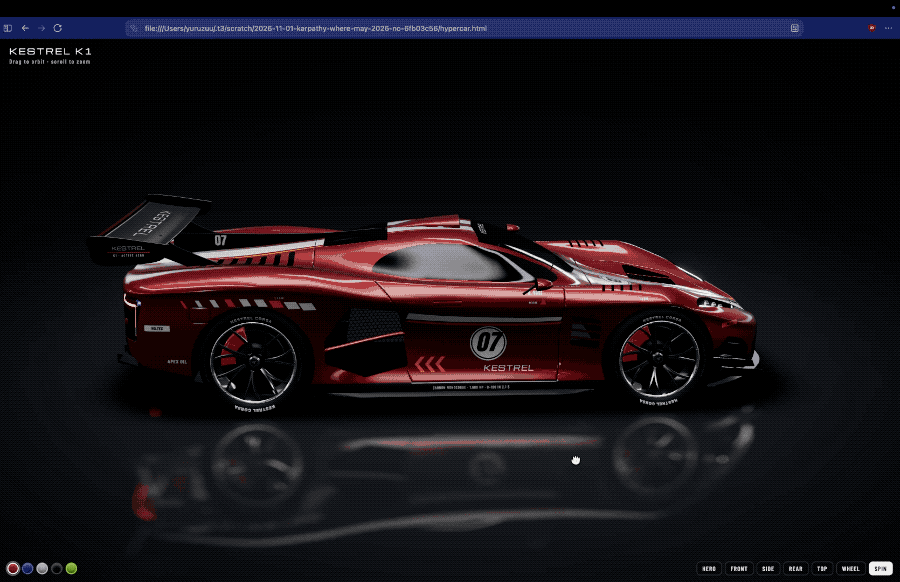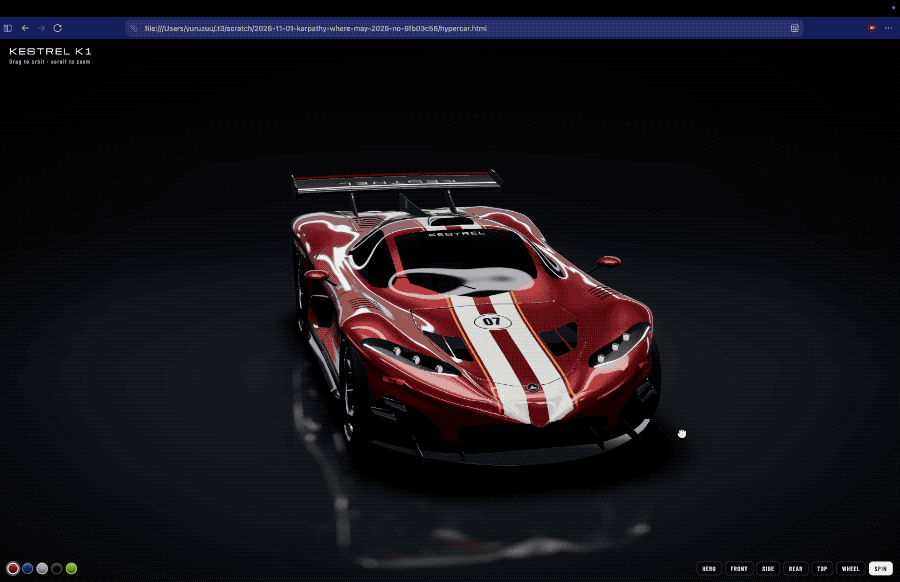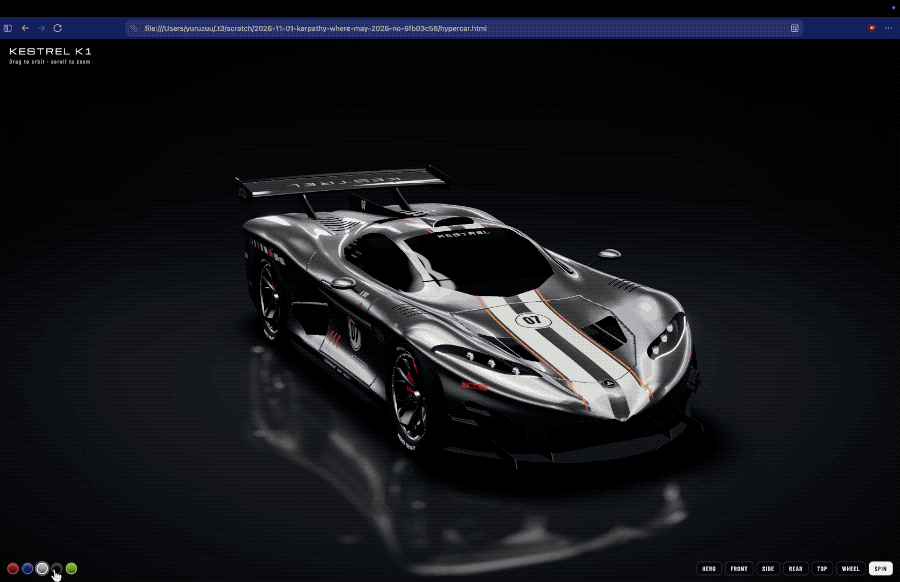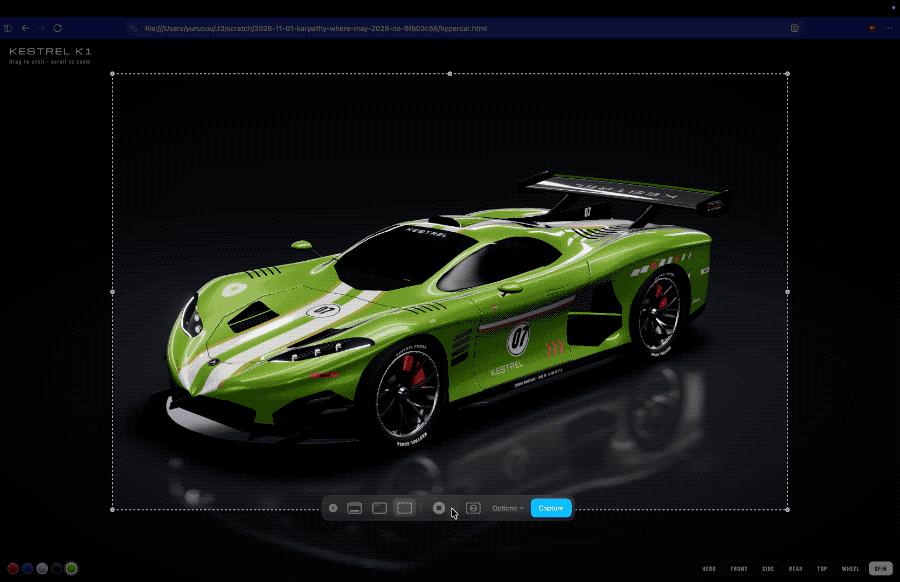
另一位开发者 @chetaslua 则展示了一款基于 Three.js 的跑车应用,用户可以从不同角度观察车辆,还能随时切换红、蓝、银、黑和荧光绿等车漆颜色。
从这些作品来看,开发者已经开始尝试让 AI 承担更复杂的 3D 建模、场景动画和交互开发任务。不过,相关视频并未附带完整提示词、调用日志和源代码,模型身份、生成耗时以及是否一次完成,仍主要依赖作者自述。
倘若后续能够得到验证,Fable 5.5 在复杂交互应用开发方面的表现,确实值得期待。
GPT-6.2 Astra 也来了,Codex 用户提前用上新模型?
Anthropic 这边消息不断,OpenAI 也出现了新的动静。
11 月 1 日,X 用户 @TokenGremlin 发帖称,部分用户的 Codex 使用统计中,出现了一个尚未正式公布的模型名称。
gpt-6.2-astra
根据网友的截图,在某个账户的模型使用占比中,GPT-6 Astra 占据约 80%,GPT-6.2 Astra 则占据 19.8%。
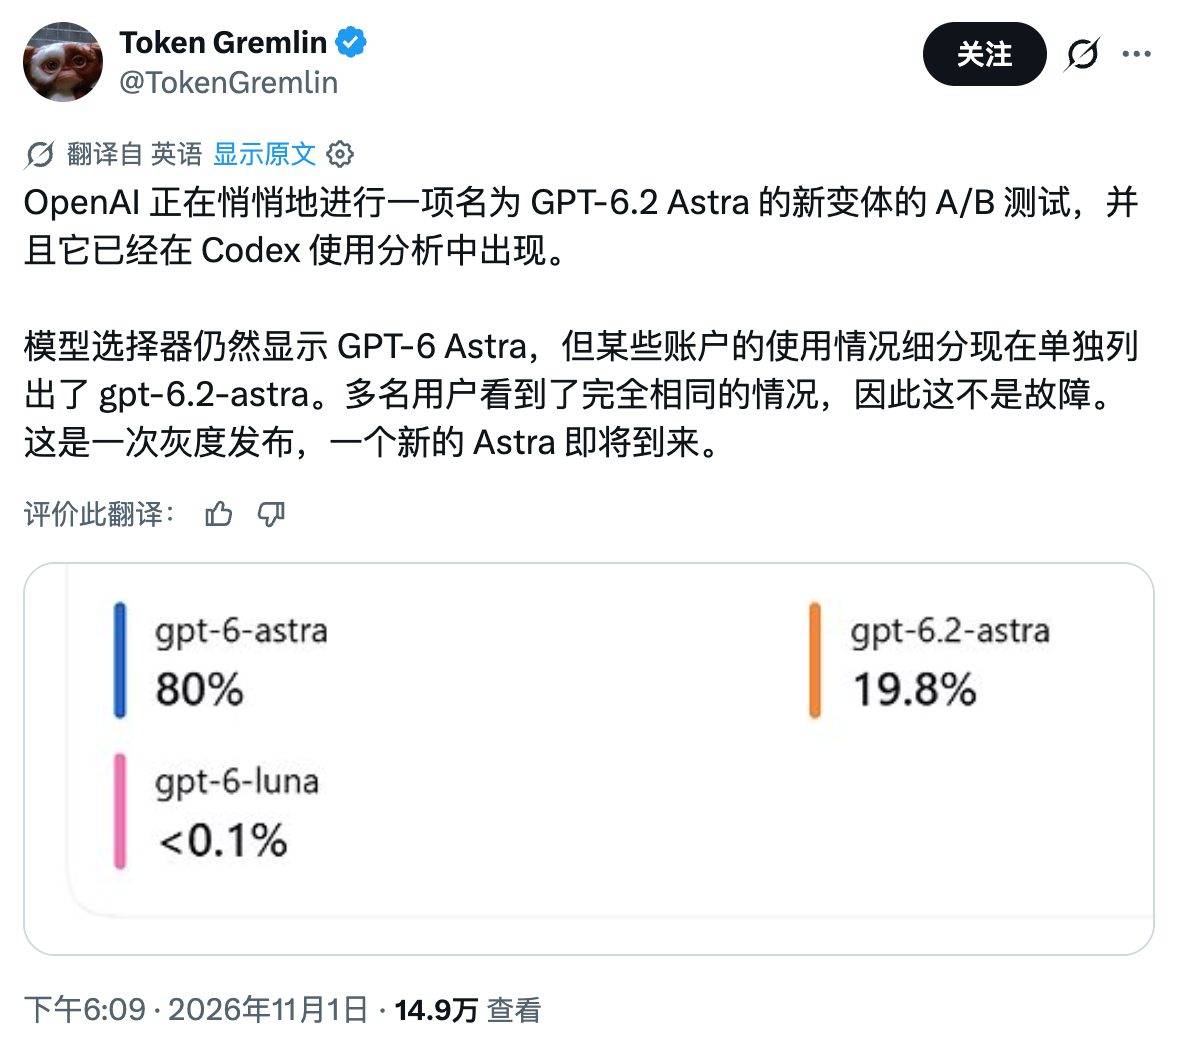
有意思的是,用户在模型选择界面看到的仍然是 GPT-6 Astra,但后台统计却显示了新的模型标识。
随后,开发者 @Mr_Salio 也晒出一段 API 响应数据,其中 response.model 字段显示为 gpt-6.2-astra。
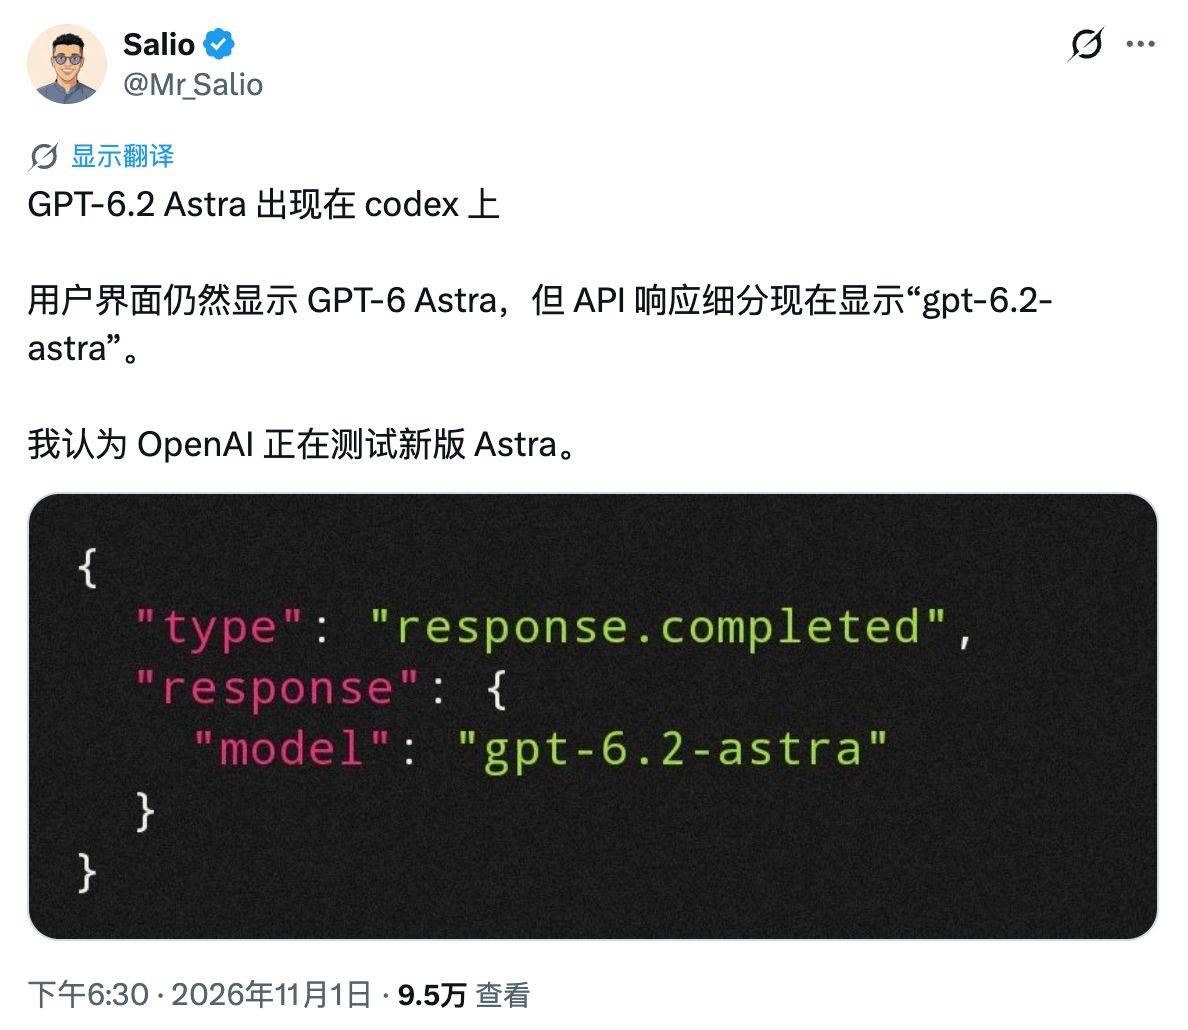
两条线索分别来自使用统计和响应记录,让外界猜测 OpenAI 可能已经开始测试新版本 Astra。
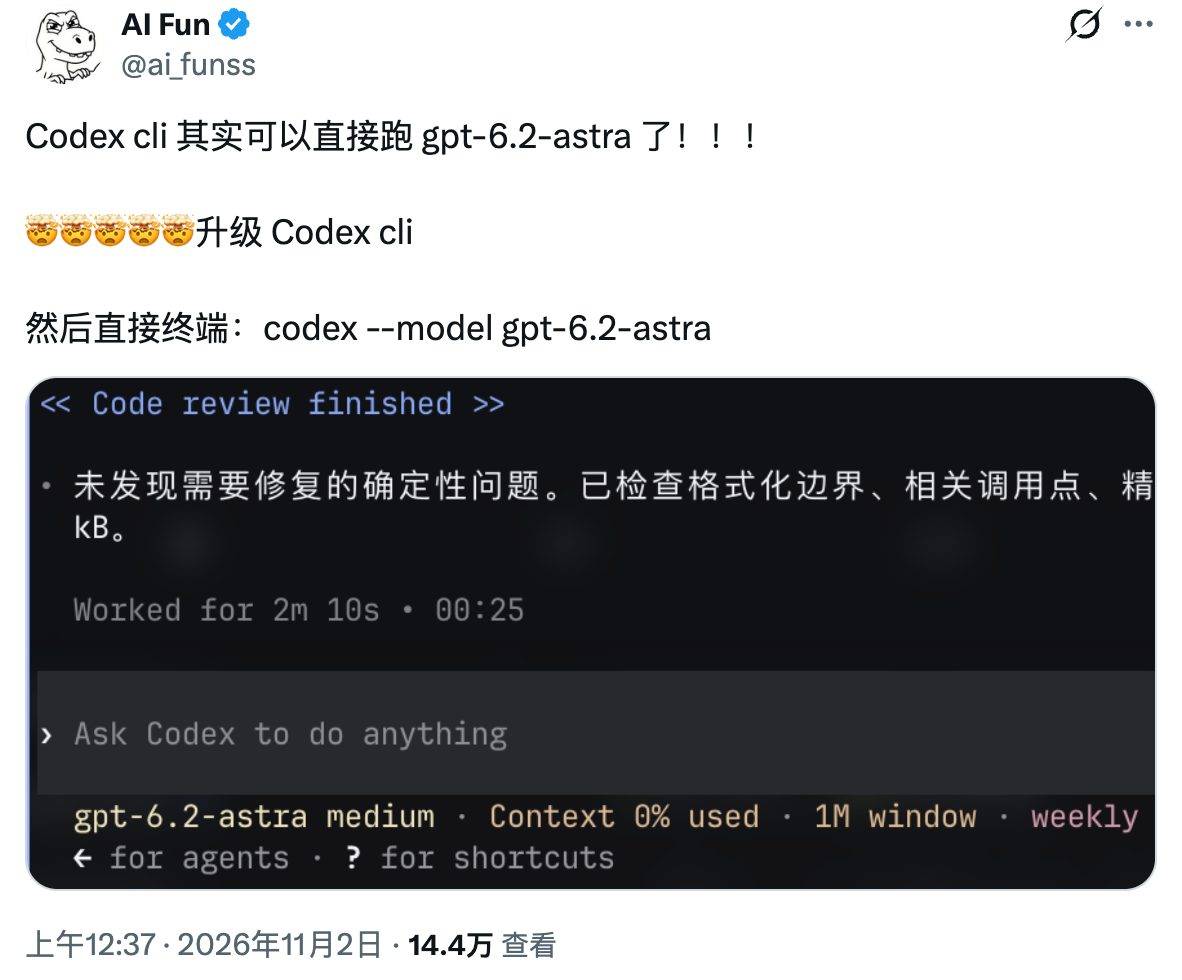
更进一步,今天凌晨,用户 @ai_funss 表示,升级 Codex CLI 后,可以通过终端指定模型名称,尝试调用 GPT-6.2 Astra。
其展示的截图不仅出现了 gpt-6.2-astra medium 标识,还显示 1M window,也就是 100 万 token 上下文窗口。
至于性能,社区内已经出现两种截然不同的评价。
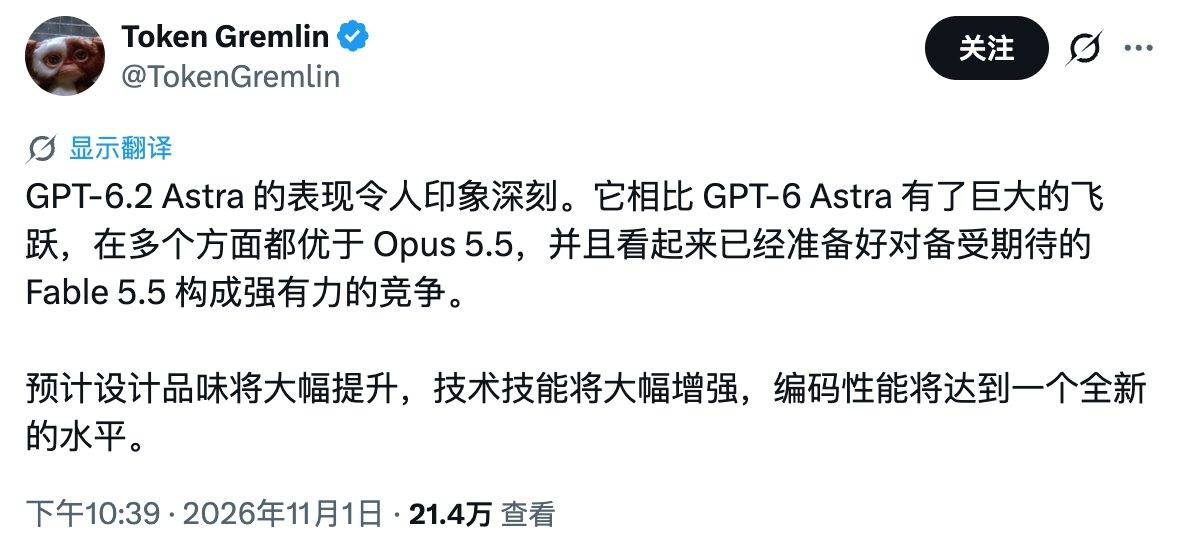
@TokenGremlin 认为,GPT-6.2 Astra 相比前代有明显进步,尤其是在设计、技术能力和编程表现方面,部分任务甚至可能超过 Claude Opus 5.5。
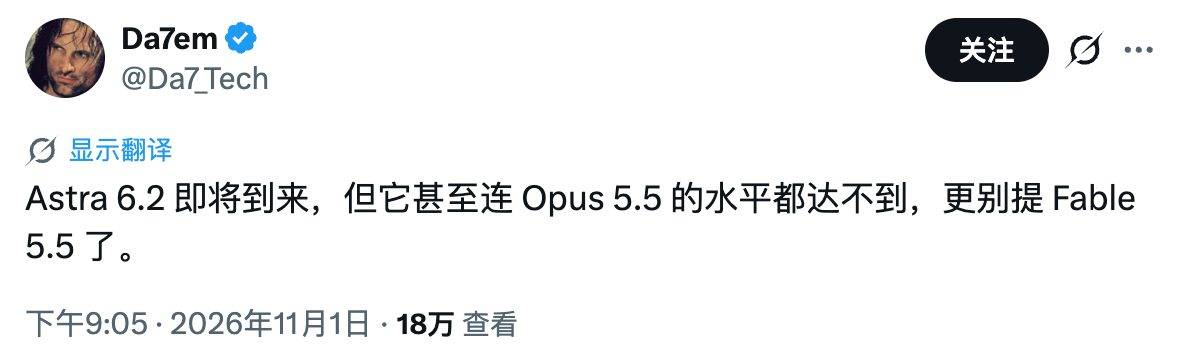
但另一位用户 @Da7_Tech 却认为,新 Astra 尚未达到 Opus 5.5 的水平,更不用说传闻中的 Fable 5.5。
值得一提的是,10 月 31 日,OpenAI 官方账号还发布了一段视频,配文「未来有很多种可能。你想创造哪一种?」,也引发了外界对其是否由新一代模型生成的猜测。
回顾最近一个月,全球大模型厂商的更新节奏明显加快。
10 月 28 日,Google DeepMind 刚刚发布 Gemini 4 Carbon,如今 Anthropic 和 OpenAI 又相继传出下一代模型的线索,国内的 Qwen、GLM、Hy4 等模型也被寄予新版本发布的期待。
如今的大模型竞争,已经逐渐进入一个有些荒诞的阶段。
一款旗舰模型还没正式亮相,网友就已经通过官网源代码、后台记录和演示视频,找到了各种蛛丝马迹,甚至提前争论起谁才是下一任世界第一。至于这些线索究竟是厂商无意留下的痕迹,还是有意放出的预热信号,恐怕只有厂商自己清楚。
但流量本身无疑是一把双刃剑。毕竟,AI 厂商最难击败的对手,可能已经不再是彼此,而是被上一代模型不断抬高胃口的用户。
当真实产品终于登场,如何超越互联网提前为它塑造的想象,或许比击败竞争对手更加困难。
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
[程序员] 我在 2 核 2G 云主机上跑 OpenViking:一次关于云主机、模型选型与长期成本的真实复盘
最近把自己的 AI Coding Agent 记忆底座迁移到了自建的 OpenViking 上( OpenViking 真的满足我所有的要求:即是各种 Agent 的统一大脑自进化、又是知识库,检索的时候是两方面综合起来的)。RAG 相关的东西看着挺吓人,动辄推荐高配服务器和本地显存,实际上用下来,只要选型想清楚,一台几十块钱的入门级云服务器完全能跑得飞起。
这篇不是教你怎么敲命令的安装教程,只是聊聊折腾这一圈下来,在云主机、模型组合、算力开销上的一些真实心得和踩坑取舍。
1. 云主机:为什么我选 99 元的 2G ,不选友商更便宜的 4G ?
买云服务器时,第一眼很容易被一些友商“几十块钱买 4G 甚至 8G”的新客促销吸引。但我最终还是选了阿里云 99 元/年的 2 核 2G ( ecs.e-c1m1.large )。
核心原因就一个:算长期的续费账,避开“首年低价、次年暴涨”的套路。
如果只是搭个无状态的个人博客,一年一换、到处搬家无所谓。但 OpenViking 是你的记忆数据库,里面存的是日常所有的会话轨迹、沉淀的项目架构、实体图谱和向量索引,是强状态资产。很多友商首年 60 块,第二年续费直接跳到 600 、800 甚至上千,一年后为了省钱被迫停机、跨云拷贝几千兆数据、重新配安全组和域名解析,折腾成本远超那点差价。
阿里云这款活动最大的诚意,是保证来年依然可以 99 元无套路同价续费。
2G 内存虽然紧凑,但只要做好 Swap 兜底,限制好容器内存,并把计算全都甩给外部 API ,机器本地只做存储检索,日常内存占用常态也就几百兆。拿稍微调优一下系统为代价,换一个每年只要 99 块、不用频繁搬家的稳定记忆底盘,这笔账怎么算都更划算。
2. 向量模型( Embedding ):花钱的大头,必须一步到位
整套系统跑起来,持续花钱的大头其实就是向量模型。但我从一开始就放弃了“白嫖免费模型”的想法,坚定选择花钱买商业服务,并且要“一步到位”。
为什么必须一步到位?
VLM 、意图分析、重排模型这些都是即时推理,今天觉得不好用,改一行配置重启一下直接就换了。但向量模型决定了数据库底层的空间几何特征。一旦以后你想换向量模型,哪怕输出维度一模一样,之前的向量也全都废了,必须全库全量重建索引( Re-index )。随着记忆越积越多,二次重构的代价和停机风险极高,所以向量模型选型必须一开始就选最好的。
为什么放弃 SiliconFlow 免费的 BGE-M3 ?
很多教程推荐用硅基流动上免费的 BGE-M3 。我们在实际做向量召回测试时发现,它的召回质量被新一代模型拉开了非常明显的代际差距。BGE-M3 是 2024 年 1 月的模型,底子太老,而且是个纯文本模型,图片只能当附件存,根本建不了索引,做不到“以文搜图”。
更关键的是,公用免费池已经被羊毛党挤烂了。我们在测试免费模型做路由时频繁遇到丢包、高延迟、无响应。作为核心基础设施的底座,把身家性命系在免费公共池上,纯属给自己找麻烦。
为什么选火山方舟的豆包 Vision ( 0.7 元),没选阿里千问?
最终我用的是火山方舟的 doubao-embedding-vision-251215,官方定价是推理输入 0.7 元 / 百万 tokens。
其实阿里百炼也有一款多模态向量模型(qwen3-vl-embedding),价格一模一样也是 0.7 元,但两者有个致命差距:
- 阿里千问的上下文窗口只有 32K;
- 火山豆包的上下文窗口高达 128K。
对于 Agent 场景,经常要塞入长篇开发规范、长上下文代码切片或者多张高清截图,128K 带来了整整 4 倍的安全容限,彻底不用担心超长切片溢出。加上 OpenViking 本身就是字节火山引擎开源的,原生 Provider 兼容最稳,同价位下显然选 128K 的豆包。
注:如果你完全没有图片、截图的检索需求,只做纯文本或代码笔记,阿里百炼的纯文本向量 qwen3.7-text-embedding 是个很好的省钱备选,价格只要 0.5 元/百万 tokens 。
3. 意图分析( Query Planner ):90% 的人都漏看的“隐藏开关”
很多人刚用 OpenViking 时都有个共同的困惑:“为什么这玩意儿响应这么迟钝?每次在 IDE 或终端里刚敲完一句话,光标都要卡顿个五六秒才开始有反应?”不少人甚至因此觉得是机器配置不够,或者系统本身设计笨重。
其实根本不是性能问题,而是绝大多数人压根没仔细看配置文档,不知道还能单独配一个意图分析模型。
官方默认示例里大家一般只填 vlm 和 embedding。但只要没在配置里显式声明 query_planner,OpenViking 在处理每一轮对话时,就会默认回退去调用主模型 VLM 来分析这轮对话是不是闲聊、要不要搜记忆、怎么提取关键词。如果你的 VLM 选了个大模型或者带思考链的模型(比如智谱 glm-5.3-flash),单次前置分析直接就能吃掉 6~7 秒,前端交互自然卡成 PPT 。
为了解决这个前置卡顿,起初我试图在主流的通用大模型里寻找替代方案。但跑了一圈下来非常沮丧:
- 阿里百炼官方的 Qwen3.7-Flash 默认带深度思考,跑一次要想 10 秒;
- 硅基流动上的 Qwen/Qwen3.5-9B 吞吐偏慢(常态 30 tok/s ),每次提问依然要停顿 4 秒;
- 硅基流动上的 Qwen/Qwen2.5-7B 格式飘忽,爱吐裸数组;
- 硅基流动公用免费池的模型(如 Qwen3.5-4B)更是被羊毛脚本挤爆,频繁丢包超时。
正当我们卡在通用大模型的选型瓶颈时,**我在阿里百炼模型广场里无意间翻出了一个宝藏模型——tongyi-xiaomi-analysis-flash(伶鹊-对话分析-flash )**。官方介绍写得很朴实:专攻对话信息抽取、场景分类与低时延分析的领域模型。
我立刻把它拉进测试矩阵,和前面的候选模型来了一场同台竞技。需要特别说明的是,为了公平对比,我们在压测所有候选模型时,全都显式关闭了思考模式(开启非思维链模式,纯直接输出)。
在实际评估中,我们重点死磕了三个核心维度:响应耗时、生成结构、规划表现。在三项严苛检验下,这个意外淘到的宝藏模型给出了教科书级的表现:
维度一:响应耗时(时间预算必须死守在 1 秒内)
query_planner 处于用户敲下回车、模型真正回答前的关键阻塞路径( Critical Path )上,耗时哪怕多 1 秒,体感都是极其明显的卡顿。
- 阿里百炼 Qwen3.7-Flash:即使关掉思考模式(
enable_thinking: false),单次分析依然要 1.1~1.4 秒( 70~90 tok/s ),作为高频前置拦截还是略重; - 硅基流动 Qwen/Qwen3.5-9B:关掉思考后,受限于供应商 30 tok/s 的生成吞吐瓶颈,跑完一段多轮分析依然需要 3.8 ~ 4.2 秒;
- 硅基流动免费池(如 Qwen3.5-4B ):公用免费池常年被羊毛脚本挤占,延迟严重抖动甚至直接超时;
- 通义伶鹊( Flash ):首字延迟( TTFT )仅 0.31 秒,生成吞吐高达 200+ tok/s,整轮规划耗时直接干到了 0.8 秒左右,完美落在亚秒级预算内。
维度二:生成结构(严苛遵循 OpenViking 要求的 JSON 协议)
OpenViking 底层的意图解析器对输出格式有明确的契约要求:模型必须返回形如 {"queries": [...]} 的标准 JSON 对象结构(由内部代码直接反序列化提取检索意图),容不得半点格式偏差:
- 通用大模型的通病:喜欢画蛇添足加礼貌用语(“好的,为您规划如下”),或者在外面套一层
json ...围栏,把本该干净的输出搞得拖泥带水,全靠系统写正则兜底去清洗; - 硅基流动 Qwen/Qwen2.5-7B 的硬伤:虽然速度压缩到了 1.8 秒,但格式极其不服从规范,经常丢掉 OpenViking 要求的顶层 Key ,直接吐出一个裸数组
[...]。一旦丢了对象结构,极易触发解析异常导致检索失败; - 通义伶鹊( Flash ):官方特性主打“自定义分析标准遵循”,实测下来对 OpenViking 要求的 JSON 协议做到了 100% 严格执行——输出纯净裸 JSON ,没有 markdown 围栏,没有前后废话,与 OpenViking 的反序列化契约严丝合缝。
维度三:规划表现评估(业务意图的决断质量)
意图分析模型绝不是盲目生成检索词,它必须具备清晰的业务场景决断力:
- 闲聊拒搜率:面对“你好”、“谢谢”、“帮我写个冒泡排序”这种无需长程记忆介入的输入,通义伶鹊能像防火墙一样在 0.4 秒 内果断断定无需检索,并输出空数组
{"queries": []},避免了无意义的向量库查询与上下文污染; - 多轮指代消解与实体抽取:在多轮对话中(比如用户追问“把刚才说的那个服务端口发我”),它能从历史上下文里把代词精准还原成具体的实体词(展开为“OpenViking 1933 端口配置”),提取出来的 Query 极其精准紧凑,绝不发散脑补。
事实证明,这个无意间淘到的宝藏模型绝非侥幸胜出,而是其专攻“对话抽取、场景分类、格式遵循”的垂直微调定位,正好与 OpenViking 前置路由的工程诉求完成了教科书般的精准对齐。
4. 重排序( Rerank )与 VLM:务实的经济账与容灾
最后说说剩下的两个组件:
- 重排序( Rerank ):我依然放在了硅基流动上,用的是
Qwen/Qwen3-Reranker-4B。 之所以用它,是因为它走的是轻量商业计费通道(避开了免费池的排队),调用一次只要几厘钱。关键是我账号里还有送的 16 块钱代金券,不用白不用。实测 4 条文档打分 0.26 秒,30 条文档打分 0.57 秒,速度快而且打分很准,性价比拉满。 - VLM (多模态语义抽取):用的是智谱 Coding 套餐里的
glm-5.3-flash,顺便配了双 Key 主备容灾。 这里有个极其关键的实战经验:配置里一定要把思考模式显式改为reasoning_effort: "low"。 我们专门做过多组 A/B 实测,默认不传参或者设为high时,模型会先深度思考大几十秒(耗时 20~48 秒,生成上千个无意义的思维链 Token ),而最终提取出来的实体和概览内容与low几乎毫无区别。记忆提取本质上是信息抽取和结构化归档,根本用不着复杂的数学逻辑推演,开high纯属白白浪费时间和算力。 即使设为low,单次抽取依然需要 4~6 秒(有底层基础思考和 20~30 tok/s 的吞吐上限),它也是目前系统唯一的耗时点。但因为 VLM 只在后台异步做会话归档和概览生成,完全不阻塞前端的提问交互;加上 Coding 套餐按年付费极度便宜,配合双 Key 容灾非常稳定,现阶段完全不需要花钱折腾换它。
5. 写在最后的一些大白话心得
折腾完这套配置,最大的几点感悟:
- 状态型服务,买服务器先看续费:做长期记忆库,宁可前期在 2G 上花点时间调优,也别为了贪图首年几块钱的便宜去买续费暴涨的机器,搬家真的很累。
- 核心资产一步到位,无状态节点随时优化:向量模型决定了你的底层空间,别贪免费,多模态 + 大上下文( 128K )直接锁死,避免以后二次重建;而 VLM 和 Rerank 这种纯推理节点,谁快谁便宜就换谁。
- 专用小模型在垂直场景吊打通用大模型:意图分析这种讲究“分类、提取、严格 JSON 格式、极速”的任务,微调过的对话分析小模型比动不动就写小作文、开思考链的通用大模型好用太多倍。