美团发布LongCat-2.5大模型 总参数量1.6万亿 - 观点网
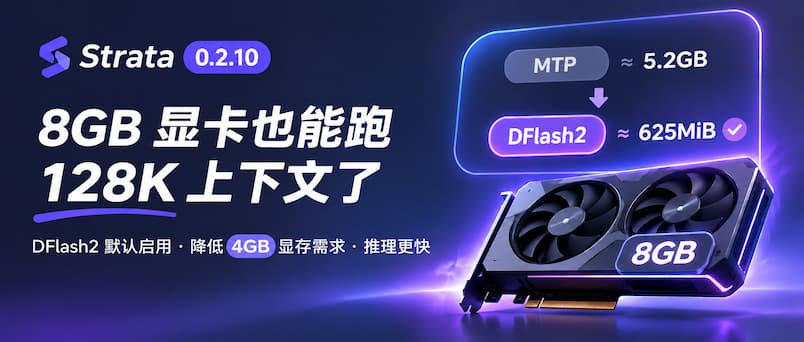
Strata 0.2.10 发布:本地 AI 大模型继续提速,默认使用 DFlash2 降低显存需求,8GB 显卡也能开启 128K 上下文
之前小众软件多次介绍过 Strata:这款开源工具可以让普通电脑,尤其是显存有限的消费级显卡,也能运行参数规模惊人的本地 AI 大模型,比如 Qwen3.8、Qwen-Flash-Next、DeepSeek 4.1 Flash 等模型。@Appinn
Strata 0.2.10 发布,这次带来了几项值得关注的改进:新的 DFlash2 推测解码器成为默认选项(降低4GB显存需求),8GB 显卡也能启动 128K 长上下文,多显卡推理速度大幅提升,还加入了一个专门针对编程任务优化的 DeepSeek 模型。
Strata 交流微信群
青小蛙拉了个交流 Strata 微信群,感兴趣的同学可以扫码入群:
8GB 显卡,也能开启 128K 上下文
以前在 8GB 显卡下,开启 64K 上下文会耗尽专家缓存空间,导致启动失败。只能改用 CPU 图像处理、更小的 KV 缓存,或将上下文降到约 48K。
Strata 0.2.10 改进了这套机制:当显存不足时,优先调整显存和内存之间的数据分配,尽可能保留用户设置的上下文长度。
比如,现在可以在 8GB 显存条件下启动 Qwen3.8 IQ3_S,并保持 128K 上下文,也就是 131,072 Token。
Strata 会根据显存余量,逐步缩小驻留在 GPU 中的 KV 缓存窗口,必要时还会调整其他缓存,甚至将部分数据放到系统内存中。
官方测试中:
- 8GB 显存限制下,DFlash2 模式生成速度达到 63~73 Token/s。
- 32K Token 的提示词处理时间为 19.8 秒。
- 一张真正的 Intel Arc A750 8GB 显卡,也成功启动 128K 上下文,生成速度为 12.7~14.8 Token/s。
注意,显存需求仍然在,不是凭空消失,而是把压力给到了内存和 SSD。
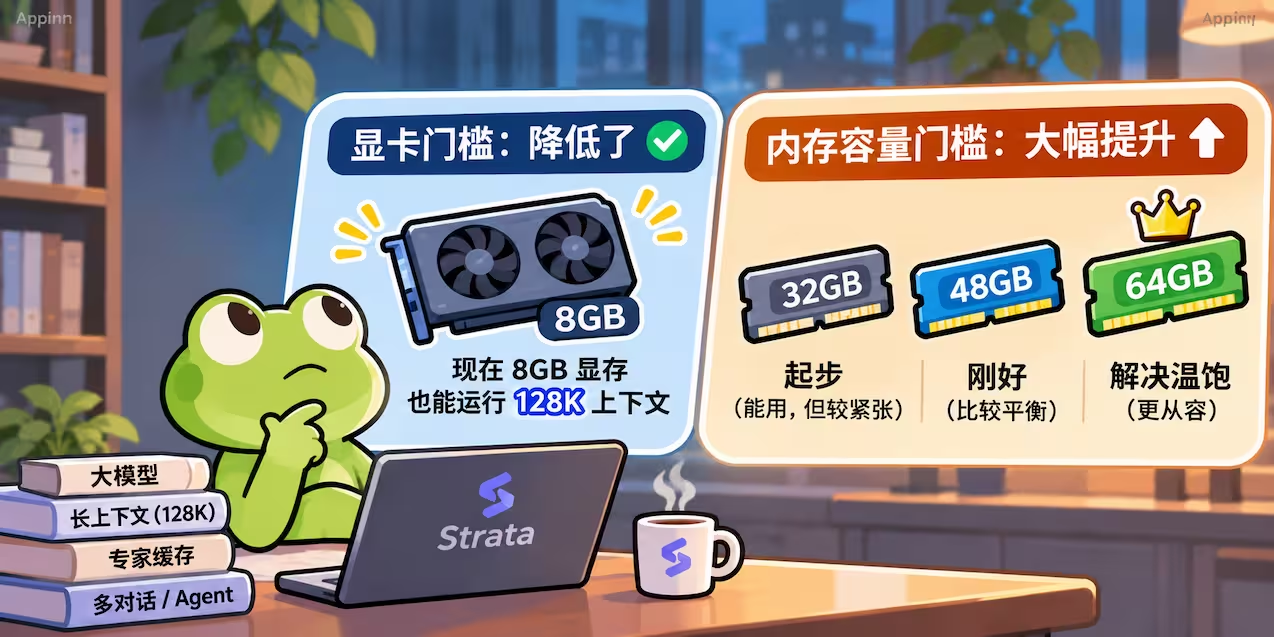
所以青小蛙认为,Strata 降低的只有显卡门槛,但却大大提升了内存容量门槛。
基本上,内存:32G起步,48G刚好,64G才算解决温饱。
DFlash2 成为默认加速器,还能额外节省 4GB 显存
Strata 0.2.10 将 DFlash2 设置为默认加速器。
DFlash2 是一种推测解码器。简单理解,就是让一个体积较小的辅助模型提前猜测接下来可能生成的内容,再交给主模型批量验证。猜对的部分越多,主模型就越有机会一次确认多个 Token,从而加快生成速度。
此前 Strata 使用的 MTP 推测层大约需要 5.2GB 空间,而新版 DFlash2 的显存占用约为 625MiB。
官方对比了同一引擎下 DFlash2 和 MTP 的表现:
| 测试设备 | 模型 | 生成速度提升 |
|---|---|---|
| Ryzen AI Max(Windows) | IQ3_S | 短回复 +8.4% |
| RTX PRO 5000 | IQ3_S | 短回复 +6.23% |
| Apple M5 Max | IQ3_S | +3.8% |
| DGX Spark | IQ3_S | +5.8% |
但是,也不是没有代价。
DFlash2 与 MTP 对比
相比之下,MTP 在硬件兼容性和多并发下都有优势:
| 对比项目 | DFlash2 | MTP |
|---|---|---|
| 显存占用 | 约 625MiB | 约 5.2GB |
| 额外文件 | 首次下载约 1.2GB | 推测层约 5.2GB |
| 单请求生成速度 | 多数官方测试更快 | 部分硬件更快 |
| 多并发 | 主要面向单请求 | 更适合多请求 |
| 低显存设备 | 优势明显 | 显存压力较大 |
| 支持范围 | 依赖特定模型与引擎 | 兼容范围更广 |
| Strata 0.2.10 默认策略 | 单请求 Qwen3.8 优先 | 多并发等场景优先 |
两张显卡一起跑,代码编辑速度接近翻倍
针对多显卡,这次更新带来优化:All-cards Split Engine。
以前多显卡运行模型时,常见做法是将模型的不同层分配到不同显卡。新的方式则允许多张显卡共同处理每一层模型,让它们同时参与计算。
官方使用两张 RTX A6000,在 Linux 下运行 UD-Q4_K_XL,得到以下结果:
| 测试任务 | 原来的速度 | 新版速度 |
|---|---|---|
| 代码编辑 | 195 Token/s | 377~394 Token/s |
| 生成新代码 | 139~144 Token/s | 189~232 Token/s |
| 普通文本 | 93 Token/s | 139~146 Token/s |
| Agent 循环 | 112~119 Token/s | 165 Token/s |
代码编辑任务的生成速度几乎翻倍。
还加入了一个编程专用的 DeepSeek 模型
Strata 0.2.10 新增了 ISTA-DAS Coder。它基于 DeepSeek-V4.1-Flash,针对编程和 Agent 任务进行了专家裁剪,每层只保留原来 384 个专家中的 192 个。
这样可以减少需要处理的专家权重。
官方测试中:
- 单张 Radeon AI PRO R9700:22.8 Token/s。
- 四张 R9700:59.2 Token/s。
- Apple M5 Max:19.1~22.5 Token/s。
- RTX PRO 6000 Blackwell:约 100 Token/s。
不过,这个模型的存储需求依然很大,仅模型权重就有约 72.1GB,另有约 110.6GB 的 Engram 数据文件,首次完整下载约需 191GB。
Agent 用户也迎来一批实用修复
除了推理性能,这次 Strata 还修复了不少图形界面和 Agent 相关问题。
比如:
- AI 回复很长时,Approve 和 Deny 审批按钮不再被滚动到看不见的位置。
- 子 Agent 可以接收用户追加的指令。
- 历史对话自动摘要现在会尽量使用用户原本的语言。
- AI 正在生成内容时,可以选择等待、排队发送新消息或者中断。
- 支持引用之前的某轮对话或选中的文字。
- 改善 Claude Code 遇到上下文溢出时的错误提示,让它能够尝试压缩上下文。
另外,Strata 也修复了 Windows 某些后台启动场景下,磁盘读取优先级过低、导致模型加载明显变慢的问题。
下载与更新
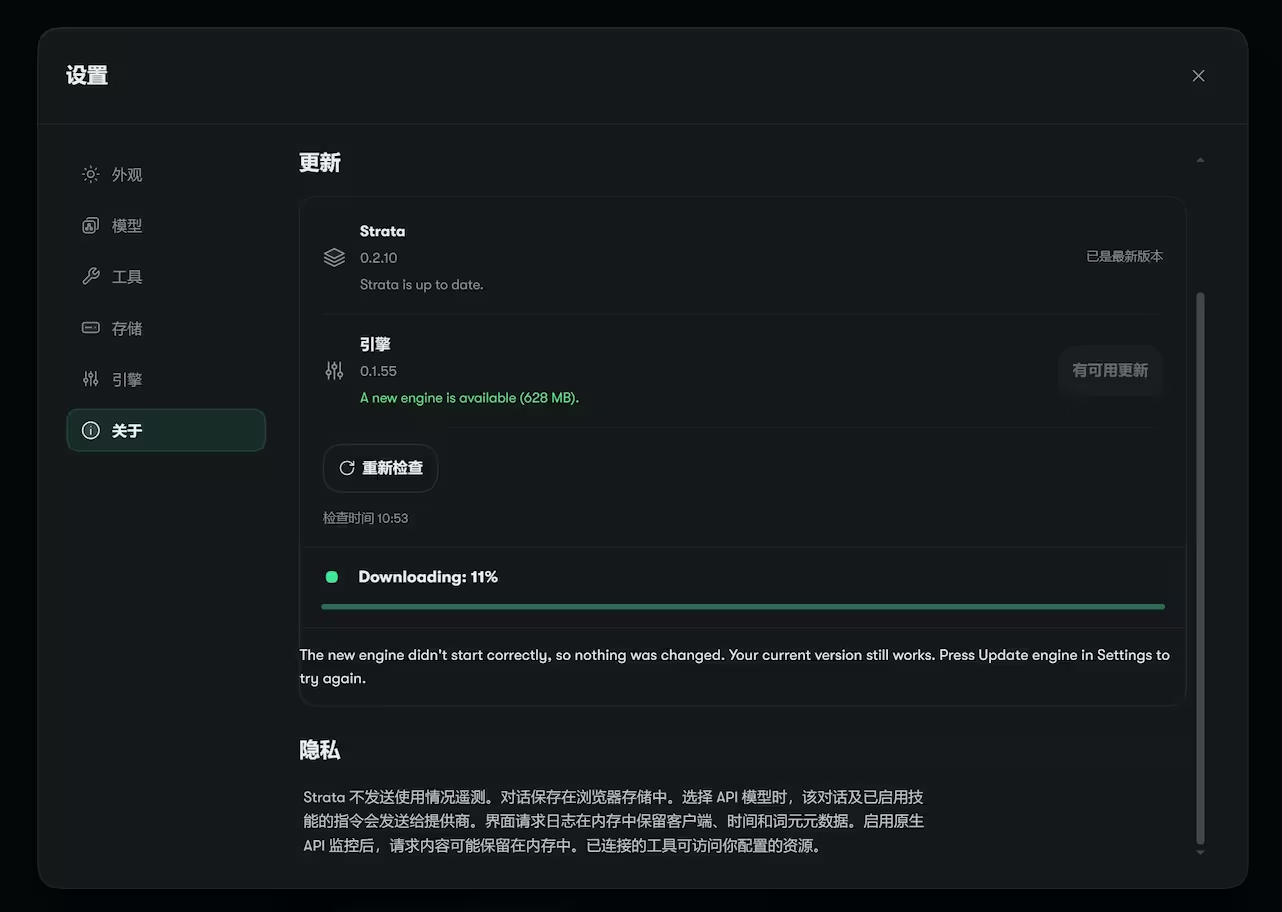
Strata 免费、开源,提供 Windows、macOS 和 Linux 版本。本次更新后 Strata 版本为 0.2.10,引擎版本 0.1.56。这两者都需要单独更新。
依旧,Strata 图形界面用户可以直接更新:
终端版用户可以运行:
strata update
项目地址: https://github.com/Niko1221/Strata
另外,每次升级都需要下载不小的文件,好慢啊。
原文:https://www.appinn.com/strata-0-2-10/
相关阅读

内部赛马结束?字节宣布扣子企业版分阶段下线 后续将推出整合产品
美团龙猫发布LongCat-2.5模型 强化视觉理解与长程编程 支持百万窗口