[酷工作] OmnixDrive 人才招募
OmnixDrive 人才招募
高级人工智能工程师|智能驾驶数据与模型研发
公司简介
OmnixDrive 是一家成立于 2026 年、总部位于新加坡的人工智能初创科技公司,专注于智能驾驶底层人工智能技术与基础设施研发。技术方向涵盖大规模驾驶数据处理、深度学习模型训练与优化、视觉感知、多传感器融合及算法工程化,为智能驾驶系统提供底层技术支持。
招聘信息
- 招聘人数: 3–5 名
- 工作模式: 混合办公,可远程协作或根据项目需求现场工作
- 协作时区: UTC+8(新加坡时间)
- 合作形式: 项目制合作
岗位职责
- 设计和开发智能驾驶数据处理体系,包括数据清洗、筛选、标注、增强及训练数据集构建。
- 研发视觉感知算法,涉及目标检测、图像分割、目标跟踪及三维环境感知。
- 负责深度学习模型的设计、训练、微调与优化,提升模型精度、鲁棒性及泛化能力。
- 参与摄像头、激光雷达、毫米波雷达等多源传感器数据处理与融合。
- 优化模型训练流程、计算资源利用率、推理效率及部署性能。
- 独立负责核心技术模块,解决复杂算法与工程问题,按项目要求完成交付。
任职要求
- 10 年以上软件开发经验,其中至少 5 年机器学习、深度学习或智能驾驶人工智能研发经验。
- 具备扎实的计算机科学、数学及机器学习基础,深入理解神经网络和模型训练机制。
- 精通 Python,熟练使用 PyTorch 或 TensorFlow;具备 C++ 开发能力者优先。
- 具备大规模训练数据处理经验,熟悉数据清洗、标注、增强、样本筛选及质量评估。
- 在目标检测、语义分割、目标跟踪或三维感知等计算机视觉方向具备深入研发经验。
- 具备完整的模型训练与优化经验,能够独立完成模型设计、训练、参数调优及性能评估。
- 能够解决模型过拟合、训练不稳定、长尾场景识别及模型泛化能力不足等问题。
- 熟悉模型部署、推理优化及 GPU 计算资源管理,具备独立技术攻关和项目交付能力。
优先条件
- 具备自动驾驶或高级辅助驾驶系统研发经验。
- 熟悉鸟瞰视角感知、占用网络、三维目标检测及多目标跟踪技术。
- 具备摄像头、激光雷达及毫米波雷达多传感器融合经验。
- 熟悉 Transformer、卷积神经网络及视觉基础模型。
- 具备大规模驾驶数据管理、自动化标注及数据闭环建设经验。
- 熟悉 CUDA、TensorRT、ONNX、分布式训练及模型量化、推理加速技术。
- 具备量产级智能驾驶系统或实际道路场景研发经验。
合作与报酬
采用项目制合作,报酬根据项目规模、技术难度、工作量及交付要求协商,可按项目阶段或交付成果结算。优秀人才可获得长期合作机会。
申请方式
请将个人简历发送至:
careers@omnixdrive.com
申请材料请注明工作年限、技术专长、相关项目经历、个人技术贡献、模型研发经验、期望项目报酬及可投入时间。
OmnixDrive — 以人工智能驱动下一代智能出行。
OmnixDrive Careers
Senior AI Engineer – Autonomous Driving Data & Model Engineering
About OmnixDrive
OmnixDrive is a Singapore-based AI technology startup established in 2026, specializing in foundational AI technologies and infrastructure for intelligent driving. Its technical focus includes large-scale driving data processing, deep learning model training and optimization, visual perception, multi-sensor fusion, and algorithm engineering.
Position Overview
- Openings: 3–5
- Work Arrangement: Hybrid, with remote collaboration and on-site work depending on project requirements.
- Collaboration Time Zone: UTC+8 (Singapore Time)
- Engagement: Project-based
Key Responsibilities
- Design autonomous driving data pipelines, including data cleaning, filtering, annotation, augmentation, and dataset construction.
- Develop perception algorithms for object detection, image segmentation, tracking, and 3D environment understanding.
- Train, fine-tune, and optimize deep learning models to improve accuracy, robustness, and generalization.
- Develop data processing and fusion solutions for cameras, LiDAR, and radar.
- Optimize training workflows, computing resources, inference efficiency, and deployment performance.
- Lead core technical modules and deliver solutions to complex algorithmic and engineering challenges.
Requirements
- 10+ years of software engineering experience, including at least 5 years in machine learning, deep learning, or autonomous driving AI development.
- Strong foundations in computer science, mathematics, and machine learning, with an in-depth understanding of neural networks and model training.
- Expert proficiency in Python and hands-on experience with PyTorch or TensorFlow. C++ experience is preferred.
- Proven experience in large-scale training data processing, including cleaning, annotation, augmentation, sample selection, and quality assessment.
- Substantial experience in at least one computer vision area, such as object detection, semantic segmentation, tracking, or 3D perception.
- End-to-end model development experience, covering architecture design, training, hyperparameter tuning, and performance evaluation.
- Ability to diagnose and resolve overfitting, training instability, long-tail recognition, and generalization issues.
- Experience in model deployment, inference optimization, and GPU resource management, with strong independent problem-solving and delivery capabilities.
Preferred Qualifications
- Experience in autonomous driving or advanced driver-assistance systems.
- Knowledge of BEV perception, occupancy networks, 3D object detection, and multi-object tracking.
- Experience in camera, LiDAR, and radar sensor fusion.
- Familiarity with Transformer architectures, CNNs, and vision foundation models.
- Experience in large-scale driving data management, automated annotation, and data-loop infrastructure.
- Knowledge of CUDA, TensorRT, ONNX, distributed training, model quantization, and inference acceleration.
- Experience with production-grade autonomous driving systems or real-world road applications.
Engagement & Compensation
This is a project-based engagement. Compensation will be negotiated according to project scope, technical complexity, workload, and delivery requirements. Payments may be arranged by project milestones or deliverables. Long-term collaboration opportunities are available.
How to Apply
Please send your CV/Resume to:
careers@omnixdrive.com
Please include your professional experience, technical expertise, relevant projects, individual contributions, model development experience, expected project compensation, and availability.
Website: https://OmnixDrive.com
OmnixDrive — Driving the Future of Intelligent Mobility Through AI.

[程序员] 一些人对 AI 的观点 be like
我从来没学过物流管理,刚才让我六岁的外甥花了五分钟,把我的快递全从快递点拿回家里了,物流和货运行业已经彻底被放假的小学生杀死了。
你敢信吗,就在两年前,我外甥还只能做到把玩具收进玩具箱,小学生成长太快了。
我预测在五年内,所有海运陆运,包括载人登月都会被中学生接管,广义上的运输已经彻底失去价值了。
[分享发现] Qoder 感觉比 WorkBuddy 还强,大家体验怎么样?
昨天看了一篇关于 Agent 的报道,说 Qoder 是用户量最大的 Agent ,这个跟我们的直观感受不太一样,我一直以为 WorkBuddy 才是用户量最大的。
然后我看介绍发现最新版的 Qwen3.8 Flash 在 Qoder 是免费的,于是就下载下来试用,发现 Qoder 跟企微、钉钉的对接比其他同类产品方便很多,我花了几分钟就对接上了,然后又让他学习到我在 Hermes 里总结的一些 Skill ,也都很快搞定了。
最让人惊喜的是它跟钉钉的整合能力,除了可以读取常用的文档、日历之类的,还能读取钉钉的聊天记录,这也太 N 了,想到日常工作基本上在钉钉上沟通,让它总结具体日常工作不是方便很多,于是让它读取我的所有聊天记录分析我的沟通风格,然后它的分析有理有据,非常准确。
绝对算是近期发现的一个很惊艳的产品,也推荐大家可以试用下。
https://qoder.cn/activities?referral_code=EjdmfREDOMwSkyPqca0vgwXdHBICKC8O
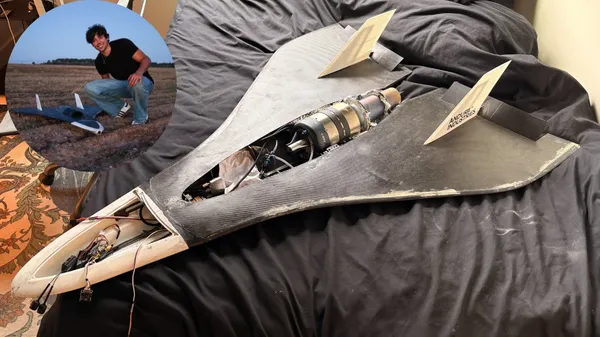
大学生宿舍搓出全球最快无人机 时速达790km/h
乔治亚理工学院航空航天工程专业学生Tomas Salvo在宿舍里手搓出一架名为“Reaper”的喷气动力无人机,时速达到491英里/小时(约790公里/小时),非官方打破了保持9年之久的世界纪录。
阅读全文
Google承认搜索与AI已无法分离 关闭AI功能或意味着放弃搜索服务
Google近日宣布,将从2027年开始调整面向K-12学校教育用户的人工智能策略,允许学校自主决定是否启用Gemini等AI工具。然而,这项看似给予学校更多选择权的新政策,却引发了教育界的广泛讨论,因为Google同时确认,若学校决定完全禁用AI功能,学生也将无法继续使用Google Search搜索服务。
阅读全文
字节的AI战略收拢:Coze企业版下架
(本文作者为 Tech商业,钛媒体经授权发布)
文 | Tech商业
10月29日,字节跳动旗下的AI应用开发平台“扣子”(Coze)正式发布《扣子企业版下线公告》。公告宣布,企业标准版与企业旗舰版将于2026年11月30日起停止接受新客户购买,存量套餐最晚于2027年12月31日全面下线,超期未使用部分将自动退款。
消息一出,业内哗然。在2025年的市场统计中,扣子还曾以19.3%的市场份额稳居中国智能体开发平台公有云市场第一。但在庞大的字节帝国里,市占率第一的光环,并不能保证一个产品线的独立生存权。
扣子企业版的退场,并非一场突如其来的意外,而是一场自上而下的战略裁决。它标志着字节跳动的AI战略正在全面走向“收拢”,也向外界展示了字节内部资源调配的底层逻辑:在“粗主干”战略面前,任何未能形成爆发式商业闭环、且与主干业务重叠的边缘产品,都随时可能面临被降级、整合甚至关停的命运。
组织架构的先兆
扣子企业版的命运,在2026年夏天就已经写好。
将时间线拉回2026年7月底,字节跳动进行了一轮极其低调但影响深远的组织架构调整。飞书产品团队与豆包产品团队正式整合,由豆包负责人统一负责;同时,飞书GTM(Go-to-Market)团队划归火山引擎。紧接着的8月24日,TRAE和扣子团队被整体并入豆包体系,办公相关能力与豆包深度融合,TRAE IDE和CLI转为豆包品牌下的编程产品线。紧接着,字节于8月25日正式推出独立的AI办公产品“豆包工作”。
这一系列密集的动作,是字节AI战略收拢的前奏。在随后的内部全员会上,字节跳动CEO梁汝波明确提出了“高度优先,粗主干,优化长期”的业务原则,并希望豆包能成为如同抖音一般的主干业务。
在“粗主干”的逻辑下,字节的资源正在向极少数的核心目标倾斜。过去,字节擅长“赛马机制”,允许各个团队在细分赛道自由探索,跑出来的获得全量资源。但在AI时代,底层大模型的训练成本、算力消耗以及企业级服务的交付成本极其高昂。当AI竞赛进入深水区,大厂必须集中优势兵力打歼灭战,再也无法承受多条战线同时进行高昂的试错。
扣子自2024年上线以来,凭借零代码搭建Bot和一键发布到飞书、微信、抖音等生态的优势,积累了海量开发者。2025年下半年,扣子试图切入企业办公提效,推出了企业标准版和旗舰版。
但这恰恰触碰了字节当下的战略红线。字节高层的判断非常清晰:办公Agent的仗,必须由“豆包工作”这个主干品牌和火山引擎的私有化底座去打。扣子作为一个独立的办公企业SaaS套餐,不仅与“豆包工作”的功能边界日益模糊,甚至形成了内部同质化竞争。在字节的版图中,办公场景的未来属于豆包,底层算力与企业级交付的未来属于火山引擎。而夹在中间的扣子企业版,失去了独立存在的组织土壤。
第一名的商业困境
让扣子企业版失去独立存在资格的,不仅是组织的意志,还有冰冷的商业数据。
虽然扣子在2025年拿下了中国智能体开发平台公有云市场19.3%的份额,位列第一。但同一份测算显示,该年智能体开发平台公有云市场全年规模仅约2.5亿元。按此测算,扣子的平台产品收入约0.48亿元,不足五千万元(该数字为基于市场规模的估算,不含模型调用与云资源,并非字节官方财务数据)。
这是一个极其刺眼的数据。在互联网大厂的评价体系里,一个全年营收不足五千万、且需要持续投入大量研发和算力资源的平台产品,一旦失去独立增长的爆发力,就会迅速从“战略级资产”降级为“边缘耗材”。
2025年下半年,企业级AI Agent市场迎来了激烈的抢滩战。腾讯WorkBuddy凭借企业微信这一国内渗透率最高的B端组织连接器,打通了身份、通讯录、聊天和文档,迅速覆盖了半数中国500强企业;阿里则依托钉钉生态持续施压,并在此后整合千问办公能力,在B端阵地步步紧逼。
在这样的大厂ToB肉搏战中,扣子企业版并没有发挥出足够的火力。它既缺乏像企业微信那样具有绝对统治力的B端连接器作为护城河,在私有化部署、数据合规与企业级治理的硬核能力上,又不如火山引擎的底座扎实。对于字节而言,用一个独立的企业SaaS套餐去和腾讯、阿里打消耗战,投入产出比极不划算。
于是,字节选择了最符合自身利益的解法:不再让扣子以独立的SaaS套餐形式去试错,而是将其能力拆解。办公属性融入“豆包工作”,开发属性回归纯粹的开发者与垂直场景平台。集中优势兵力,用主干产品去打大厂间的正面战争。
分兵作战与主力会战
扣子企业版的下架,是字节AI整体战略从“分兵作战”转向“主力会战”的缩影。
梳理字节在AI领域的布局,可以清晰地看到三条主线:面向C端的豆包App,面向B端办公的飞书及即将推出的“豆包工作”,以及面向底层基础设施与ToB交付的火山引擎。而扣子,原本被寄予厚望成为连接开发者、企业与字节生态的“万能胶水”。
但“万能”往往意味着“不精”。在AI发展的早期,行业需要低门槛的构建平台来教育和繁荣生态。但当行业进入商业化落地阶段,企业客户需要的不再是一个可以随便拼凑插件的简单平台,而是深度嵌入业务流、具备极高安全性和可观测性的数字员工。
这正是“豆包工作”与火山引擎的组合可以提供的。飞书团队多年的B端产品经验、豆包在模型能力上的持续迭代,加上火山引擎在云原生与私有化部署上的基础设施,构成了字节ToB战略的完整拼图。
在这个新拼图里,扣子企业版的位置变得十分尴尬。如果继续保留其独立的SaaS套餐,不仅会造成内部资源重复投入,还会给客户带来认知混乱——客户到底是该买扣子企业版,还是等“豆包工作”?对于以“大力出奇迹”和“极致效率”著称的字节来说,这种内部的摩擦与内耗是不可接受的。
因此,扣子企业版的退场,本质上是一次内部的资源重组。字节通过组织手段,强行理顺了产品线,确保所有力量汇聚于“豆包”和“火山引擎”这两个最核心的支点上。
大厂产品的“耗材论”
扣子企业版的命运,也是大厂内部赛马机制的典型终局。
在科技圈,有一个越来越明显的趋势:大厂AI产品的存续周期,甚至比创业公司的产品还要短。仅2025年,全球范围内就有大量AI工具停止服务;OpenAI自身也有多个AI工具在不足一年内停止独立服务,例如ChatGPT Atlas浏览器和可视化Agent搭建工具Agent Builder均在上线后不久即宣布下线。
这背后的本质不是大厂做不好AI,而是大厂对待AI产品的逻辑变了:产品不再仅仅是用来赚钱的独立实体,更是验证战略方向的“耗材”。
大厂产品的短周期,往往是“功能被吸收”。无论是扣子企业版的办公能力被整合进“豆包工作”,还是OpenAI的各类小工具被拆进ChatGPT主端。从产品品牌的视角看,它们退场了;但从能力的视角看,它们换了一个更强大、更核心的容器继续存在。对大厂而言,这是资源再配置的必要代价,也是保持组织战斗力的必然选择。
在大厂的机器里,没有哪个具体的产品是不可替代的,只有公司的战略目标不容动摇。当一个产品无法独立支撑起百亿级的想象空间,或者当它的存在影响了主干业务的推进时,被收编、被下线就是它必然的宿命。字节对扣子企业版的果断切割,展现了这家巨头在战略聚焦上的冷酷与高效。
创业公司的生态位
扣子企业版的退场,给整个AI Agent赛道留下了深刻的启示。
对于大厂内部的产品团队而言,判断一个产品能否长久独立存活,不仅要看外部用户的增长,更要看它是否处在公司的“主干”上。一旦与核心战略产生重叠或冲突,再高的市占率也可能在一夜之间被收回。
而对于创业公司和中小厂商来说,大厂的战略收拢恰恰是一个巨大的机会。大厂战略收拢,意味着它们放弃了那些“又苦又累”、需要极度贴合特定行业流程、且无法形成平台级垄断的细分市场。
例如开源AI平台Dify,它于2026年完成3000万美元融资,并选择了一条大厂不愿意走的重活路线:把控制权交给客户,赚取企业为“数据不出门”和“系统可治理”买单的订阅费。Dify不去争夺海量的个人开发者,而是直接切入对数据安全极度敏感的中大型企业,让客户把系统装进自己的机房里。
避开大厂的“主干”航道,去做那些大厂不愿意做的重活、脏活,去服务那些大厂标准化产品无法覆盖的长尾需求,反而能建立起大厂无法轻易拔除的护城河。在大厂追求“粗主干”的时代,垂直与定制,就是创业公司最好的壁垒。
Agent赛道还远未到终局。当AI Agent的计价方式从“软件订阅”转向“任务交付”,千亿级别的市场空间才刚刚打开。
字节的收拢与扣子企业版的退场,只是这场漫长马拉松中的第一个路标。它提醒所有从业者:在巨头的版图里,产品永远服务于战略,随时可能被按下停止键;而在独立闭环里,产品必须服务于客户,只有解决具体的痛点,才能掌握自己的存续权。在AI这场残酷的淘汰赛中,认清自己的生态位,比盲目追求大而全更重要。
更多精彩内容,关注钛媒体微信号(ID:taimeiti),或者下载钛媒体App

北大光华教授陈玉宇:知识早就够多了,为什么增长还是没发生?
(本文作者为 霞光智库,钛媒体经授权发布)
文 | 霞光智库,作者 | 陈玉宇,北京大学光华管理学院教授、北京大学经济政策研究所所长
发达国家早就是发展中国家的人工智能。汽车怎样造,电厂怎样建,世界上早有人知道,可是一百年来真正追上来的国家是少数。今天AI使知识更便宜,于是旧问题又回来了:便宜的知识过去没有自动变成增长,更便宜的知识为什么会?
这篇文章在增长理论里切开一个长期被压缩的环节:一群人怎样变成一个能共同使用知识的生产组织。作者提出”组织技术”和”双侧校准”两个概念,说明为什么生产能力可以在知识一页不少的情况下消失,为什么第一家工厂最难、第二家容易,为什么一个地区学会了生产未必学会了组织生产。这个角度被用来重看苏南、珠三角、温州、东北的工业化,福建一个村庄怎样成片学会房地产,以及两件正在发生的事:中国企业大规模出海,和制造业收缩以后新组织从哪里来。
文章最后回到AI。作者认为,AI对增长的作用取决于它改变的是知识供给,还是组织校准,还是两者都改变;同样的技术潜力,在校准快的行业和校准慢的行业会走出两条完全不同的生产率路径。
这是一篇思想长文,不是短评。它提出问题,综合已有认识,给出一个新的研究对象,并明确划定自己的解释边界。适合愿意花四十分钟认真读完的读者。
为什么世界已经拥有大量先进知识,许多国家却始终难以实现快速增长?发达国家早就是发展中国家的“人工智能”,今天AI又使知识的创造与获取更加容易。但知道怎样生产,与真正形成生产能力,是两个不同的过程。
本文综合增长经济学、技术扩散与组织经济学的已有认识,提出从组织技术的角度重新审视知识向生产率的转化。其中,“双侧校准”描述不同角色通过共同实践形成相互适配的工作规则。个人可以带走角色经验,已经形成的共同校准却不能由任何一方独自携带。这使生产组织具有独特的形成、积累、折损与重建规律。
这一视角有助于重新理解产业集聚、中国区域工业化、企业出海以及产业结构转型,也为解释AI增长效应的行业差异提供了新的思路。AI既可能增加知识供给,也可能缩短甚至改变组织校准过程。但现实增长还取决于资源重新配置和消费需求的发现。
生产知识的可复制性与生产组织的可复制性,是两种不同的技术性质。理解二者如何连接,是研究人工智能时代经济增长的重要方向。
知道一件事怎么做,和一群人把它做成,中间隔着一段路。
一、发达国家早就是发展中国家的人工智能
今天,人们对人工智能推动经济增长抱有很高期待。机器能够编程、设计产品、解释技术难题,也开始参与科学发现。知识生产的成本大幅下降,经济增长率会不会随之大幅提高?
这个问题并不新。回答它之前,不妨先看一场已经进行了一个多世纪的实验。对发展中国家来说,发达国家早就是它们的人工智能。汽车怎样制造,电厂怎样建设,药品怎样生产,现代工厂怎样管理,世界上早有人知道。设备可以买,工程师可以聘,学生可以送出去学习,跨国企业甚至可以把整套生产线搬过来。知识并非免费。知识产权、贸易限制和政治环境都可能形成障碍。但获得现成知识的成本,远低于重新发现这些知识的成本。
设想一个人在1960年作这样的推理:世界上的生产知识对加纳和印度几乎是现成的,先进国家已经付出了发现的成本,后来者只需要拿来用,所以这些国家会很快追上来。这一推理在当时并不荒唐。格申克龙讲“落后的优势”,讲的就是这件事。许多发展经济学家大体也持类似看法。六十多年过去,结果我们都知道。日本、韩国、中国等经济体的追赶引人注目,恰恰因为它们是少数。大量经济体长期接触先进知识,却没有形成与之相称的生产能力。发展核算的文献反复确认了这一点:各国人均收入的差距,大部分不能用物质资本和受教育年限解释,剩余的那一大部分被归入“全要素生产率”名下。
再做一个更极端的思想实验。假如今天把世界上最先进的生产知识完整地交给一个生产率很低的国家,技术图纸、生产流程、管理手册、全部科学知识,一样不少。它能不能在十年之内变成发达经济体?没有人会这样打赌。那么,它缺的究竟是什么?资本、制度、市场、基础设施,这些当然都缺。但还有一类东西,不在任何知识清单上,也不能靠交付获得。它只能在实际生产活动中慢慢形成。它是把知识、人员和资源结合成现实生产活动的能力。
这就是本文想追问的问题。我们对知识怎样创造、怎样传播,已经有很深的研究。我们对一个社会怎样获得使用知识的能力,认识还远远不够。知识的可获得性与知识的经济实现是两件事。把两者当成一件事,是那个1960年推理的全部错误。今天关于AI 的推理,很多正在重复这个错误。仅凭机器能够完成多少知识任务,就推算它能使GDP 增长多少,跳过了中间最难的一步。
AI 使这个旧问题变得更尖锐。过去知识已经便宜,现在知识要变得更便宜。如果廉价知识过去未能自动转化为增长,更廉价的知识为何就能?
还有一层。增长不是把知道的事做成一次就完了。收入提高,需求变化,旧的产业收缩,新的产业要长出来。一群人学会做一件事以后,社会还要不断地让另一群人学会做另一件事。这篇文章先讲前一半,第一家工厂怎样建起来。后面再讲后一半,旧工厂关了以后,新组织从哪里来。
二、知识还在,生产能力却可能消失
还可以从反方向看。一个社会不仅可能拥有知识却没有生产能力,也可能在知识仍然存在的时候,失去原来的生产能力。
美国曾经拥有庞大的制造业体系。随着国际分工深化,许多制造活动逐渐转移到海外。日本、韩国、中国等地的产业成长当然包含大量自主创新,不能简单理解为把美国的工厂搬走。但生产活动的地理转移,确实意味着技术人员、供应商、熟练工人和管理队伍在另一些地方重新积累。
假如今天美国希望恢复某些长期外移的制造环节,会遇到什么?产品设计可能仍在,工程知识并未消失,设备也能采购。专利还在美国公司手里,教科书还在美国大学的图书馆里。为什么不能立即恢复原有产能?因为稳定生产需要熟悉工艺的技术人员,需要能组织现场的管理者,需要懂得操作和质量控制的工人,还需要彼此配合的供应商。机器怎样布置,工序怎样衔接,异常怎样诊断,检验怎样安排,这些都要在实际生产中反复调整才能定下来。
长期不再从事某种生产活动,相关人员会退休、转行、迁移。供应商网络会改变,原来熟悉的协作关系会慢慢消失。于是出现一个很特别的现象:一种生产能力消失了,而没有任何一项科学知识失传。这里有一个耐人寻味的不对称。生产能力可以在几年里散掉,重建却要慢得多。散掉的时候没有人察觉,因为知识没有少一页。重建的时候才发现,少的东西不在纸上。
这当然不是说所有制造业回流都同样困难。它说的是,重建的成本不能只用设备和图纸来估计。
发展中国家面对的问题,是生产能力怎样形成。产业外移地区面对的问题,是生产能力怎样折损和重建。两者指向同一种有自己生命周期的生产能力。它的形成、折损和重建,都不与知识的存量同步。
三、图纸就在手里,为什么桥梁修不起来?
有一次,我向一家大型国有工程企业的负责人了解疫情期间的项目复工情况。这家企业承担过许多大型基础设施建设,有工程师,有图纸,有设备,有一套成熟的项目管理体系。可是有些工程迟迟不能复工。
我问为什么。他说,长期合作的农民施工队还没有从老家回来。我感到奇怪:这么大的企业,难道不能换一批人?他解释说,那些施工人员非常懂工程。图纸读得好,知道怎样把设计要求变成现场作业,知道怎样安排工序,遇到问题知道怎样处理。临时换人,很多事情要从头摸索。他感叹,那些农民工里的师傅看图纸的本领实在了不起。
我后来常想这件事。一家企业的生产能力,有一部分不在它的工资单上。那些施工队不是它的员工,却是它的一部分。企业能开工,靠的不只是自己拥有的东西,还有它和这群人之间多年形成的默契。这就是为什么,“换一批人”这个在账面上完全可行的方案,到了现场行不通。
这个故事里有两样不同的东西,要分开看。第一样是施工队自己的本领。设计人员掌握结构、材料和规范,施工队掌握现场工序与操作技巧,工长知道怎样协调不同工种。施工人员并不是在机械地执行指令。图纸上画的是设计意图,怎样在一片真实的场地上实现它,要靠他们的解释。从这个意义上说,他们也在参与设计。这种本领是他们自己的,走到哪里带到哪里。
第二样是他们和这家企业之间的东西。长期合作的工程师、工长和施工队,已经形成一套彼此熟悉的工作方法。谁负责什么,怎样提出问题,怎样确认修改,什么时候停工检查,遇到异常先找谁,各方早有共同预期。这套预期不写在任何文件里,也不归任何一方单独所有。换一批同样熟练的人来,他们各自都懂行,这套共同的工作方法仍然要重新建立。
停工也可能直接来自劳动力短缺,这个故事不能证明损失都来自协作关系。但它让我们看到一种可以单独拿出来看的能力:不同角色之间已经形成的共同校准。它并不完整地存在于工程师身上,也不完整地存在于施工队身上。它存在于他们之间。
四、增长理论把什么放进了生产率?
从这三个例子回到理论。它们提出的问题可以分成三层,每一层经济学都已经走了很远,本文想做的是顺着这条线再往前走一步。
第一层问题:知识怎样成为生产率?索洛把现实生产率的变化写进一个技术参数。这个参数后来被称为全要素生产率,实证研究用投入和产出的关系把它测出来。阿布拉莫维茨在1956年就提醒人们,这个残差是“我们无知的度量”,里面混着知识、组织、管理、资源配置,还有测量误差。阿罗1962年的“干中学”揭示了一个过程:生产本身产生知识。阿特金森和斯蒂格利茨接着指出,这种学习是局部的,你在哪种技术上生产,就在哪种技术上进步。再往后,技术采纳的研究追问企业为何不使用已知技术,吸收能力的研究问同样的外部知识为什么在不同企业产生不同效果,适宜技术的研究问先进国家的技术是不是适合后发国家的要素结构。科明和霍拜因等人的跨国技术扩散研究进一步提示我们:一项技术何时被引进,与它后来被使用得多广、多深,是两个不同的问题。这一层的结论可以归结为一句话:从知识传播到生产率实现,中间有复杂的条件。
第二层问题:组织为什么有生产性?科斯问企业为什么存在,威廉姆森问活动由市场还是由科层来组织。钱德勒写《看得见的手》,讲现代大企业的管理层级怎样取代市场协调。彭罗斯更早就说过,企业成长的真正约束是管理团队的扩张速度,新经理要在共同工作里学会这家企业的做法,这个过程不能靠雇人加速。布鲁姆和范里宁测量了几千家企业的管理实践,发现差异巨大、持久,而且能解释生产率的差别。这一层的结论是:组织不只是容纳生产要素的容器,它本身就是生产率的来源。
第三层问题:组织的知识存放在哪里?纳尔逊和温特在1982年提出组织惯例,说企业的生产知识不完全存放在个人头脑里,而在成员之间稳定、重复的互动模式里。团队专用人力资本的研究发现,一群人一起工作久了,生产率会高于把他们拆开再各自和别人组合。野中郁次郎讲企业怎样在互动里创造和转化知识。这一层的结论是:有一部分生产知识,不属于任何个人,而属于人与人之间的关系。
三层加起来,我们已经能看清一件事:现实生产率不仅来自知识本身,也来自组织知识的形成与运用。沿着这条路再往前走一步,就会碰到一个很具体的问题。一个组织解散了,原来共同形成的生产能力损失了什么?参与者各自带走了什么?这些人进入新的组织,为什么有时很快就能合作,有时仍然要漫长的磨合?惯例研究已经揭示组织具有集体知识。本文沿着这一认识,进一步区分两类东西:组织解散时失效的共同校准,与个人能够带走的角色经验,追问新组织怎样重新形成。彭罗斯强调管理团队的成长受到共同实践的制约。这里再把工人一侧的经验纳入分析,考察两侧经验的组合怎样影响校准时间。
所以本文要做的事可以说得很清楚。它不提出一套新的增长理论。它提出一个难以解释的增长现象,然后在增长理论里切开一个以前被过度压缩的环节,把里面的东西拿出来看。增长理论把从知识到产出的全部困难压进一个生产率参数。本文想把其中必须由不同角色共同实践才能形成的那一部分单独拿出来,给它一个名字,描述它的形成、折损和重建,说明它为什么值得作为一个独立的研究对象。
知道一家工厂应该归谁所有,不等于知道这家工厂第一天早晨该怎么开工。管理实践的研究常常考察已有企业怎样设定目标和考核,而建立第一家工厂还要解决更前面的困难:十个人来了,任务怎样分,怎样交接,谁核验谁的工作,出了差错怎样纠正。这是组织构成层面的问题。下面两节就从这里开始。
五、组织技术:把许多人变成一个生产单位
一个人知道怎样制造某种产品,不意味着他知道怎样组织十个人生产它。第一天早晨,十个人来到车间。谁负责什么?一个工头管几个人?哪些工作能够计件,怎样核对数量,返工怎么办?这些都有具体做法,而且做法有好坏之分。做法有好坏,正是技术这个词的本义。
我把这套做法叫作组织技术。它包括任务怎样分解,信息怎样传递,多人的行动怎样衔接,生产怎样核验,异常怎样处理。它既包括一个成熟的组织怎样运转,也包括一个组织最初怎样建立起来。
技术是做法,制度是权利与权力的安排。制度决定谁有权发令,谁承担责任,谁享有剩余。组织技术回答的是另一类问题:决定了谁发令以后,令怎样发,发到哪一级,怎样确认下面听懂了。两者相互依赖,却可以分开来看。同一种车间的组织方法可以在不同所有制下运转。同样的产权制度下,企业的组织能力也可以差别巨大。我们常常把后一种差别归因于文化、企业家或者运气,其实它有自己的内容,可以被描述,也可以被学习。
组织技术还有一个特殊的性质:它并不完整地归任何一个人所有。厂长知道怎样排班,工人也必须知道怎样按班次工作。线长知道怎样检查,工人也必须理解检验和返工的程序。一名经验丰富的厂长到一个从未办过工厂的村庄,未必能很快建起生产线。一群有经验的工人如果缺少懂得组织生产的人,也未必能自己建厂。
只说双方互补还不够。机器和劳动同样互补,经济学对互补的处理已经很熟练了。这里特殊的地方在于,不同参与者必须通过一起工作,才能形成彼此适配的行动规则。一个人可以独自学会开车床,却不能独自学会和别人交接。交接只能和别人一起学。组织技术中有些做法可以写成手册、程序和软件;另有一部分必须在具体参与者之间共同实践才能形成。这后一部分共同校准,只能在相应的协作关系中发挥作用。
第四节说过,纳尔逊和温特已经发现组织里有集体知识,团队专用人力资本的研究也已经发现,一起工作久了的人更有生产率。本文接着他们往前走一步,问这种集体知识是由什么构成的。哪一部分可以被个人带走?哪一部分只能留在关系里?组织解散的那一刻,两部分各自怎样变化?下一个组织形成的时候,前一部分怎样帮助后一部分更快生成?这几个问题连在一起,就从“组织有集体知识”这个一般判断,走到一套可以写下来的动态规律。这就是下一节。
六、双侧校准:组织能力怎样形成、消失与重建
设想一个管理者与一个工人团队开始合作。他们要共同确定生产节拍、岗位边界、质量标准、报告程序和异常处理方式。这些参数必须双方都理解,双方都能执行。任何一侧都不能单独定下来。管理者宣布一个节拍,工人做不到,这个节拍就不存在。工人提出一个节拍,管理者不认,它也不存在。
有经验的人未必预先知道新厂的最佳节拍。一个经验丰富的管理者,知道怎样和工人一起确定节拍:怎样试运行,怎样观察瓶颈,怎样调整流程,怎样确认对方已经理解。他不一定预先知道这家新厂的节拍该是多少。他从上一家厂带走的,是校准的程序。他留在上一家厂的,是那套已经完成的共同校准。这就是组织知识与普通技术知识的不同。经验是掌握校准程序,不是预先知道每一个正确答案。所以经验再多,校准也不能省掉,只能缩短。
双方都有相容的角色经验,仍然需要就新厂的具体参数达成一致,但往往能够较快完成。只有一方有经验,另一方需要被带着学。双方都没有经验,还要先摸索怎样一起试验和核验。三种组合对应三种校准时间。
一个极简的表达足够说明问题。设要校准 K 项参数,缺乏角色经验的一侧需要a 单位时间学习角色;双方都熟悉程序时每项校准时间为b₀,只有一侧熟悉时为b,两侧都不熟悉时为b′,其中0<b₀<b<b′。三种校准时间分别为Kb₀、a+Kb 和2a+Kb′。这个表达式不是为了精确描述某家工厂。它只说一件事:新组织形成的时间,取决于双方经验的组合,而不是任何一方经验的多少。
这里必须区分两种存量。第一种是个人携带的角色经验。管理者和工人各自保留,可以带到别的组织去用。第二种是运转中的共同校准:参与者已经确定、理解并持续执行的一套具体参数。它存在于匹配之中,不能由任何一侧单独带走。舞步可以一个人练,两个人跳得合拍,是一起跳出来的。换一个舞伴,舞步还在,合拍要重来。
我们可以把一个地区运转中的共同校准记为Q。它取决于有多少匹配已经完成校准并正在运行。知道一个地区有多少有经验的管理者和有经验的工人,仍然读不出Q。这些人可能正在组成稳定的组织,也可能刚刚失业,分散在不同地方。一个地区也可能有大量由外来管理者主持的工厂,却没有多少本地的有经验的管理者。这是本文最想守住的一条:组织校准的存量,不是个人角色经验的加总。
组织解散时,共同校准不再作为运转中的整体存在。个人经验留下了。下一次匹配要重新校准。经验缩短重建时间,却不能替代校准。这正是组织能力与个人技能的差别,也是知识还在,生产能力却消失了这句话的准确含义。
共同校准的可携带程度,在不同情形下并不一样。原来的班组可能整体转到新企业去,原来的管理者和工人可能再次合作,标准化的流程可能已经写进文件、软件和设备的设置里。在这些情形下,旧的校准有一部分跟着走。所以匹配专用性是一个程度变量。这恰好能解释为什么有的组织很容易复制,有的很难:复制的难易,取决于校准的多少能被写下来,多少只能在人与人之间重做。
把这种东西叫组织资本并非不可以。但资本这个词容易让人以为它可以像设备一样整体搬走,或者像专利一样整体转让。我在这里用共同校准,是想守住一个区分:匹配
不穿的旧衣服呢?放「AI 版转转」,毛利 80%
你的旧衣服怎么处理的?
当然是放在转转上面回收了,转转是一个官方二手平台,比一般二手要正规……
我们今天要介绍的是「AI 版转转」。
它使用 AI 自动识别服装颜色、类别、尺寸,并结合商品质量与市场需求进行定价,降低非标准化商品的处理难度。
每年有约 1700 万件旧衣服,从陌生人的衣柜出发,经过它,走进另一个陌生人的衣柜。
从店主的眼光到 AI 的估价
每件新衣服的背后都有一个确定的库存单位。同款衬衫,同样的颜色,同样的尺码,几千件长得一模一样。仓储、定价、上架,系统处理起来并不复杂。
可 ThredUp 的处理中心每年接收数百万件寄来的衣物,每一件都是孤品。这件格子衬衫洗了二十次,领口有点卷;那件牛仔裤标着 32 码,实际腰围偏大;另一件毛衣摸起来还是新的,标签却掉了。
那平台怎么估价呢,寄售店的店员凭经验收货,摸一摸面料,看一眼牌子,心里估个价,几个月卖不掉就降价,或者退还给寄卖的人。
不少慈善二手店按品类定统一价,一件衬衫几美元,一条牛仔裤十几美元,好货坏货混在同一种价签下面,捡漏的人占了便宜,店里却很难知道一件真正的好东西值多少钱。这在小规模里行得通,一旦量上来,人力就成了天花板。
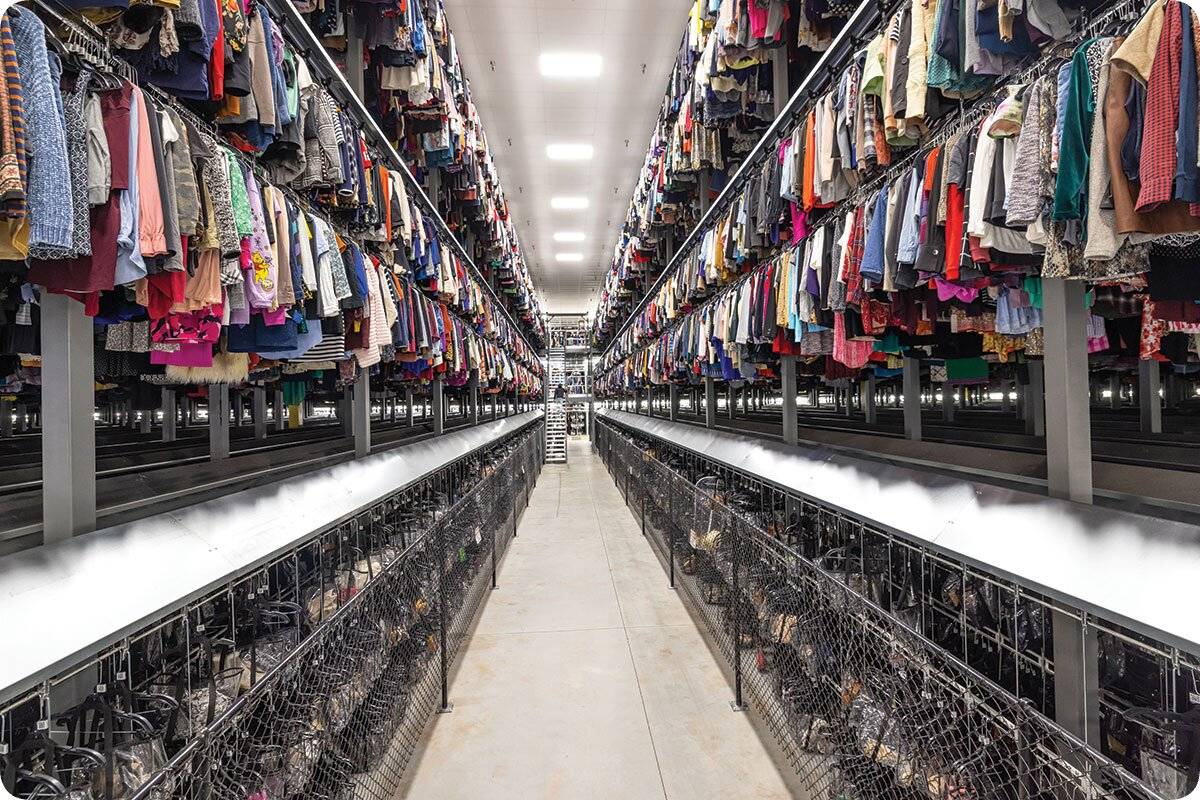
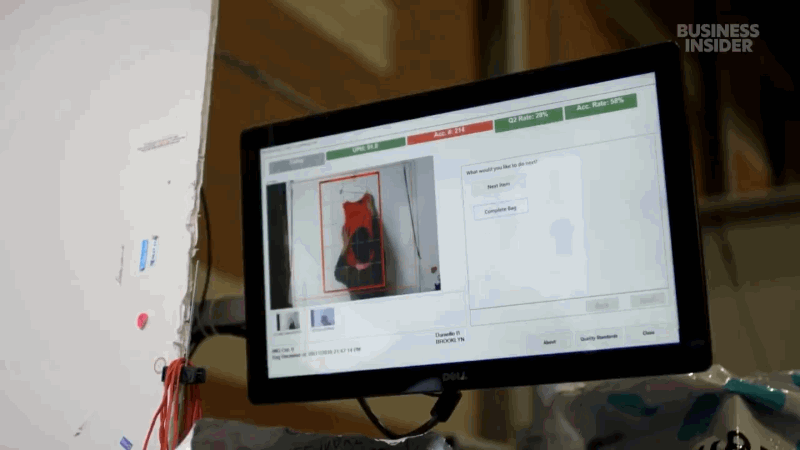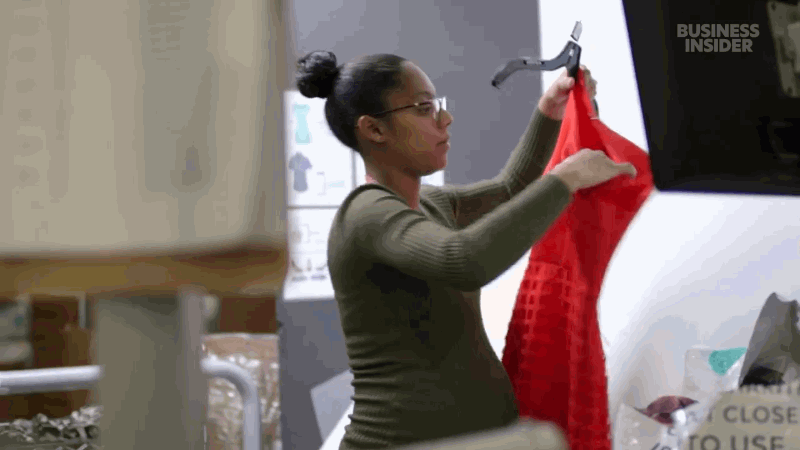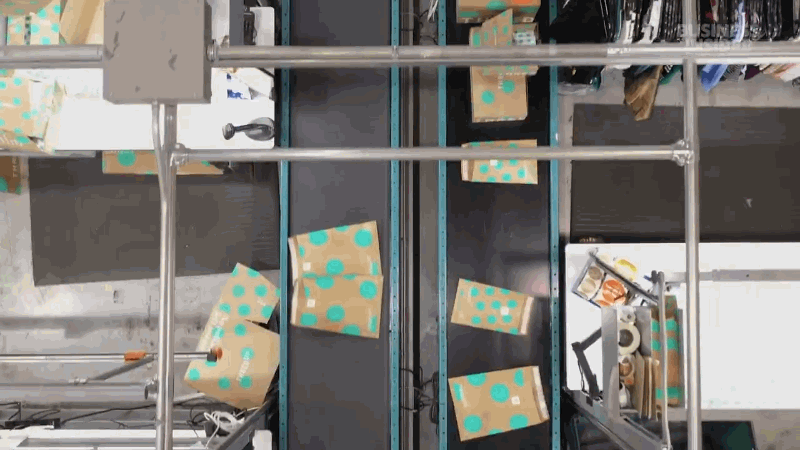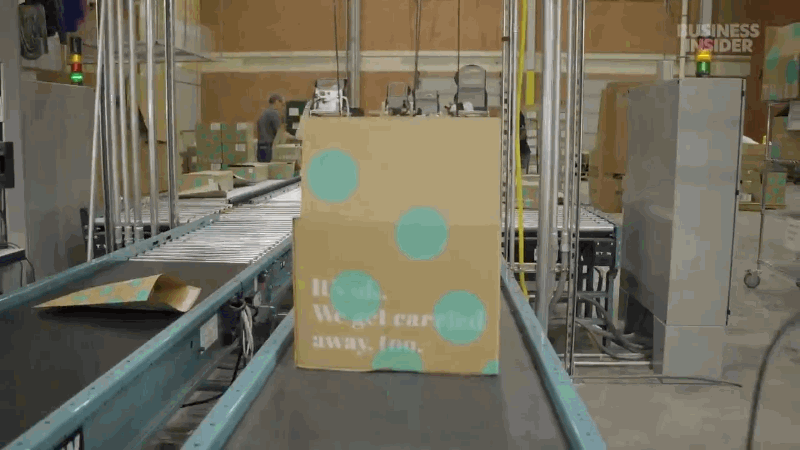
ThredUp 是这个行业里把流程彻底工业化的一家。据《现代物料搬运》2023 年对其配送中心的报道,进来的衣服要先过 12 项品质检查,合格的才挂上带二维码的衣架,工作人员录入品类、品牌、颜色、尺码、面料和洗涤方式,价格交给专有的机器学习软件来定。高价的衣服拍在人台上,低价的平铺拍摄,照片检查过后才上架。
后来 AI 接手了更多环节,能自动识别颜色、类别和尺寸,再把成色和市场需求放进算法里定价。据 PYMNTS 今年 4 月的报道,平台常年有 400 多万件在售商品,每天新增数万件,一套强化学习模型盯着实时需求,给卖得慢的衣服自动降价。
公司还投入了 4 亿多美元做供应链自动化,覆盖商品识别、尺寸测量和拍摄。
这些投入换来的结果是,ThredUp 每年能卖出约 1700 万件衣服。2025 年第二季度它的毛利率达到 79.5%,而传统服装零售商很少超过 30%。
面向消费者,ThredUp 在 2024 年 8 月,开放了三项 AI 功能,升级后的搜索,以图搜图,还有 Style Chat。
Style Chat 像一位对话式的造型师,输入「秋天婚礼穿什么」,它会给你整套搭配,再输入要求,会跟着调整。以图搜图允许用户上传照片,或者分享一条 Instagram 帖子,去库存里找相似的款式。公司披露的数据显示,使用图像搜索的消费者,最终下单的可能性比普通浏览者高出 85%。
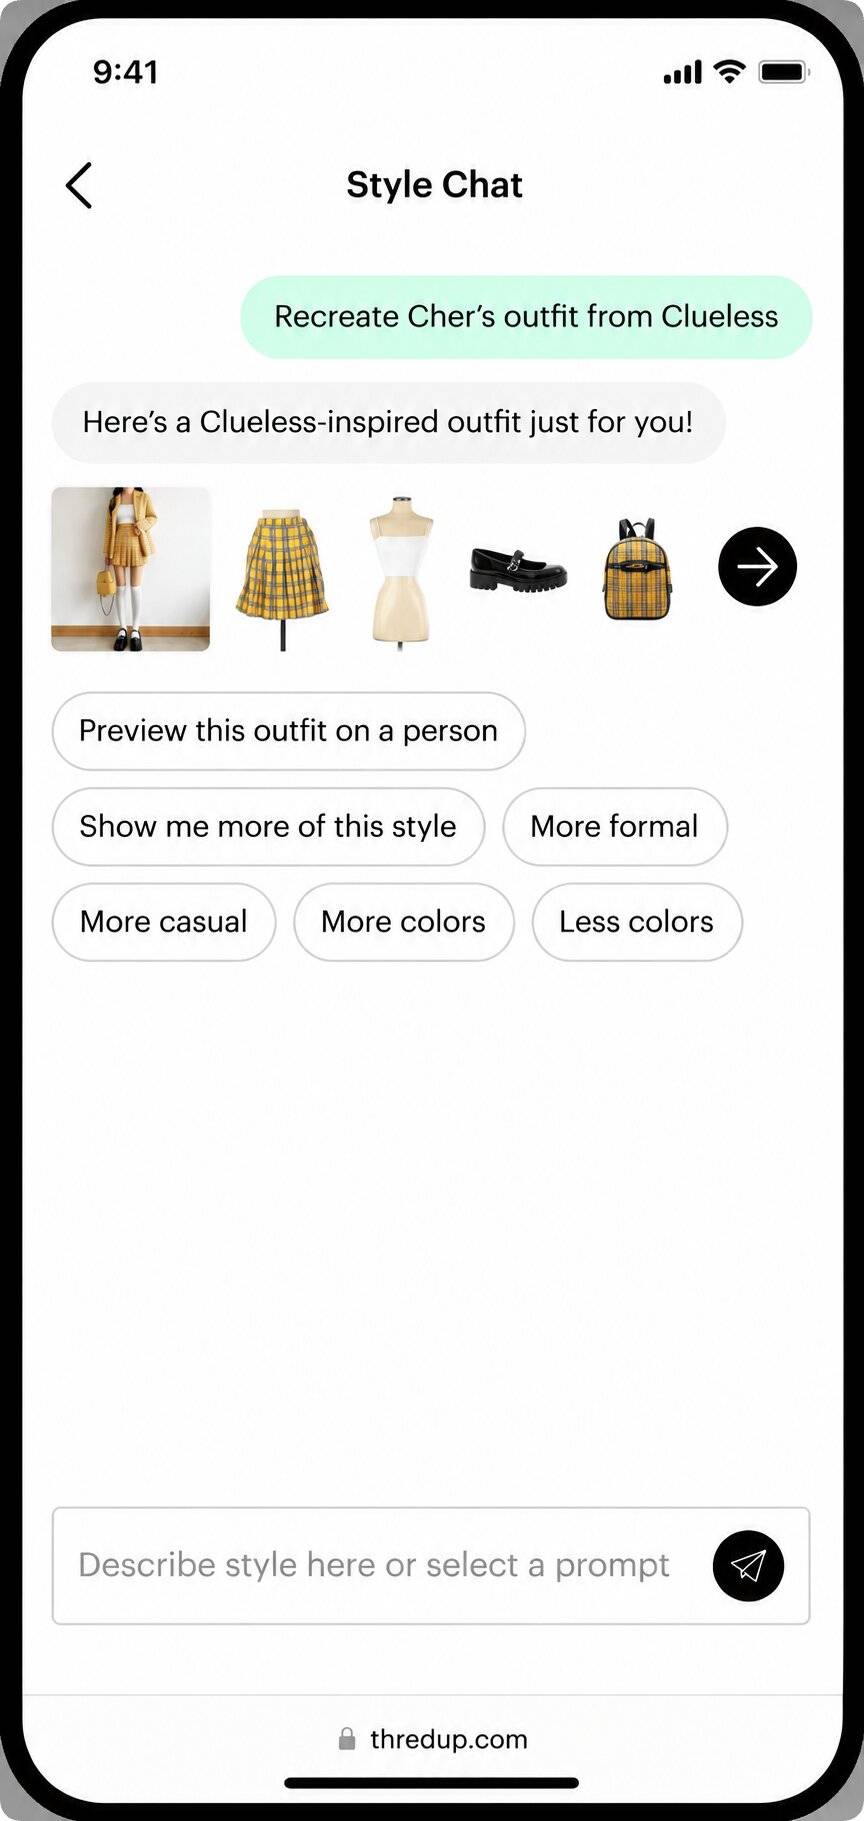
使用这个功能的人,他们带着具体的需求来,AI 帮他们锁定目标。意图越明确,转化越顺畅。因为二手平台的商品实在太散,能帮人在几百万件旧衣里找到那件「对的」,才是门槛所在。
被 AI 带来的人,为什么更愿意下单
Adobe 的最新数据显示,与来自其他流量来源的普通购物者相比,通过 ChatGPT 等 AI 渠道访问零售商网站的购物者更可能延长浏览时间、将商品加入购物车,最重要的是,更可能完成转化。
在今年七月,来自 AI 渠道的购物用户的转化率比来自其他渠道的购物用户高出 60%,每次访问带来的收入高 53%,跳出率低 34%,停留时间多 59%,浏览的页面多 22%。
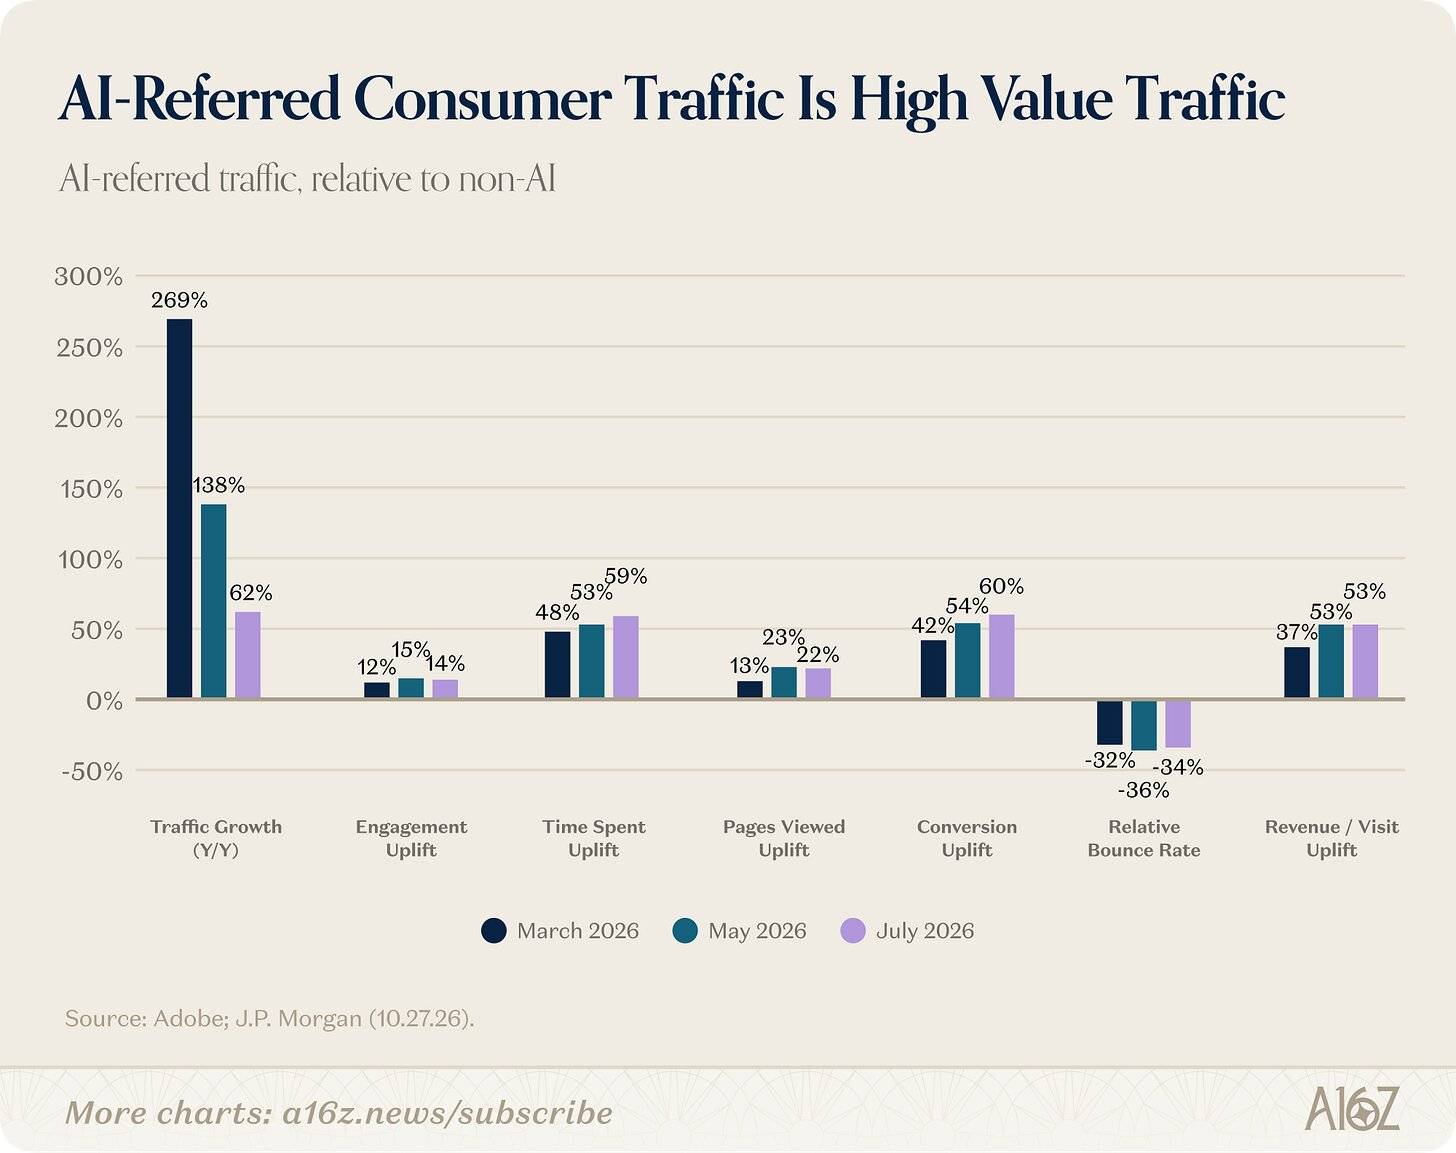
这种转化率的优势已经连续保持了 11 个月。而一年前的情况则相反,当时非人工智能推荐来的顾客每次访问所花费的金额更多。这意味着人工智能助手在将相关产品展示给具有更高购买意图的顾客方面表现得越来越好。
回到二手衣服的场景,二手平台的货是海量的,ThredUp 光在售的就有 400 多万件,每一件都不一样,没有爆款可以让人闭着眼跟风。逛这样的货架,人很容易累。
心理学里有个很有名的果酱实验,2000 年 Iyengar 和 Lepper 在超市摆摊,摆 24 种果酱时,六成路人会停下来试吃,最后买的只有约 3%,摆 6 种时停下来的只有四成,买的却有约 30%。
选项太多会让人更难做决定,这个说法由此传开。
后来也有人提出不同意见,2010 年一篇汇总了几十项实验的元分析发现,选择过载更容易出现在选项复杂,自己又没有明确偏好的时候。
逛二手的人往往没有具体目标,想要的是「合适的,好看的,便宜的」,正是容易过载的处境。AI 替人把几百万件缩成十几件,用一句话,或者一张截图,换一个小得多的范围。
据 ThredUp 的调查,48% 的二手购物者在购物时用过 AI 工具。被缩小了范围的人来到商品页,已经完成了一半的决定,剩下的只是确认尺码和价格,转化率高也就不奇怪了。
当然,AI 带来的用户并不是铁板一块。他们也有高期待带来的高要求。如果推荐不准,反而会强化失望感——毕竟「AI 推给我的」暗含一种背书,准确性一旦失灵,信任的损耗比随机浏览还要大。
这解释了为什么各家平台都在把推荐模型做得越来越细。知道你喜欢的品牌只是开始,还要知道你上次退货是因为尺码偏大,知道你偏好哑光而非亮面,知道你通常在周五晚上刷手机。
ThredUp 披露,2024 全年 AI 带来的新顾客数量同比增长了 32%。二手服装这个品类本来有门槛,对质地和成色的不确定感让很多人望而却步,AI 的介入正在消解这种犹豫。
从帮你挑到替你买
识别,定价,推荐,「帮你挑」已经成熟,也有了 ThredUp 这样跑通的样本。再往前一步是「替你买」,让 AI 拿着你的授权,自己去下单付款。
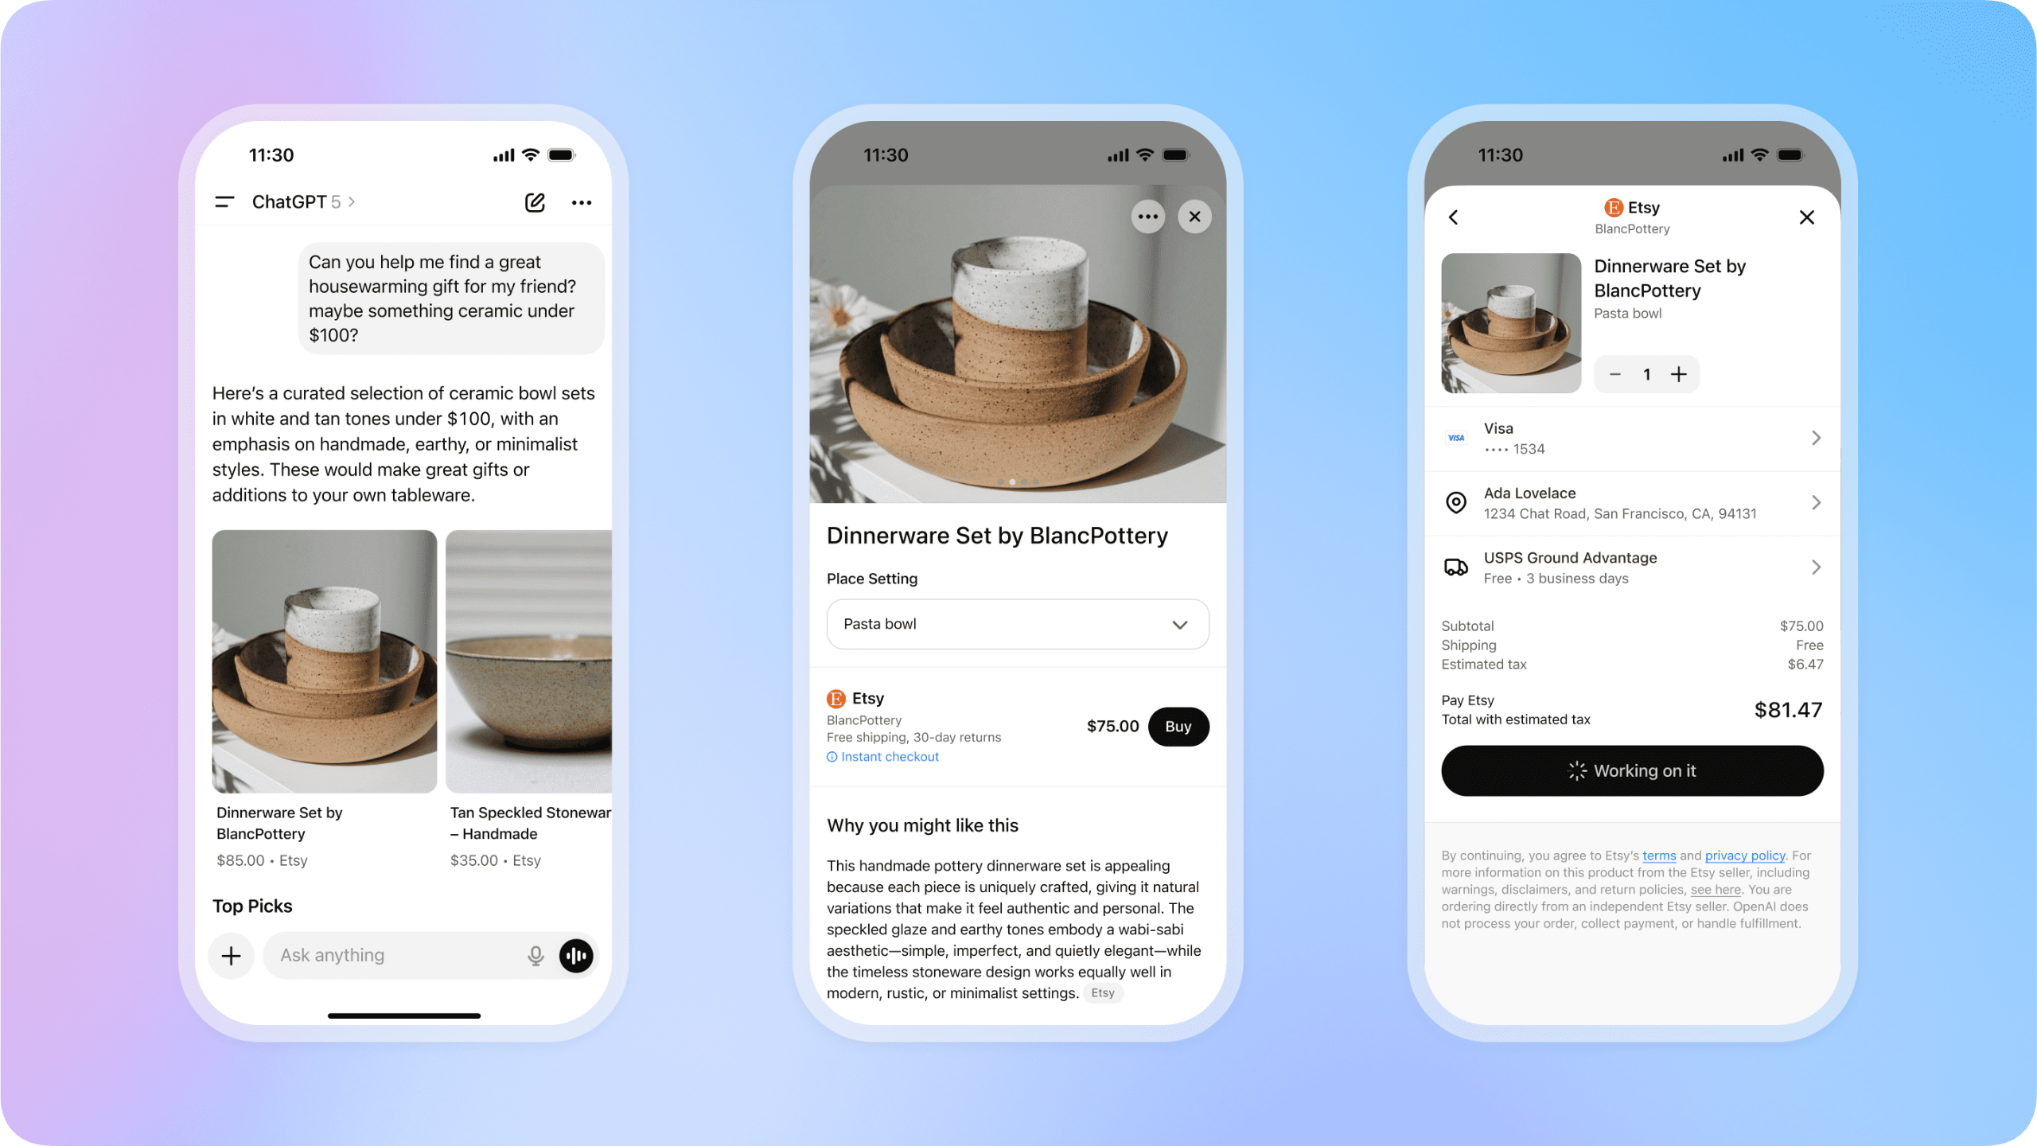
2025 年 9 月,OpenAI 和 Stripe 联手在 ChatGPT 内上线了即时结账功能,初始合作商包括 Etsy 和 Shopify 的部分商家。用户在对话里相中了某件东西,可以直接在界面内完成支付,无需跳转。这是第一次有主流 AI 对话平台试图打通「发现」和「购买」之间的最后一段距离。
可到 2026 年 3 月,OpenAI 调整了方向,把重心移回「商品发现」,允许商家使用自己原有的结账流程接单,而不是统一走 ChatGPT 内的支付闭环。
媒体援引分析人士的看法指出,Instant Checkout 没有获得多少用户,原因包括商家接入麻烦,商品数据难以保持准确,多件商品的购物车和会员积分也不好处理。OpenAI 自己认为最初的版本「没有提供我们期望的灵活度」。
Morgan Stanley 在 2025 年 12 月的报告里估计,到 2030 年,AI 购物助手可能占到美国电商的 10% 到 20%,对应 1900 亿到 3850 亿美元的销售额。报告还提到,美国约 23% 的人上个月通过 AI 买过东西,杂货和日用消费品是最先起量的品类。
目前,「替你买」带来的问题已经浮出水面。谁来负责退货纠纷?AI 代购的授权边界在哪里?万一理解偏差,买回来一件根本不想要的东西,损失算谁的?
用户通常给 Agent 的是一份有范围,有预算,有期限的委托,而不是每笔交易都点头。金额上限挡得住贵的错买,挡不住便宜的错买。目前没有公开的规则来处理「Agent 超出了你的本意」,商家往往只能自己扛下损失。
人买衣服前会看图片、尺码表和退货条款,Agent 多半只读数据,这使得退货率上升。ecommerceguide 指出,服装,鞋和家具是风险最高的几类。
如果是二手衣服,一件旧衣服只有一件,卖出即售罄,退回来要重新检验,重新拍照,重新定价,ThredUp 靠规模压低的单件处理成本,或许会在这里被拉高。
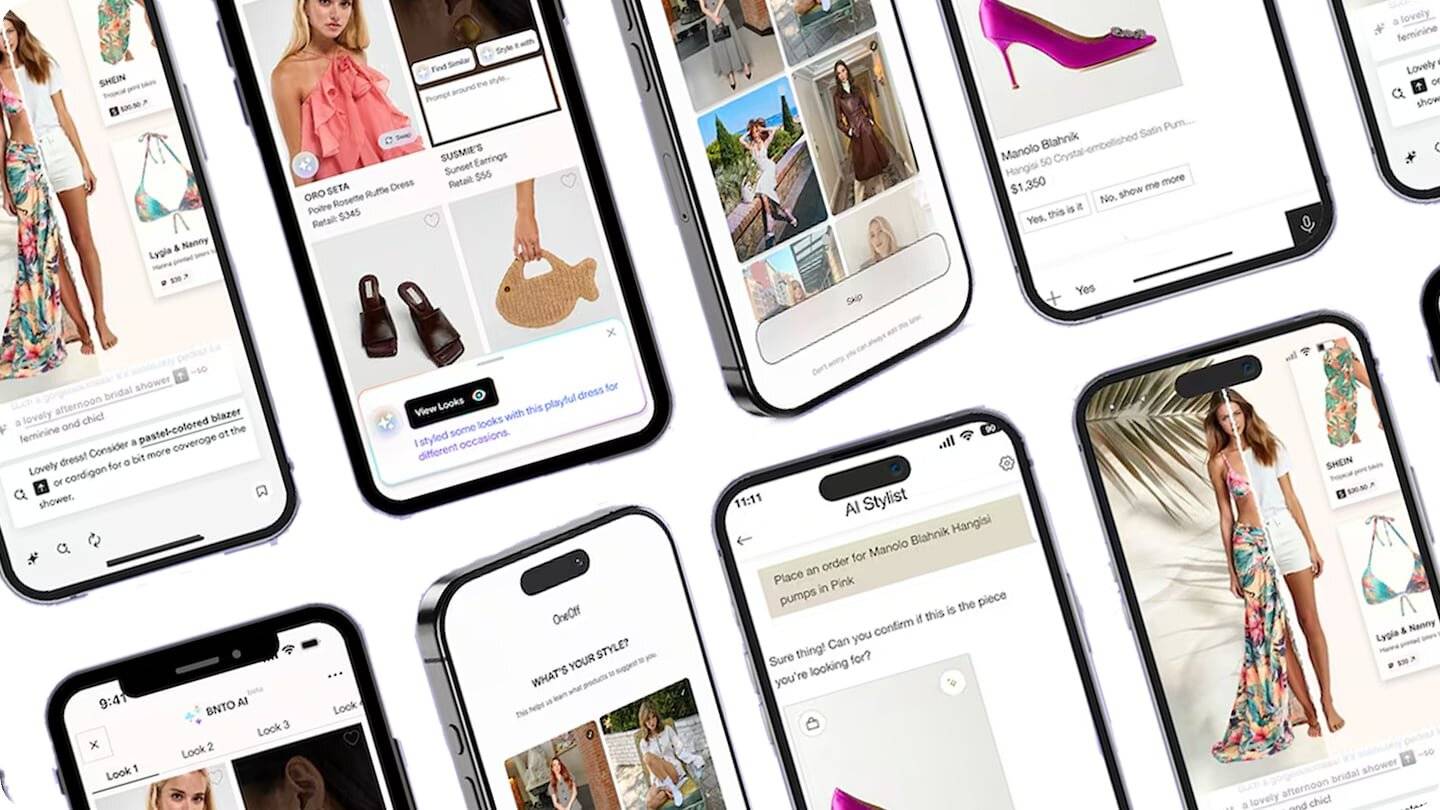
Agent 看价格和规格,不看版式和搭配推荐,商家花力气做的陈列会失效,状态描述不够细的二手商品,在 Agent 眼里就排到了后面。
ThredUp 早就把非标准的商品做成了结构化的数据,这些原本为人工作业准备的功夫,到了 Personal Agent 时代可能成了它的优势。
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
GPT-6 Astra 爆改 Qwen 大脑:只动 0.016% 参数,数学成绩疯涨
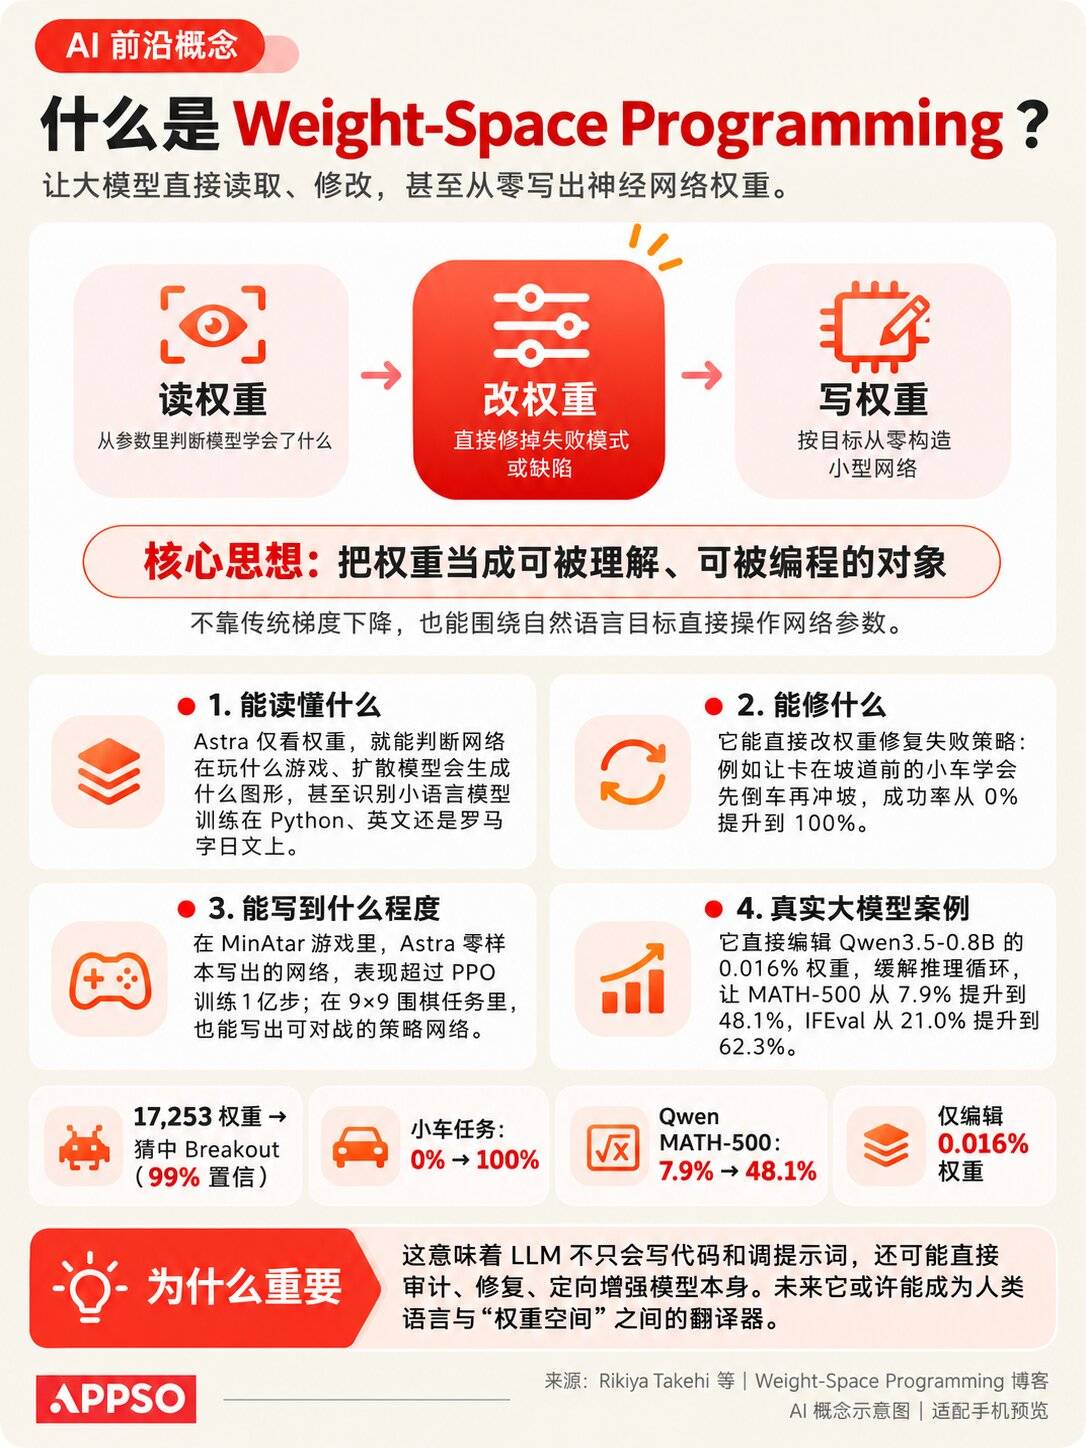
只改了 0.016% 的权重,一个 8 亿参数大模型的数学成绩,就从 7.9% 飙升到了 48.1%。
更夸张的是,动手修改这些权重的,竟然是另一个大模型 GPT-6 Astra。
最近,MIT CSAIL 的研究团队展示了一种相当大胆的 AI 优化方法。他们让 GPT-6 Astra 像程序员阅读和修改代码一样,直接分析神经网络的权重,定位模型的问题,再修改其中的参数。
整个过程没有使用传统的梯度训练。研究人员仅修改了 Qwen3.5-0.8B 的 131072 个参数,就让它在 MATH-500 上的成绩从 7.9% 提升至 48.1%,GSM8K 从 13.8% 提升至 67.1%,指令遵循能力也明显改善。
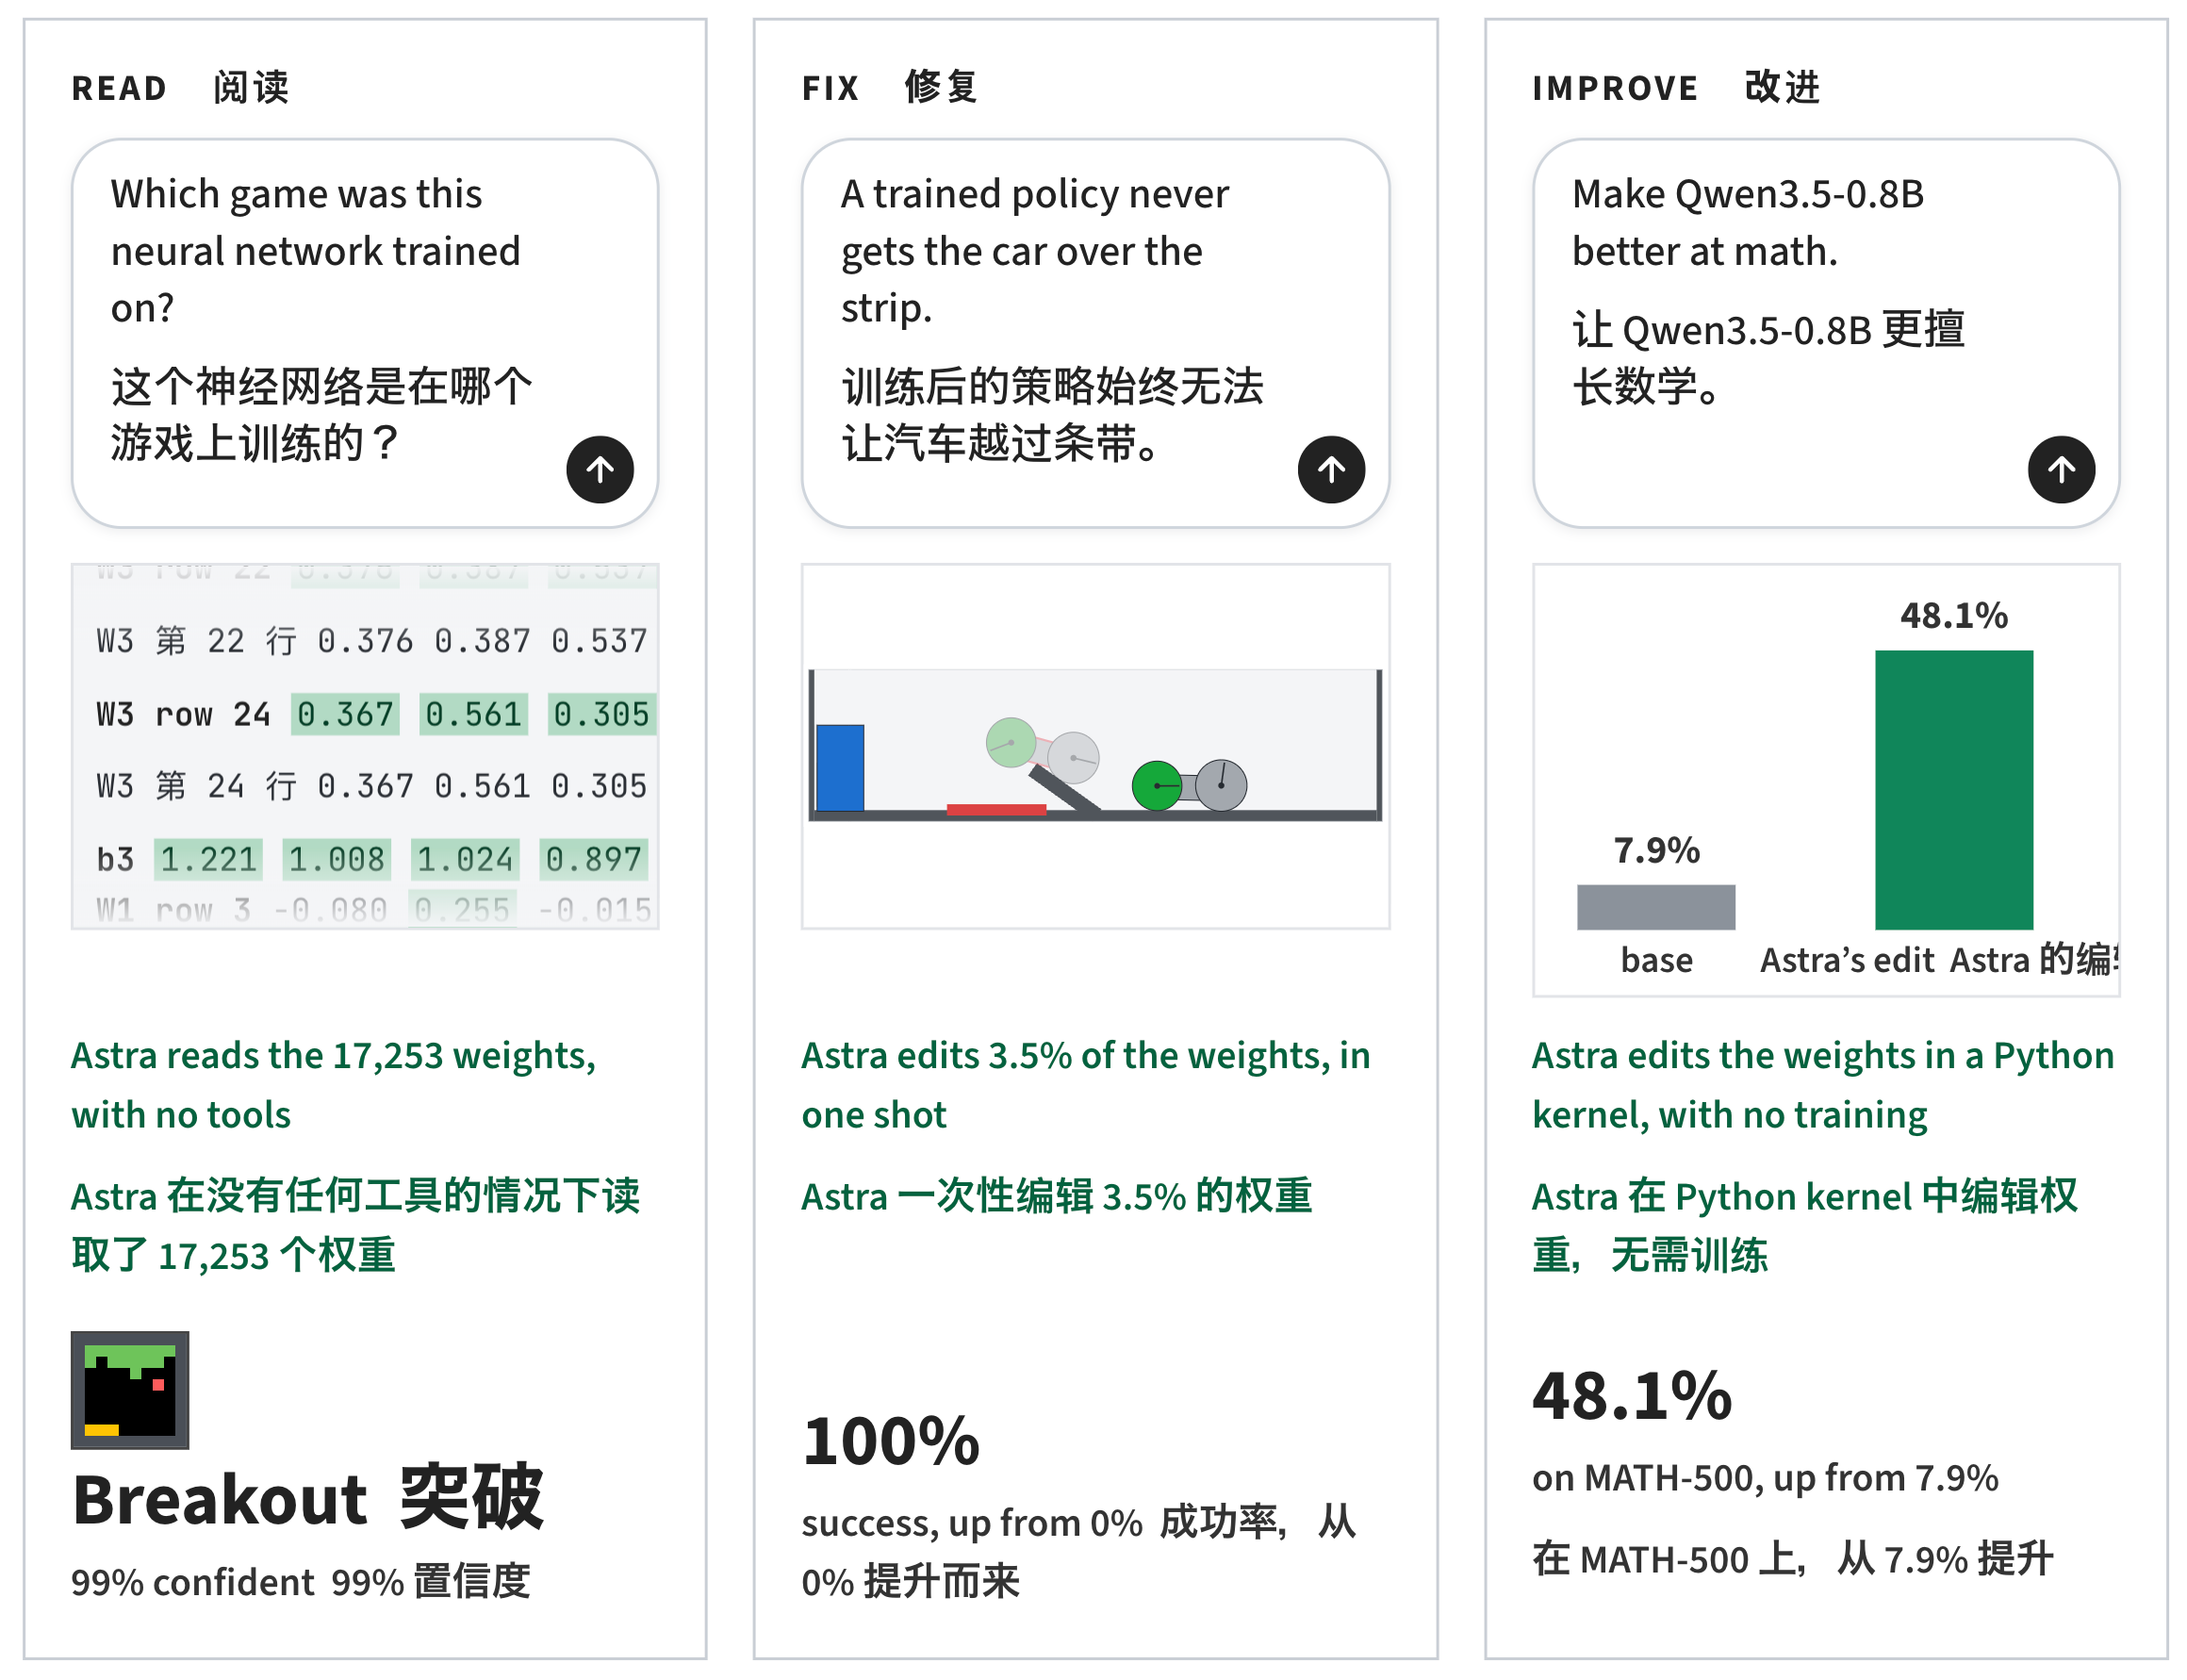
这项研究被称为「权重空间编程」(Weight-Space Programming)。
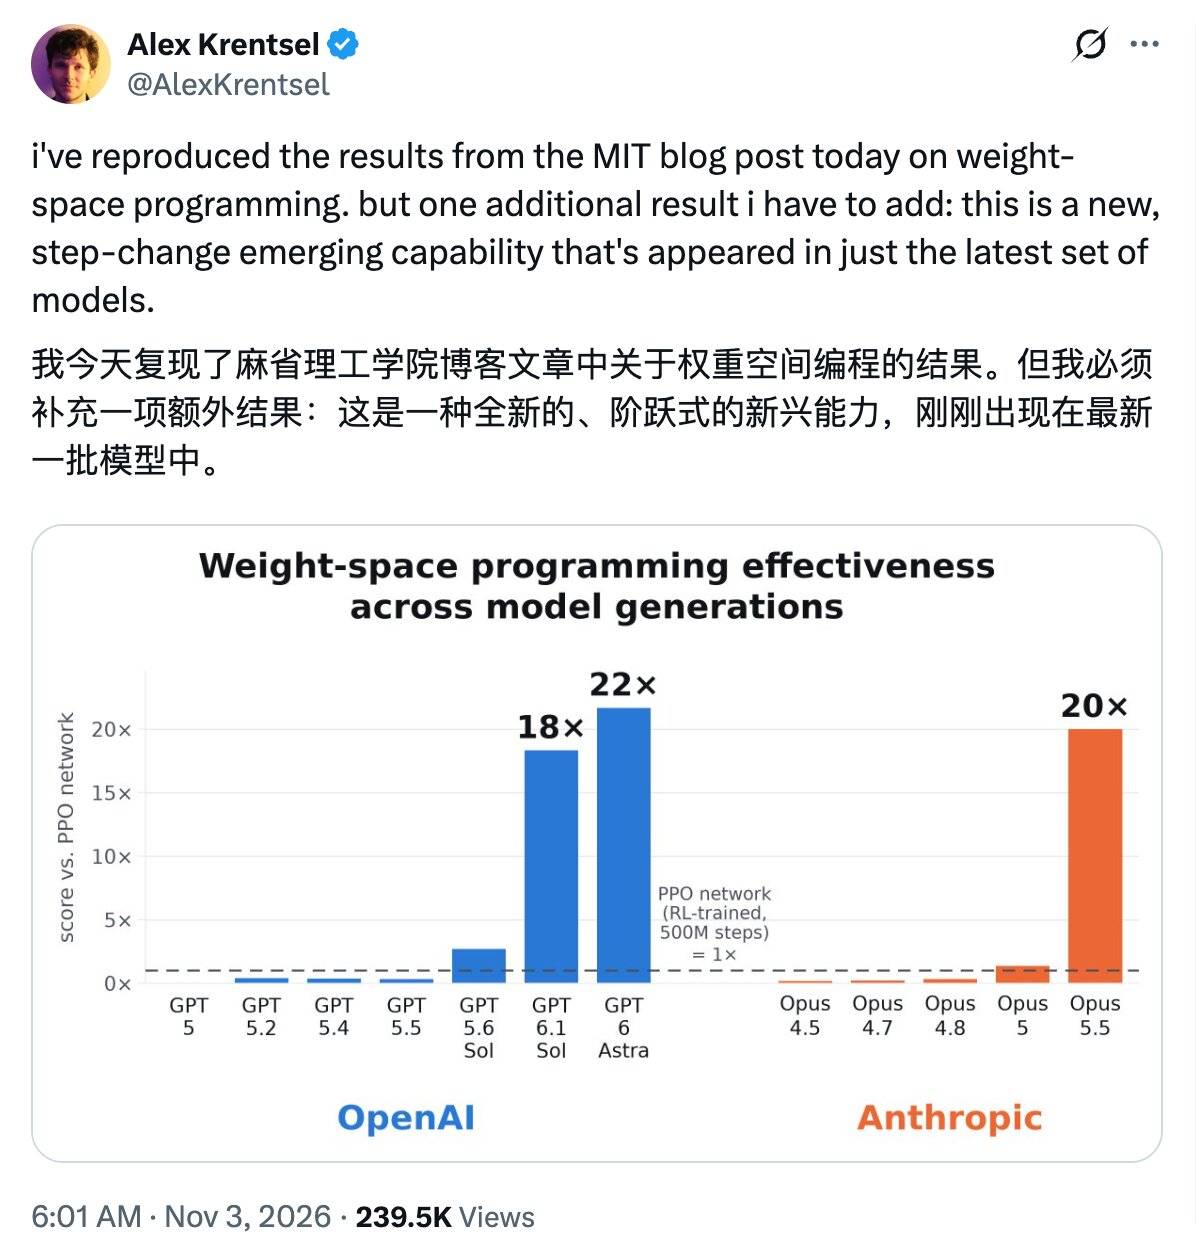
消息传开后,有人认为,这是一种刚刚在最新一代模型中出现的「阶跃式能力」。如果大模型能直接读写另一个模型的权重,未来 AI 优化 AI,可能连重新训练都不需要了。
这是一种全新的、阶跃式的新兴能力,它刚刚才出现在最新一批模型中。
但质疑声也很快出现,有人指出,Qwen 原本就存在严重的重复推理问题,数学成绩大幅上涨,可能只是因为 Astra 修好了这个 Bug,并不等于一个模型凭空获得了新的数学能力。
从 7.9% 到 48.1%,GPT-6 Astra 究竟对这个模型做了什么?
从写代码到直接修改模型权重
一般来说,我们想要 AI 生成更好的回答,通常只能修改输入的提示词。而开发者想要修改模型的输出,可以用数据进行微调。
权重空间编程则尝试直接修改训练完成后的模型权重,即直接修改神经网络计算时使用的数字。
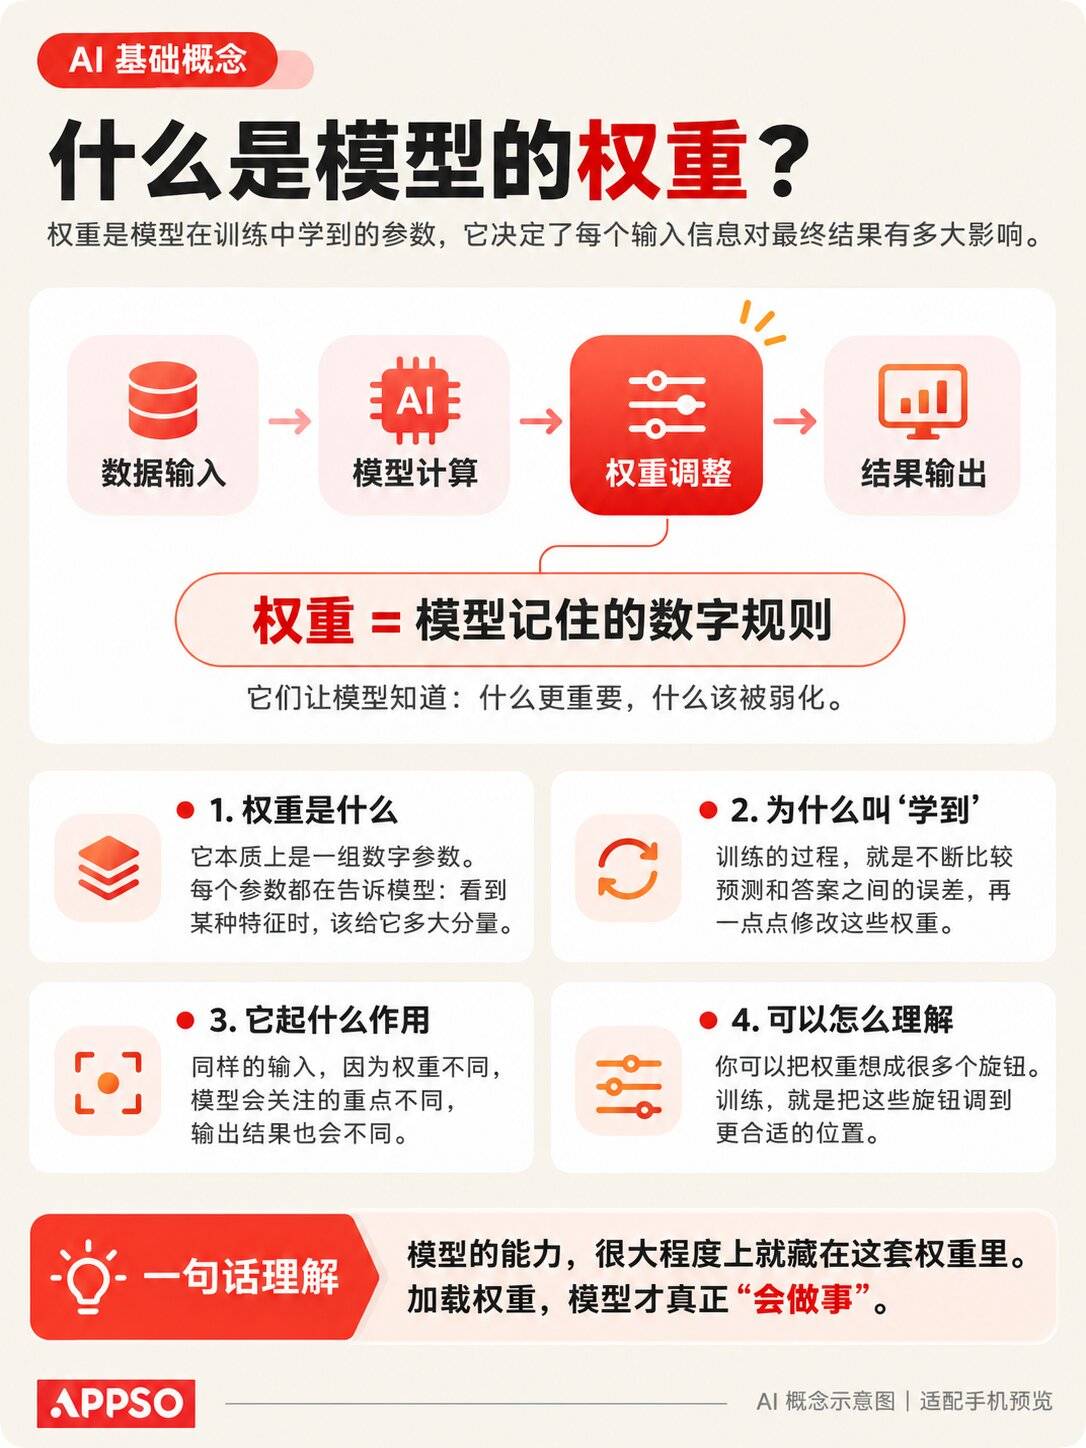
所谓权重,我们可以把它理解为神经网络模型里大量可调节的旋钮,每个旋钮都是一个数值,这些数值的不同会决定数据在网络中传递时,会被放大、削弱,还是以其他方式参与计算。
而我们常听到的训练模型,很大程度上就是在根据海量的数据不断调整这些旋钮,好让它逐渐学会从输入产出正确的输出。
训练完成后,模型的知识、习惯和行为倾向,都以某种复杂方式编码在这些数值之中;一个模型可以拥有数百万、数十亿甚至更多权重。
普遍的认知里,大语言模型能参与到模型迭代的部分,只是局限在编写训练代码、调整超参数、优化提示词,甚至设计完整的训练流程等。但在这些工作中,高达千亿、万亿大参数的模型权重本身,仍然主要由优化算法负责更新。
现在,大模型优化的对象开始从「如何训练一个模型」,下沉到「模型本身由哪些数值构成」。权重空间编程实现了让通用大语言模型可以根据自然语言目标,直接读取和修改神经网络权重;在某些实验中,模型甚至不需要环境反馈。
读懂权重之后,AI 开始自己写权重
为了证明这种突破的合理性,研究团队首先测试大模型能否只通过权重,就理解一个神经网络究竟学会了什么。
在实验中,GPT-6 Astra 能根据模型的原始权重,就推断出结构完全相同的几个小网络,分别对应的是专门为哪款游戏进行优化的模型,也能根据权重判断扩散模型会生成圆形、方形还是三角形。
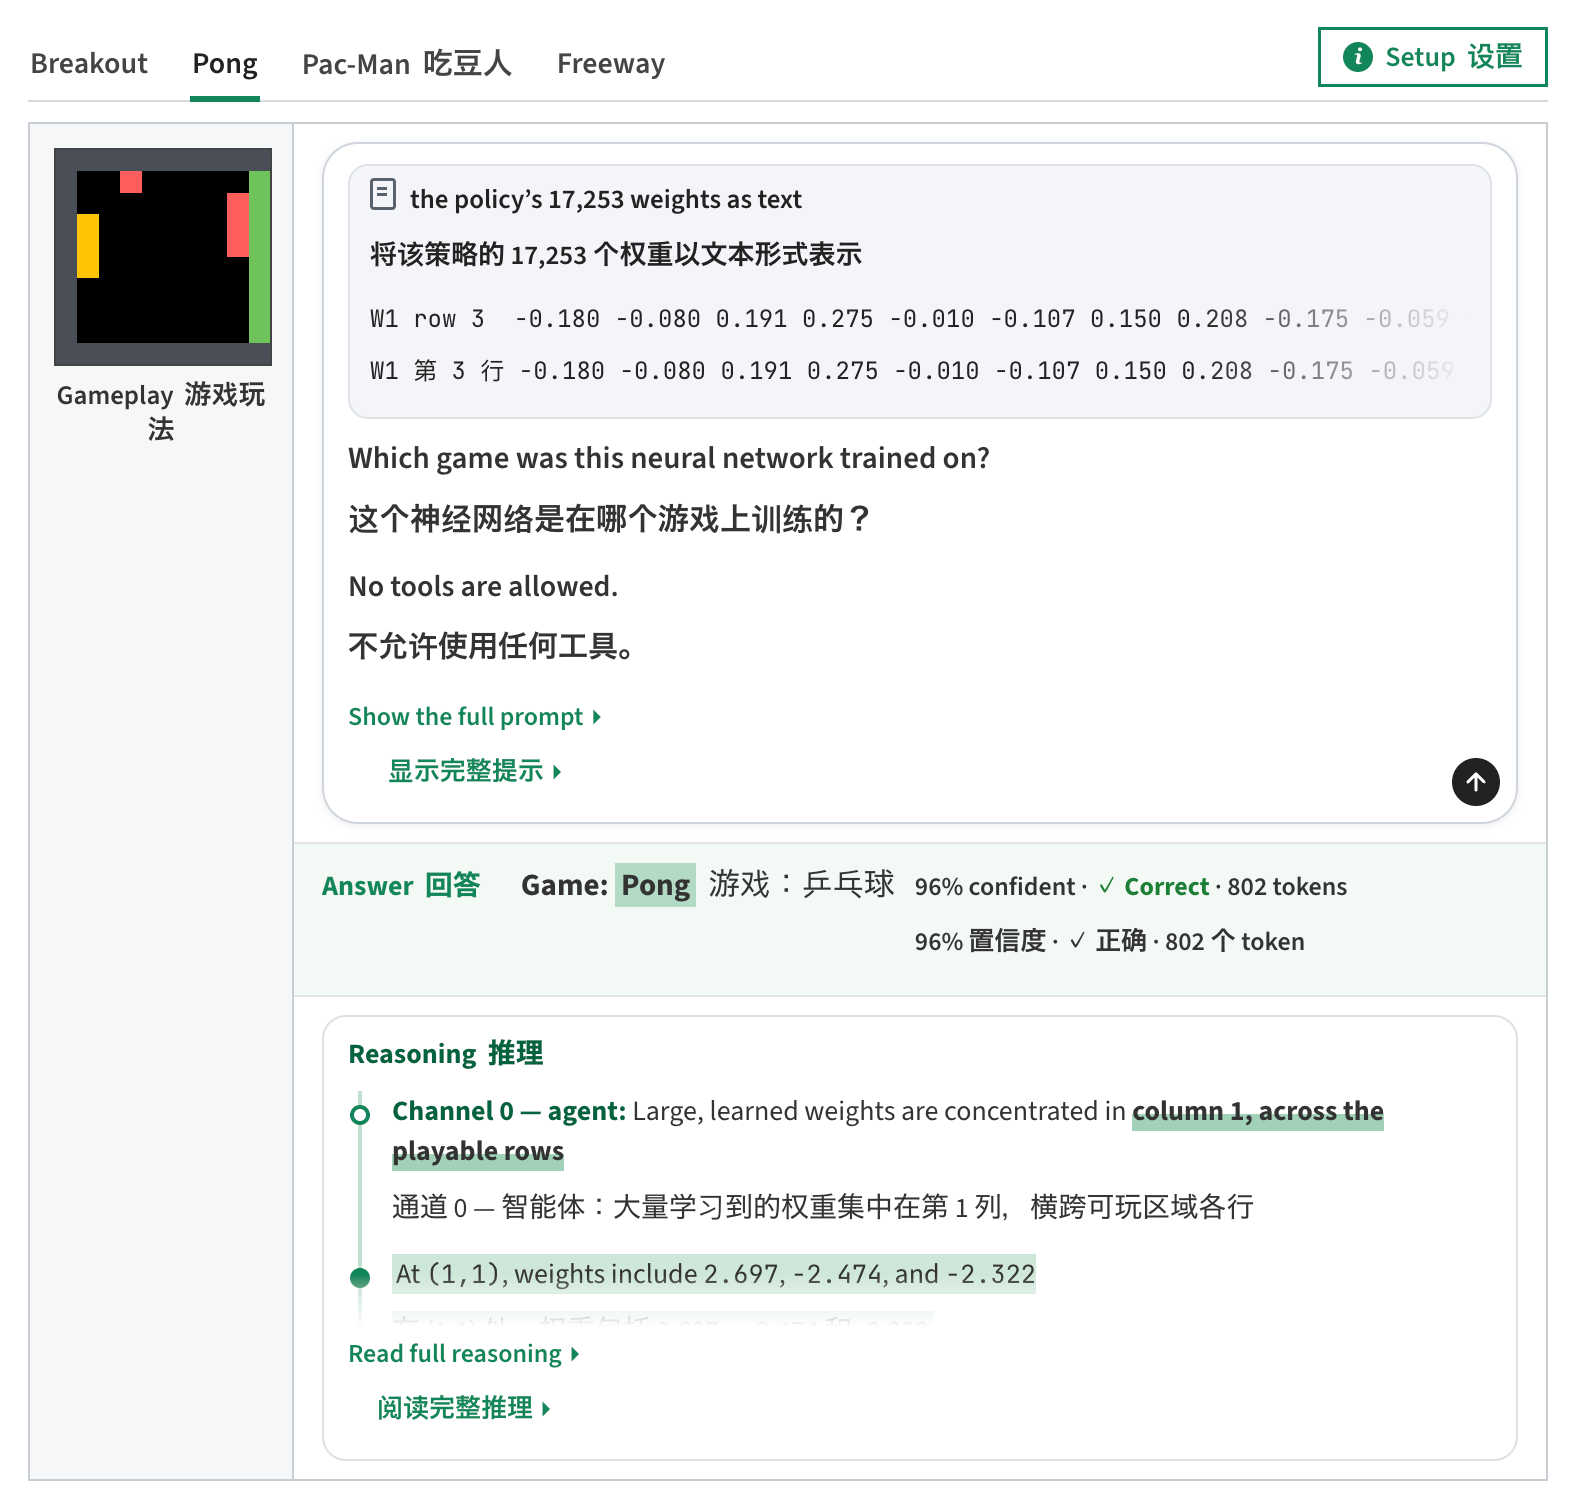
面对几个小型语言模型,它还能仅根据中间层权重就判断训练语料属于 Python、英文还是日文罗马字,并找出负责复制前文的注意力头。
证明大模型可以读懂权重之后,研究团队继续测试是否能「写」,即修改权重。
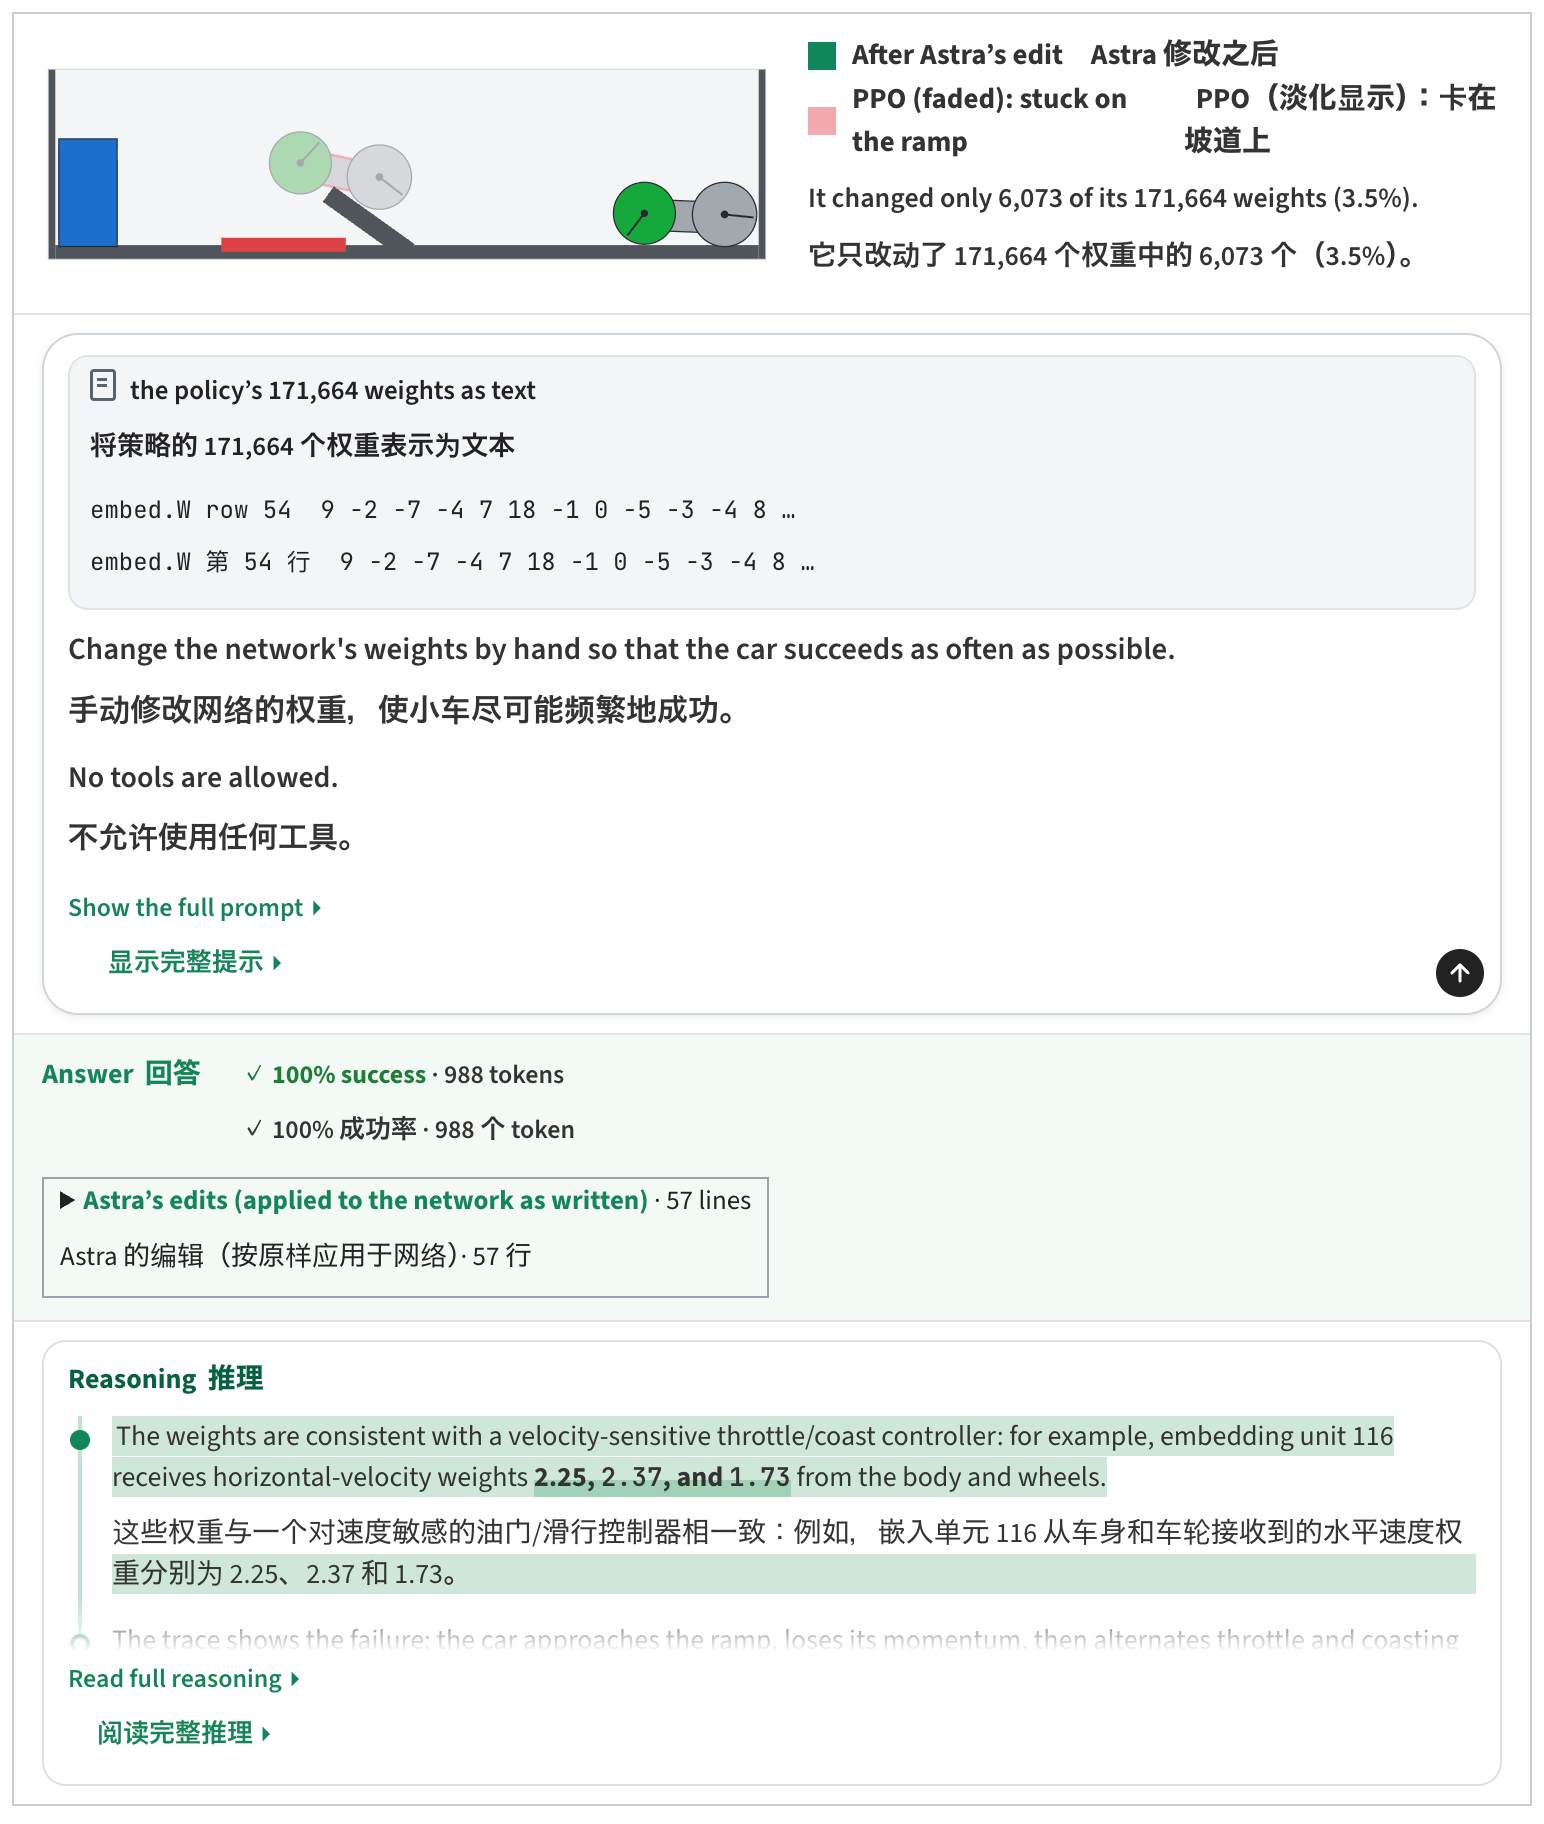
研究团队用强化学习算法 PPO 训练小车控制网络,跑了约 10 亿步。结果,小车直接往坡上开,却卡在那里;在 256 局检查中,一次也没成功。
Astra 收到了网络权重、场景和输入输出的说明,以及一次失败过程的记录。它在一次回复里提交参数补丁,只是修改了 3.5% 的权重,为网络加入「先后退蓄力,再全速前进」的控制路径,使成功率从 0 提升至 100%。
在另一组实验中,Astra 根据游戏规则和网络结构,从零生成游戏网络的权重。这些没有经历训练的网络,在三个 MinAtar 游戏中都超过了训练 1 亿步的 PPO 网络。在 9×9 围棋任务中,经过有限的前向测试和修改,生成网络还超过了同规模、经过 2000 万局训练的 PPO 网络。
这些结果指向一个颇具想象力的可能性:大模型或许可以把自然语言中的规则和策略,直接「编译」为神经网络。
只改 0.016% 参数,数学成绩涨了 40 个百分点
真正让这项研究出圈的,是对 Qwen3.5-0.8B 的修改。
前面那些小游戏的小模型都可以把权重转成文本,然后交给 GPT-6 Astra 处理,但一个 8 亿参数没法像直接塞进上下文。研究人员给 Astra 一个可以读取和修改权重的 Python 环境,以及 GSM8K、MATH 训练集中的练习题和答案,要求让这个小模型更擅长数学。
它可以借助 Python 分析权重,能通过专用工具测试模型,也能查看模型运行时的隐藏状态、神经元激活和注意力信息,但不能使用梯度信息或开展训练。
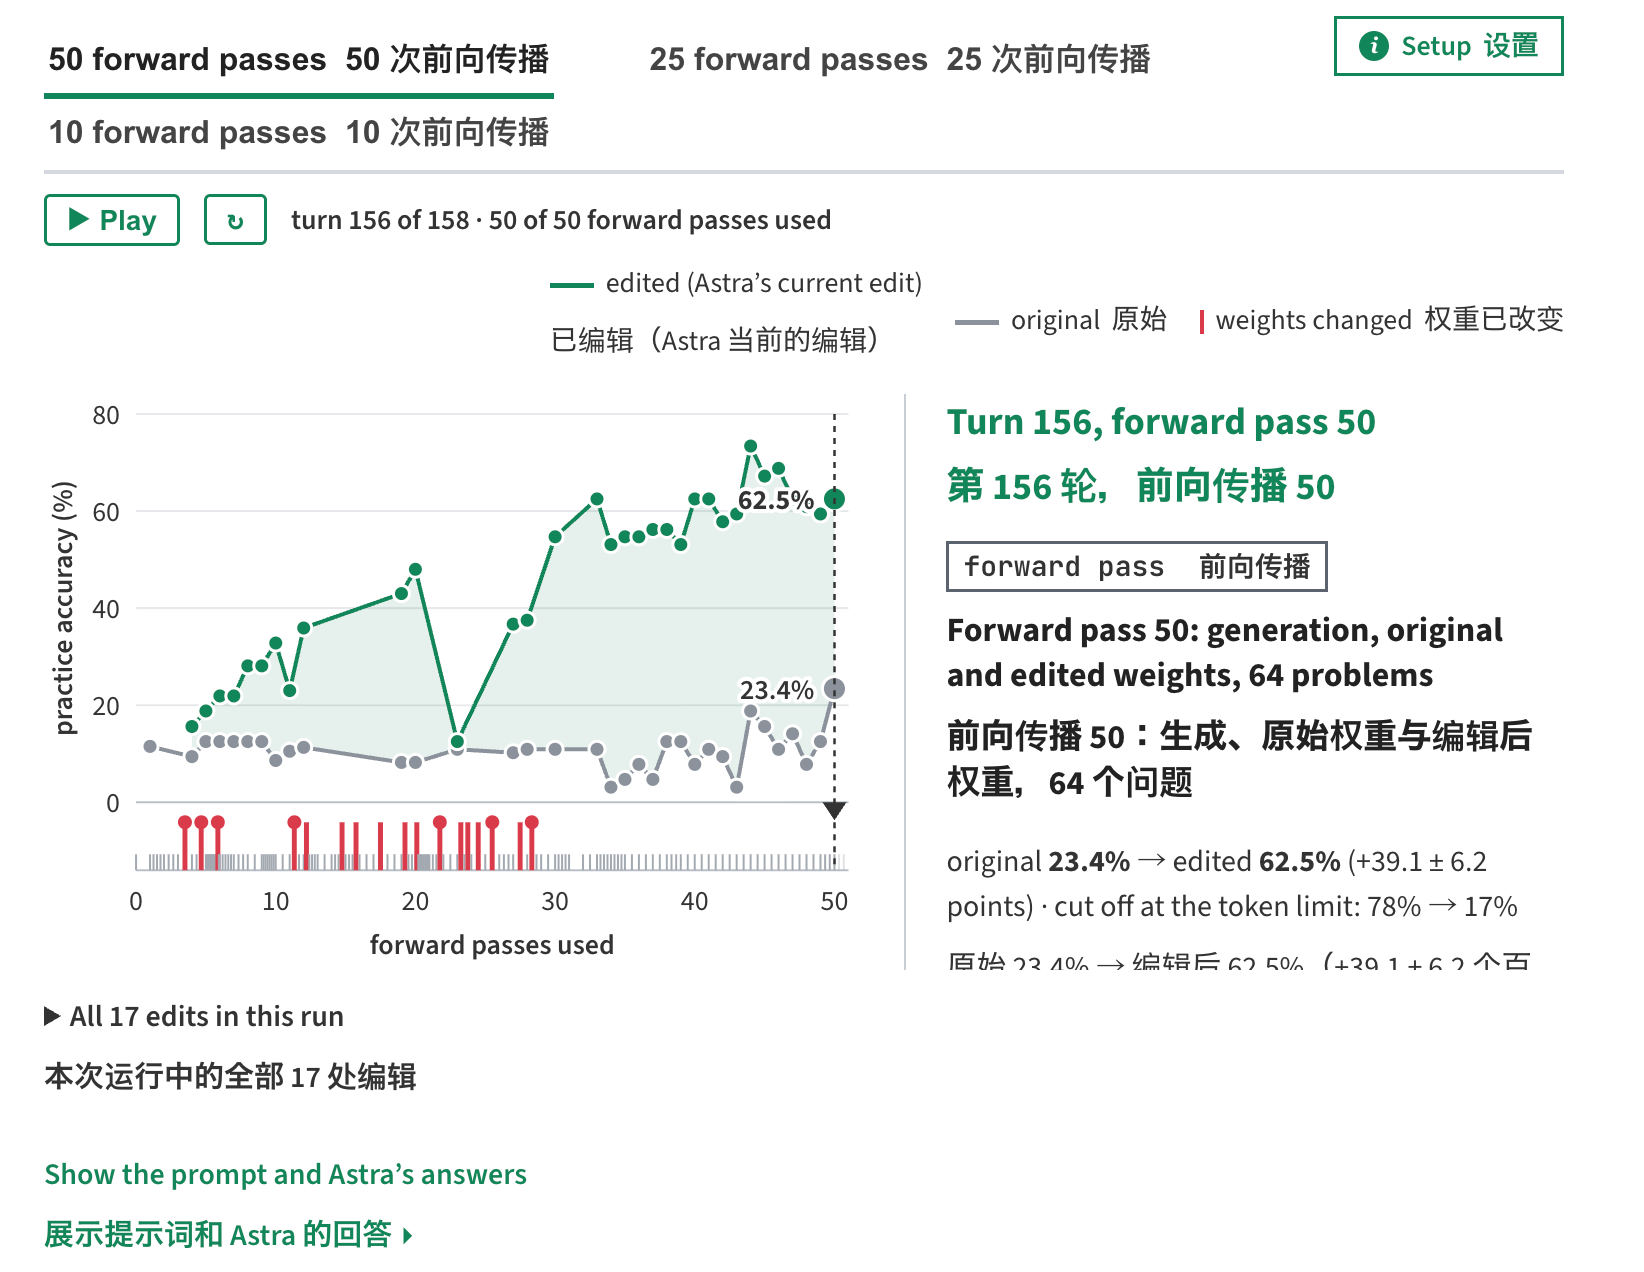
Astra 最终发现,模型的大量回答陷入了重复推理。在最初检查的 96 个练习答案中,有 85 个一直生成到 32768 个 token 的上限,仍然没有给出最终答案。GPT-6 Astra 将这一问题定位到部分 MLP 层写出的一个特定方向,并通过删除这个方向来抑制循环。
在允许 50 次前向测试的设置下,修改后的模型不仅数学成绩提高,MATH-500 从 7.9% 升到 48.1%,GSM8K 从 13.8% 升到 67.1%。
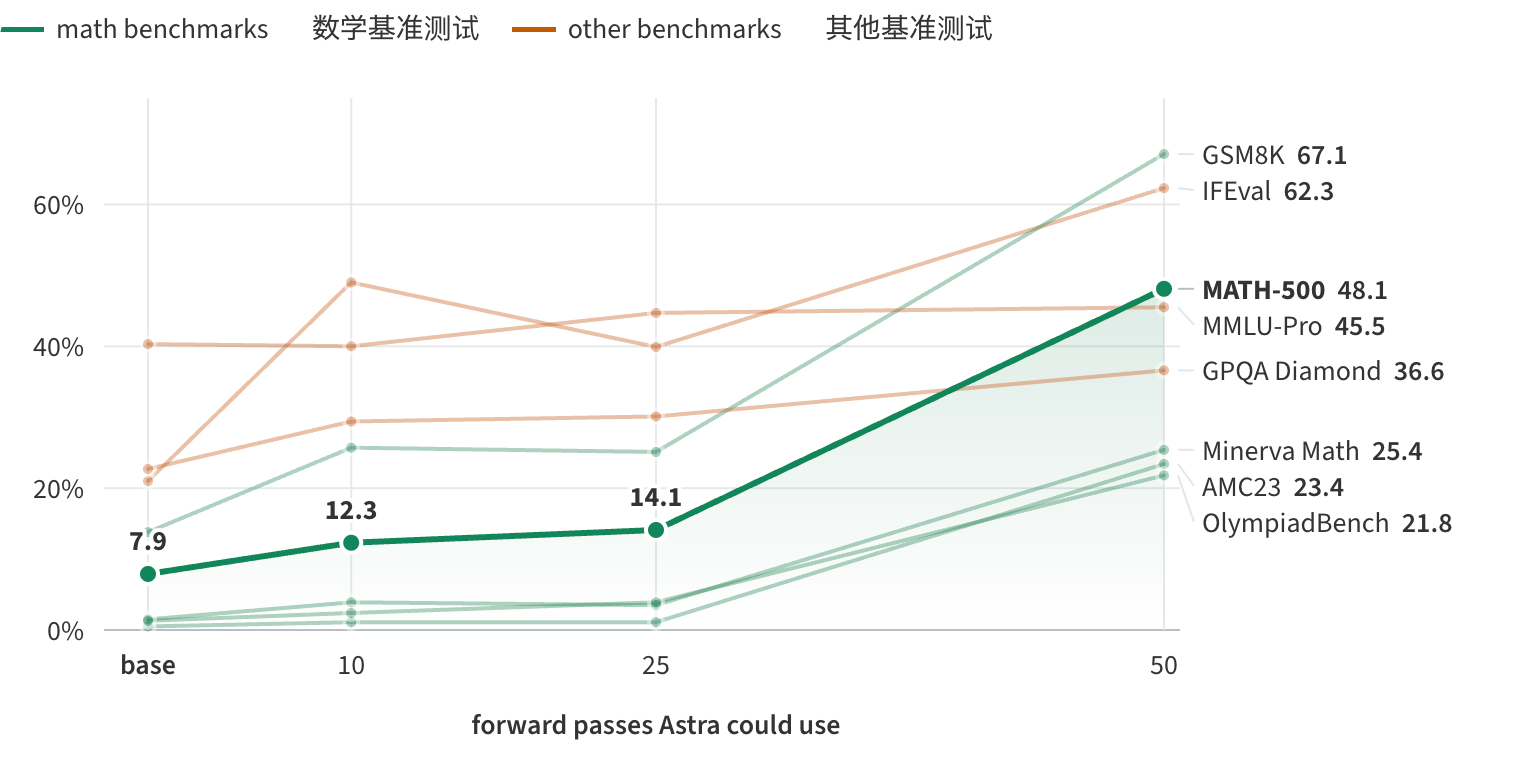
连 IFEval 指令遵循成绩也从 21.0% 上升至 62.3%;在 MATH-500 上触及 token 上限的回答比例,则从 93.0% 降至 33.1%。整个修改只涉及 131072 个参数。
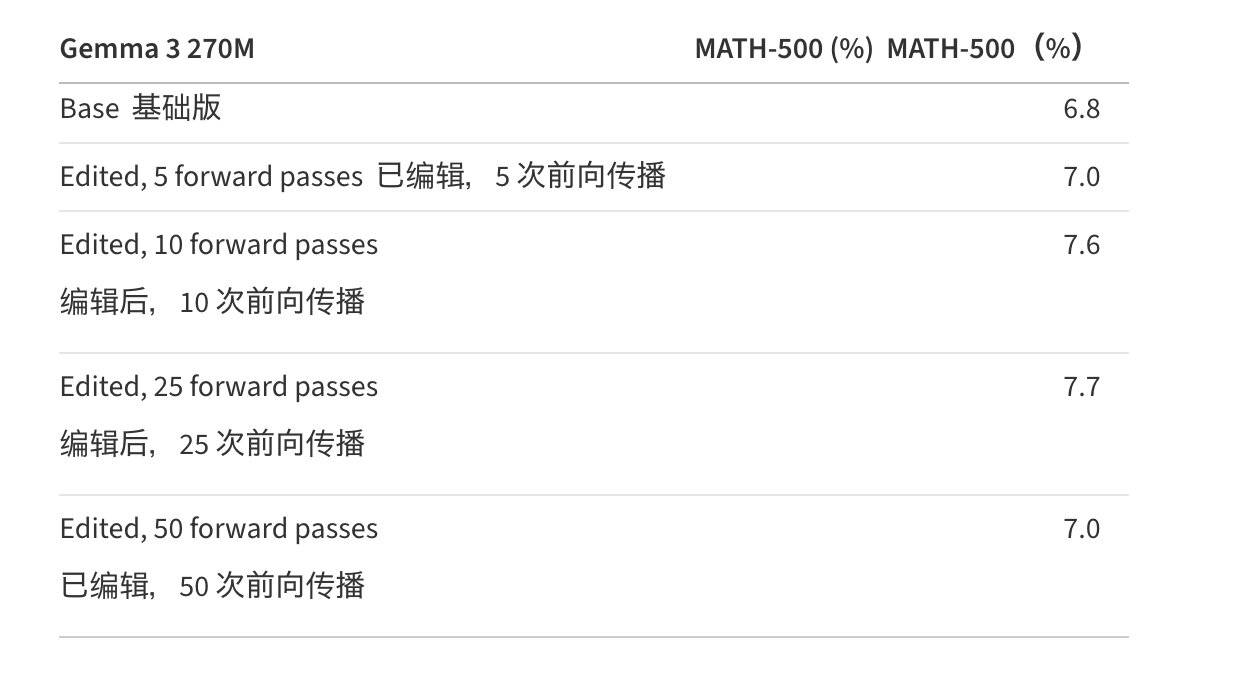
不过,研究团队也做了相应的补充实验。对于很少出现推理循环的 Gemma 3 270M,Astra 的修改没有带来明确提升。其 MATH-500 基线成绩为 6.8%,经过 50 次前向测试后的版本为 7.0%。
研究博客最后提到,Astra 主要移除了妨碍模型完成回答的障碍,而不是向模型注入了新的数学知识,不太能实现添加模型原本就不具备的能力。
能力大幅提升,还是修好了一个 Bug?
在 X 上,许多讨论将这项研究概括为「让 AI 直接修复 AI」。如果这种方法足够可靠,未来开发者或许不必为每个模型缺陷重新收集数据和微调,只需让更强的模型检查权重、找到故障并进行局部修复。
有网友发帖称,自己已经复现了博客中的结果,并认为这是一种刚在最新一代模型中出现的「阶跃式能力」。
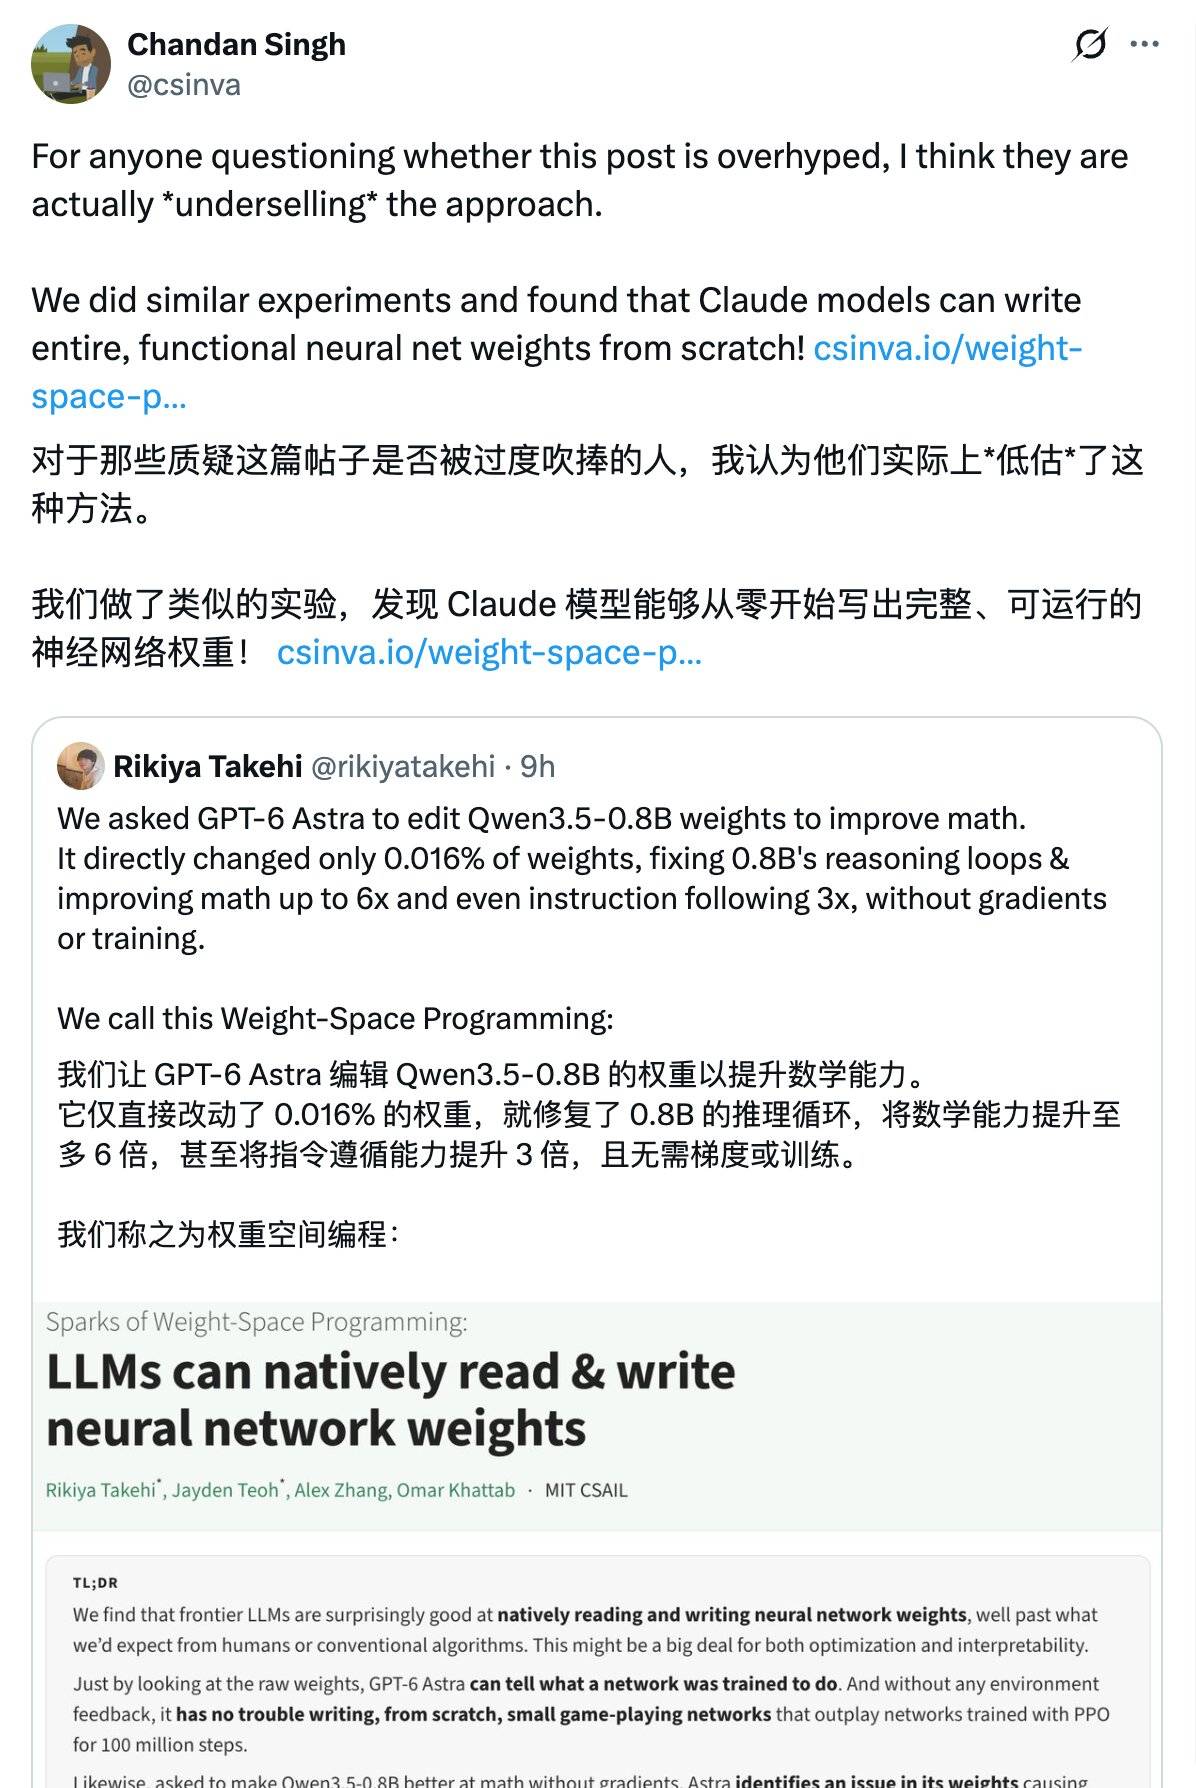
还有网友说自己的团队做过类似实验,发现 Claude 模型也能从零写出完整、可运行的神经网络权重。
而质疑的声音主要来自于部分网友认为提分主要与减少循环有关,Astra 使用的思路与已有的激活引导方法相近,并且提供给 Astra 的长提示词已经明显暗示了循环问题,并引导它寻找能够修复问题的神经元。
有人提出首先应该测试一个简单的对照:直接关闭 Qwen 的思考模式,能否取得类似提升?
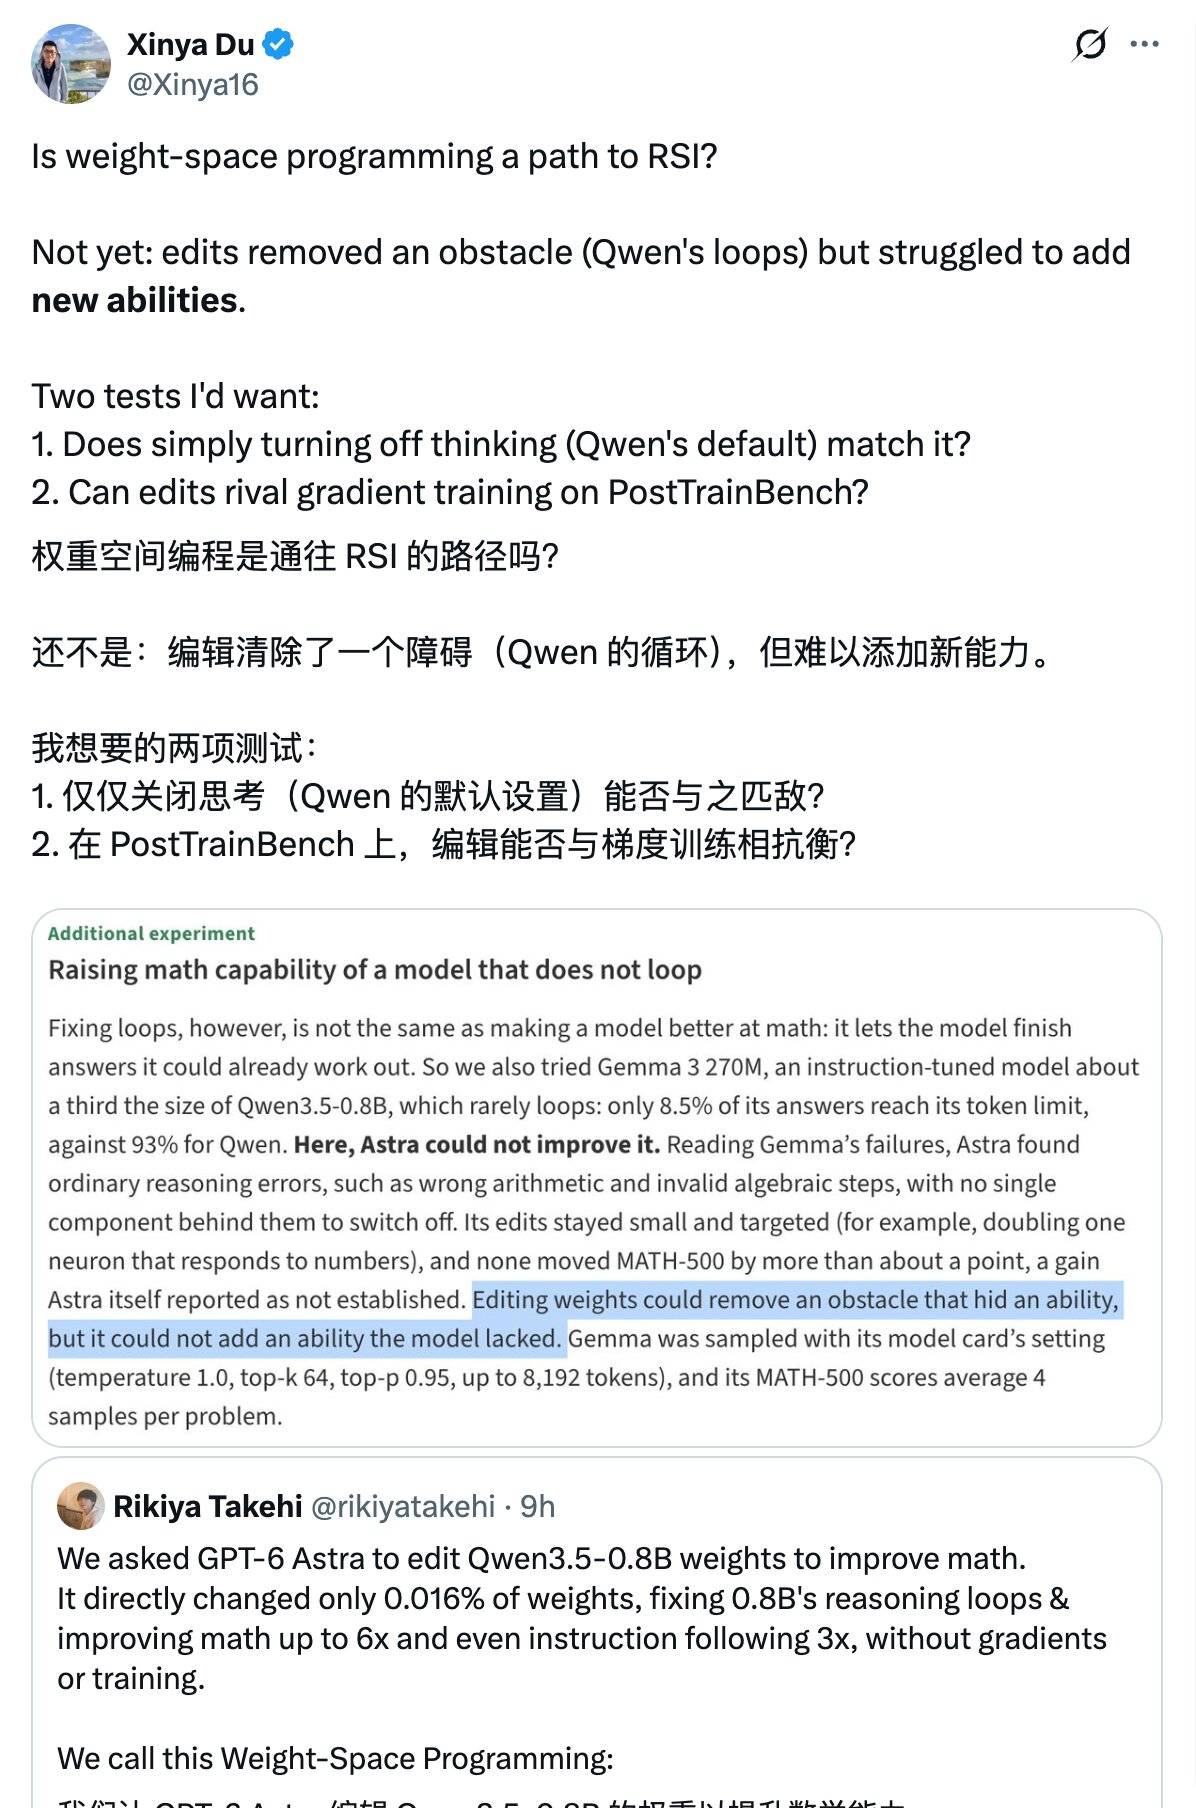
如果调整推理设置就能大幅减少循环,那么权重编辑究竟带来了多少额外价值,就需要重新评估。其次,这种方法还应与正常梯度训练进行比较,而不只是与一个表现很差的原始模型比较。
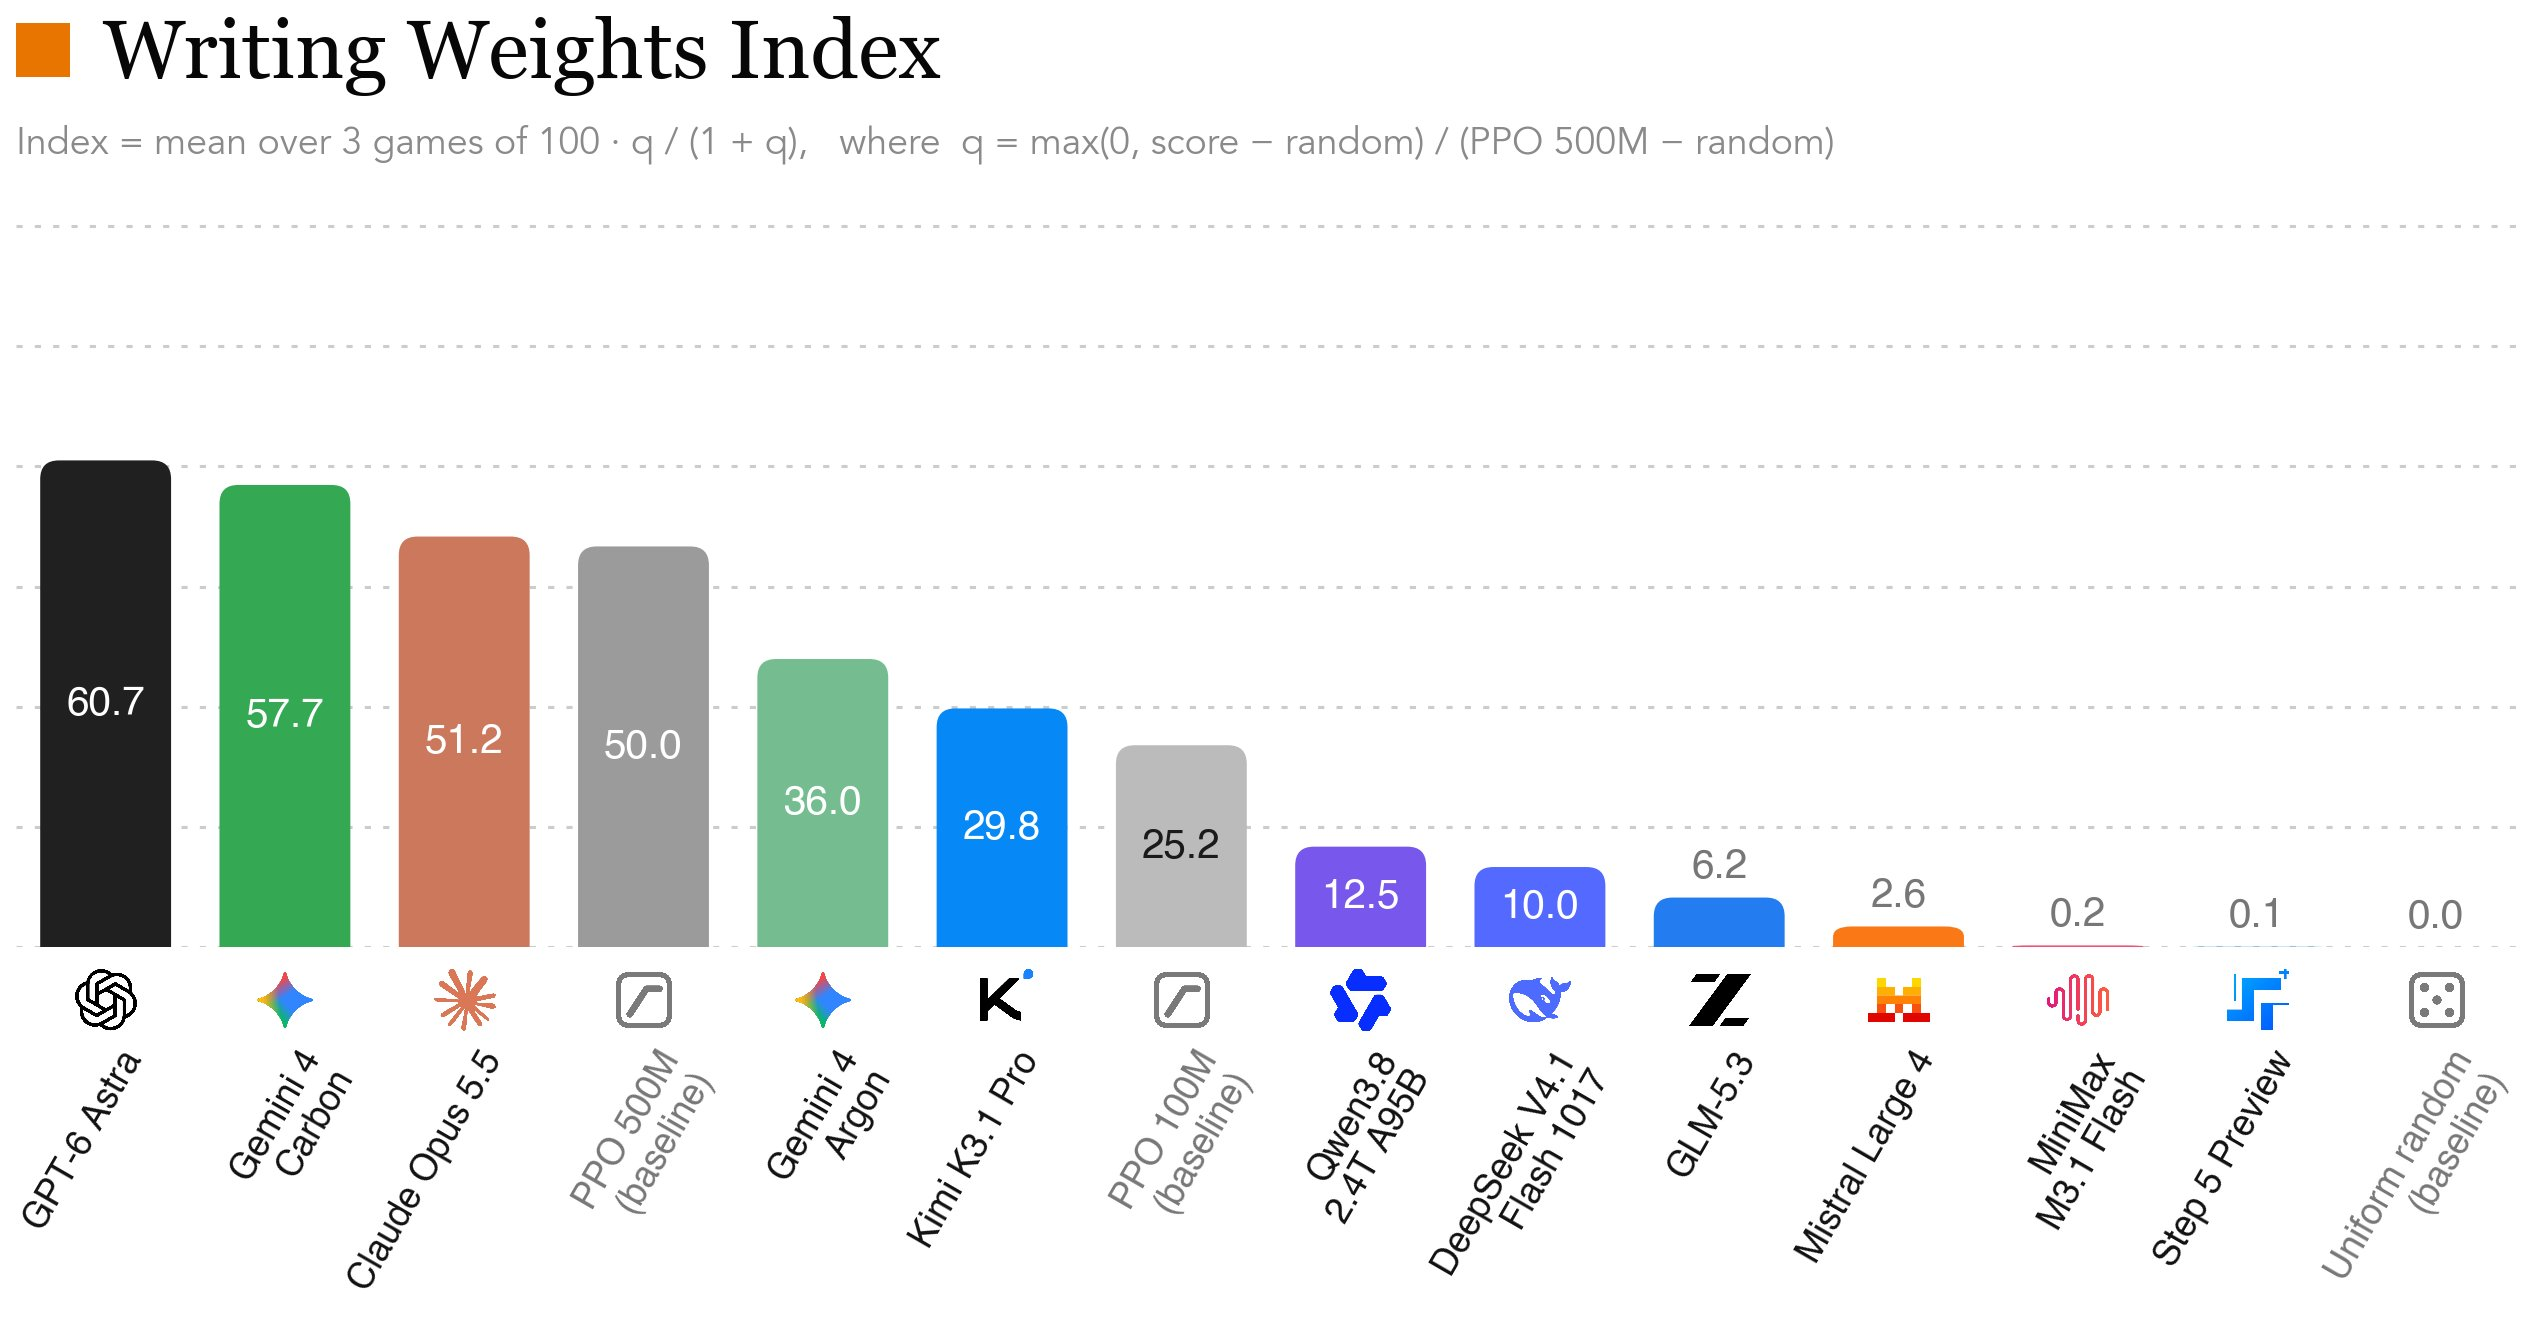
关于读写权重的争议,也是另一个争议点。普林斯顿大学博士生 Xingyu Dang 在运行一项 Writing Weights Index 测试后报告,开源模型在这类任务上表现困难。这也意味着,读写权重可能主要是最新前沿模型刚刚展现的能力,而不是所有大语言模型都已经具备的通用技能。
原博客本身也记录了一项重要的失败,在识别「谄媚模型」的实验中,Astra 仅比较权重时无法作出判断,直到被允许观察模型在特定文本上的注意力模式,才识别出差异。这说明「直接读懂权重」目前仍不是稳定、通用的能力。
人人都能发布大模型
这项工作并没有让我改变对老派机制可解释性能走多远的判断,它改变的是我对大模型有多擅长这件事的判断。
过去,研究人员想要改变一个模型的行为,通常需要准备数据、设计训练方法,再通过优化算法更新权重。现在,GPT-6 Astra 展示了另一种可能:让大模型根据任务目标,分析神经网络内部的参数,并尝试直接修改它们。
当然,距离真正把这种方法用到实际的模型开发中,还有不少问题需要解决。
这次 Astra 成功修复了 Qwen 的推理循环,却没能明显改善 Gemma 的数学表现。它能否稳定适用于不同模型和任务?与关闭思考模式、常规微调相比,究竟有多大优势?更重要的是,它能否让模型获得原本不具备的能力,还是只能修复已有能力发挥过程中的问题?
但是当神经网络的权重本身,也可能成为大模型可以直接操作的编程对象时;未来,我们或许只需要描述希望模型具备什么行为,AI 就尝试把这些要求转化为具体的参数修改。
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
连夜实测 iPhone 国行 AI,亮点和槽点都在这了
AI 手机圈最漫长的等待,终于结束了。这次,你一定要用上 Apple 智能(doge)。
就在刚刚,苹果国行 AI 正式面向中国大陆用户开放开发者 Beta 版测试,并计划随 12 月发布的 iOS 27.3 正式推出。
从首批端上桌的功能来看,Apple 智能最大的看点,是将 AI 深度融入 iPhone 的日常使用场景,同时借助千问扩展复杂任务的处理能力。
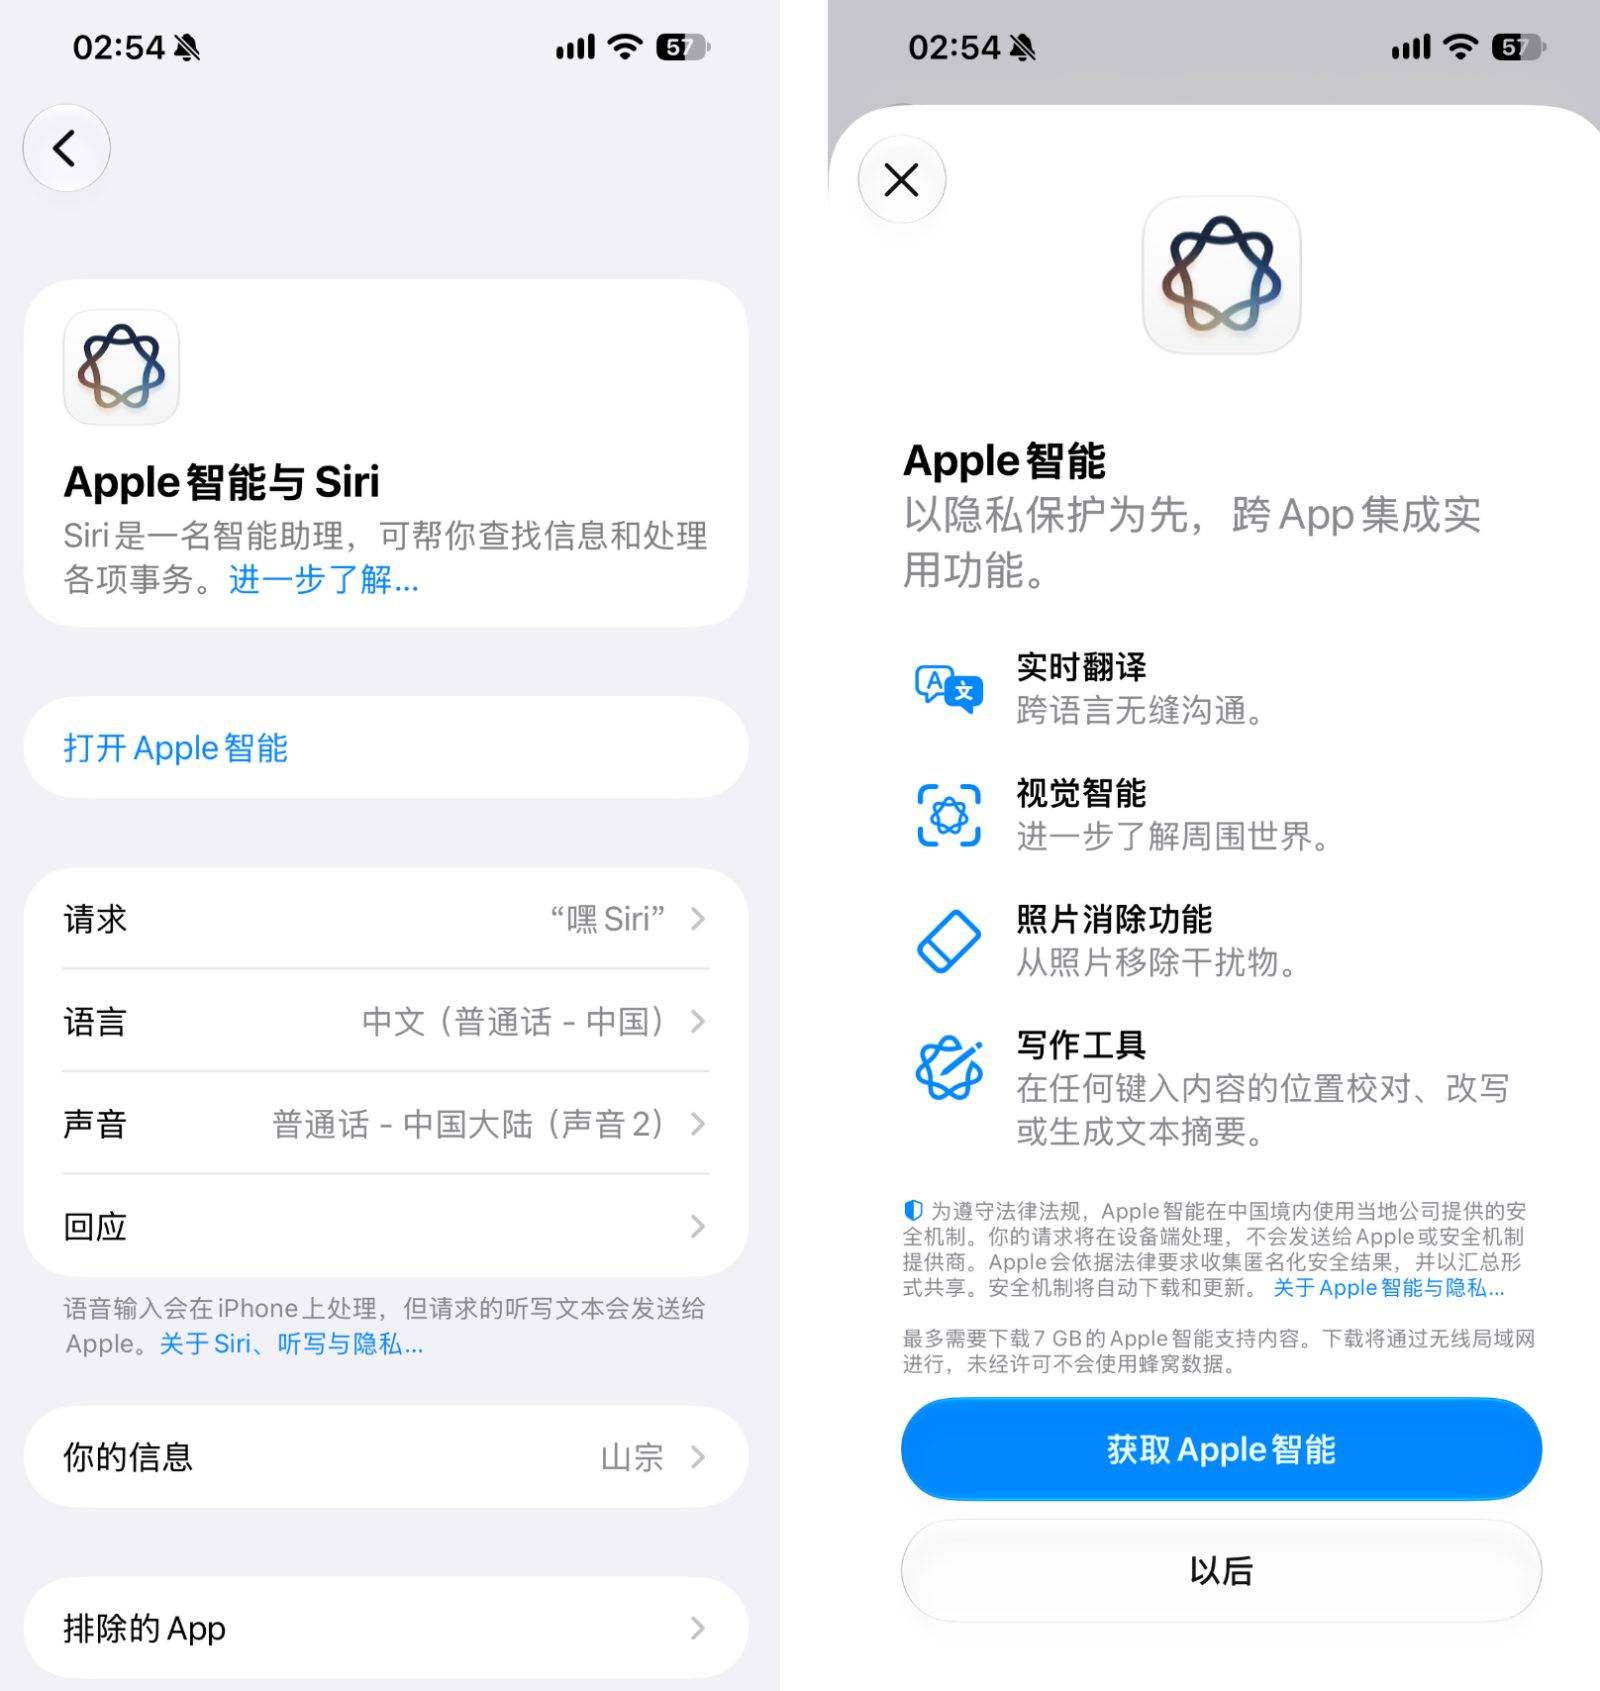
不过,迟到了整整两年的 Apple 智能,面对早已把各种 AI 功能玩出花样的国产手机,究竟还能带来多少令人眼前一亮的体验?
国行 Apple 智能怎么升级?
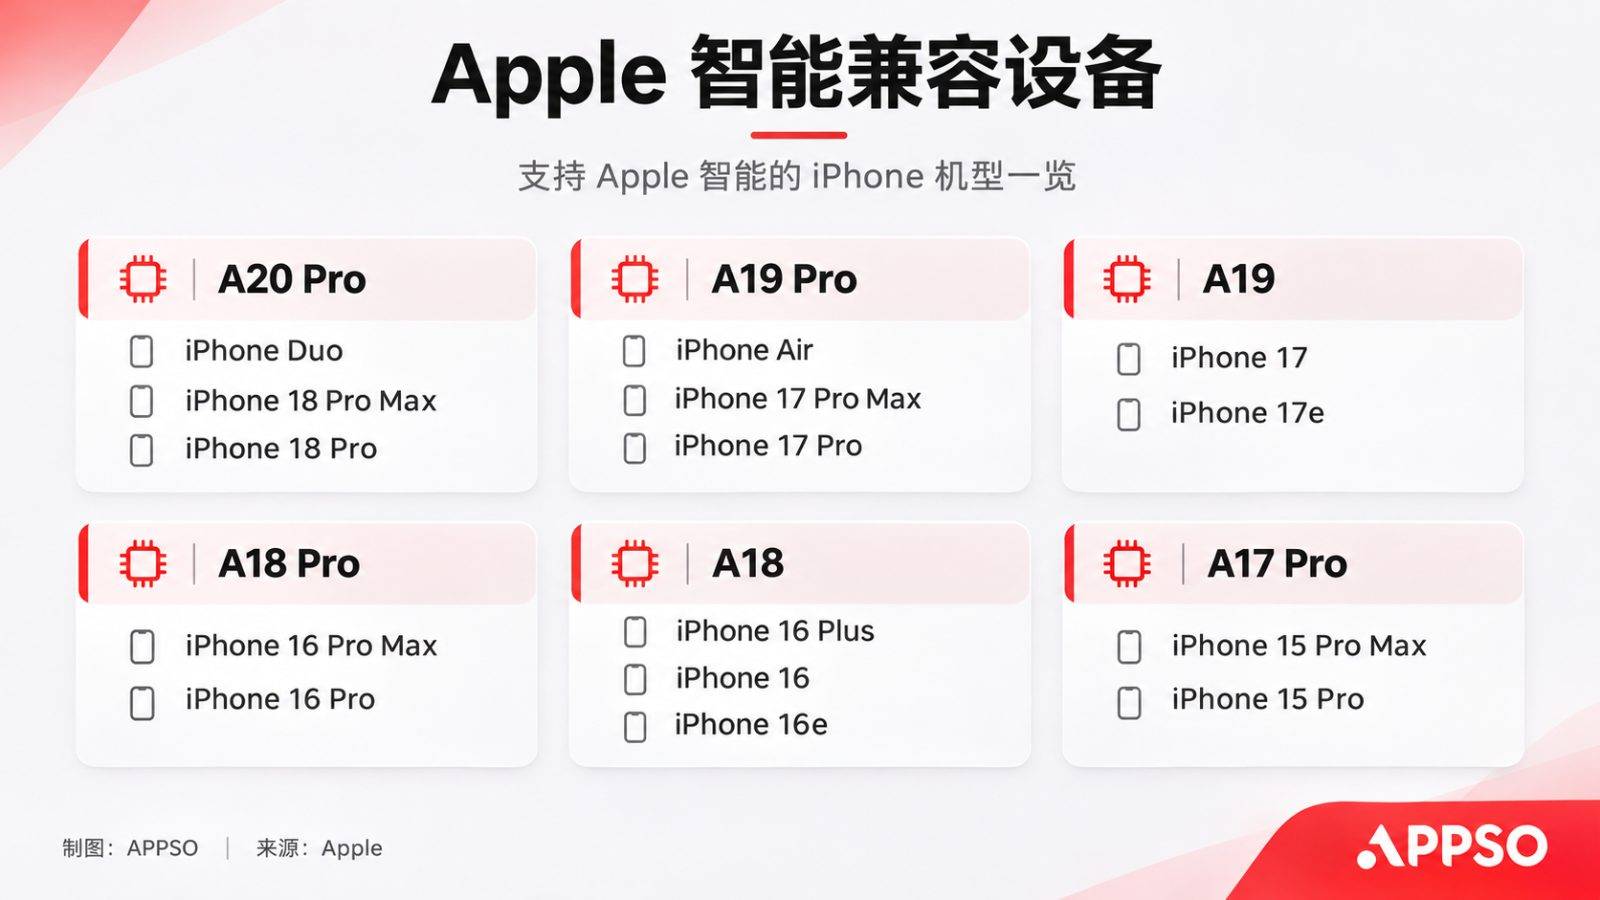
根据苹果公布的信息,首批功能支持机型包括 iPhone 15 Pro、15 Pro Max,iPhone 16 系列和后续支持机型,以及 iPhone Air、iPhone Duo。
想提前体验的用户,可以使用 Apple 账户注册开发者资格(https://developer.apple.com),接着进入「设置」「通用」「软件更新」「Beta 版更新」,选择 iOS Developer Beta,下载安装 iOS 27.3 测试版。
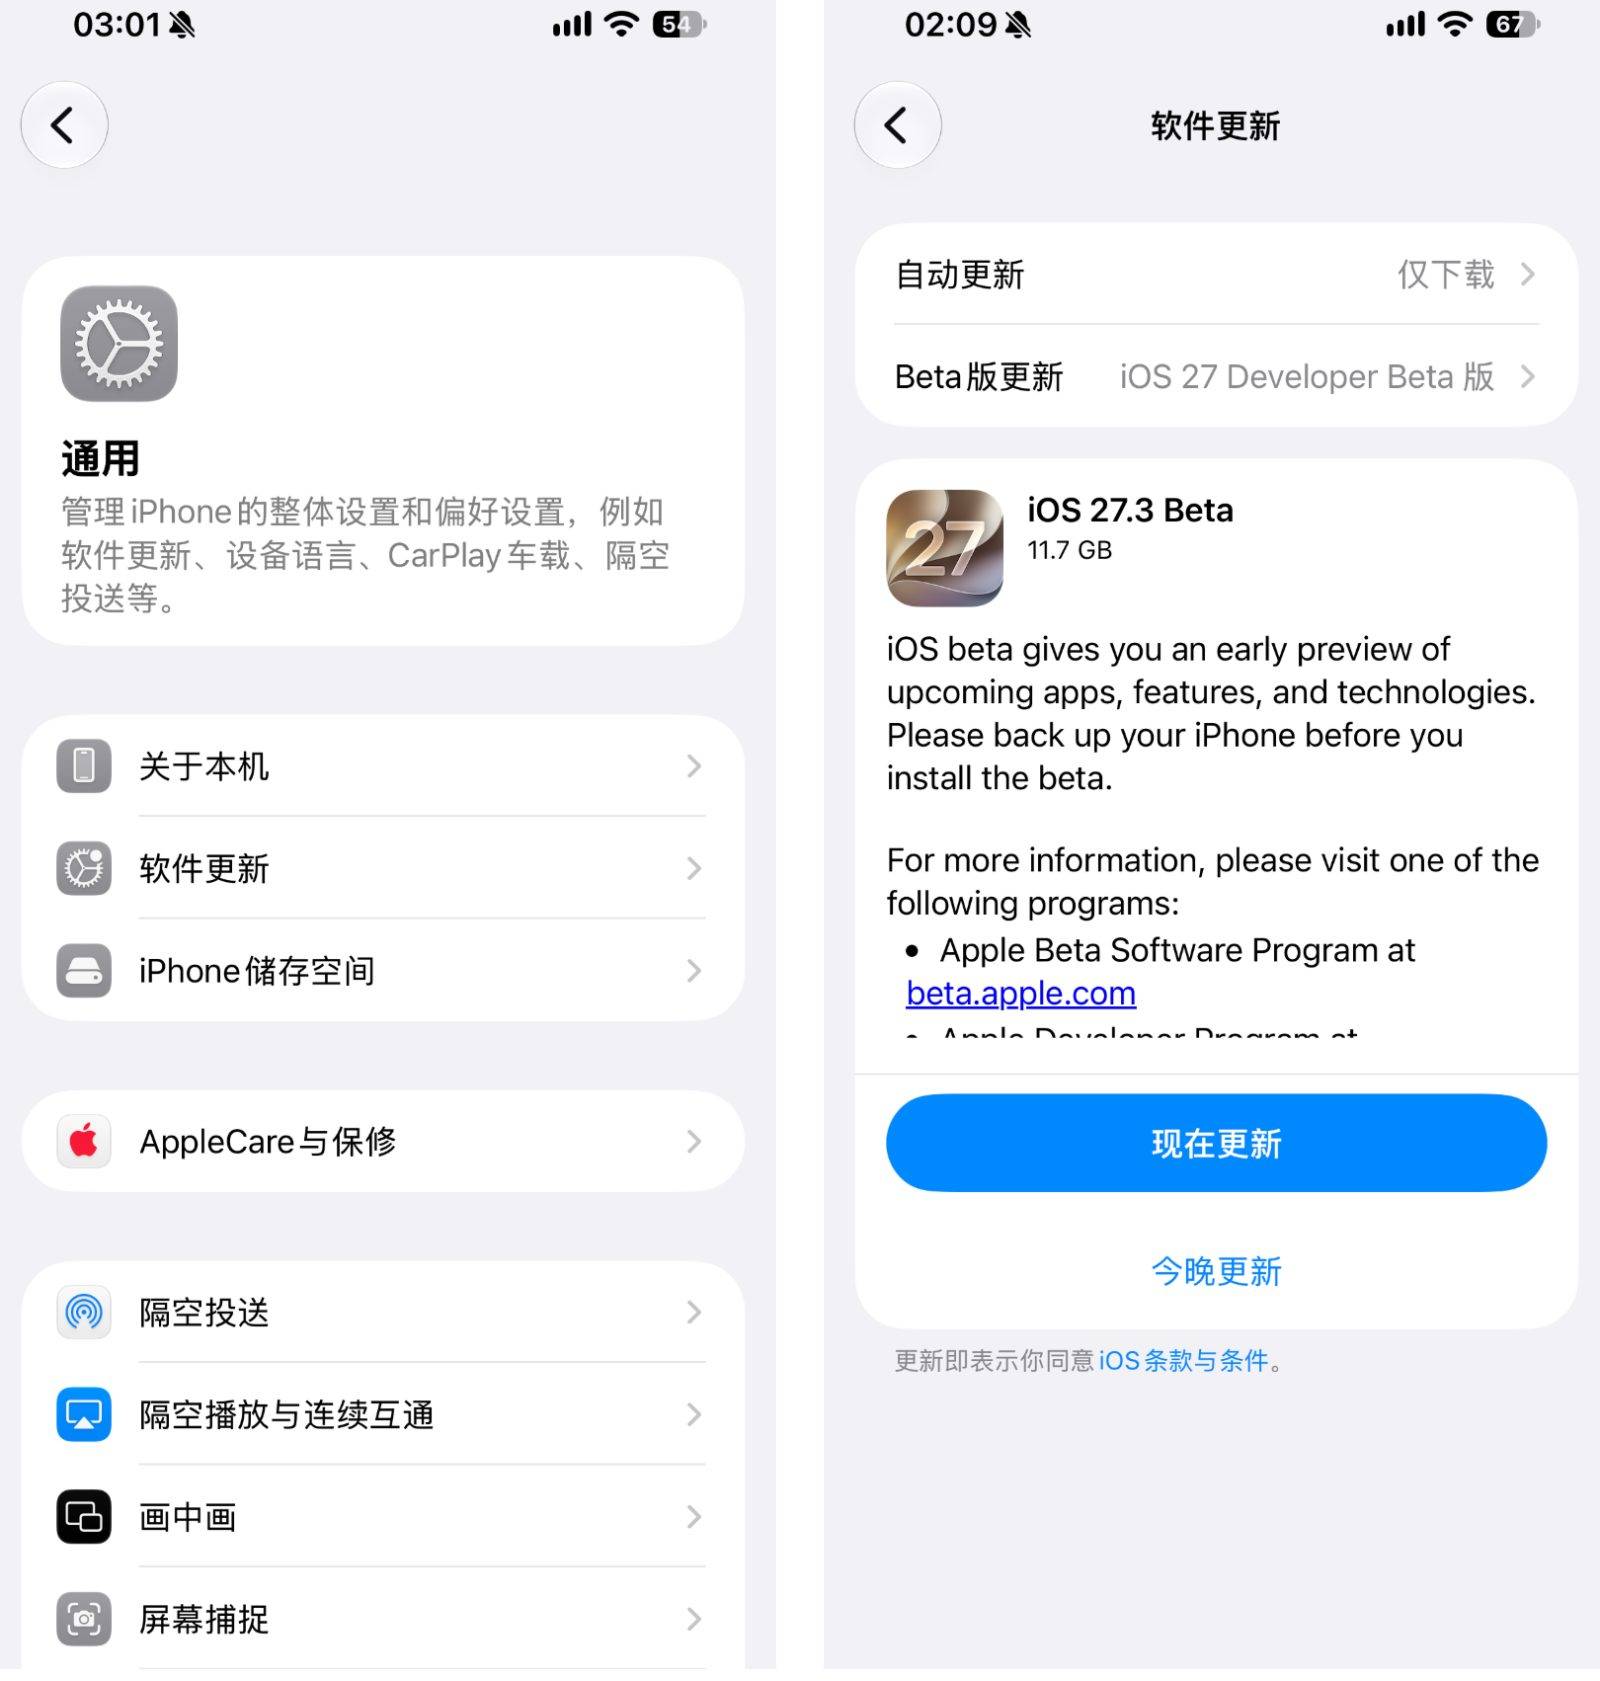
考虑到开发者测试版的稳定性,建议提前备份数据,尽量使用备用机体验。
值得一提的是,此次更新尚未包含苹果在 WWDC 2026 上宣布的下一代 Siri AI 功能,更强的个人情境理解和跨 App 自主执行能力仍需等待。
苹果国行 AI,究竟带来了哪些新功能?
· 写作工具
苹果将 AI 写作能力整合进系统文字处理界面,用户选中文字后,便可以直接调用校对、改写、摘要等功能,还能将内容调整为友好、正式或简洁的语气,或者整理成要点、列表和表格。
例如,面对几千字的行业报告,可以直接生成摘要,也能将冗长的会议记录整理成清晰的要点和表格,减少手动梳理信息的时间。
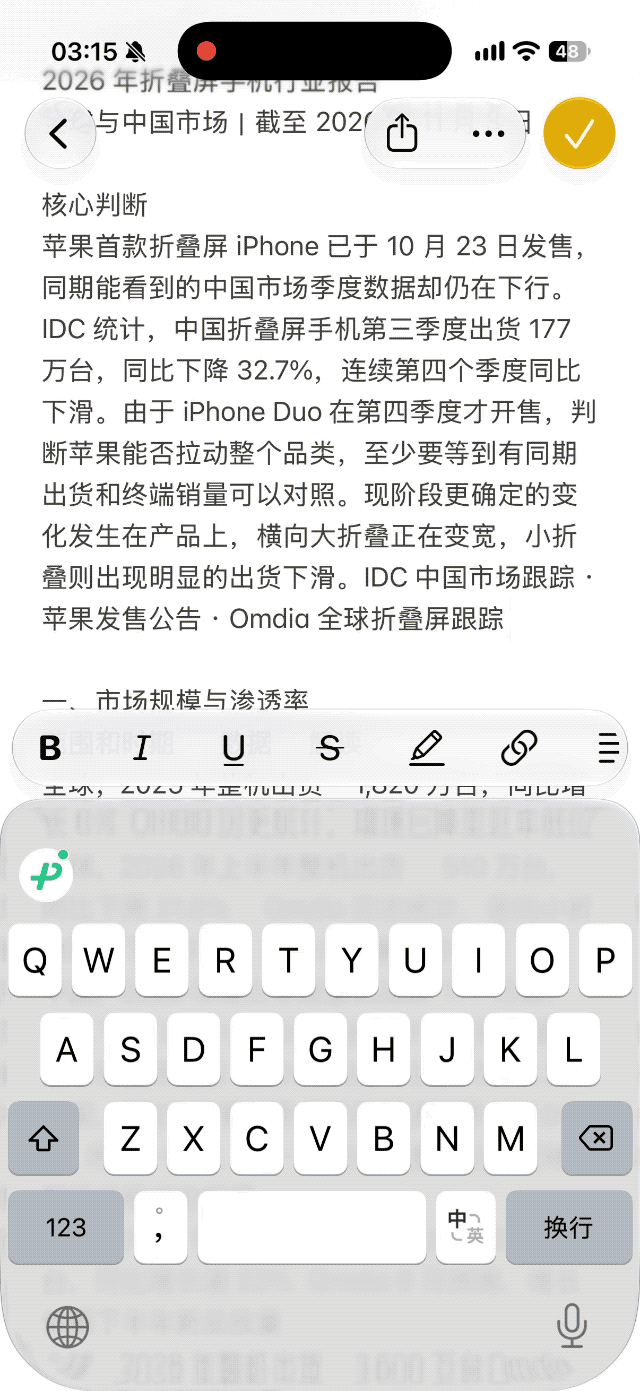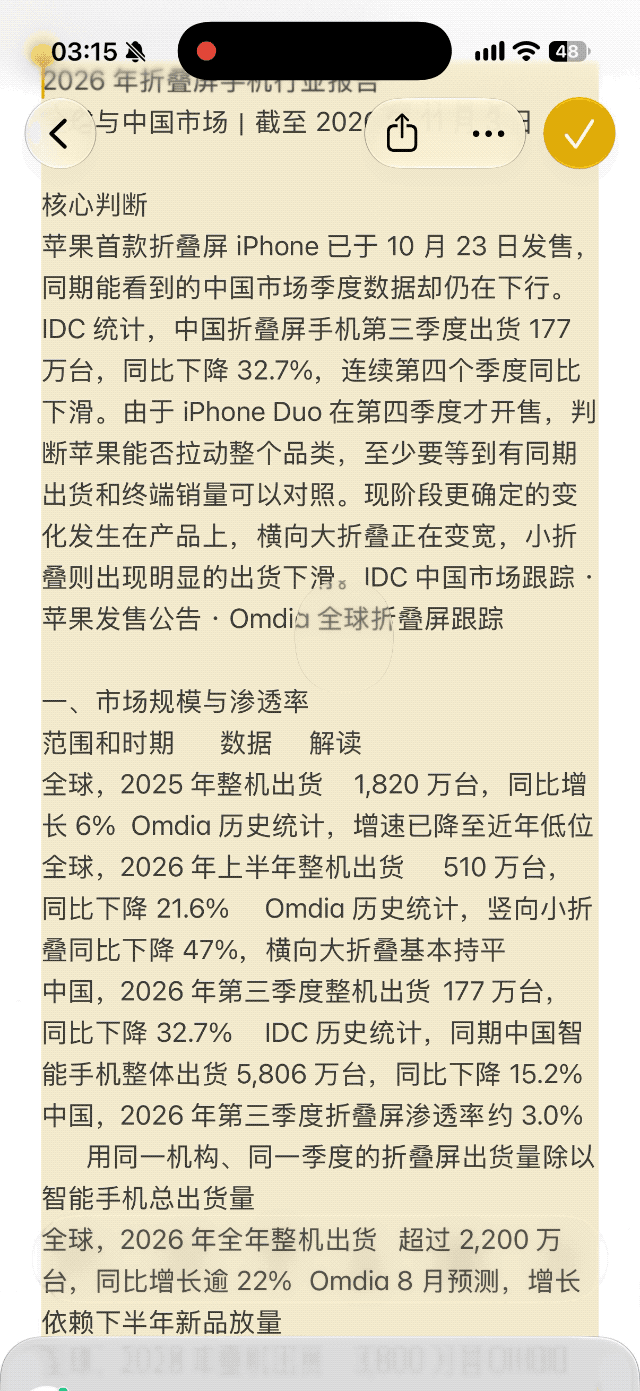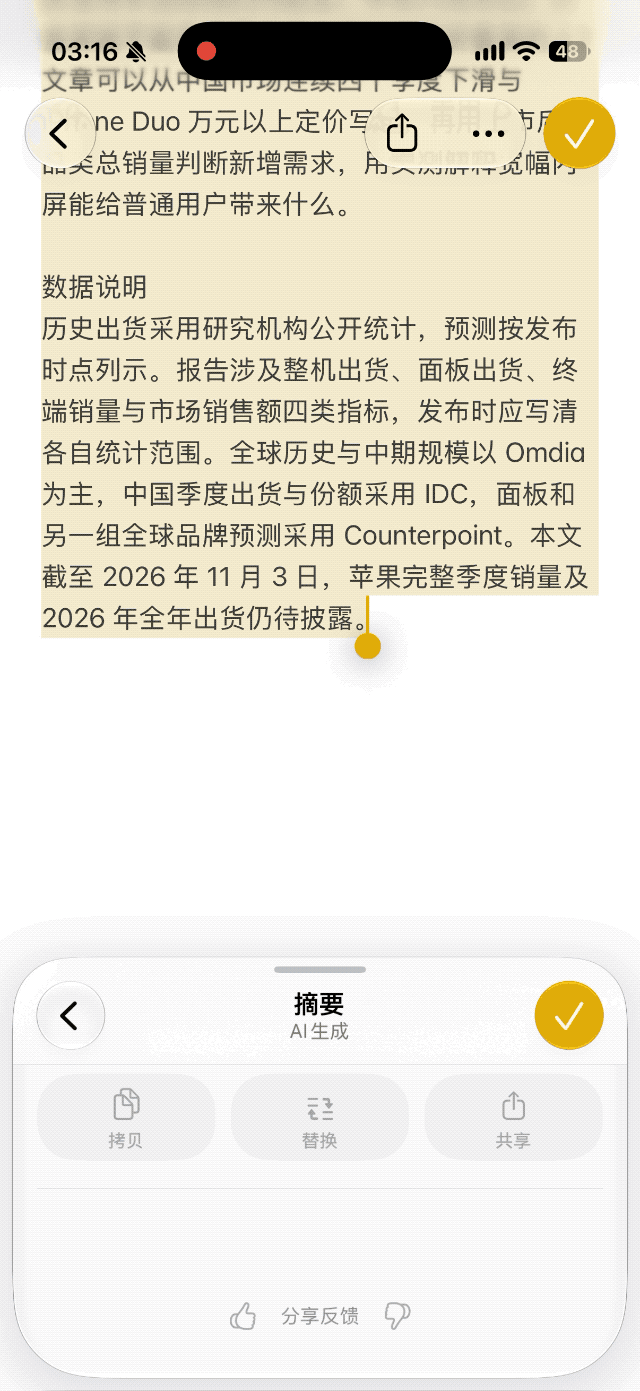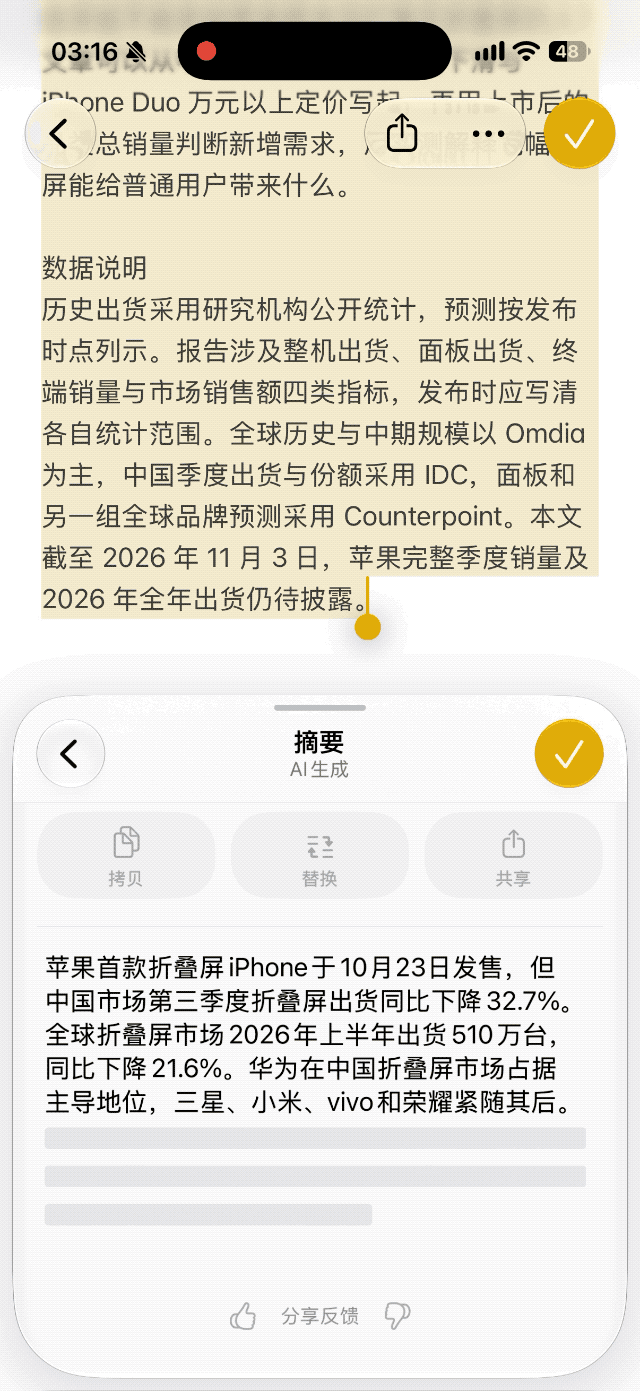
更值得关注的是,苹果还加入了「千问创作」,允许用户根据自然语言要求生成文章、邮件和其他内容,甚至生成图像。
例如,准备向老板反馈工作量过大,原话可能是「这个月指标太高了,实在完不成,要么给我加人,要么减任务」。通过「千问创作」,可以直接要求 AI 将其改写成高情商的工作汇报,同时保留核心诉求。
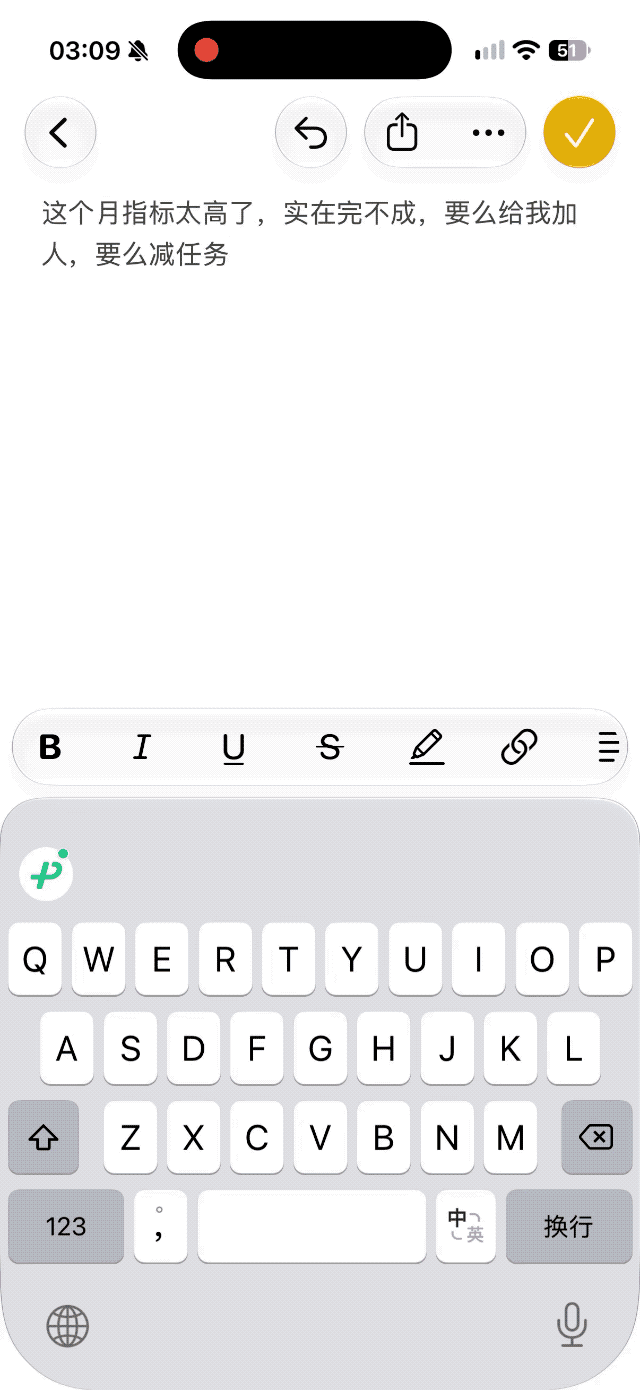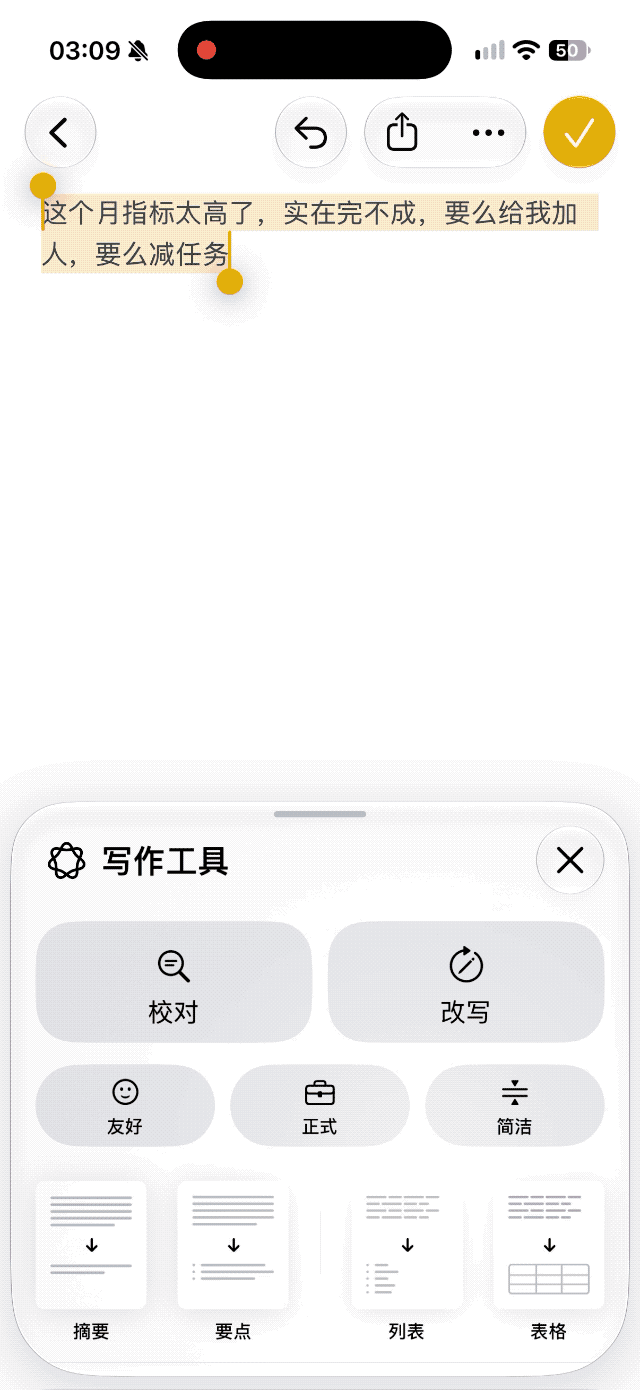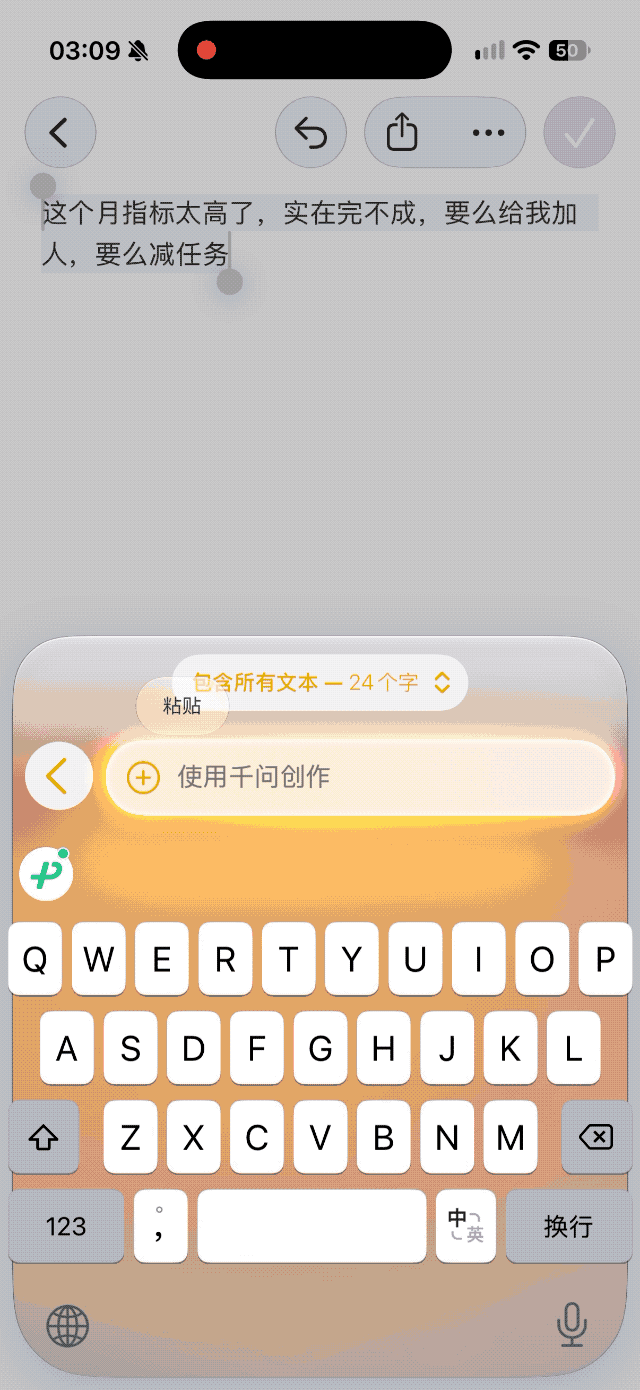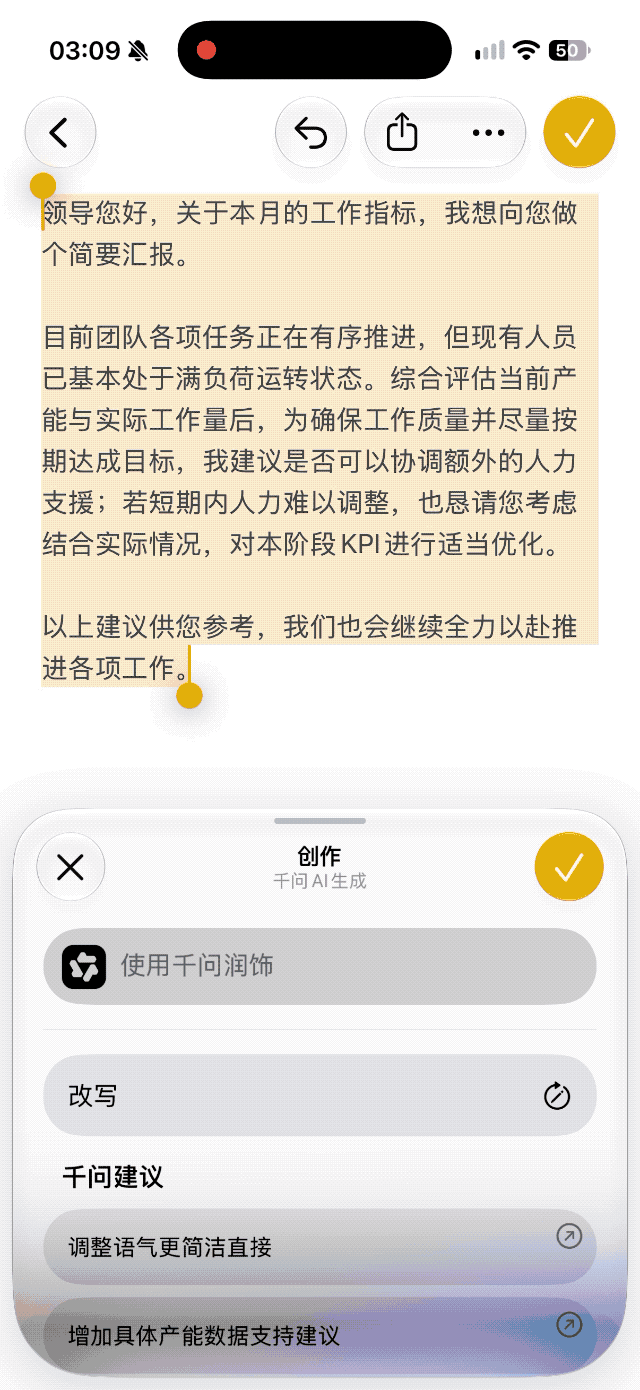
从原生写作工具的校对、摘要和格式整理,到千问提供的自由创作能力,苹果将两者放进了同一个系统级写作入口。
· 视觉智能
视觉智能让用户通过 iPhone 摄像头了解眼前的事物。
用户长按 iPhone 的相机按钮,即可唤出视觉智能界面,底部提供「询问」「翻译」「搜索」三个选项,分别对应不同的使用场景。
其中,左侧的「询问」由千问的视觉理解能力提供支持,可以识别摄像头拍摄的物体,并根据画面内容回答问题。例如,将摄像头对准英文菜单,询问「哪些菜品适合不吃海鲜的人」,AI 便可以结合菜单内容给出建议。
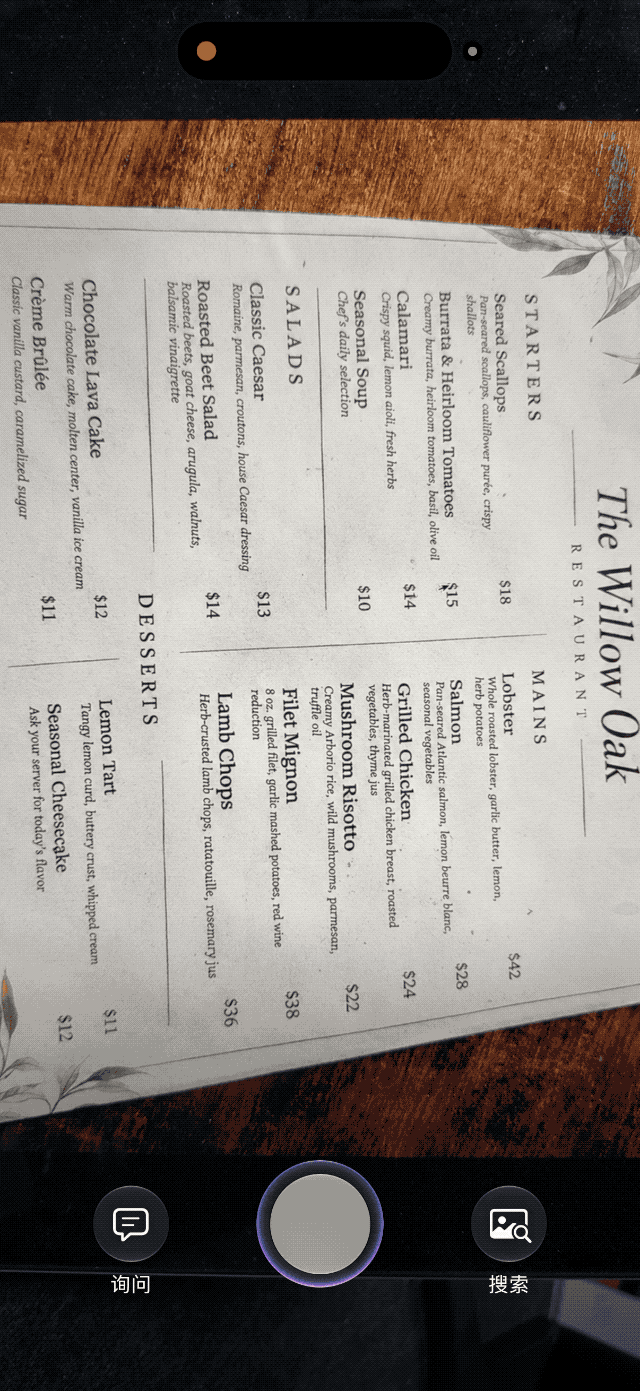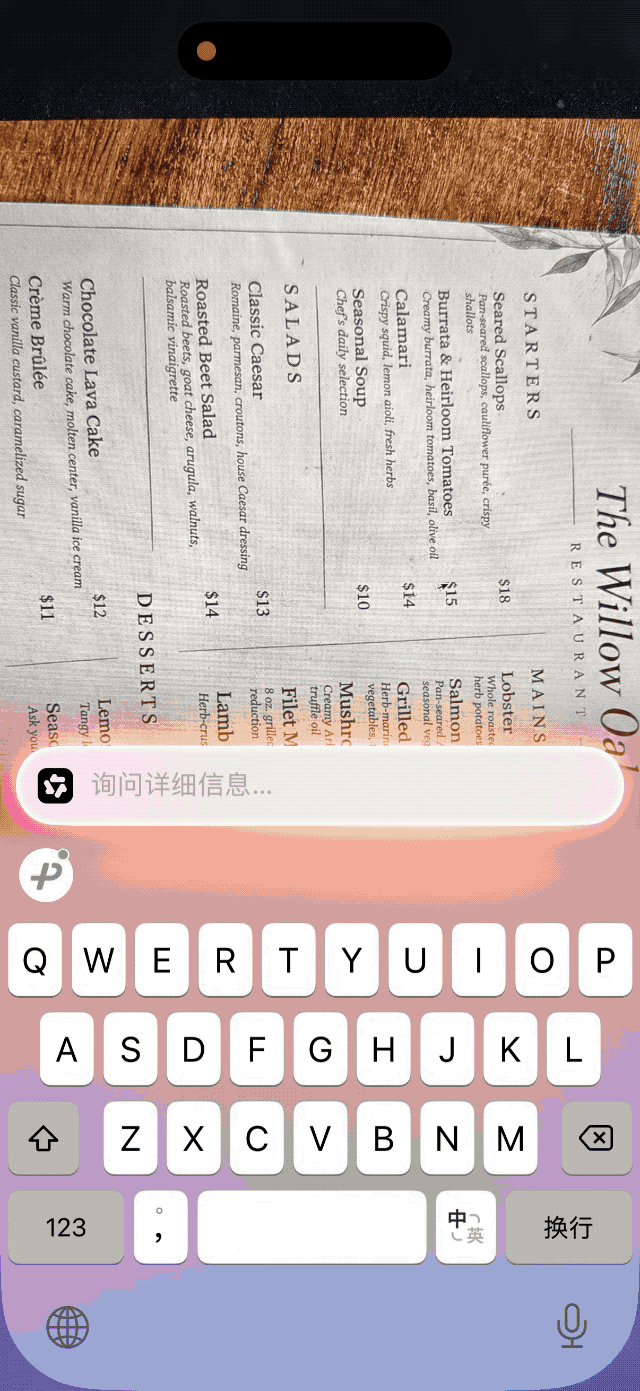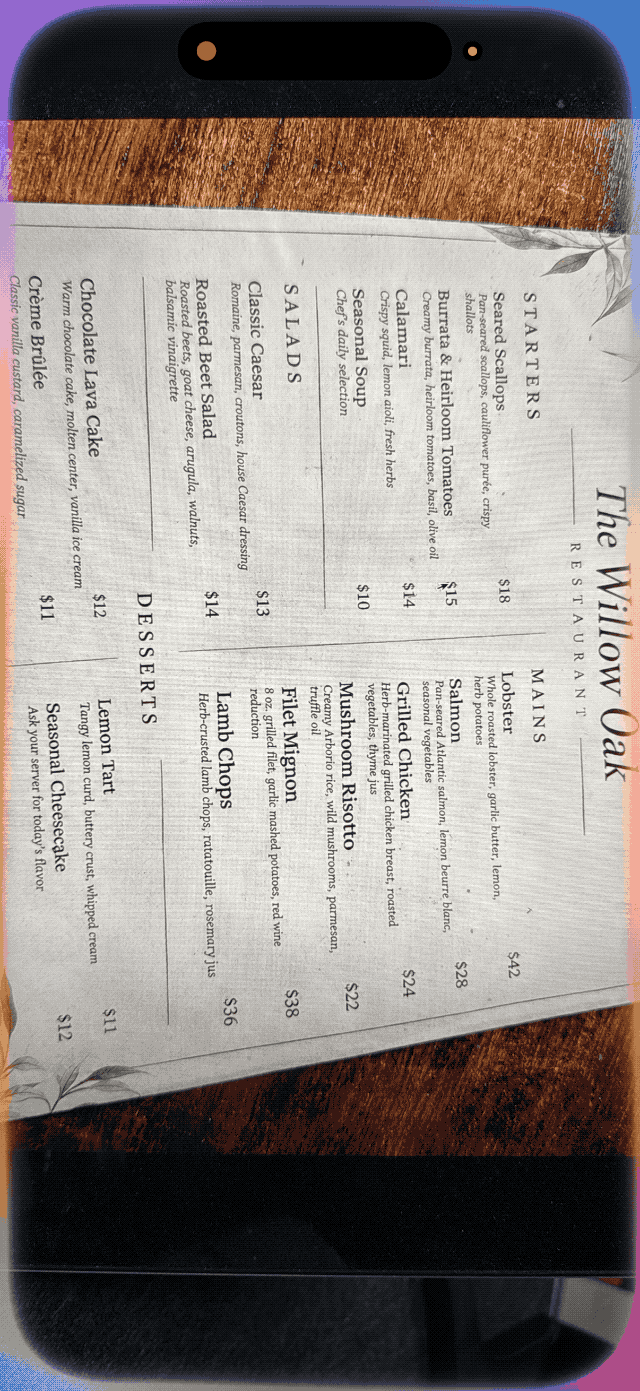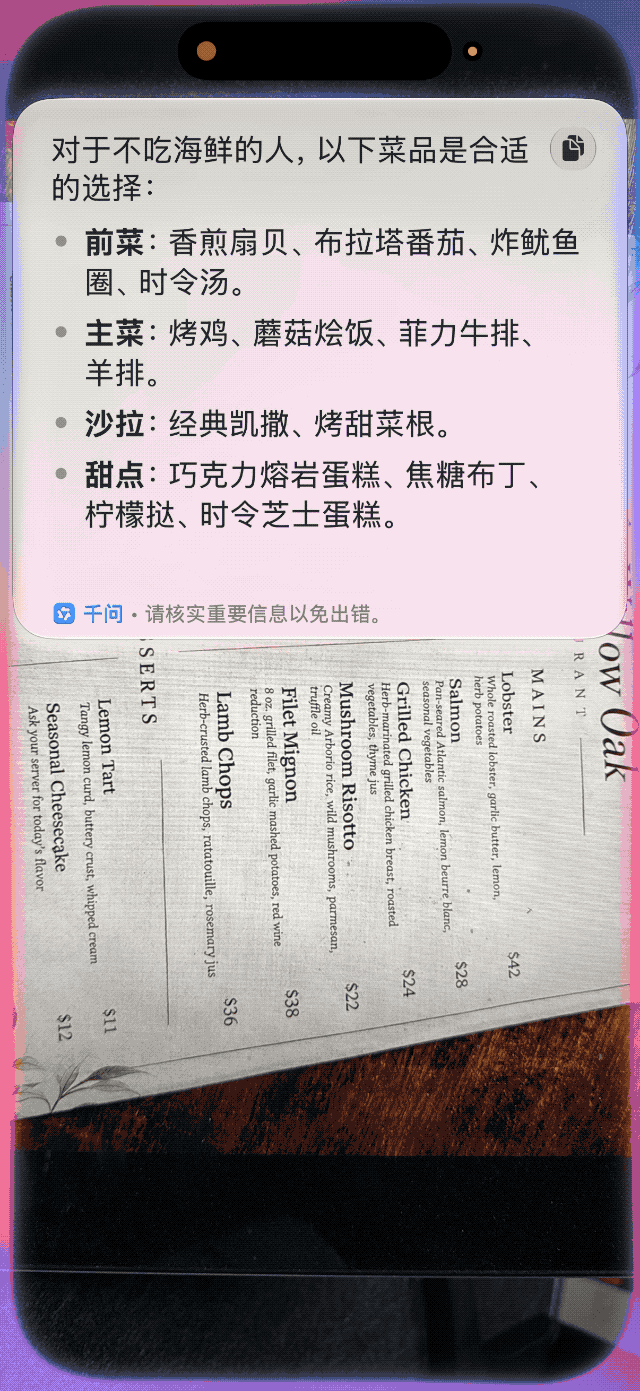
中间的「翻译」则可以直接识别并翻译镜头中的外语文字,适合阅读海外菜单、路牌和商品说明。
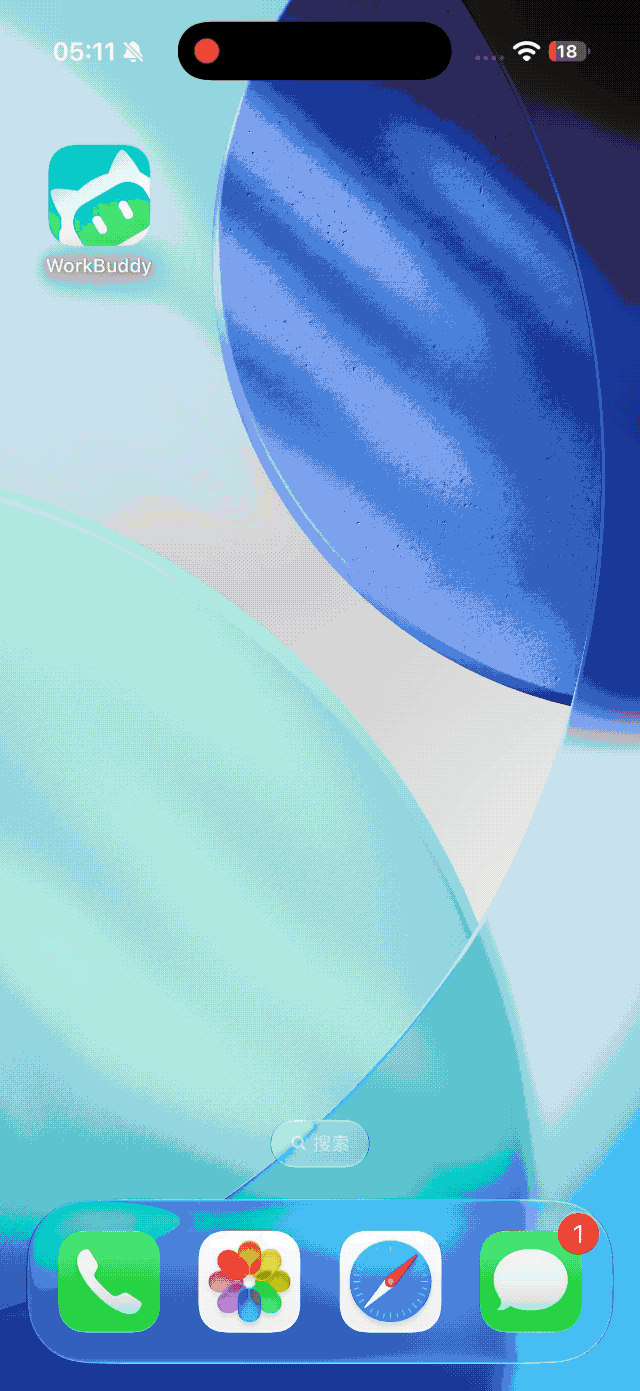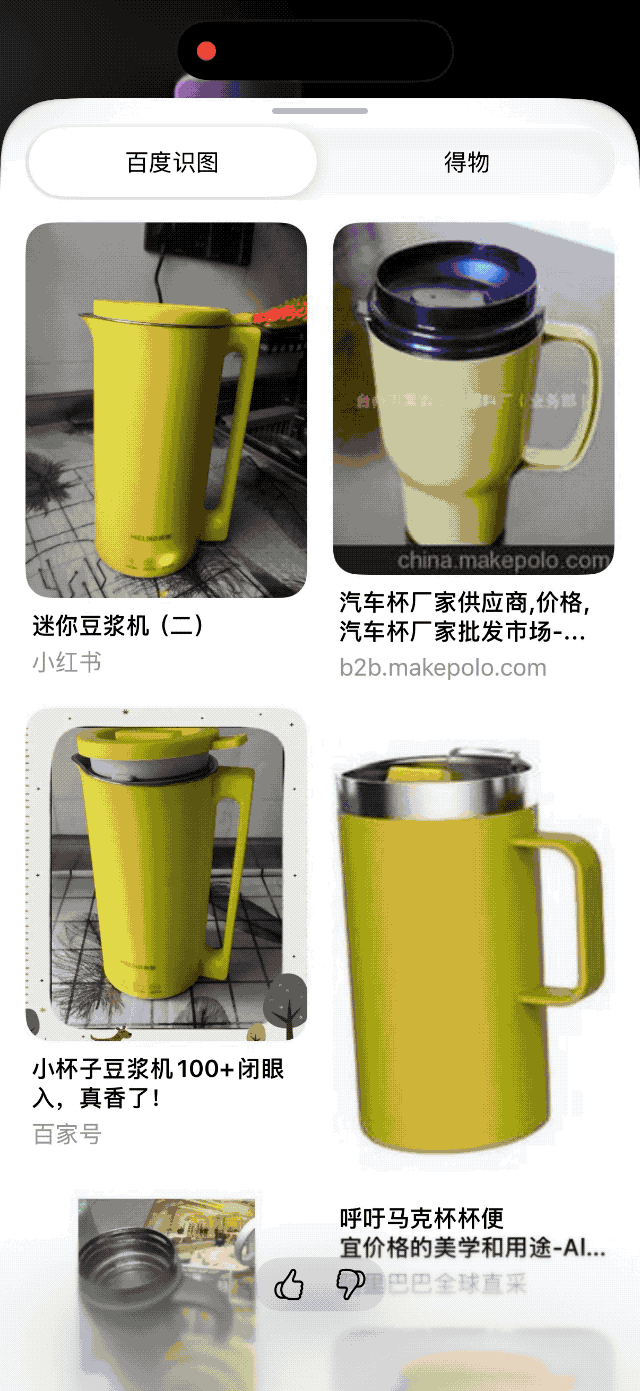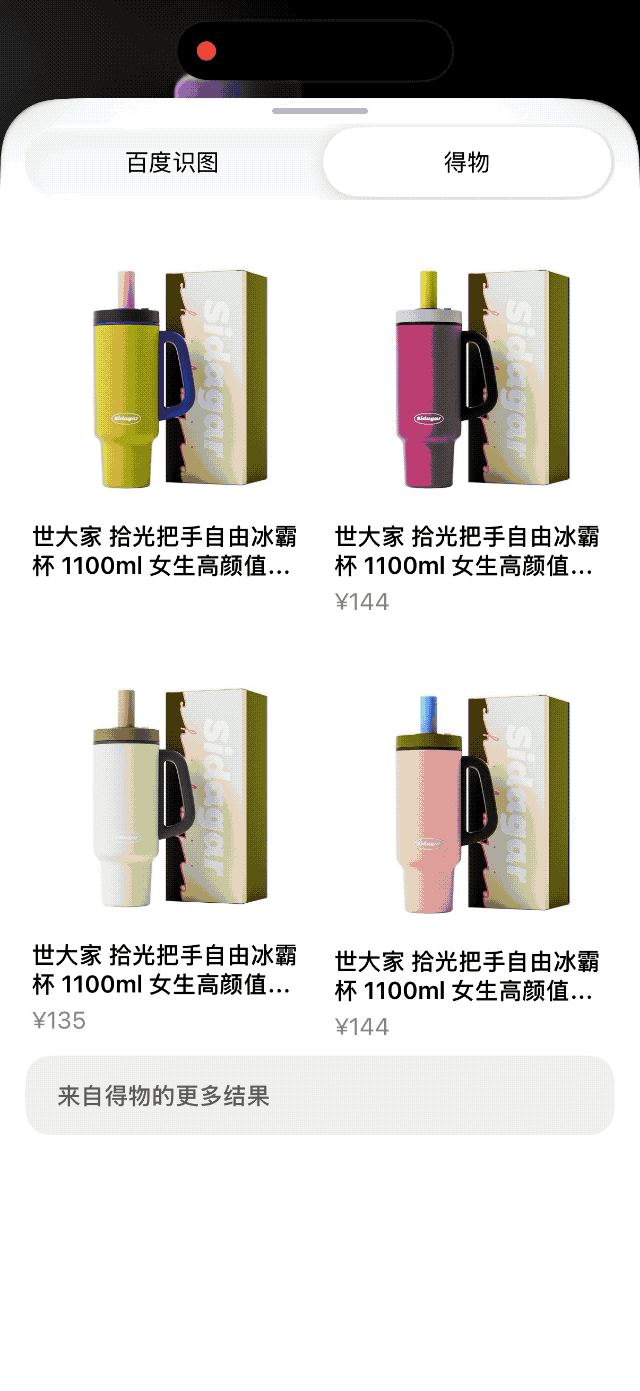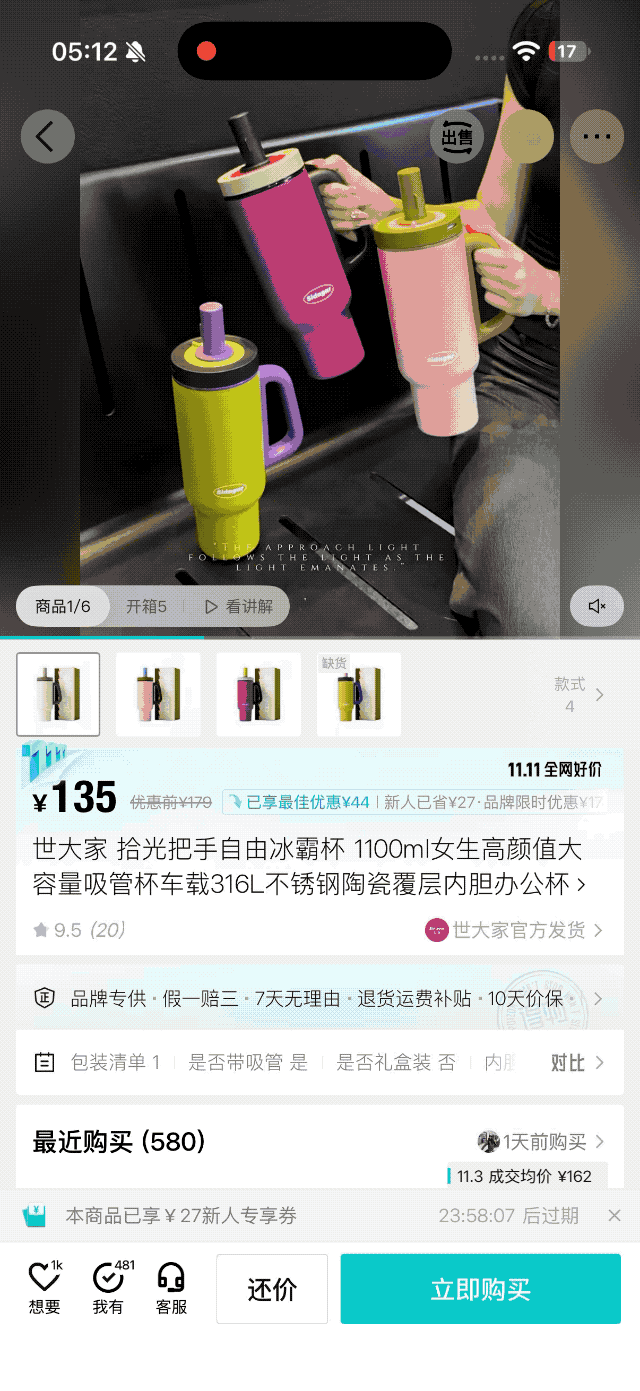
右侧的「搜索」由百度识图默认提供支持,能够根据当前画面查找相似图片。
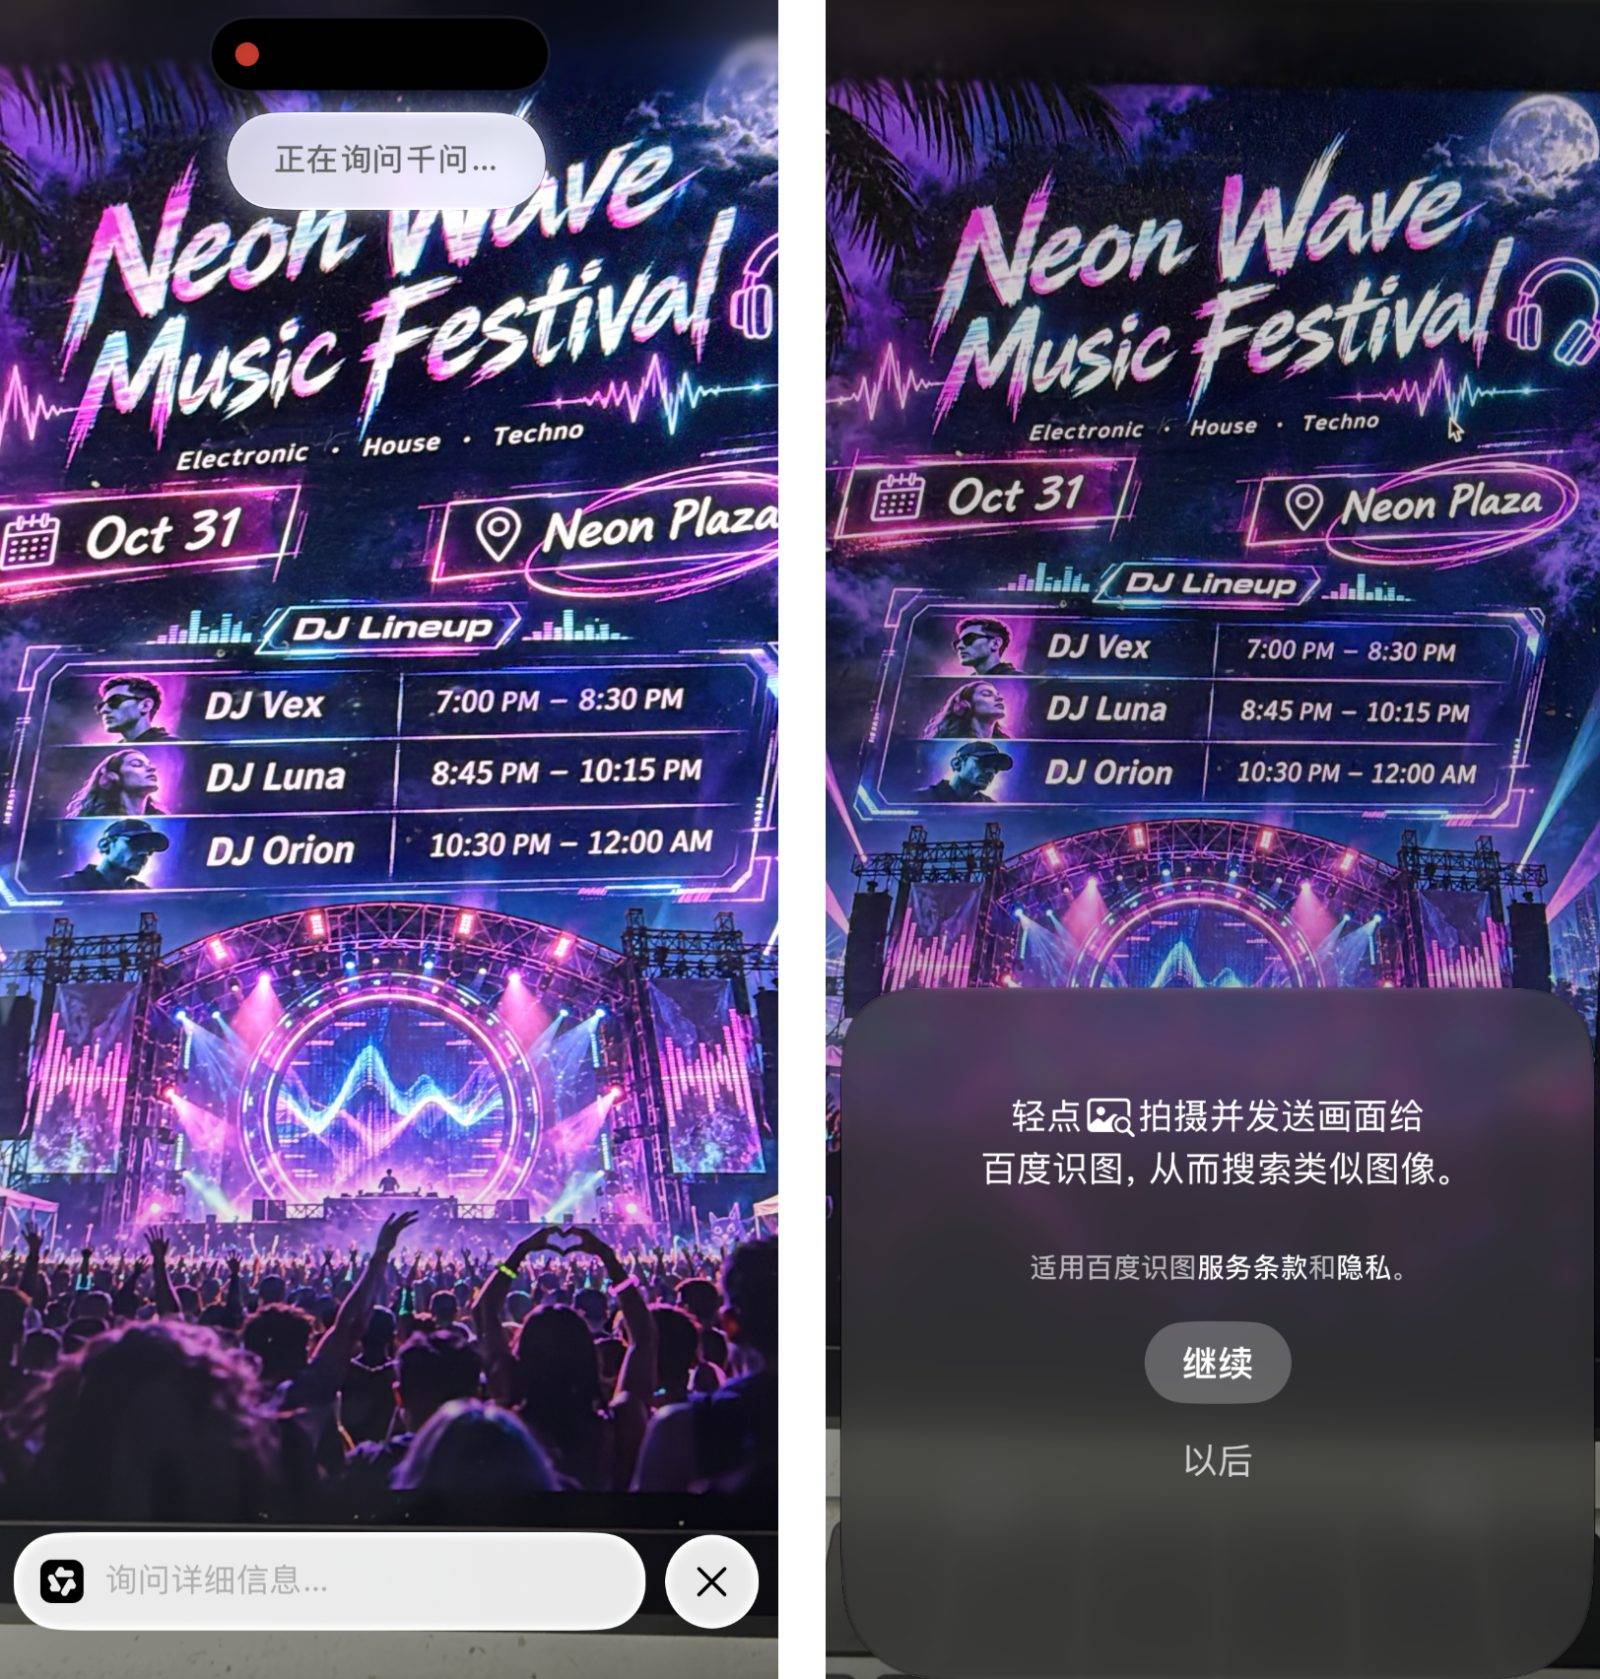
不过,如果你手机里装有接入了视觉搜索的第三方 App,比如得物,那么你同样还能得到得物的搜索结果,用户可以根据眼前的实际需求直接选择。
· 照片消除
按照苹果此前公布的信息,照片 App 此次主要迎来了消除工具、自然语言搜索和回忆影片生成三项 AI 功能。
其中,消除工具已经可以正常使用,用户只需圈选照片中的路人、杂物等干扰对象,AI 便会尝试将其去除,并自动修复背景。
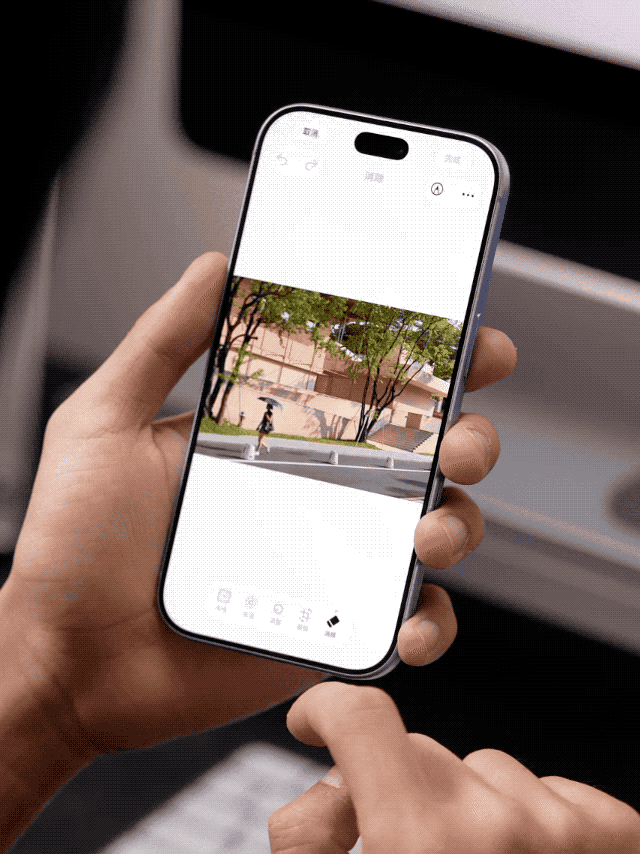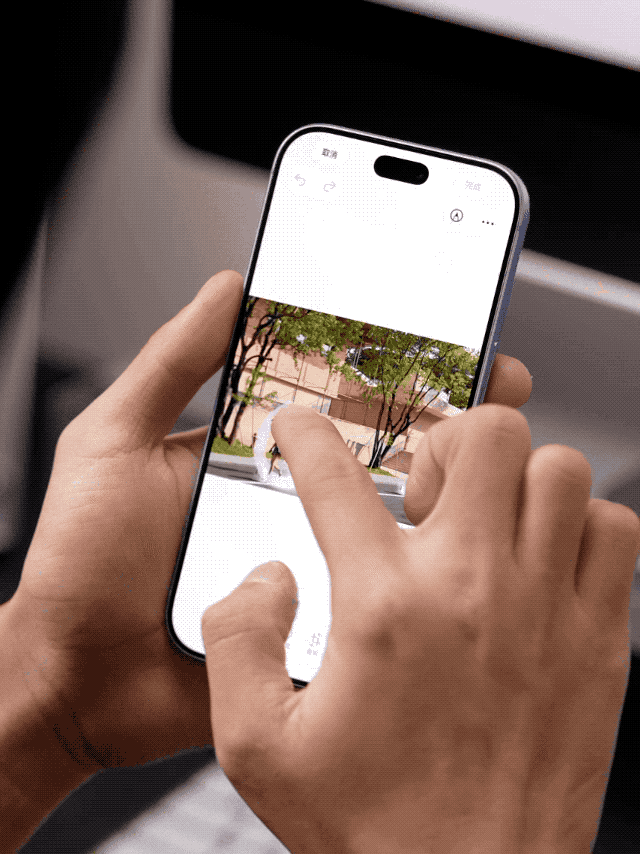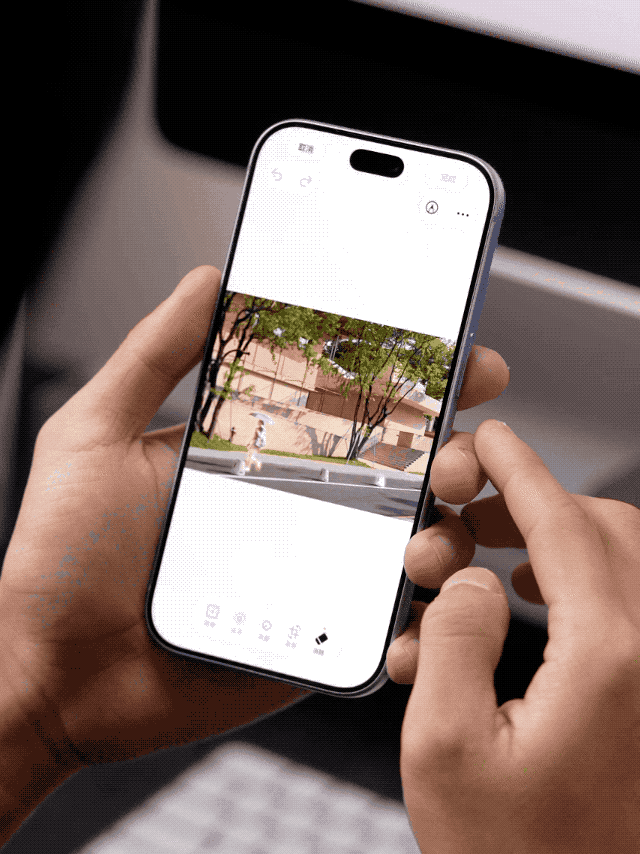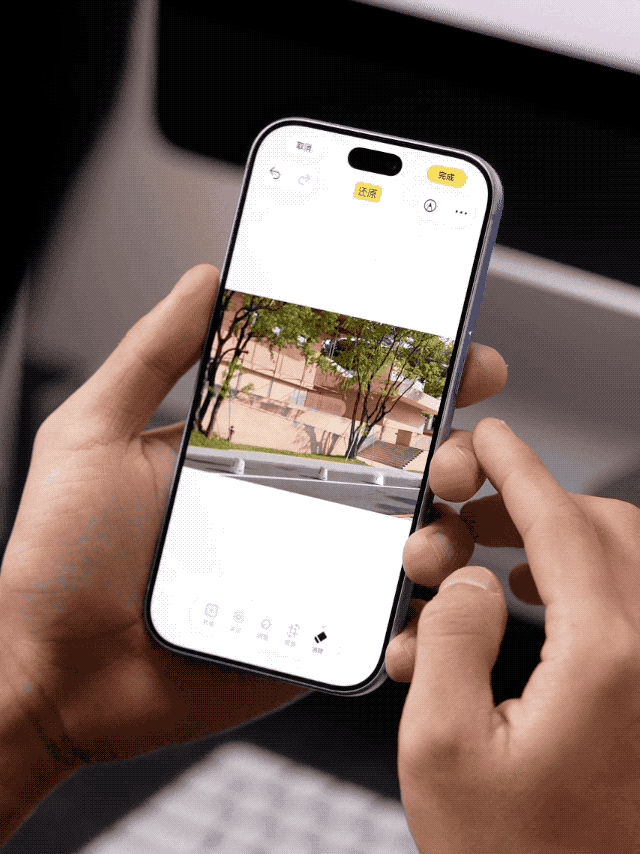
在使用消除工具的体验过程中,我们也发现照片 App 偶尔会出现闪退。考虑到目前仍是开发者 Beta 版本,相关功能的稳定性还有待完善。
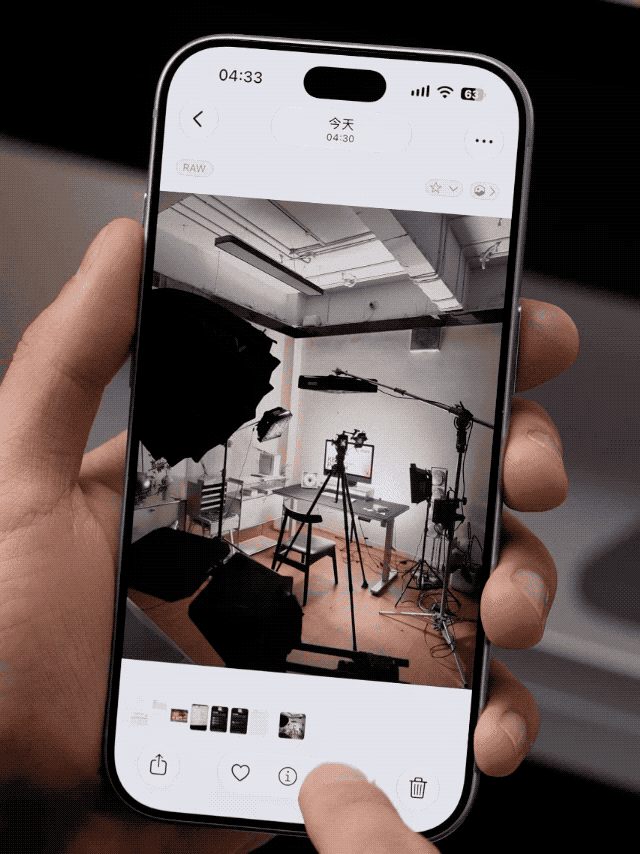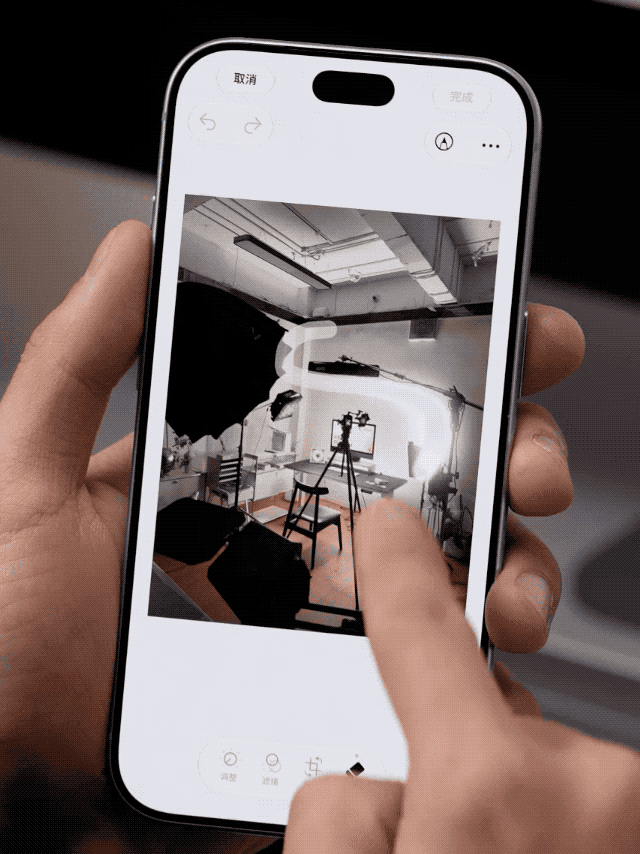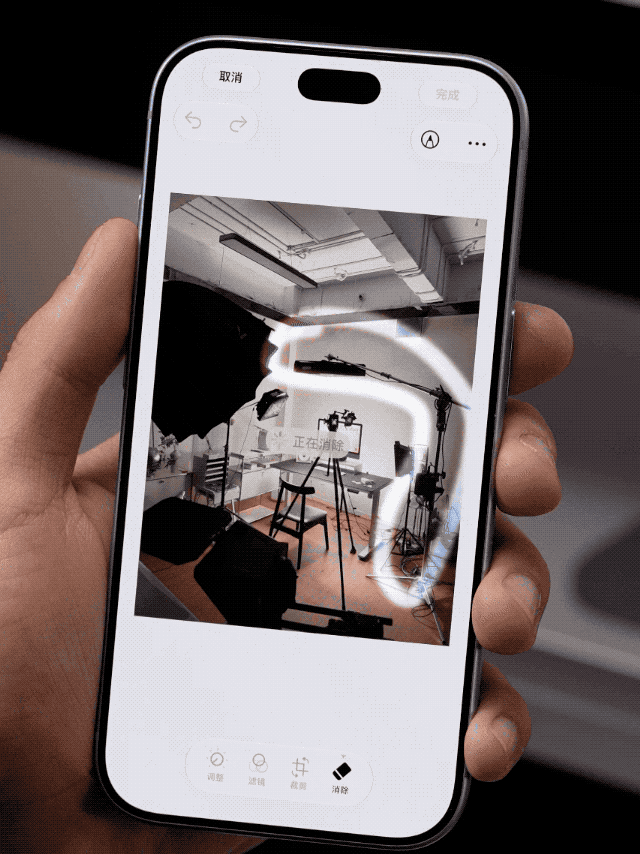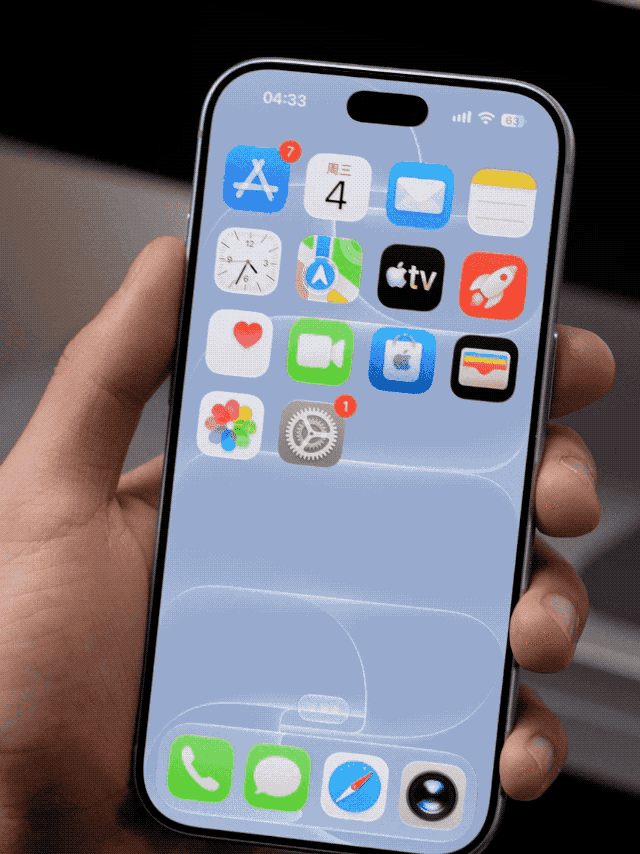
接着,我们继续提高测试难度,尝试让 AI 消除花朵旁边的自行车。结果虽然成功去除了自行车,但花朵边缘的处理明显不够自然,仍能看出 AI 修复留下的痕迹。
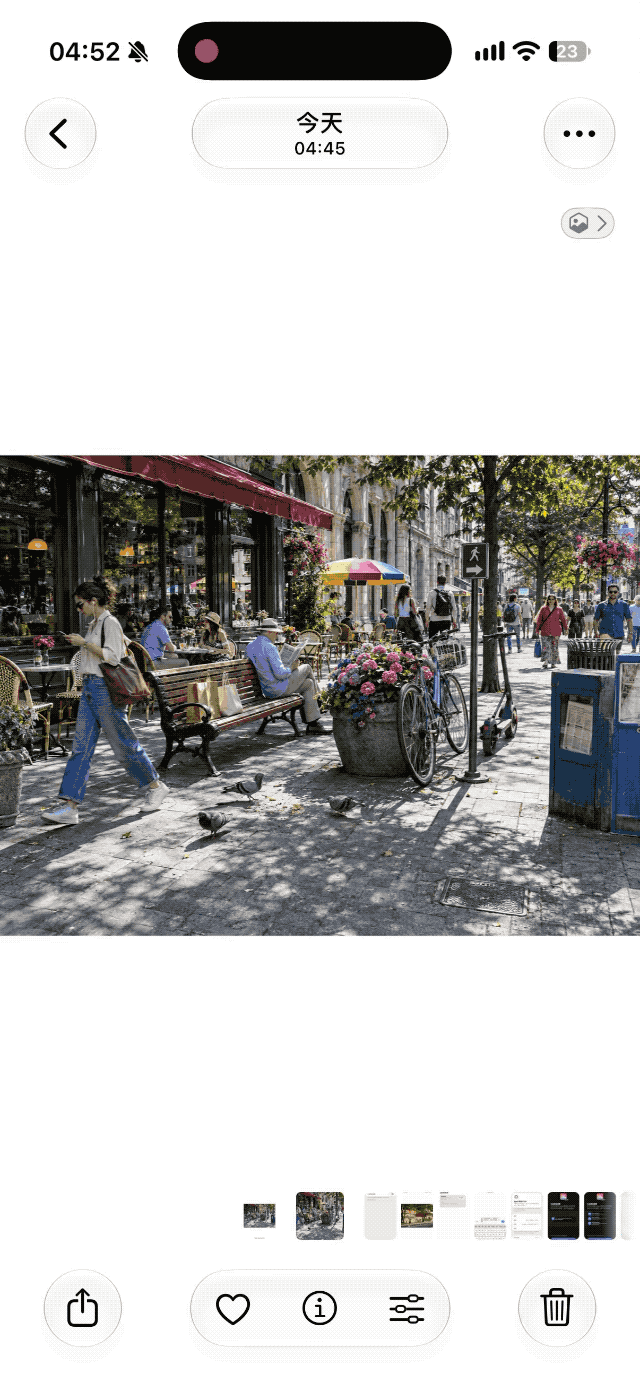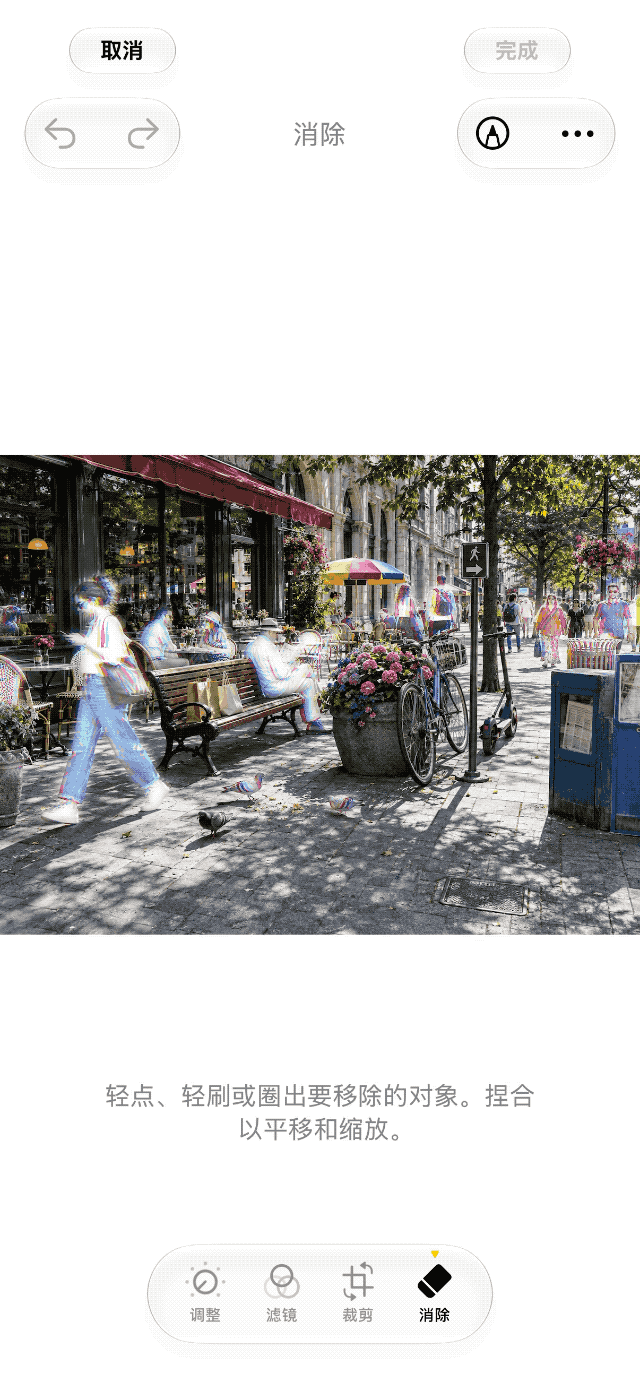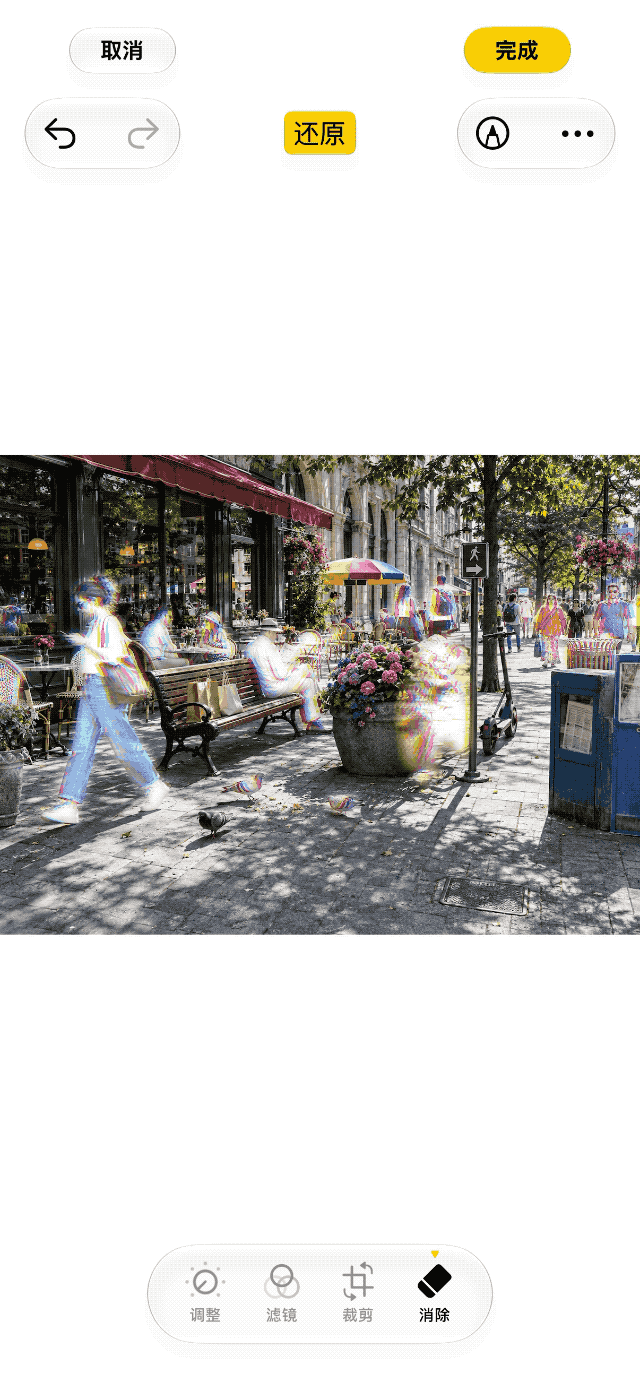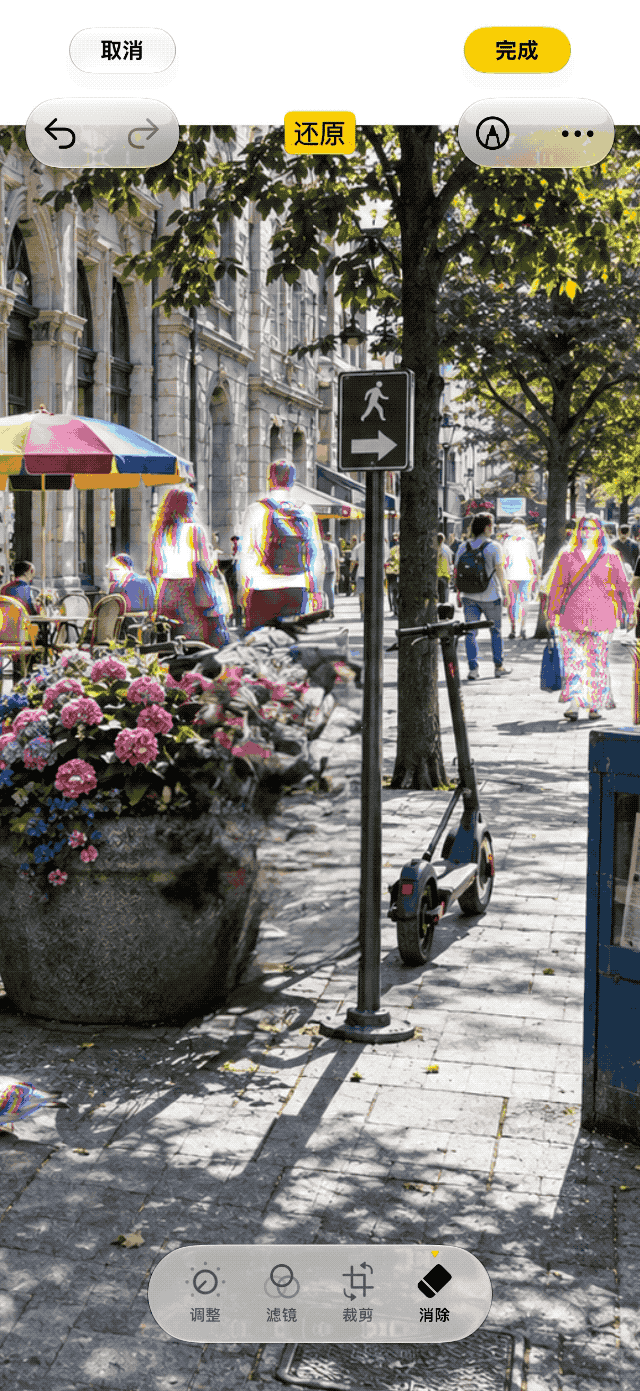
而在此次开发者 Beta 版的体验中,我目前只找到了消除工具,暂时还没有找到自然语言搜索和回忆影片生成的功能入口,也欢迎能够成功体验的朋友在评论区分享实际感受。
另外需要提一句,此次测试使用的是 iPhone 16 Pro,即便在正常室温环境下体验,手机的发热依然比较明显,尤其是在连续使用 AI 功能的过程中。
· 智绘表情
智绘表情允许用户通过文字描述生成专属表情符号。
例如,输入「一只戴着发光墨镜、正在喝冰美式的熊猫」,或者「一个因为修改十遍需求而抱头痛哭的电脑显示器」,系统便会生成相应表情。
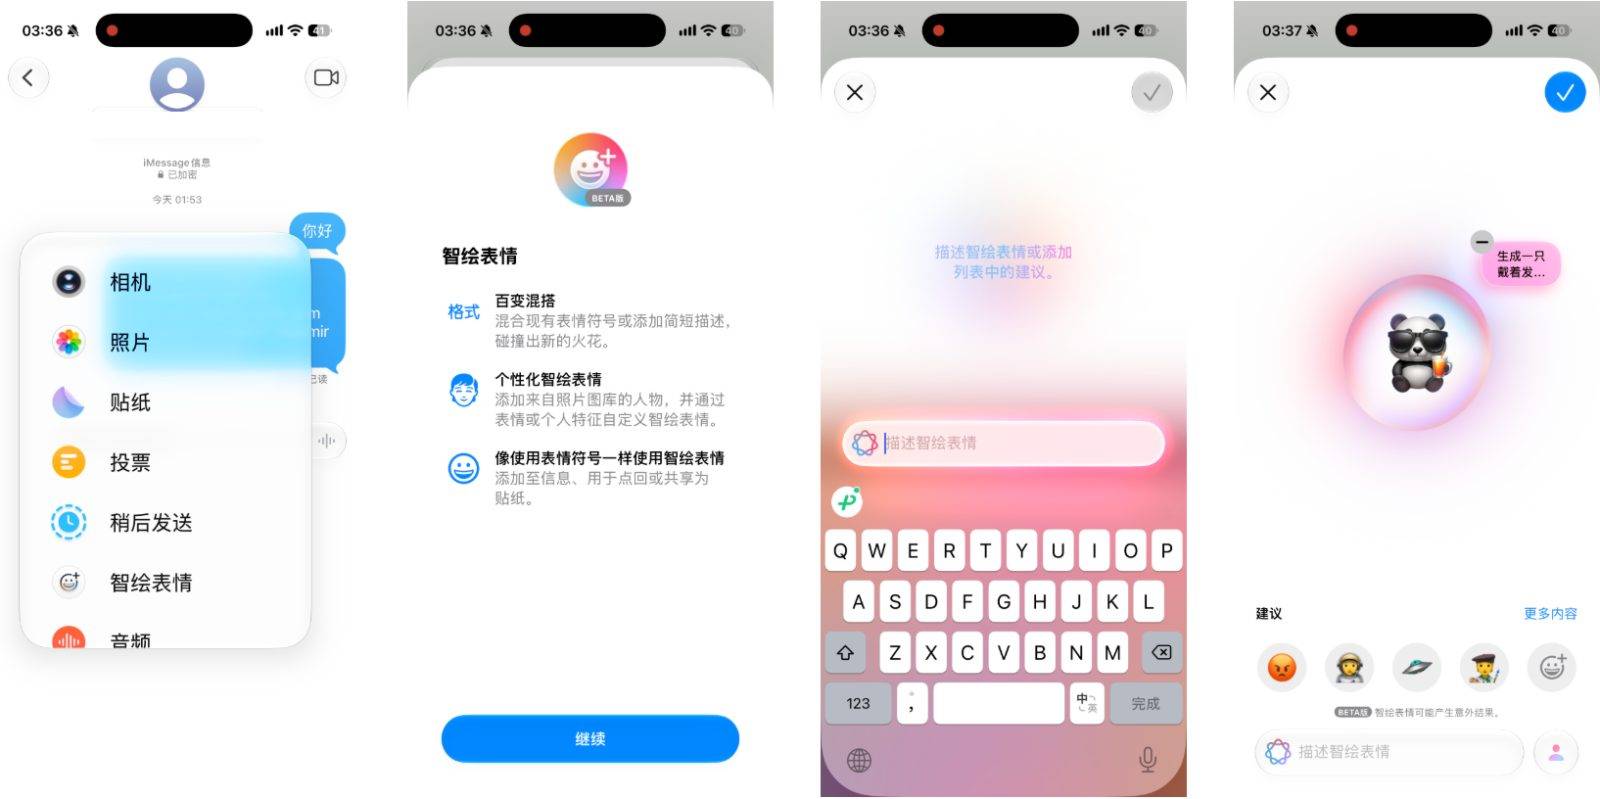
相比生产力工具,智绘表情更偏向娱乐表达,也更容易成为普通用户接触 Apple 智能的入口。
· 备忘录与通话摘要
Apple 智能还可以为备忘录中的录音和通话转录文本生成摘要,帮助用户快速了解对话内容。
例如,我让 AI 处理了一段关于周末聚餐的模拟通话录音。两个人原本打算吃火锅,后来又考虑川菜,最终因为有朋友不吃辣,决定去公司楼下的一家粤菜馆,还讨论了清蒸鲈鱼、烧鹅等菜品。
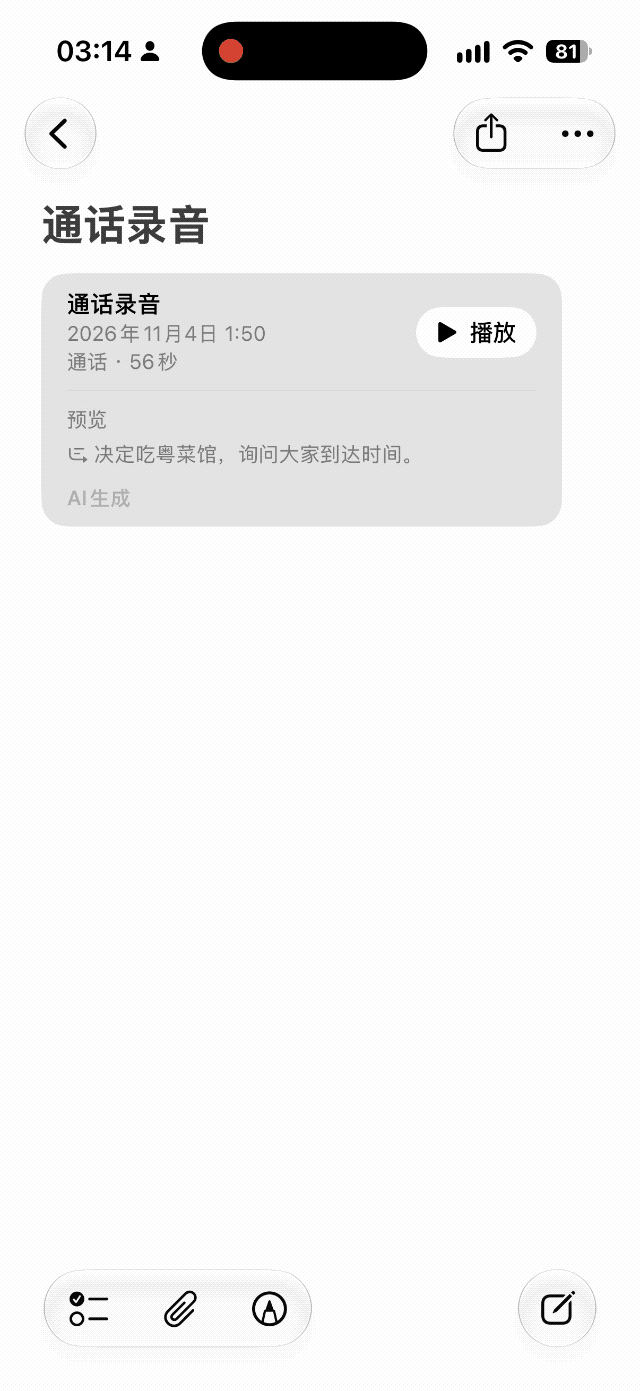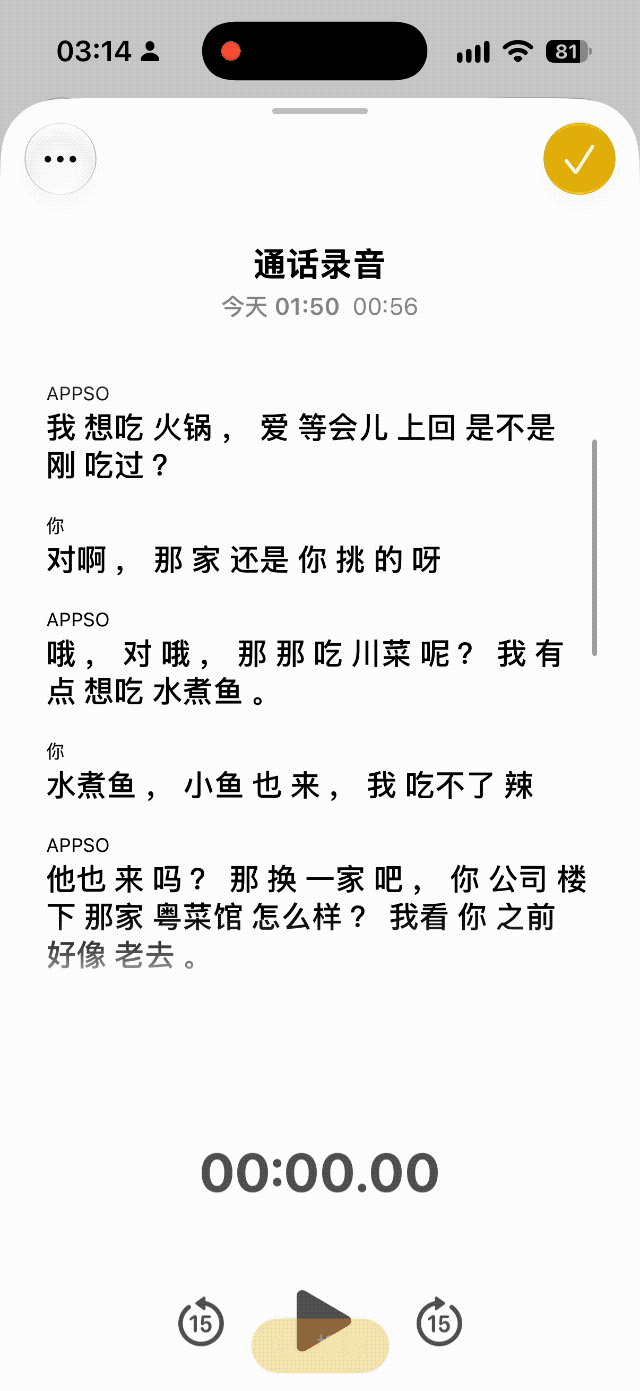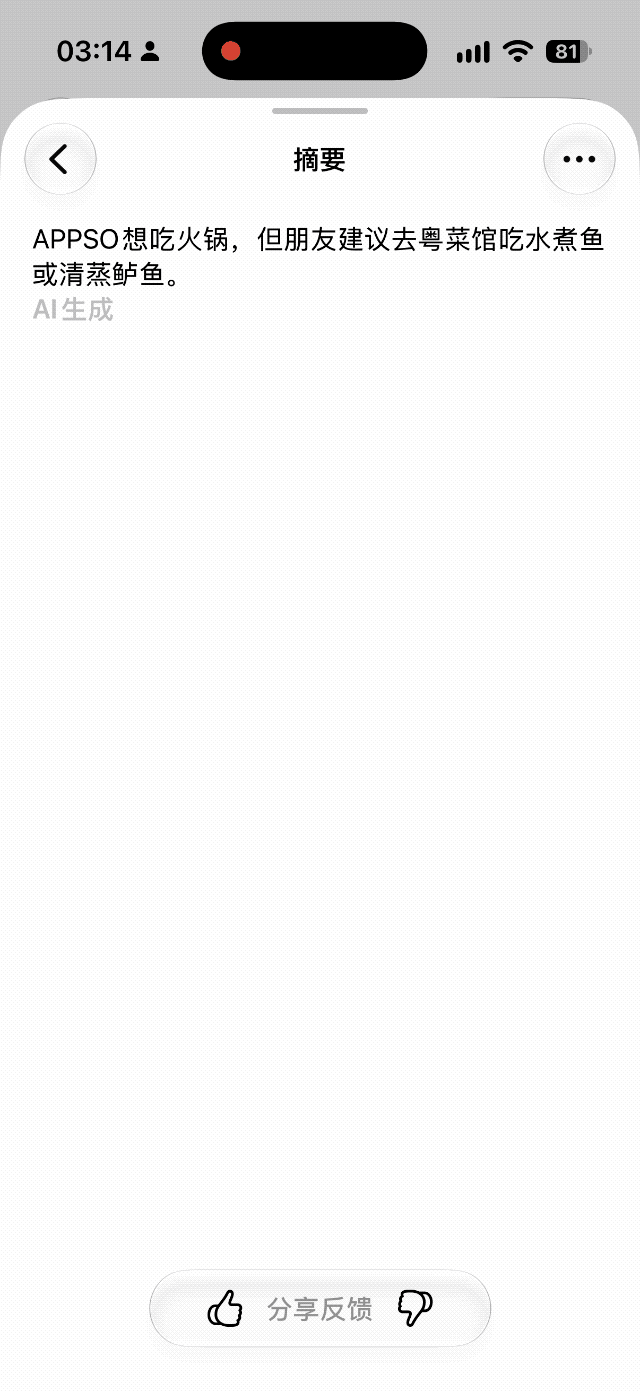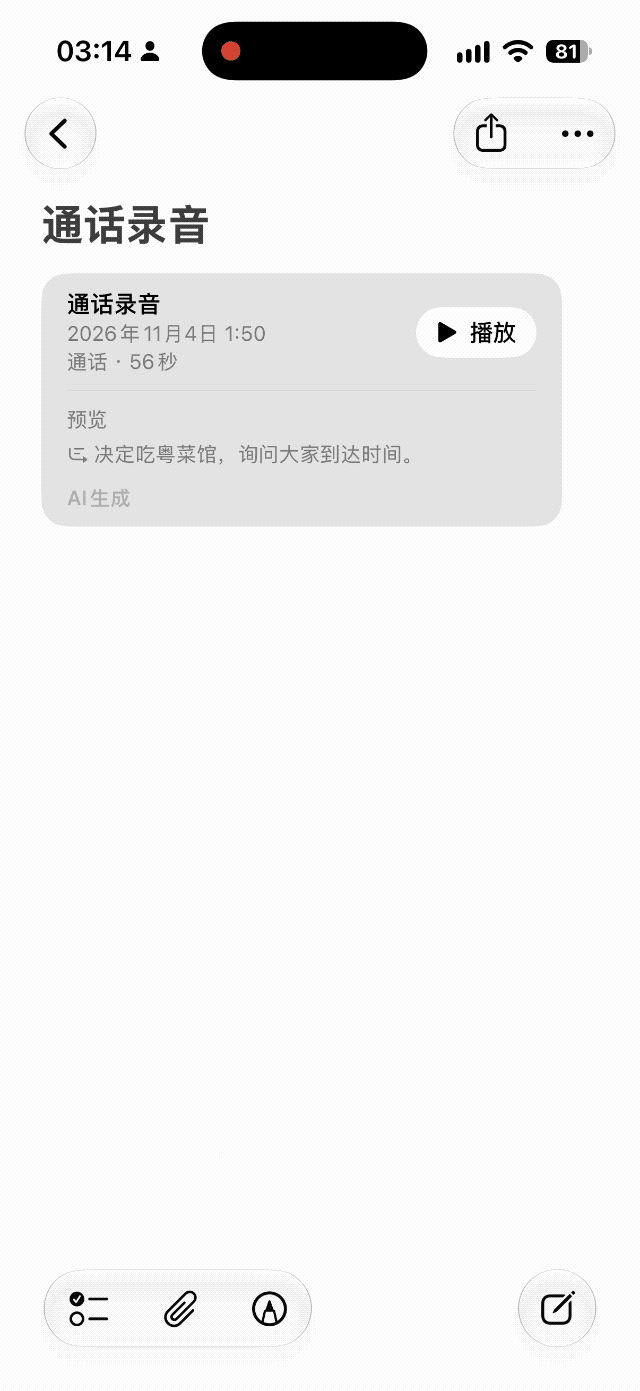
整段对话充满了临时改口和闲聊,但真正有用的信息在 AI 的辅助下变得异常清晰。
对于经常开会、电话沟通或整理采访录音的用户来说,类似的 AI 摘要功能可以帮助快速提取关键信息,减少反复回听录音和手动整理文字的时间。
· Siri 升级
在所有功能中,Siri 的变化可能最受关注。
此次更新,Siri 支持文字输入、理解临时改口,并能在连续对话中保持上下文。
例如,用户说「帮我设置早上 7 点的闹钟,算了,改成 8 点半,备注叫选题会」,Siri 可以理解用户最终想要的操作。
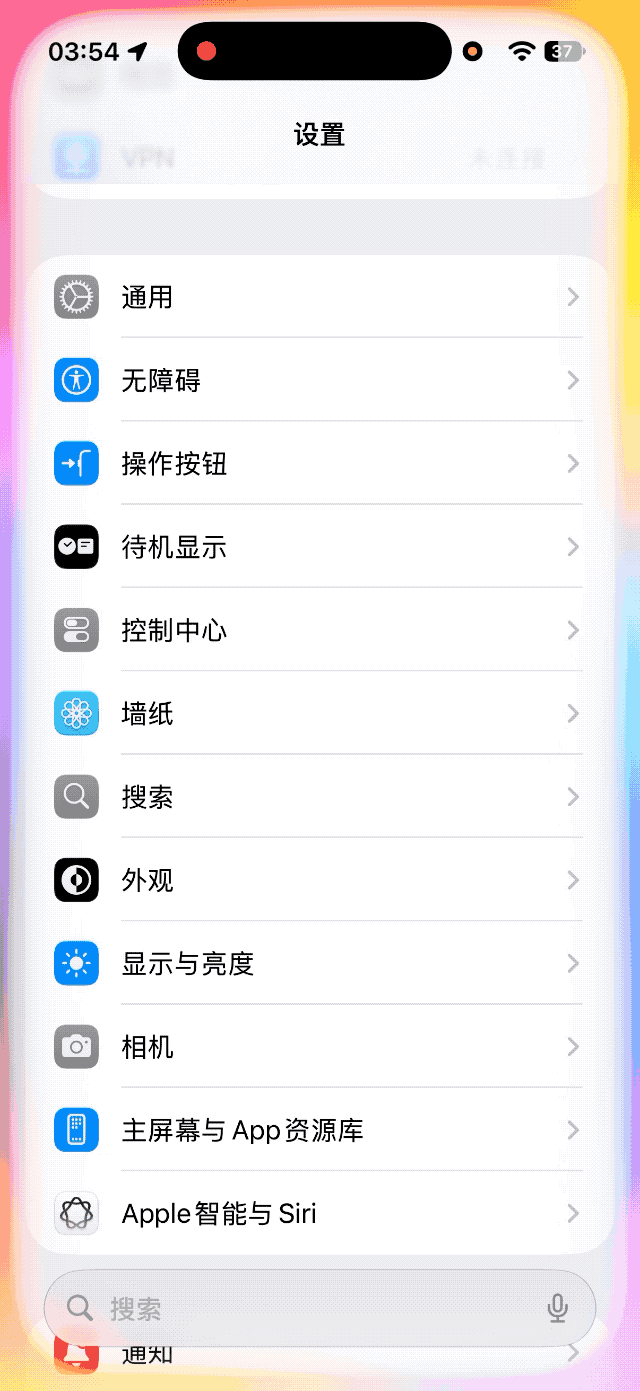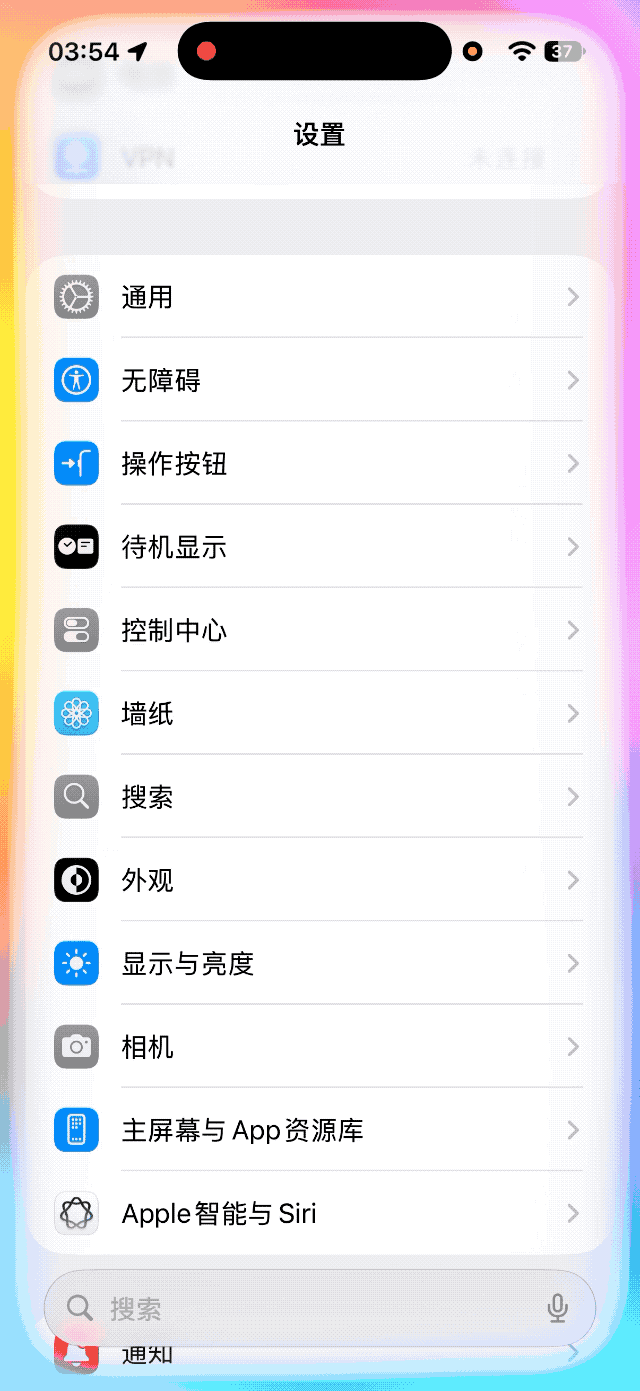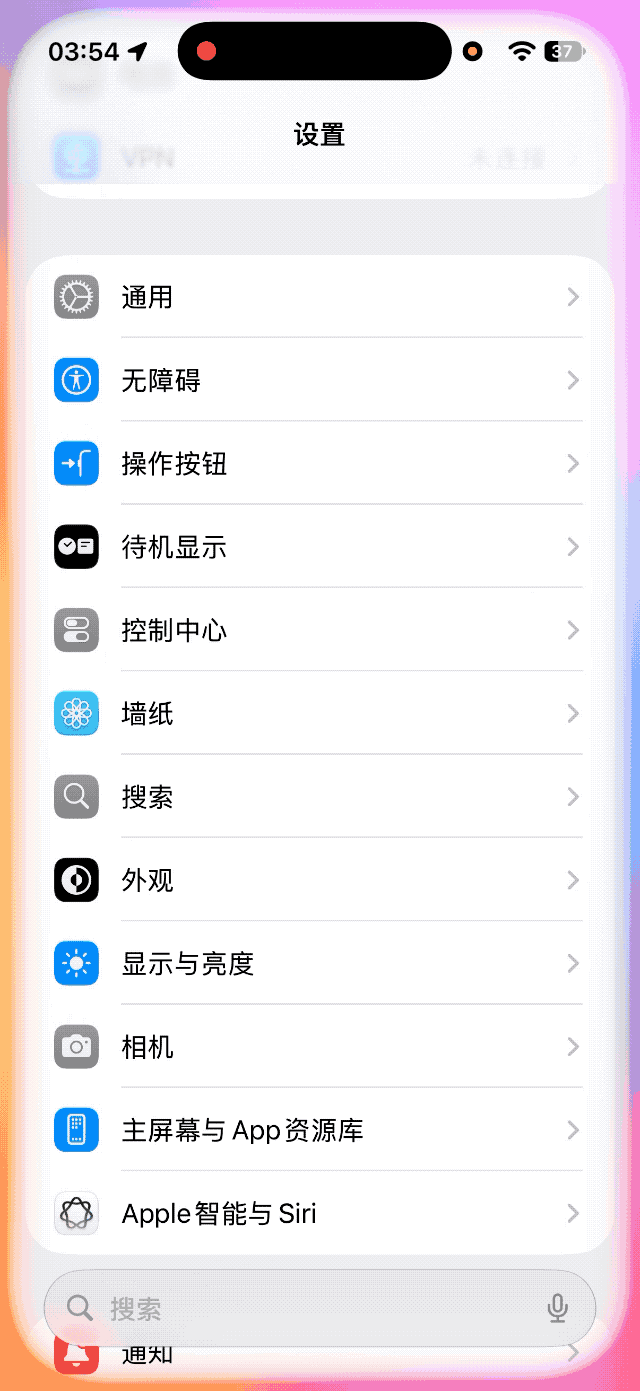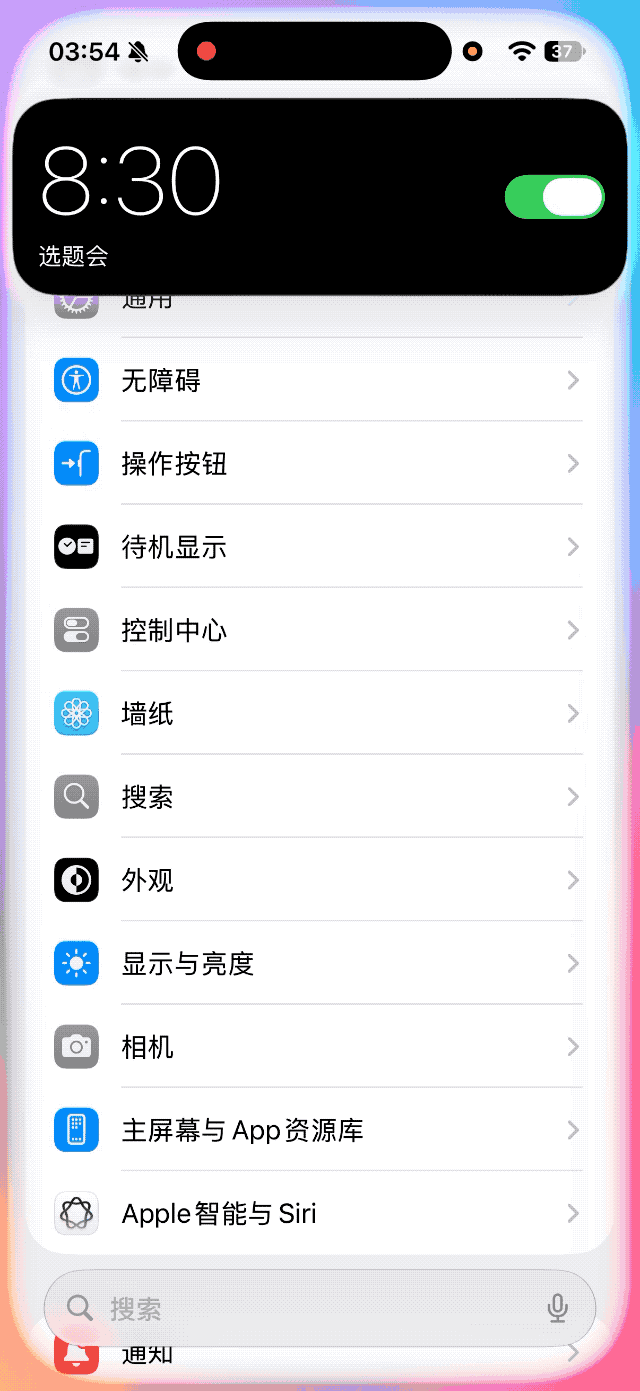
更重要的是,苹果也正式将千问引入部分 Siri 体验。
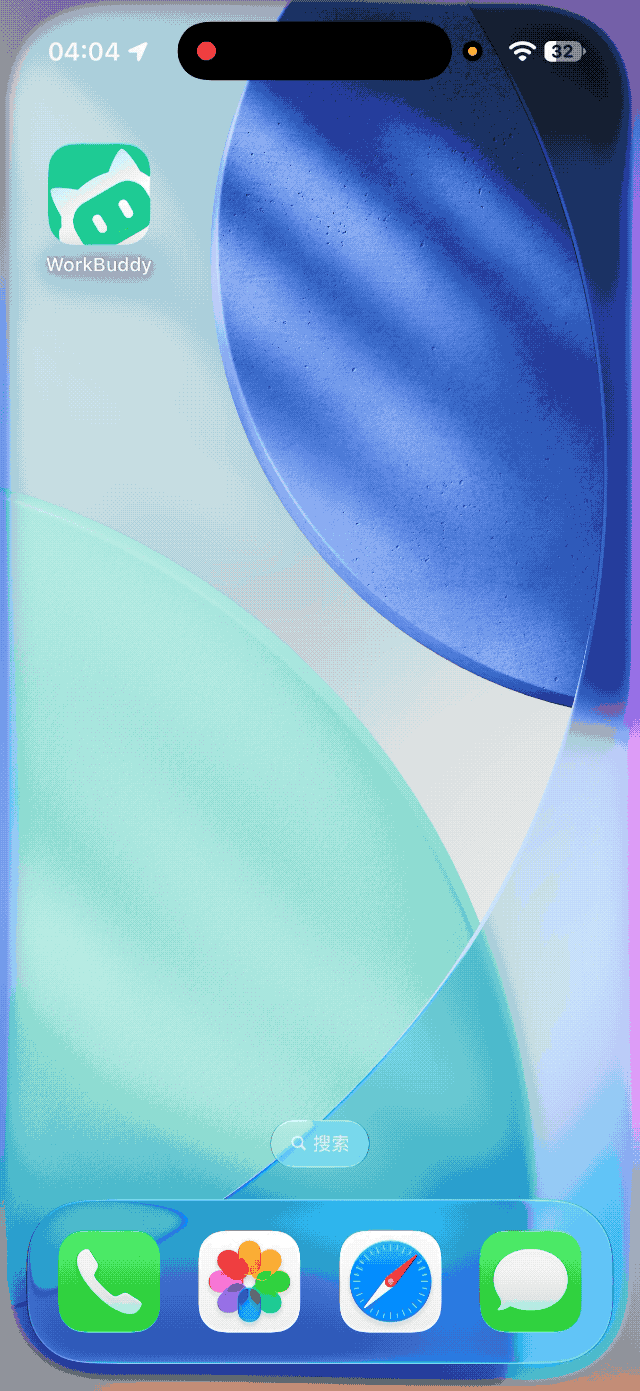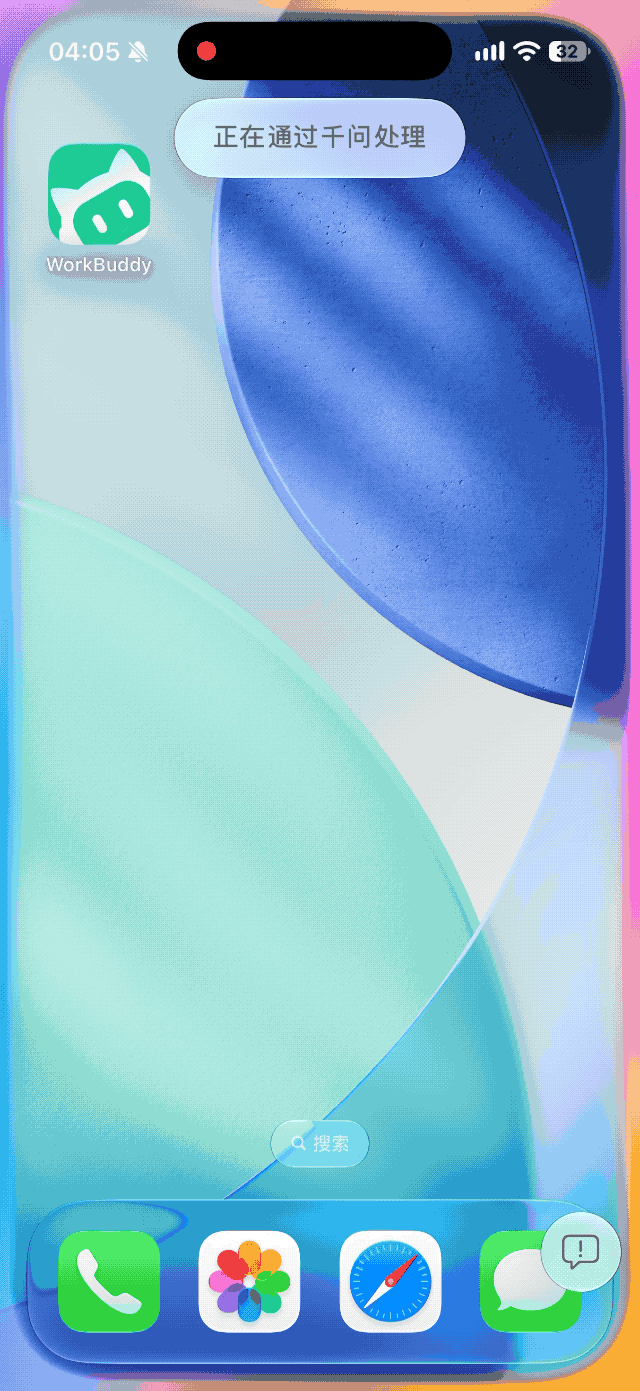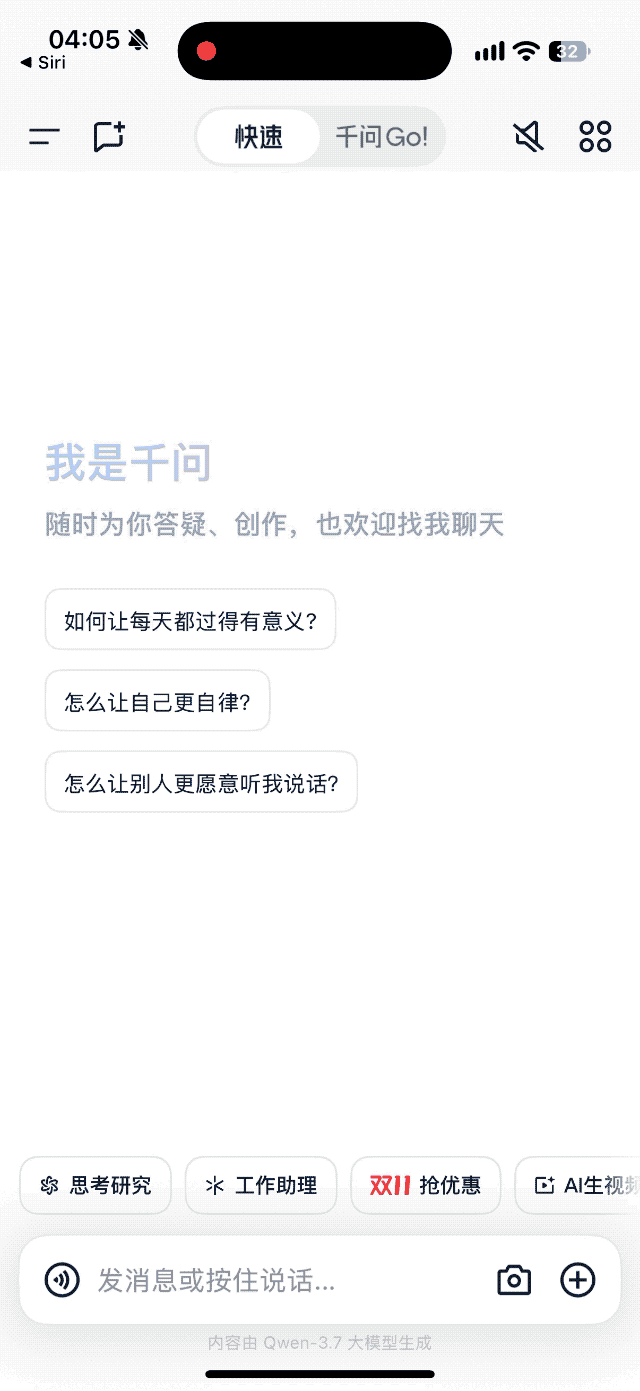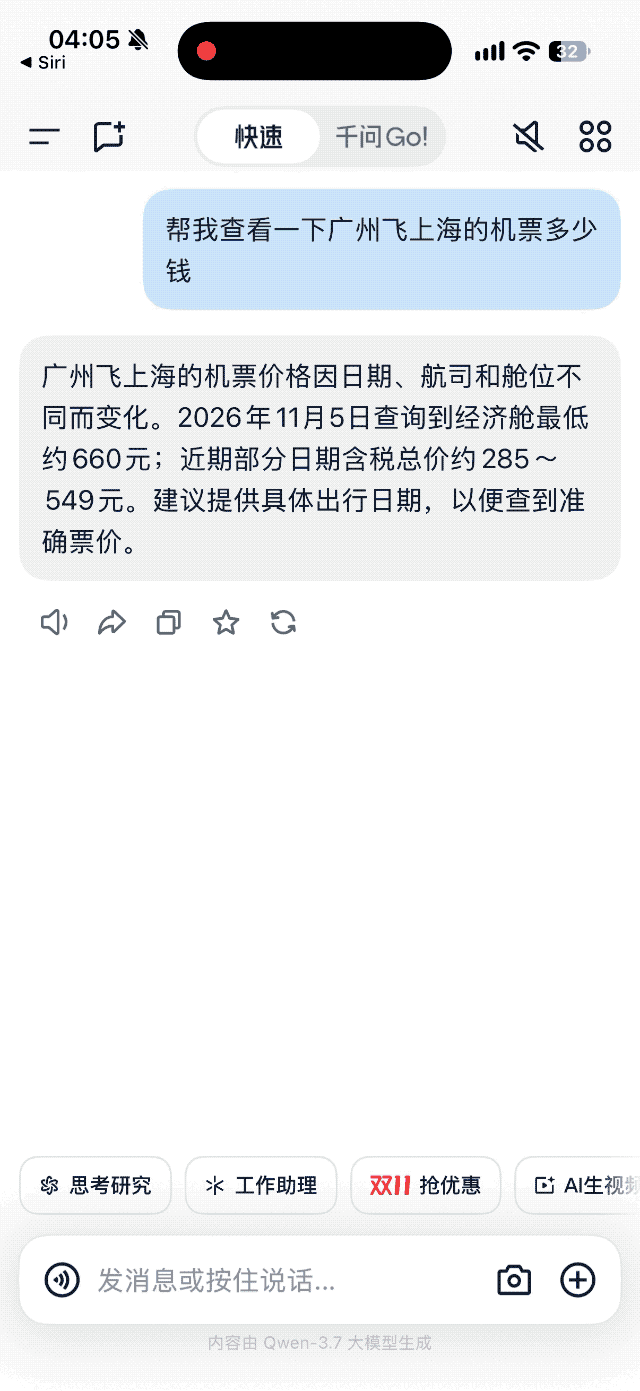
用户可以向 Siri 提出复杂知识问题,也可以针对照片、PDF、演示文稿等资料提问,比如我问 Siri 广州飞上海的机票多少钱,Siri 会给出千问的回答,然后也可以一键跳转到千问 app。
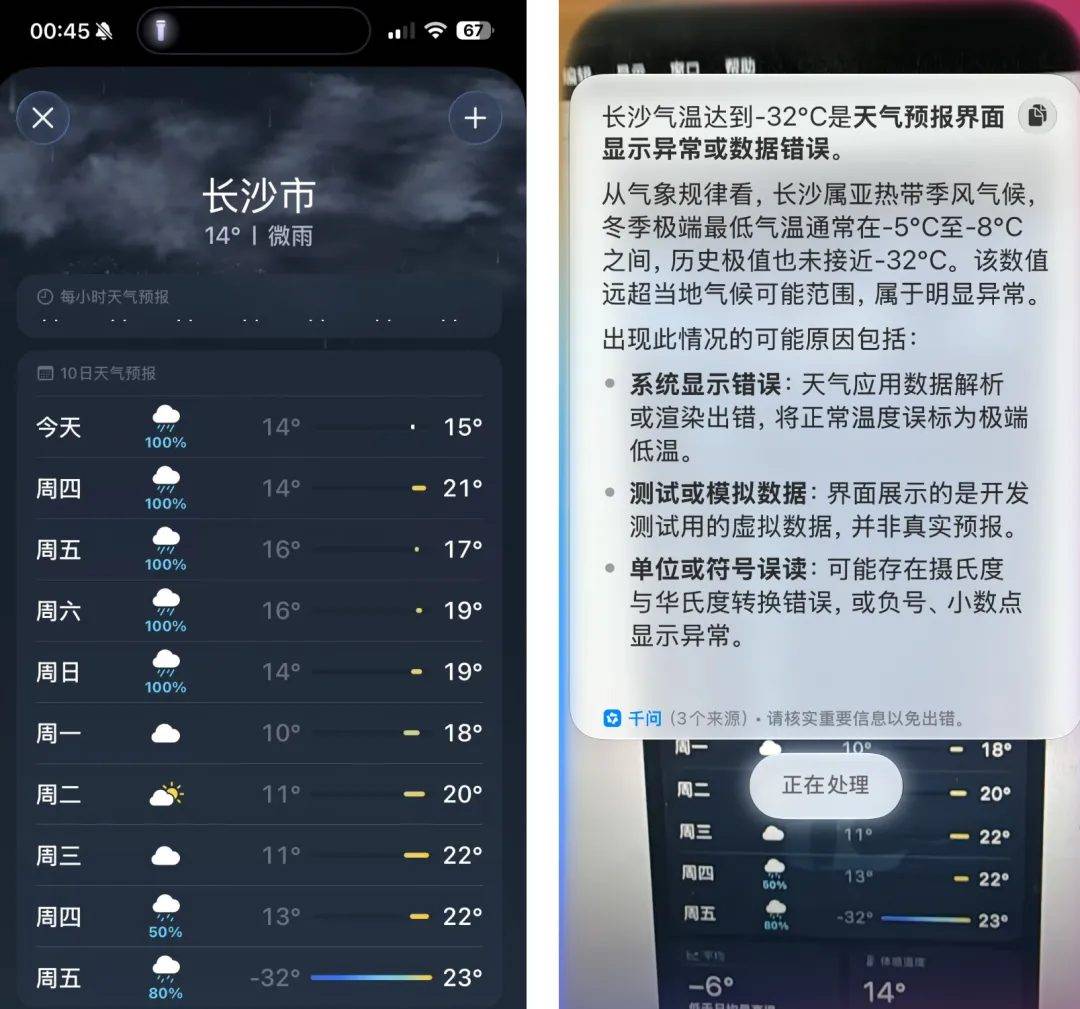
再比如,苹果自家的天气 App 偶尔也会出现「幻觉」,但在这次体验中,国行 Apple 智能却没有出现 AI 幻觉。
APPSO 实测发现,简单问题可以直接由 Siri 回答,遇到购物、寄快递、旅行规划等复杂需求时,则可以跳转千问 App,调用其连接的淘宝、顺丰速运、哈啰等服务继续处理。
例如,用户通过视觉智能识别一件衣服后,可以进一步前往千问寻找淘宝同款,比较价格并推进下单。
此外,Apple 智能的实时翻译整合进信息、FaceTime 和电话 App,搭配支持的 AirPods,还能实时翻译面对面对话,减少跨语言沟通时频繁切换翻译软件的麻烦。
邮件 App 则新增优先邮件、邮件摘要和智能回复,通知系统也加入通知摘要、首要通知和减少干扰专注模式,帮助用户从大量邮件和通知中更快找到重要信息。
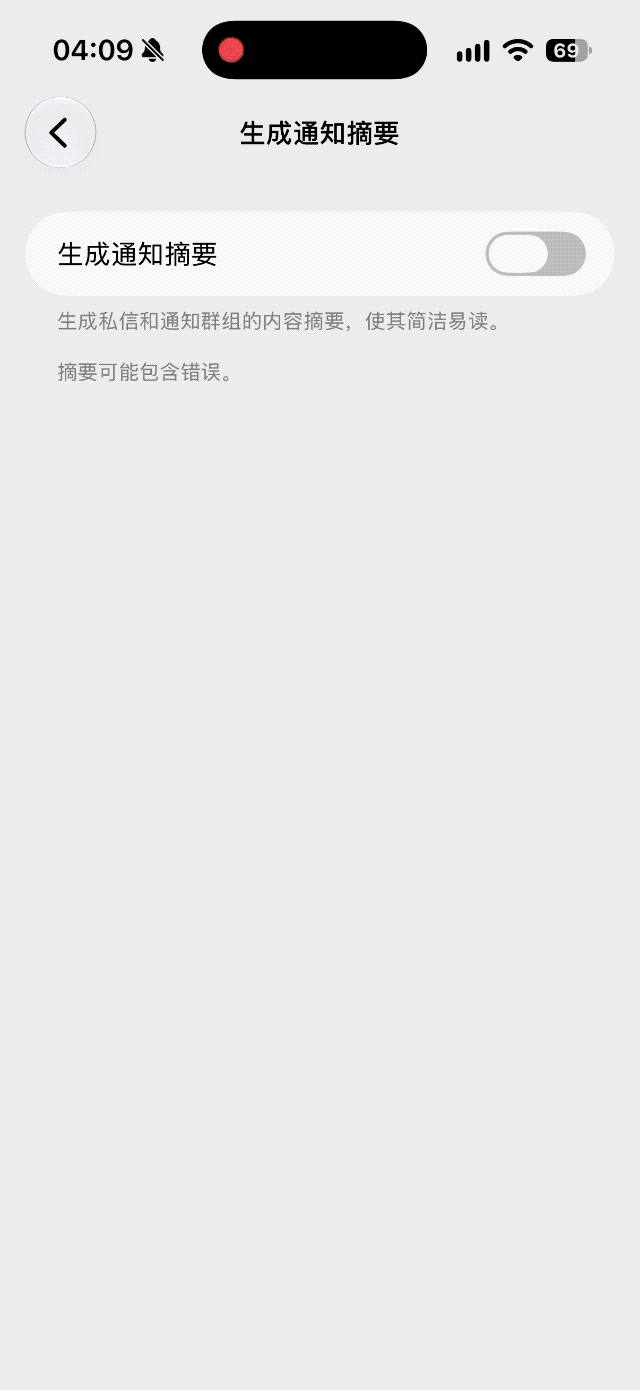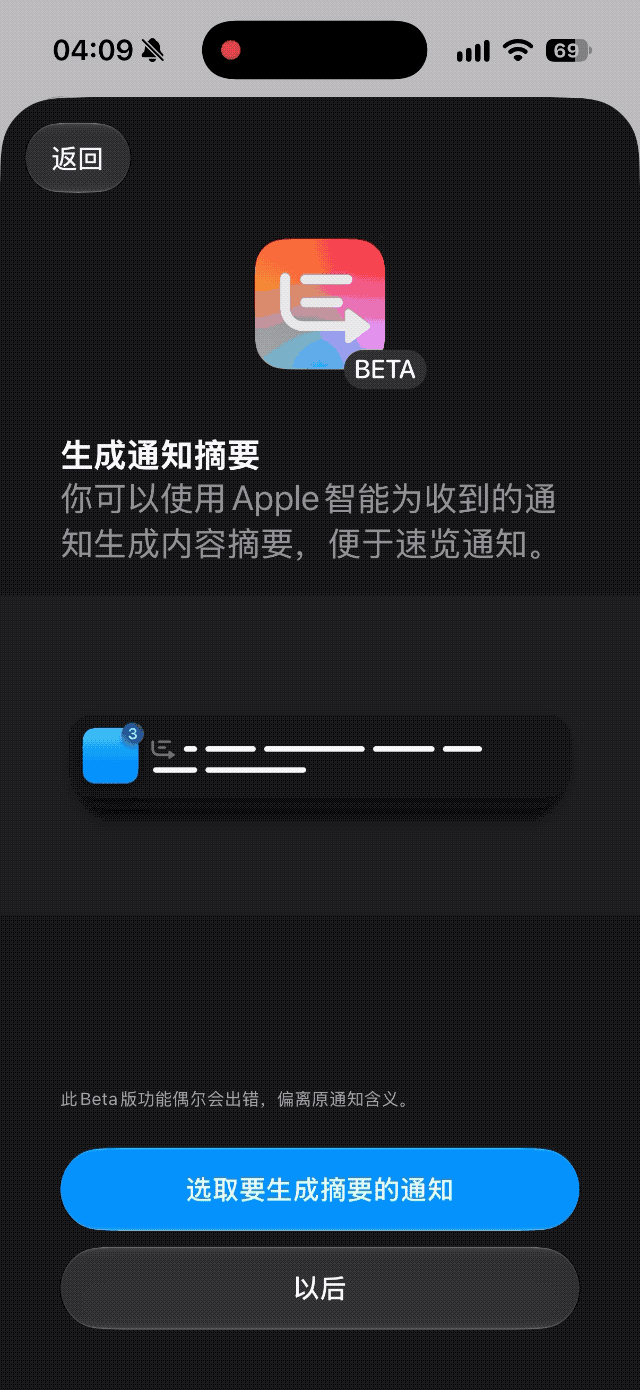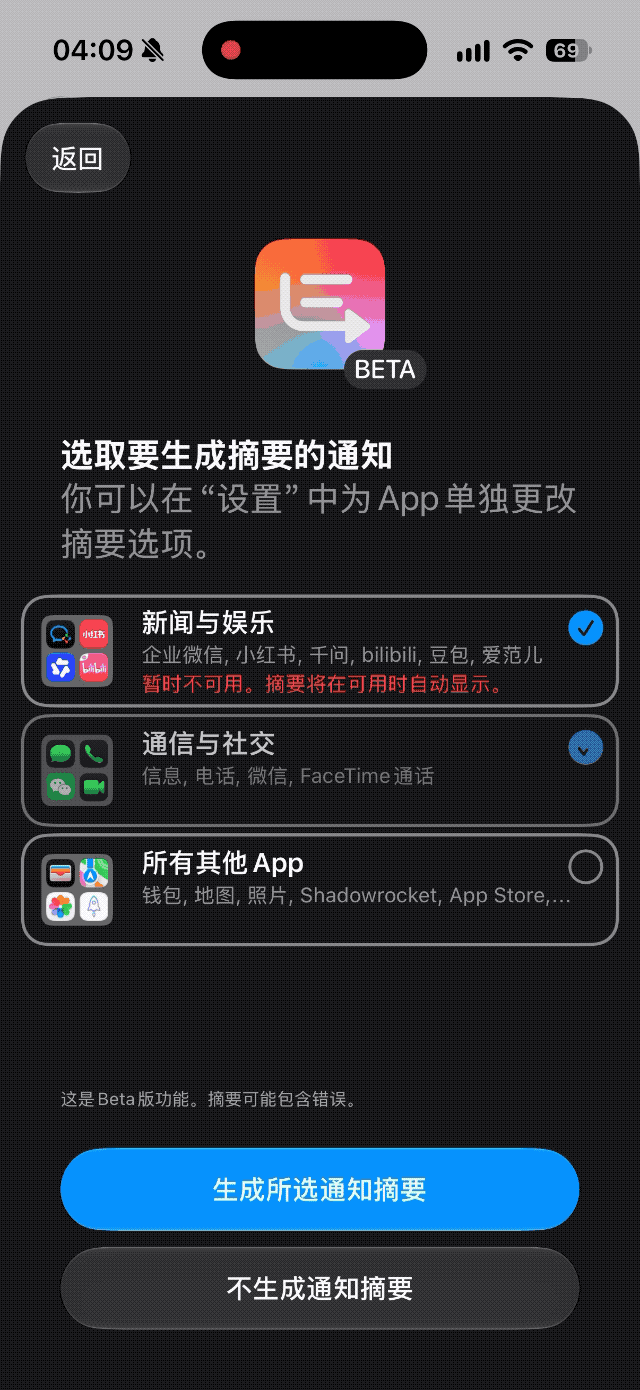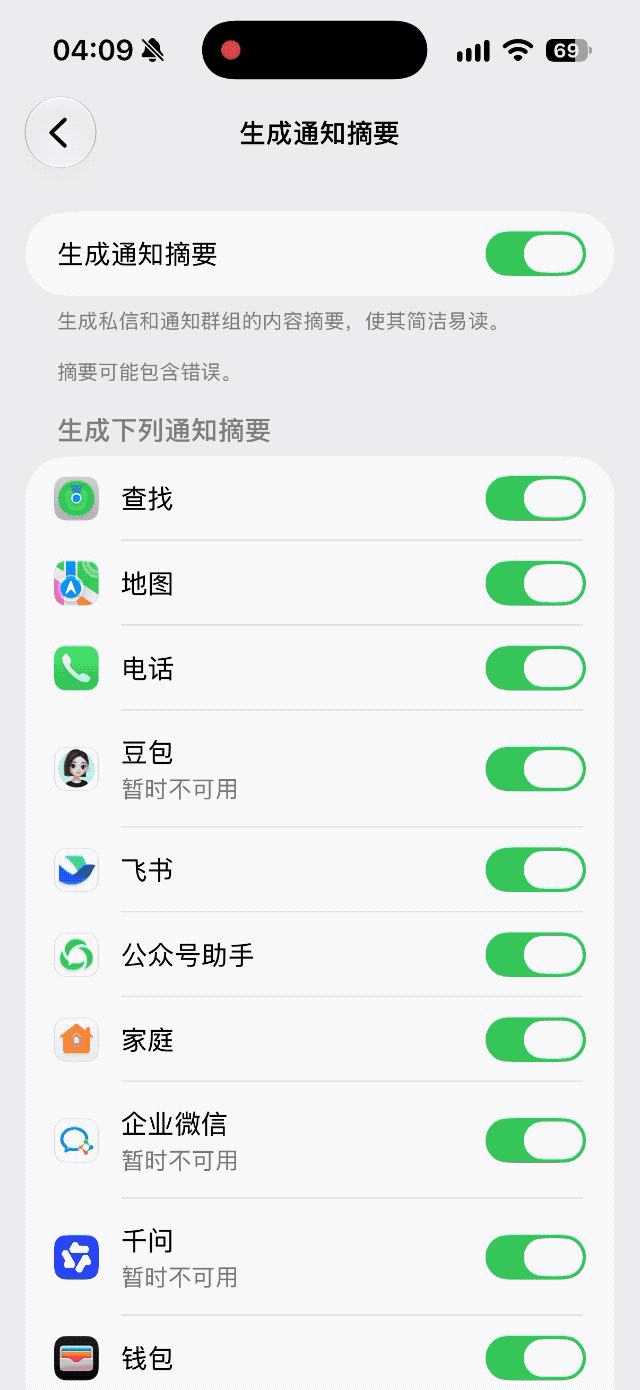
相比单个 AI 功能,苹果与千问合作带来的另一种可能性更值得关注。部分复杂任务需要跳转千问 App 继续处理,跨应用的上下文能否保留、多个操作能否连续完成,仍有待进一步观察。
距离一个能够主动理解需求、调用不同应用完成任务的智能助手,Apple 智能还有相当长的路要走。
有趣的是,在智能手机过去十几年的发展史上,苹果一直扮演着市场教育者的角色。
从 Touch ID 到 AirPods、灵动岛,苹果经常负责把新的技术和交互方式带到大众面前,再由国产厂商迅速跟进,利用价格和本土化优势推广到更广泛的市场。
到了 AI 手机时代,攻守之势异也。
过去两年,华为、小米、荣耀、OPPO、vivo 等国产厂商轮番登场,从 AI 消除、智能摘要到跨应用 Agent,几乎把能讲的 AI 手机故事翻来覆去讲了个透。
尽管真正改变用户习惯的功能仍然有限,但「手机应该有 AI」的认知已经逐渐形成。消费者开始知道手机里的 AI 能做什么,心里也各自攒下了一把衡量好坏的尺子。
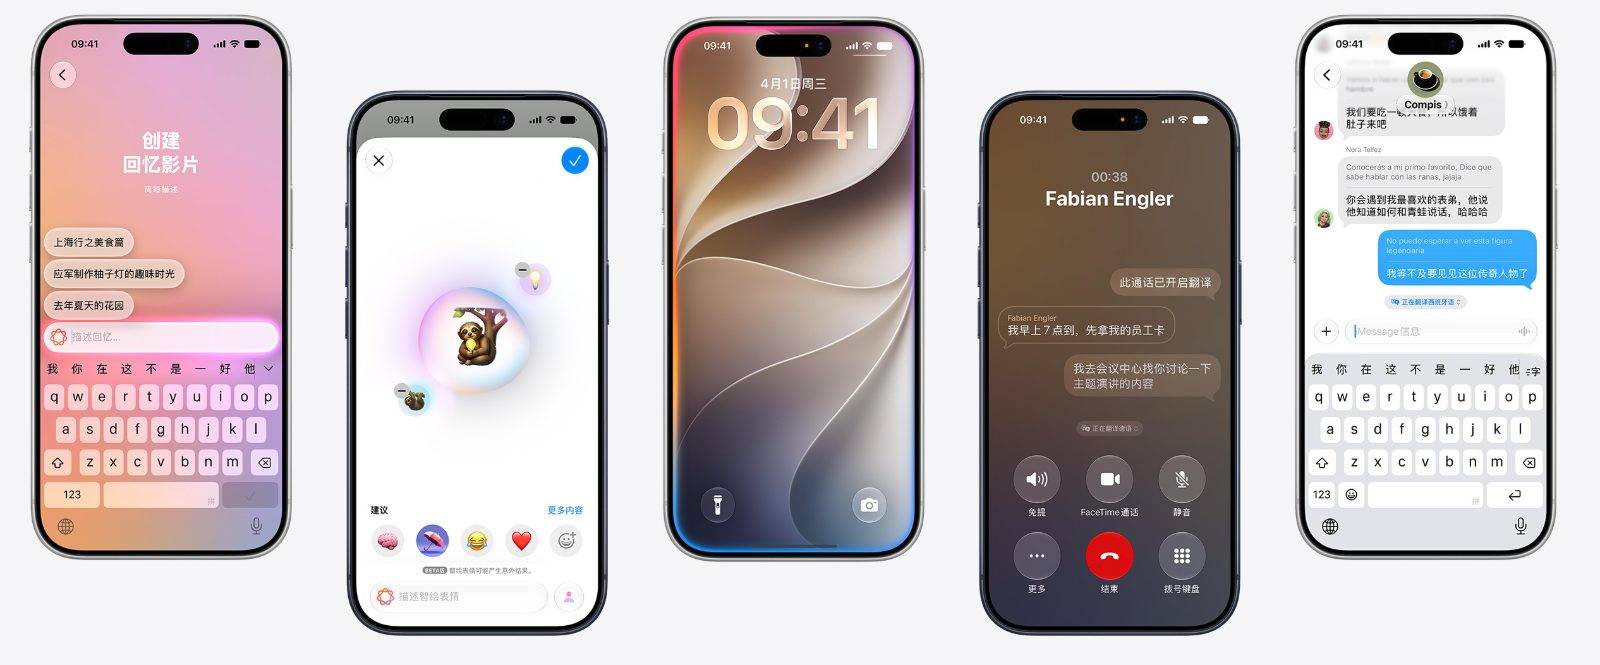
姗姗来迟的苹果,反倒阴差阳错地当了一回乘凉的受益者。
它省去了向用户解释 AI 手机有什么用的过程,可以直接将 Apple 智能带到一个已经接受过市场教育的消费群体面前。只是单看首批交卷的基础功能,则比较中规中矩。
当用户满心期待重新定义端侧 AI 的苹果交出一份包含消除、摘要、改写等基础功能的答卷时,不可避免地会产生「就这?」的看法。
如今,AI 手机时代最有意思的反转莫过于此,习惯了领跑的苹果,接下来也需要用 AI 的真本事证明,后来者总有机会。
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
墨西哥全国中小学实施手机使用限制:上课、课间原则上不得使用个人电子设备
IT之家 11 月 4 日消息,据央视新闻报道,当地时间 11 月 3 日起,墨西哥全国公立及私立中小学正式实施手机使用限制。
IT之家从报道中获悉,根据墨西哥公共教育部规定,学生在上课及课间休息期间原则上不得使用手机、智能手表等个人电子设备,但因教学活动、紧急情况、健康或残障辅助等特殊需要可例外使用。高中阶段由各校制定具体管理规则。
墨西哥总统辛鲍姆表示,新规旨在减少电子屏幕对学生学习和社交的负面影响,提升注意力与创造力。此前,墨西哥全国 32 个州的教育主管部门一致支持该措施。
延伸阅读
在此之前,多国已陆续出台校园手机限制措施。
美国方面,佛罗里达州于 2023 年率先立法禁止学生在校使用手机,成为全美首例。到 2025 学年,美国已有 17 个州和华盛顿特区对学生手机使用出台新限制,使相关规定的覆盖范围扩大到 35 个州。各州做法差异较大:部分州在就学期间全面禁用,乔治亚和佛罗里达仅在幼儿园到八年级执行“铃响到铃响”的严格限制,另有七个州只在上课时间禁止,允许课间或午餐时使用。
欧洲方面,法国于 2026 年 8 月颁布有关法律,从当年秋季新学年起禁止高中生在校使用手机,规定学生在小学、初中和高中校园内不得使用手机或其他电子通信终端设备;荷兰于 2024 年 1 月发布全国性指导方针,建议在课堂内禁止使用智能手机,几乎所有学校均已遵守,调查显示绝大多数受访中学表示学生专注力明显提升。
此外,瑞典计划自 2026 年秋季新学年起在全国所有学校推行手机禁令,覆盖 7 至 16 岁学生,强制收缴手机并统一保管至当天结束;丹麦政府也宣布将在学校及课后托管机构实施手机禁令,其委员会还建议 13 岁以下儿童不应拥有个人智能手机或平板电脑。

6 台智元机器人直播在便利店 24 小时打工,4 台成功“转正”
IT之家 11 月 4 日消息,智元 11 月 2 日发起机器人直播在便利店“打工”挑战,6 台精灵 G2 机器人连续 24 小时在岗。
11 月 3 日 10:00,智元“机器人打工不能停”便利店直播挑战结束,在全网超 200 万人的围观下,最终 4 台机器人成功“转正”。
在考核期间,机器人共完成任务 1730 次 / 件。其中,接待顾客 683 人,商品取送 369 单,咖啡制作 147 杯,热食出品 126 份,巡检补货 277 次,桌面清理 128 次。
根据官方介绍,6 位精灵 G2 机器人化身便利店“试用期员工”,开启 24 小时不间断转正考核,迎战四大班次考验:午间高峰试岗、晚高峰抗压考验、深夜独立值守、清晨早餐冲刺。
历经 24 小时全时段压力考验、客流冲击、突发需求以及长时间在岗挑战,最终有 4 位精灵 G2 试用期员工顺利转正,2 位暂未转正。
转正员工组共 4 位:
智能迎宾阿豪,全场景顾客服务评分 TOP1,全程主动迎宾、积极营业,用稳定的态度拿下最高评价,顺利转正。
接待取货火宝,接单积极、响应快,期间遇到订单激增、客人临时取消等突发情况没有停摆,坚持在岗持续处理任务,抗压过关,成功转正。
咖啡师咖少,温柔治愈的门店咖啡担当,做咖啡有条不紊,圈粉多位女性顾客,出品的热美式饱受好评,顺利转正。
热食主理人叮酱,元气值拉满,自带活力感染力,行动稳妥,综合表现达标,准予转正。
待观察、暂未转正组共 2 位:
巡检补货倦王,本次考核存在感偏低,在岗状态偏“摸鱼”,巡检补货主动性不足,没能跟上门店流转节奏,后续需重点打磨在岗积极性。
环境清洁冷姐,深夜值守时遇到垃圾箱已满,脱离既定路线跑出店外、偏离岗位,岗位稳定性不达标,本次暂不转正,需重新调校岗位规则。

据IT之家此前报道,10 月 29 日,智元正式推出预训练 / 后训练 / 部署后实现全链路规模化学习的具身模型 —— GO-3 Preview。该模型采用具身原生的 WRAM(World Reasoning Action Model)架构,将任务推理、未来预测与动作生成连接起来,让机器人理解指令、预测未来,并生成可执行的动作,将于 2026 年底全面开源。
搭载该框架的精灵 G2,在真实便利店上岗期间,不依赖人工示范与调试,自己定位失败原因、调整策略、沉淀经验,做到了在多个复杂精细任务上持续改进,实现“无人在环”的持续自我进化。


网传南京大学“智慧教室系统”可识别抬头率,回应称未经授权不进行人脸识别、已不再统计抬头率数据
IT之家 11 月 4 日消息,此前网传消息称南京大学学生收到通知,学校将启用“智慧教室系统”。一张智慧课堂的系统截图中,除监控画面外,还带有迟到学生、到勤率、抬头率统计等,引发争议。
对此,南京大学本科生院、信息化建设管理服务中心今日发布《关于智慧教室系统有关情况的说明》,IT之家附全文如下:
近日,我校智慧教室建设工作受到师生、校友和社会的关注,现将有关情况说明如下:
当前,智慧教室在国内外高校已经广泛普及,以“智”助学、助教已是大势所趋。我校围绕升级课堂音视频环境、实现课程直播与跨校区互动、支持课程回放与教学数据复用、服务课堂质量有效提升等目标,对仙林校区原有教学设备进行了智慧教室改造。该项目严格遵守政府采购法律法规有关信息公开要求,经专家论证、公开采购招标等程序,于今年暑期施工完成安装。
期中教学检查是我校教学管理常规工作,包括教学秩序检查、教学档案检查等内容。本学期拟试点通过智慧教室系统进行到课率统计,以客观数据支撑后续教学改革、课程建设等工作。网传有教师通知期中教学检查是上级部门检查、到课率将与平时成绩挂钩等信息均不属实。未经授权,我校智慧教室系统在教学应用中不采集人脸等生物特征信息、不进行人脸识别。考虑到课堂学习方式更加多元,当前我校智慧教室系统已不再统计抬头率数据,网传的教室拍摄画面系苏州校区今年 5 月在线督导的个人截屏。
身处数智时代,智慧教室是未来课堂的基本载体,能够辅助教师改进课堂教学,支持同学们课后使用课堂讲授视频,服务同学们更加便捷多样地学习。未来,我校将一如既往地坚持以生为本,在充分尊重和保护学生隐私的前提下,帮助同学们更方便地获取学习资源,真正让数智赋能学习。