
Mac 端安卓设备管理工具 AndroMeld 限时 8 折,仅需 28 元起!
在日常工作中,我们经常要使用电脑和手机来协同完成工作。
如果用的是 Mac + iPhone,那当然不会有什么问题。但如果用的是 Mac + 安卓手机,那光是文件传输,就足够让人头大。
AndroMeld 就是一款能让你的 Android 设备和 Mac 电脑无缝连接的工具!
怎么个无缝法?
通过有线 / 无线的方式,让它们连接起来,然后就能直接在 Mac 上:
- 打开访达,直接读写安卓设备中的文件;
- 在独立窗口内,运行安卓设备中的 App;
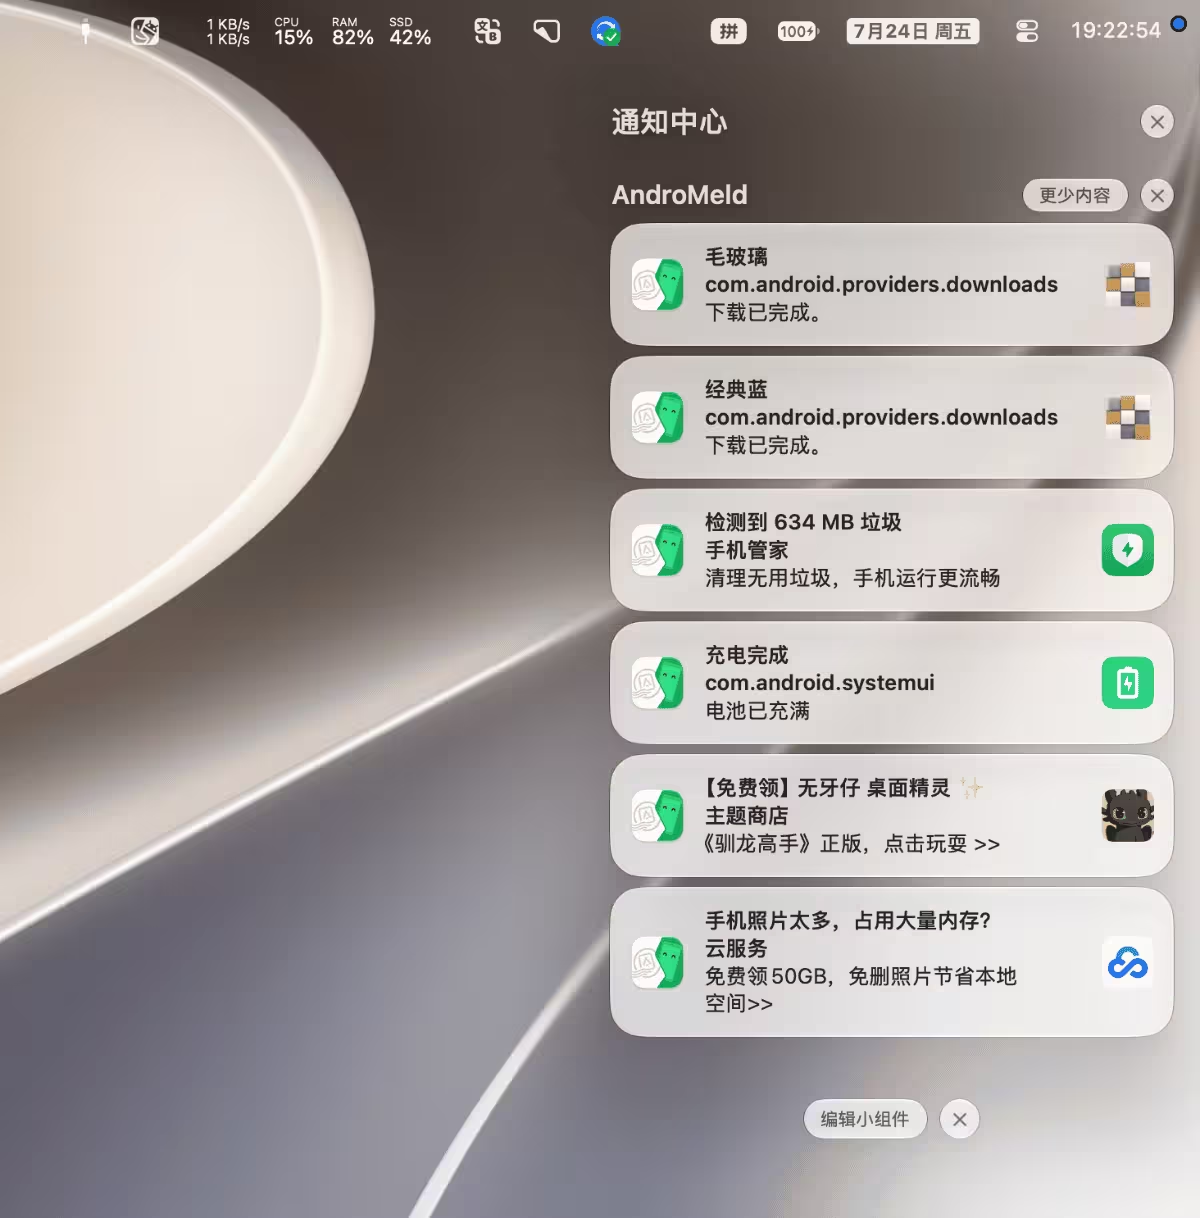
- 让安卓通知显示在 Mac 通知中心;
- 连接 AI Agent (智能体) ,让它直接操控安卓设备;
- 更多玩法……
数码荔枝「双十一」正版软件大促活动已开启,下单 AndroMeld 可享受 8 折优惠!
即日起至 11 月 13 日,AndroMeld 限时 8 折,到手仅 28 元起,买断也只要 68 元。快戳小众软件专属优惠链接前往购买>>
- 新用户免费加入会员,首单立减 5 元
- 结算页面输入“APPINN”优惠码,额外再享 95 折优惠;
两种连接方式
AndroMeld 的用法很简单,只需要:
- 从 Mac App Store 安装 AndroMeld;
- 在安卓手机上打开开发者选项;
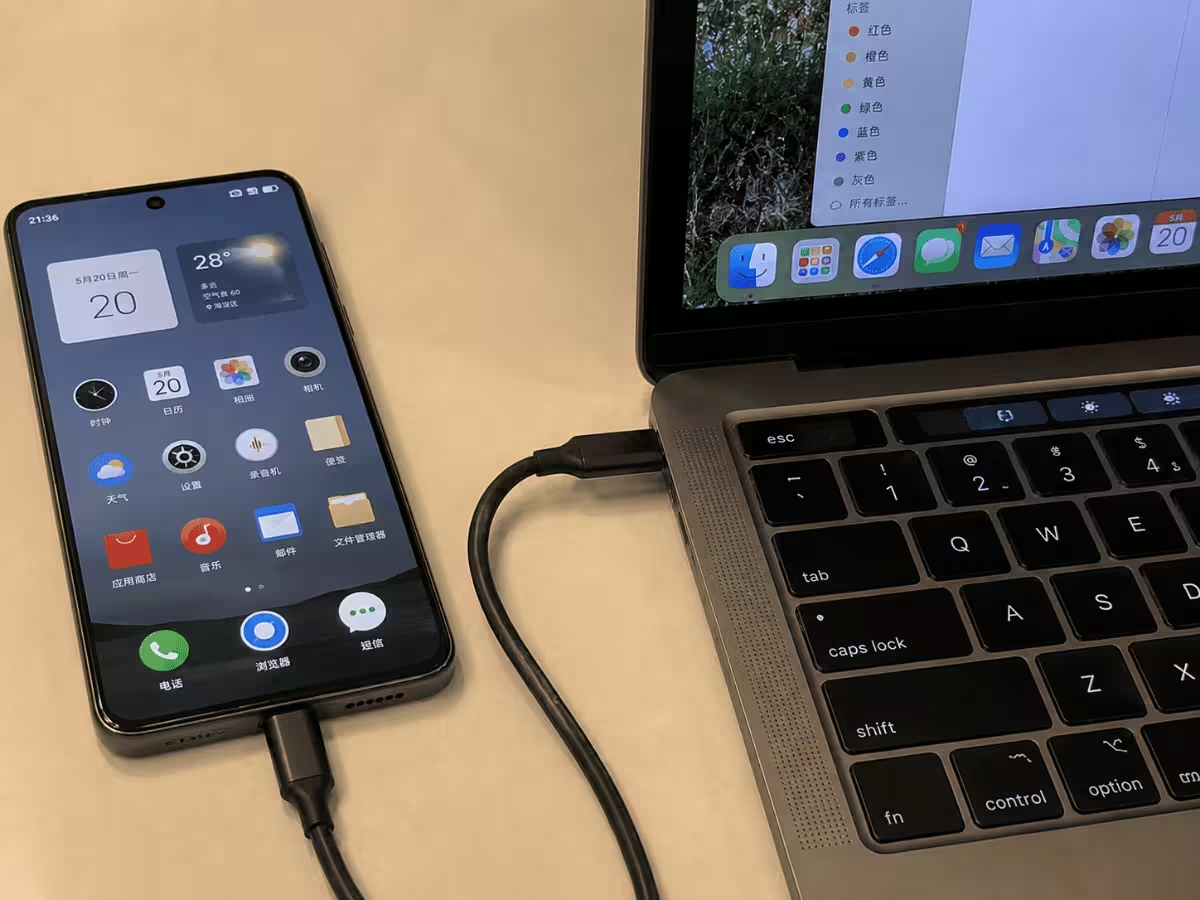
- 用数据线把手机和电脑连接起来,或者让它们接入同一个 Wi-Fi。
运行 AndroMeld 后,按照提示操作就能轻松完成配置。
剪贴板 & 通知同步
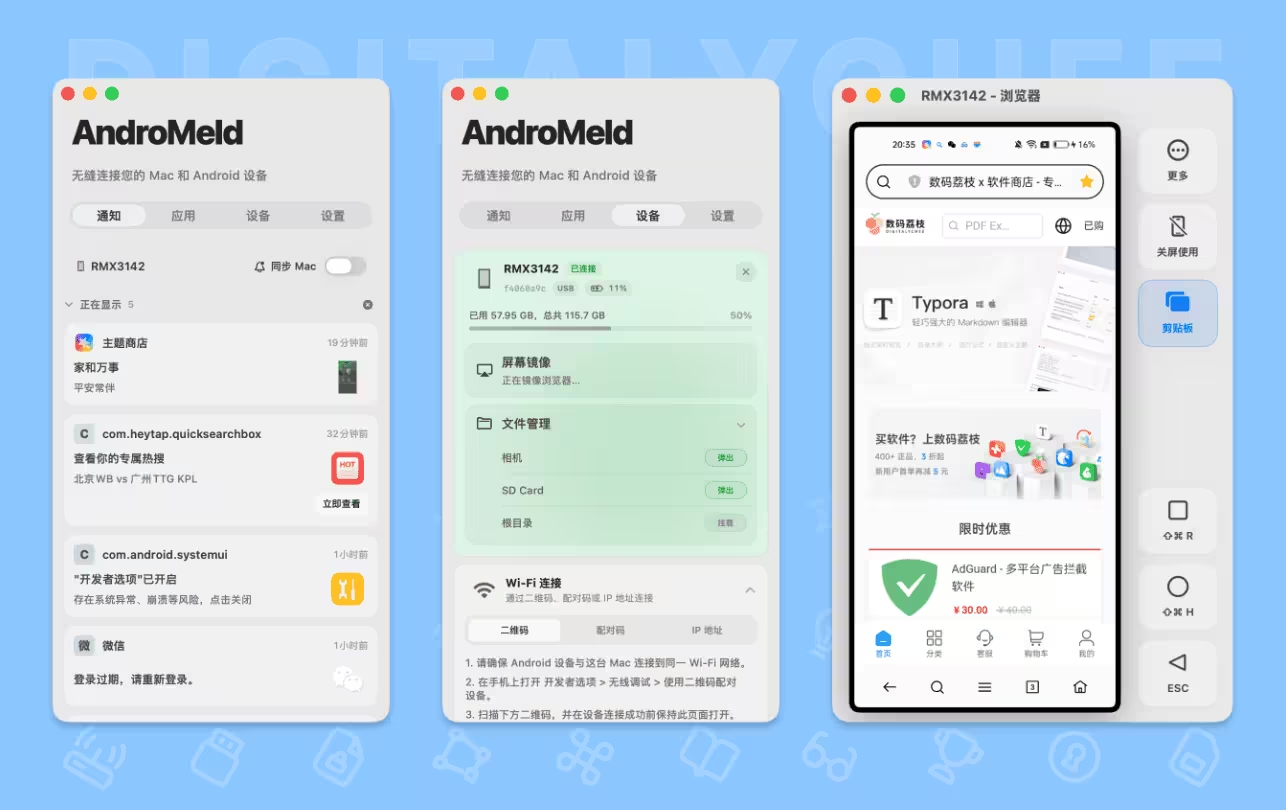
连接后,可马上体验到的功能,就是剪贴板和通知同步。
剪贴板同步:就是从一台设备复制,然后到另一台上面粘贴,轻松完成文字或图片的跨设备传输。
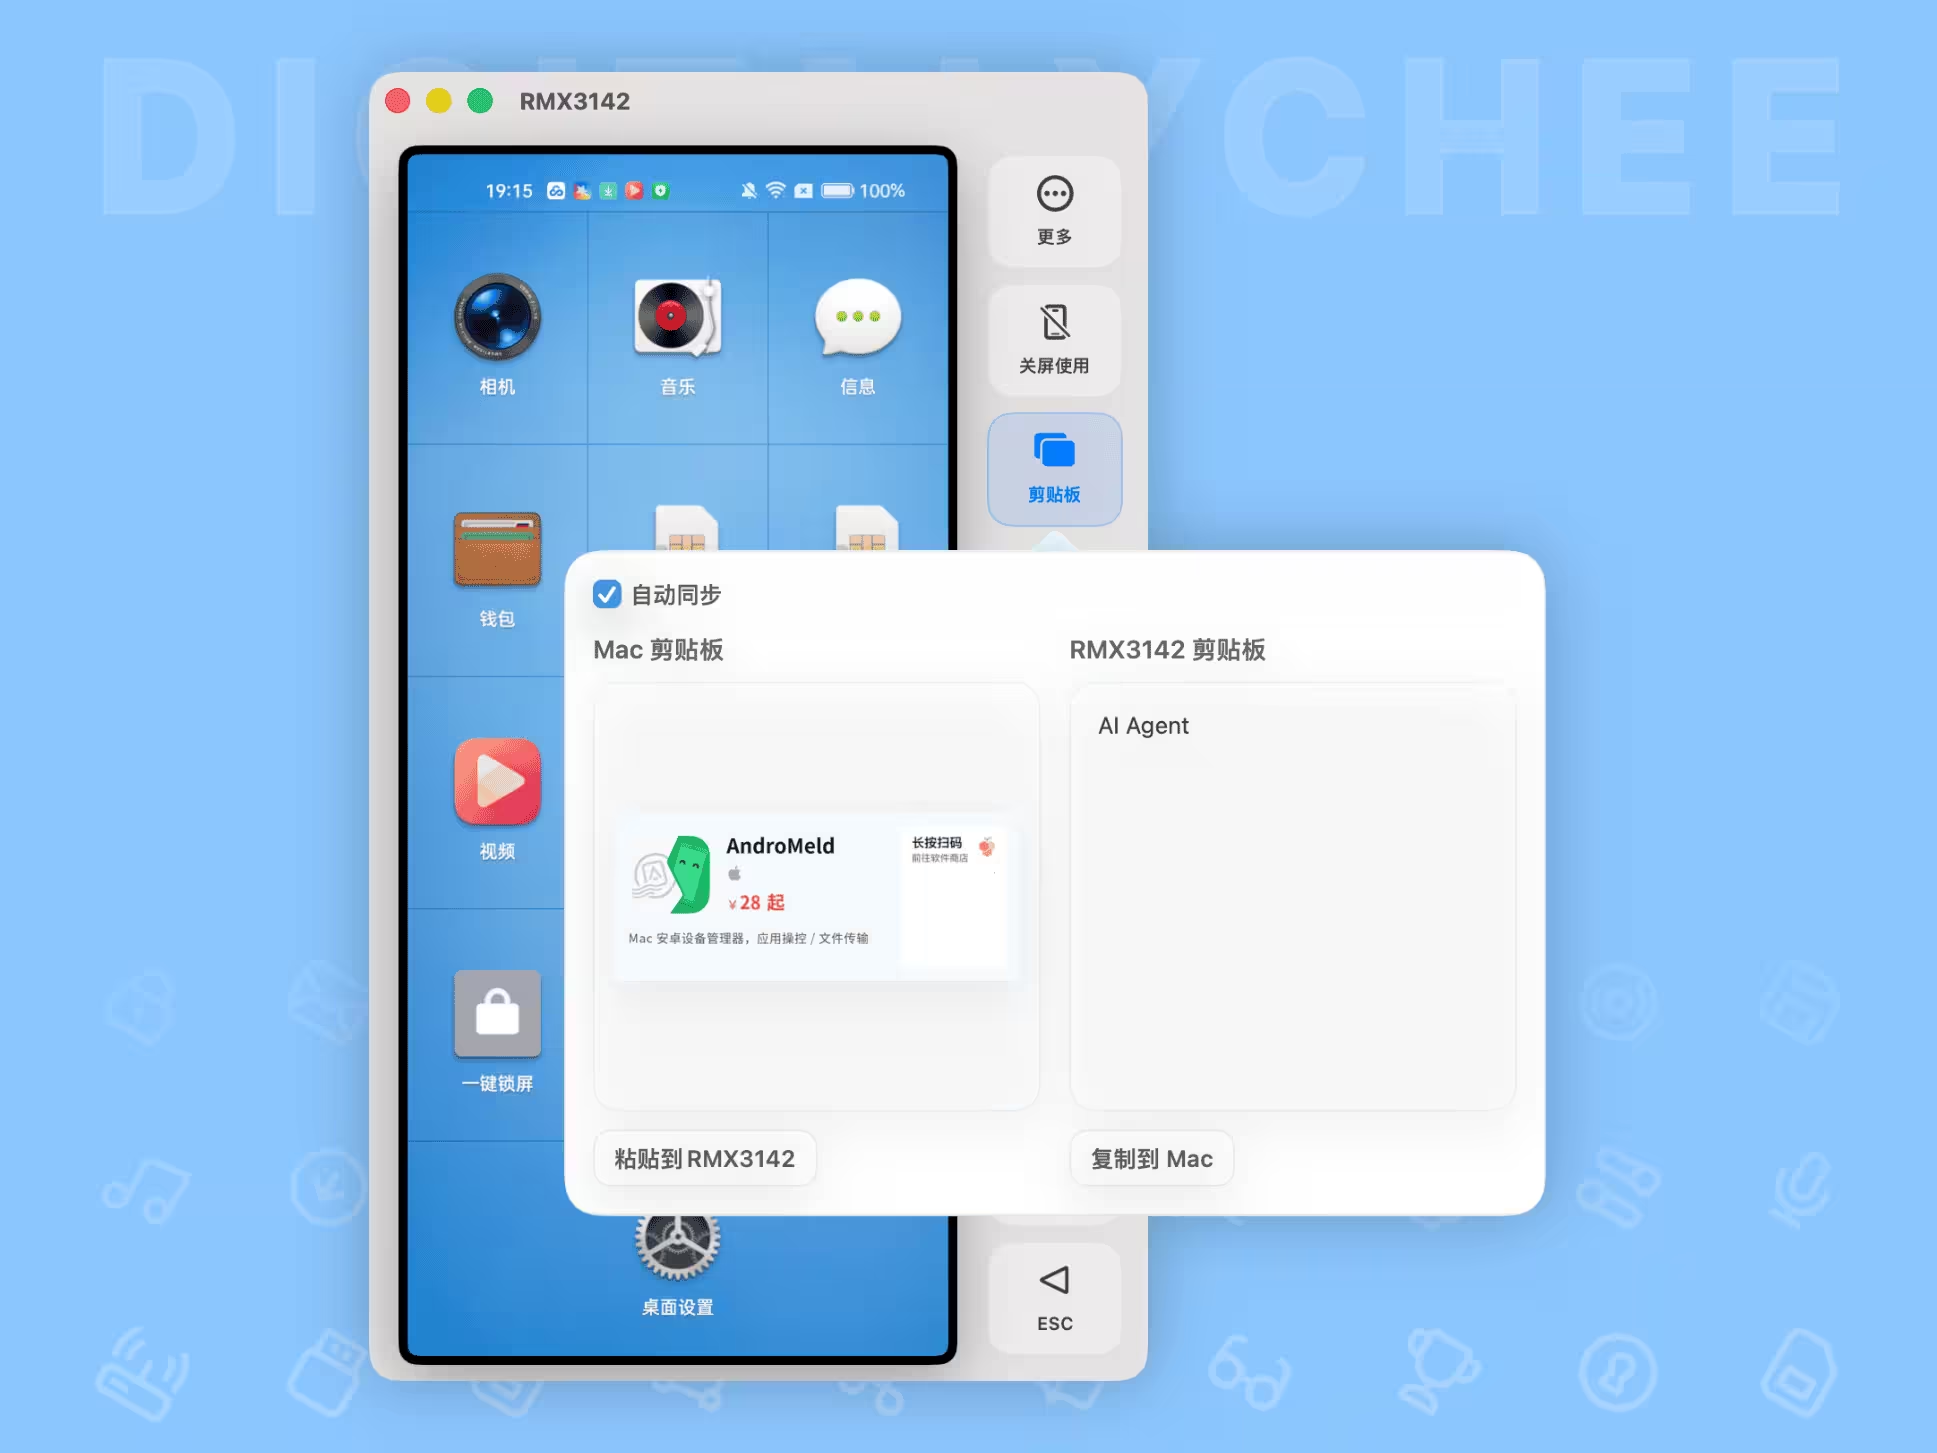
这个过程可以是从电脑到手机,也可以是手机到电脑,都没问题。
带来类似于 iPhone 和 Mac 搭配使用的体验。
通知同步:就是让安卓设备接收到的通知,实时显示在 macOS 的通知中心 —— 方便复制安卓手机上接收到的验证码等信息。
在访达中管理文件
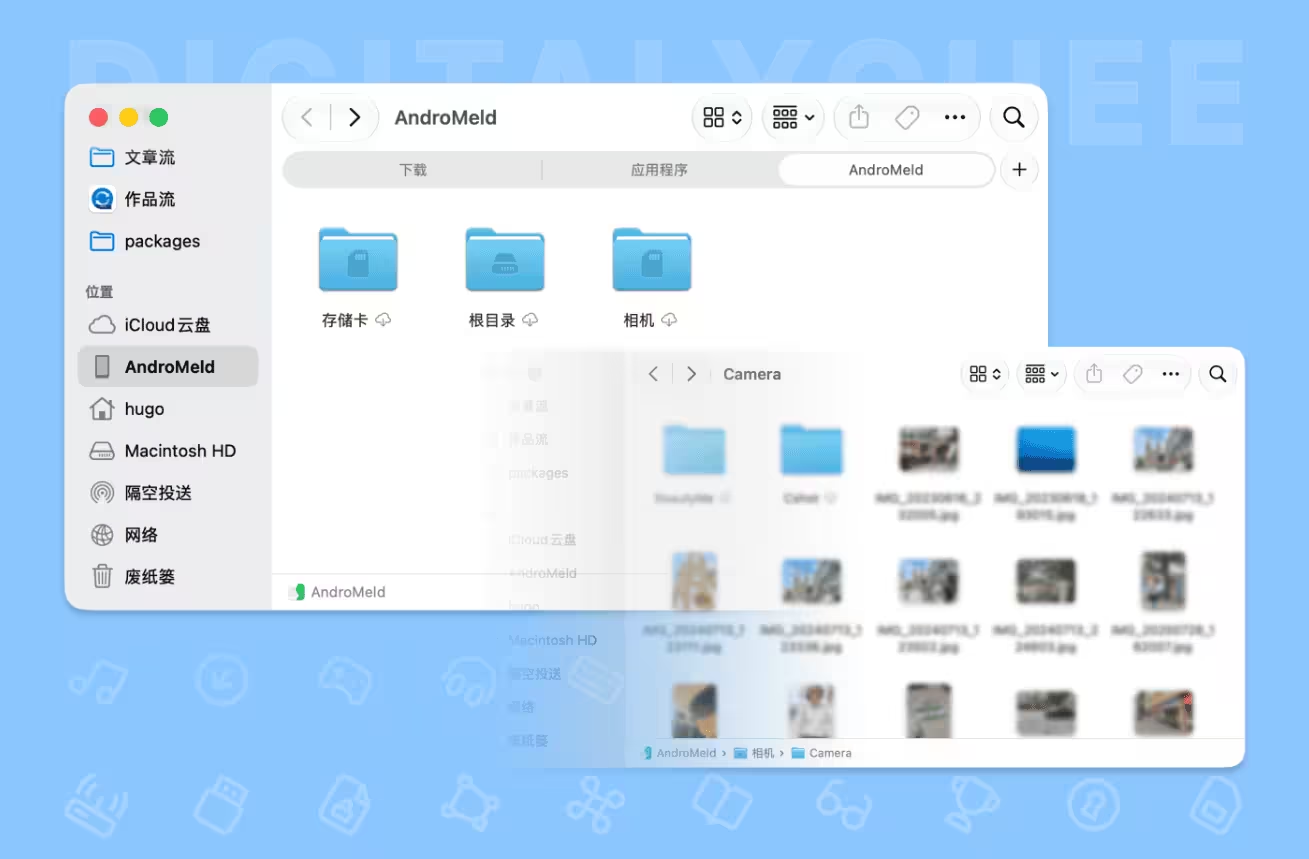
AndroMeld 还支持把安卓设备中的存储空间,挂载到 Mac 访达。
方便我们以文件夹的形式,复制 / 移动 / 编辑 / 删除安卓设备里面的文件。
在实测中发现,不仅能够挂载「存储卡」 (存放各类应用的数据) 和「相机」 (存放相机拍摄的照片视频) 这两个文件夹,甚至还能挂载「根目录」,方便我们访问系统文件和数据。
在 Mac 上运行安卓应用
利用 AndroMeld,还能在 Mac 上,直接运行安卓设备中已安装的应用!
比如,想要测试某个网站在手机上的浏览效果,可以直接在 Mac 上进行如下操作:
滑动桌面找到浏览器,鼠标点击打开,输入并访问 appinn.com,在搜索框内输入 PDF,按下回车……
在上述过程中,不需要触碰手机,只需要用电脑键鼠控制手机操作,用电脑屏幕查看手机画面 —— 跨设备办公效率拉满!
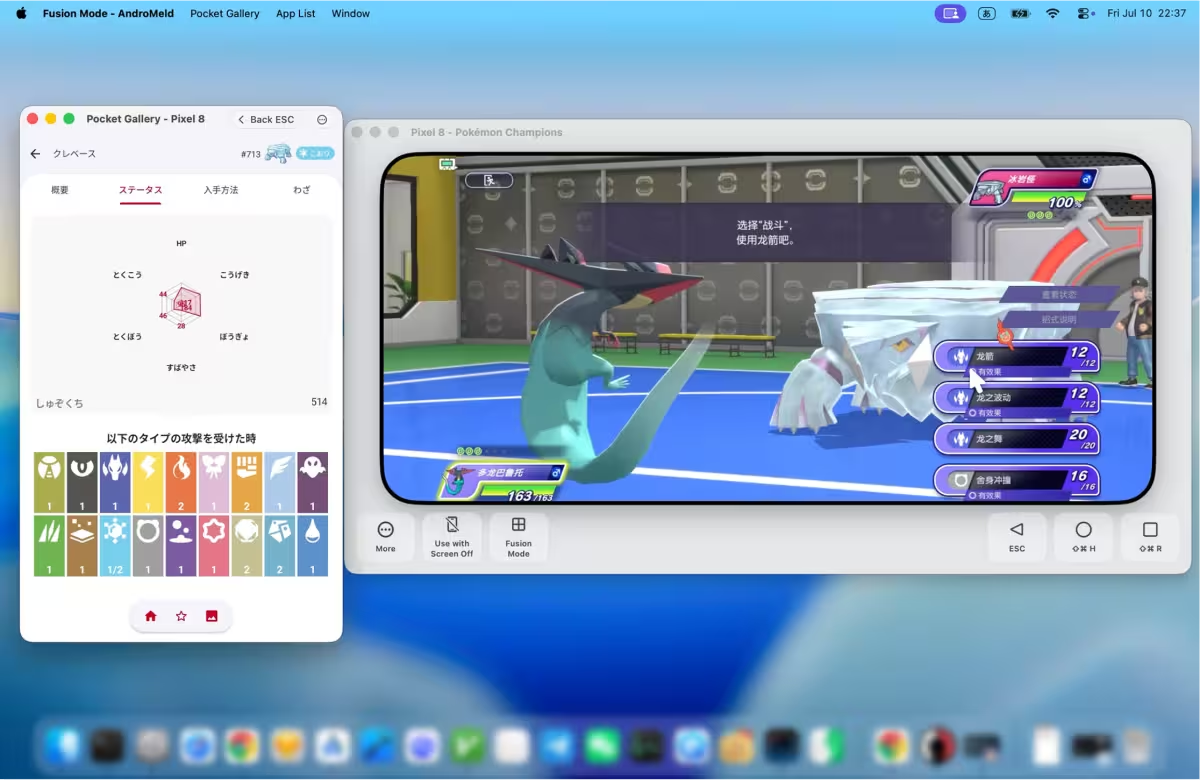
当然了,上述只是在投屏模式下的基本玩法,AndroMeld 还支持更高级的 —— 融合模式。
在融合模式下,安卓应用可以运行在虚拟屏幕上,以独立 Mac 窗口呈现!手机本身可以继续其他任务,甚至保持锁屏。
画面可以缩放、旋转……还能在 Mac 上实现同屏多任务!
比如,一边玩安卓游戏,一边通过专门的安卓 App 查找玩法攻略。
让 AI Agent 操控设备
很多朋友一直想实现手机自动化,但此前复杂的编程方案让人望而却步。相比之下,AndroMeld 提供了称得上「傻瓜式」的解决方案。
它内置了 MCP 服务器,可实现让 AI Agent 直接查看并操控安卓设备。
用户只需要在 Mac 上安装好 AndroMeld 并配置好一款 AI Agent,比如 OpenClaw。
接着把 AndroMeld 提供的提示词,发送给 AI Agent,等它自动完成相关配置,就能对它发号施令了。
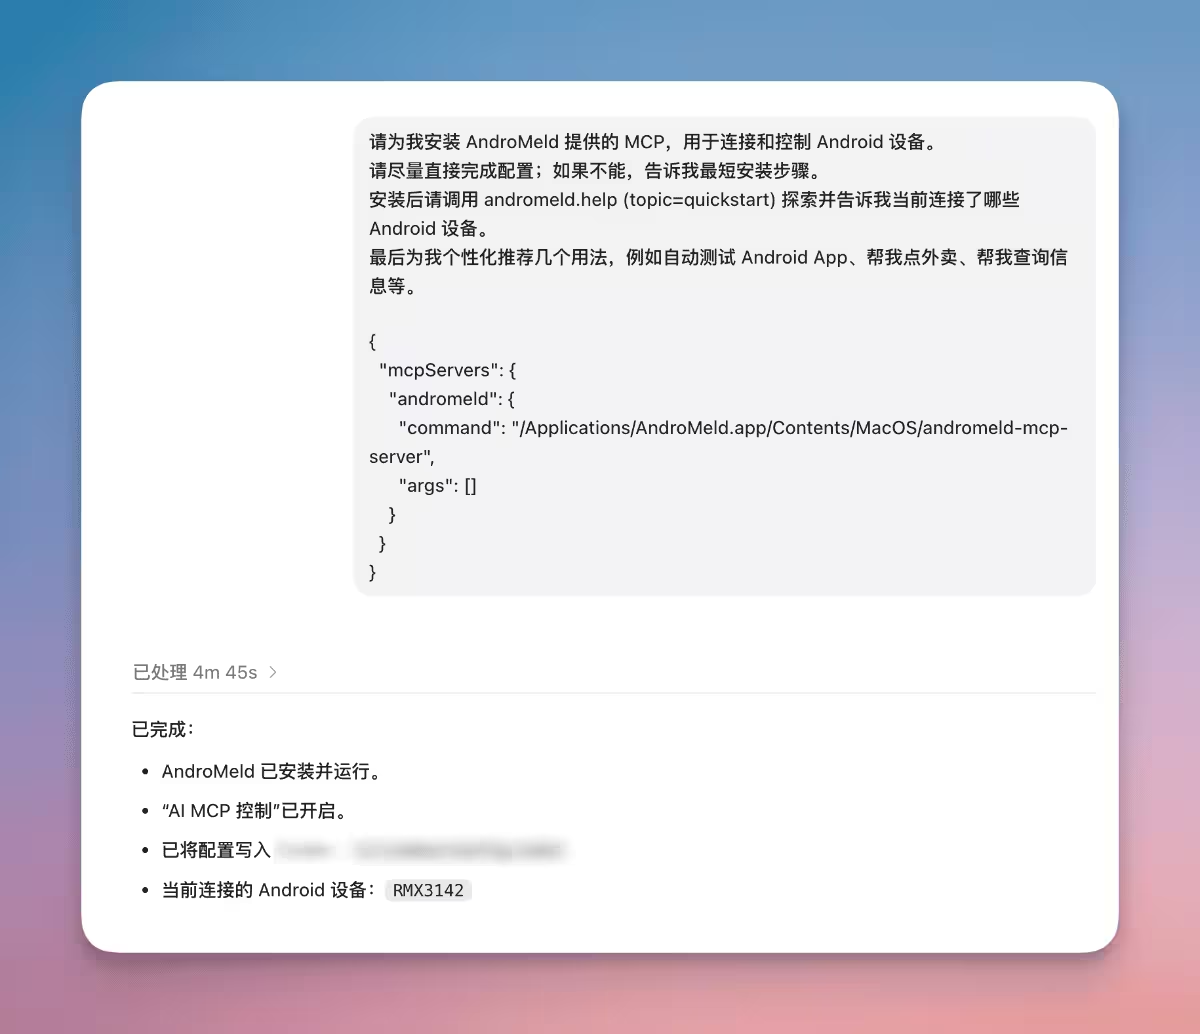
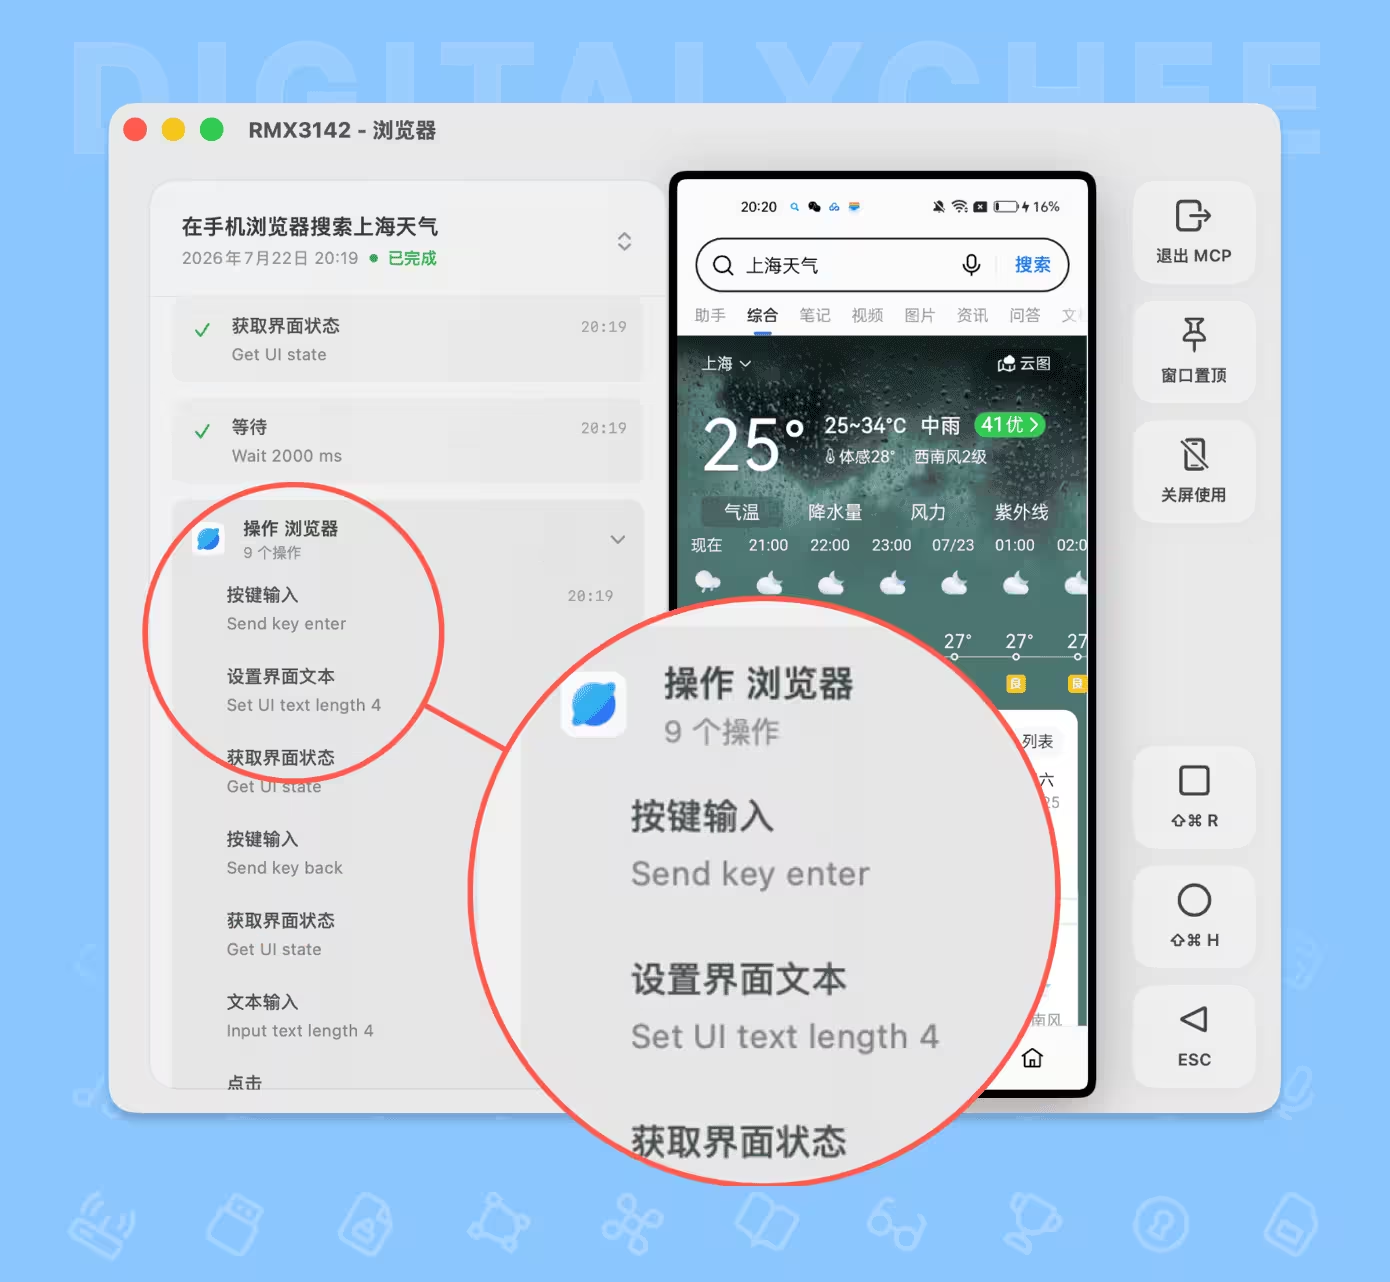
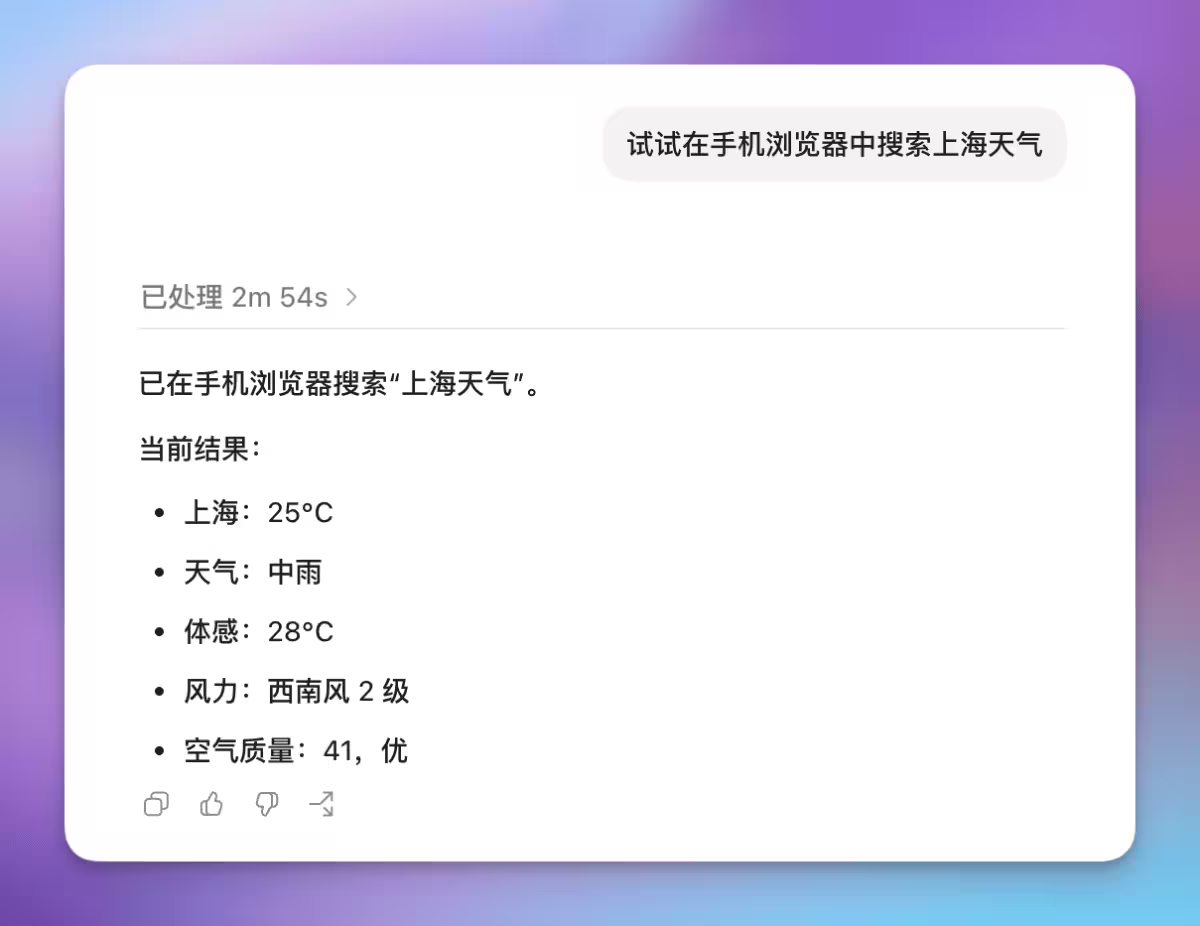
比如,对 AI 说:试试在手机浏览器中搜索上海天气。
AI 就会按照要求,在手机桌面找到并打开浏览器,点击搜索框,输入上海天气并搜索……最后把在对话中回复结果。
写在最后
AndroMeld 真的很强!不过,它对设备系统版本的要求,有那么一点点门槛。
仅支持 macOS15 及以上版本,和 Android14 及以上版本。
如果你的设备满足要求,那就赶快下载 AndroMeld 体验一下吧!
通过 USB 或 Wi-Fi 连接,就能在 Mac 上直接运行手机中的 App、管理文件,并实现通知与剪贴板同步等功能。
即日起至 11 月 13 日,AndroMeld 限时 8 折 到手仅 28 元起,买断也只要 68 元。
戳专属优惠链接下单更划算,让 Android 与 Mac 无缝融合,为日常工作提升效率!
优惠购买
- https://lizhi.shop/products/andromeld?cid=jxlwguir
- 新用户免费加入会员,首单立减 5 元
- 结算页面输入“APPINN”优惠码,额外再享 95 折优惠
相关阅读
靠嘲笑AI赚钱,一群年轻人被好莱坞盯上了
据美国科技媒体《WIRED》报道,当好莱坞各大制片公司忙着将生成式AI引入电影和电视剧制作时,一群专门拿AI开玩笑的内容创作者却意外走红。他们通过戏弄AI面试官、揭露ChatGPT的低级错误,吸引数百万粉丝,甚至获得了好莱坞经纪公司的签约。
阅读全文
AI绑架美股七姐妹
(本文作者为 定焦One,钛媒体经授权发布)
文 | 定焦One,作者 | 金玙璠,编辑 | 魏佳
截至11月2日,“美股七姐妹”中除英伟达之外的六家,已公布最新业绩。营收几乎全线增长,股价走势却不同。
跌得最狠的,恰恰是增长最快的。美东时间10月28日,谷歌母公司Alphabet公布三季度财报,谷歌云单季收入307亿美元,同比增长103%。然而第二天,股价暴跌12.64%,创下这家公司上市以来最大单日跌幅。
24小时后,亚马逊重演了这一幕。AWS增速39.3%,创近五年新高,盘后股价跳水超过7%。再往前一周,Meta营收增长26%,股价也跌了7%。
另外三家股价相对稳定。微软Azure增速48%,业绩不差,第二天股价微跌0.2%。特斯拉经营利润下降56%,营业利润率只剩2.6%,却因为宣布将全年资本开支从250亿美元压缩到200亿美元,股价反而稳住了。而几乎没在AI基础设施上花钱的苹果,今年股价涨了约26.7%,是“七姐妹”里表现最好的。
“七姐妹”指的是苹果、微软、英伟达、亚马逊、Alphabet、Meta和特斯拉这七家美国科技巨头。英伟达的财季与其余六家不同步,三季度财报要到11月才公布,因此本文主要分析已披露业绩的六家,涉及股价和产业链时仍按七家来讨论。
过去几年,七姐妹的股价走势大体同步,今年彻底变了。截至10月30日,苹果年内涨26.7%,英伟达涨9.7%,Alphabet和特斯拉分别跌10.5%和11%;七家公司占标普500约三分之一的权重,年内加权涨幅只有6.2%,没跑赢大盘。这是自2023年“七姐妹”概念被提出以来,首次集体落于下风。
表面上看,市场在担心AI泡沫,担心巨额投入能否收回。仅上个季度,六家公司的资本开支加起来就超过2000亿美元,其中相当一部分最终流向了英伟达,而英伟达自己上一财年全年的资本开支不过61亿美元。但如果只是害怕泡沫,同样在大举烧钱的微软为什么安然无恙,增速最快的谷歌反而跌得最惨?
要回答这个问题,得先拆解这几家巨头的生意,看清它们各自靠什么赚钱。
01.谁在赚“现在的钱”,谁还在赌“未来”
这六家公司都被贴上“AI概念”的标签,但撑起股价的,是四种不同的逻辑。
微软和亚马逊卖算力,Meta卖广告,苹果卖硬件和服务,特斯拉押注自动驾驶。谷歌特殊一些,两样都占:云和广告。当市场开始用真金白银掂量AI的回报时,模式的优劣就显现出来了。
卖算力,是当下最稳的生意。只要整个行业还在疯狂抢算力,微软、亚马逊、谷歌这三家云厂商未来两三年的收入就大致有了保障。
微软Azure单季收入331.7亿美元,增长48%;AWS收入460亿美元,增长39.3%,年化1840亿美元,是近五年最快;谷歌云收入307亿美元,直接翻了一倍多。
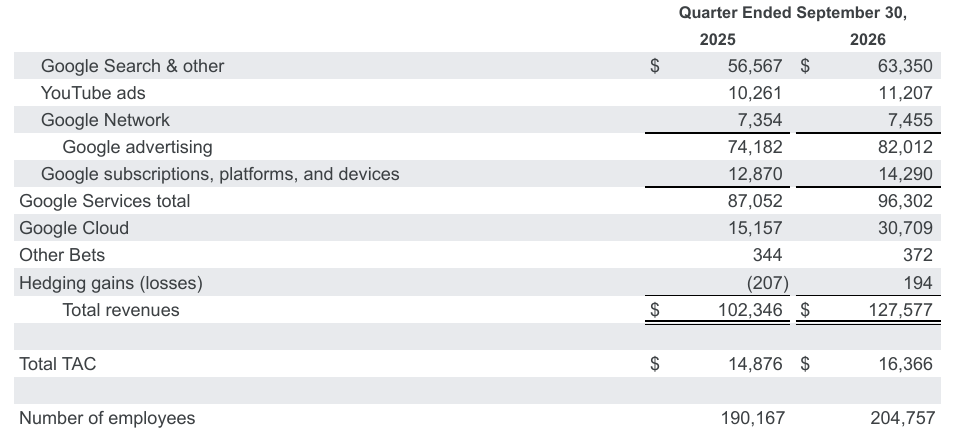
谷歌云收入翻倍至307亿美元 图源 / 谷歌财报
这种增速能否持续,要看手里的订单。微软还没交付的商业合同高达6770亿美元,比去年同期多了73%;谷歌云的积压订单也有5610亿美元,管理层说一半以上会在未来两年内确认为收入;亚马逊积压订单5780亿美元,CEO Jassy在电话会上透露,OpenAI和Anthropic各自追加了上千亿美元的长期采购合同。
云厂商未来几年的收入,很大一部分已经被预定了。眼下的瓶颈在于供给。亚马逊现在平均每14秒就要往数据中心里装一枚AI芯片,产能依然不够。
Meta是另一条路:靠AI把广告卖得更贵。
这个季度营收646亿美元,增长26%,广告展示量多了10%,平均单价涨了14%。管理层在电话会上把增长归功于AI推荐系统的改进。
问题是,广告生意有上限。广告主的总预算是一个有限的池子,AI的价值无非是让广告更精准、更贵,或者增加用户看广告的时长。这个季度单价已经涨了14%,还能不能继续涨?全系产品日活用户超过36亿,增长空间还有多大?当AI投入的边际效益开始递减,广告的增速能否永远跑赢开支的增速?这些都是问题。
苹果几乎没参与这轮军备竞赛。
季度营收1145亿美元,创了纪录,增长12%;全年营收4788亿美元,是公司史上最好成绩。它全年资本开支90亿美元,同比还降了29%。过去两年,市场总批评苹果在AI上落后,同行在大举砸钱,它好像没什么动作。这个季度之后,风向有点变了。当所有人都在为巨额投入和日益紧张的现金流发愁时,“不花钱”反而成了优点。2026年,苹果以27%的涨幅领跑七巨头。
特斯拉是第四种:估值全押在还没兑现的自动驾驶上。
当季营收280亿美元,和上一年持平,经营利润却下滑了56%。卖车这门生意的利润在缩水,市场愿意给它高估值,赌的是自动驾驶和机器人。FSD付费订阅174万,增长67%,北美交付的新车超过75%选装了FSD;Robotaxi也已在奥斯汀正式载客,无监督里程一个季度增长了八倍。
但这些离赚钱还远。特斯拉与SpaceX正在评估的潜在合并,也让它的资本配置多了不少变数。
谷歌跌得最狠,因为两门生意同时遭了质疑。
搜索广告收入增长12%,低于市场预期(约15%),AI搜索的变现效率还不如传统搜索。云业务收入翻倍,代价是单季资本开支514亿美元,自由现金流转为负的91亿美元。加上SpaceX等股权投资的亏损拖累,净利润下滑了24%。财报全面低于预期,市场直接用脚投票。
一位关注美股的投资人Roy对「定焦One」表示,把这六家都当成一个“AI概念”来炒,从一开始就不合理。同样是投AI,有的当年就赚回来,有的要等好几年;有人是用客户的钱建基础设施,有人是用自己的利润赌未来。
02.现金流为负,市场紧张了
这个季度,六家公司的股价涨跌,和自由现金流的状况对应。所谓自由现金流,就是公司赚的钱,刨去建厂房、买设备、买芯片的开销后,手里真正剩下的部分。
自由现金流为负的三家,谷歌、Meta、亚马逊,股价在10月都跌了。自由现金流为正的另外三家,微软、特斯拉、苹果,股价都稳住了。
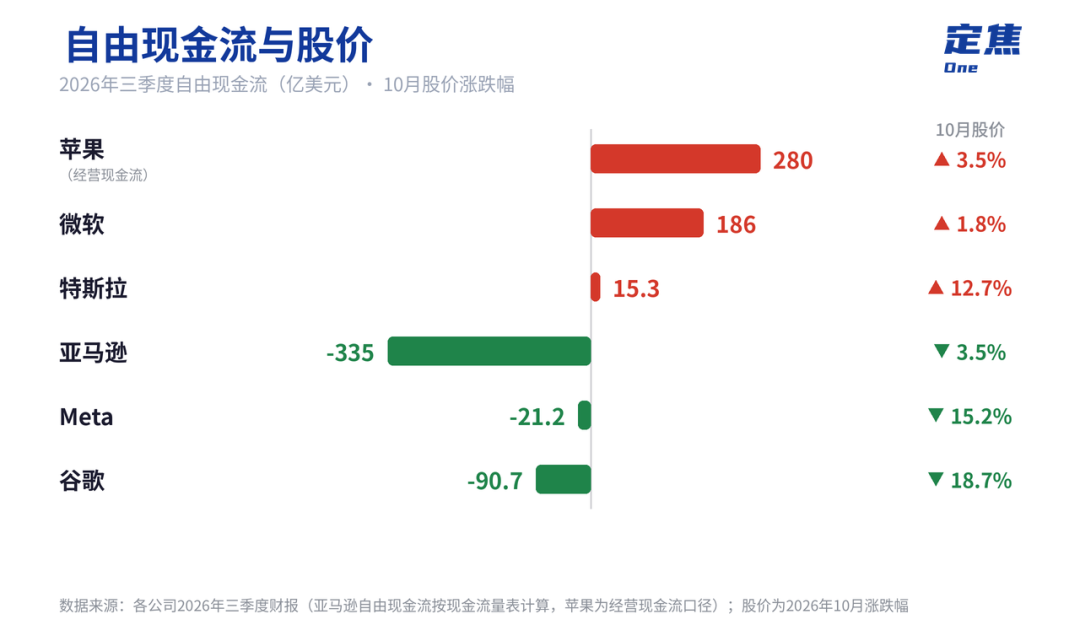
Roy表示,前两年,市场还愿意为“敢花钱”下注;现在,花钱多的得先证明自己还得起。
变化背后,是这轮AI投入的体量实在太大。微软、亚马逊、谷歌、Meta四家这个季度的资本开支合计2029亿美元,创单季纪录,今年全年计划加起来超过7000亿美元,比去年多了75%。业界预计明年这一规模将达到1.3万亿美元。
钱花到这种程度,市场当然要关注:花出去的钱到底什么时候能回来?高盛在今年一季度的行业回顾里概括过这个转向:对AI的关注,已经从“谁投得最多”,变成“投出去的钱离变回现金还有多远”。
“现金流为负”的三家,处境也不一样。
谷歌和亚马逊的钱都花在了数据中心、芯片和网络设备上。花出去的钱,大概率收得回来,只是需要时间。谷歌这个季度资本开支514亿美元,同比翻了一倍多。底气是谷歌手里5610亿美元的积压订单,管理层说一半以上会在两年内变成收入。亚马逊的逻辑相同:AWS积压订单5780亿美元,OpenAI和Anthropic各自追加了上千亿美元的长期采购。
值得一提的是,微软这个季度的资本开支同样翻倍,达到394亿美元,不过因为赚得多,经营现金流有580亿美元,扣掉开支还剩186亿美元。
Meta的情况不同。它的钱也花在数据中心上,单季资本开支349亿美元,全年计划花1350到1450亿美元,和云厂商是一个量级。区别在于,云厂商的数据中心是替客户建的,建好了客户付钱;而Meta的数据中心是建给自己用的,投入能不能收回来,还是看广告能多赚多少。
2022年Meta大举押注元宇宙,一年之内股价跌了75%,后来靠裁员和砍预算才缓过来。眼下广告业务固然比四年前更赚钱,但这次赌注的体量是当年的数倍。
更值得关注的是,Meta正在从“靠自身利润为AI竞赛提供资金”转向“靠资本市场募资”:长期债务一年内从587亿美元涨到809亿美元,还宣布要设立没有投票权的C类股。标普最近已将Meta的评级展望从“稳定”下调至“负面”,理由正是资本支出和自由经营现金流存在重大不确定性。
另外两家,特斯拉主动收缩,苹果干脆没怎么花钱。
特斯拉把主要资源投向Robotaxi和机器人,但相比此前更大的规划已有所收敛:全年资本开支从250亿美元以上控制到200亿美元,自由现金流回到正的15.3亿美元,手里还备着300亿美元的信贷额度。
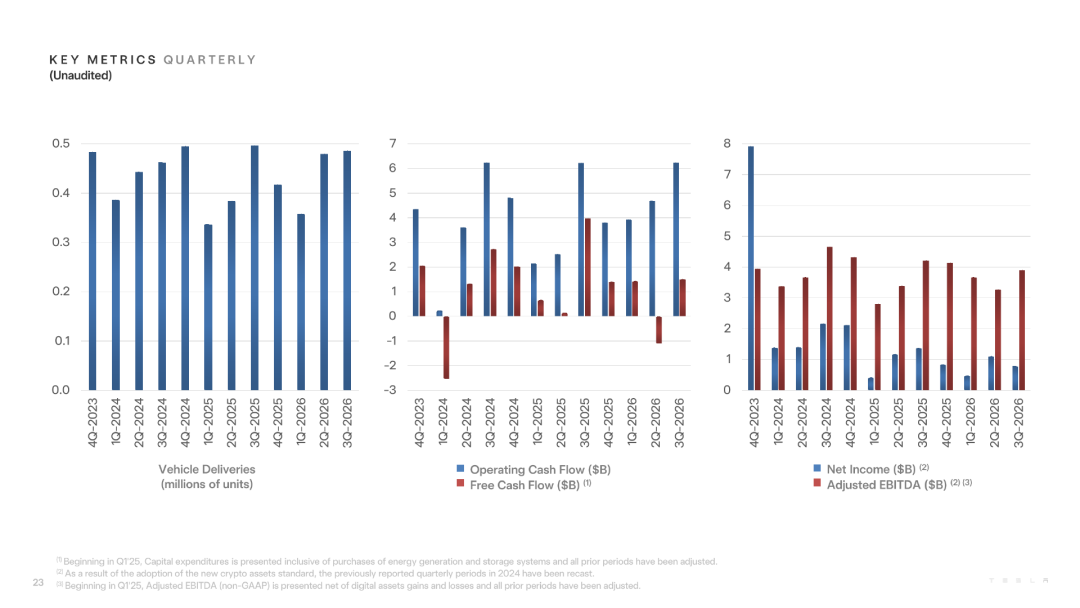
特斯拉季度经营现金流与自由现金流
苹果几乎没有参与这轮投入。它不建大规模数据中心,AI投入集中在对现有产品和服务的渐进式集成,而非大规模自研训练集群,全年资本开支90亿美元,同比还降了29%,单季经营现金流就有280亿美元。
但苹果也有代价:自研AI进展不顺,今年1月宣布每年花约10亿美元买谷歌的Gemini模型来重建Siri;供应链也被波及,AI服务器抢走了大量高带宽内存产能,普通存储芯片的成本大涨,Mac mini已经提价了200美元。
市场反应其实很清晰:回款路径明确的,市场还愿意等;路径不明朗的,压力最大;投入保守、或者已经开始收缩的,反而成了避风港。
03.座次重排,洗牌才到中场
把时间拉长来看,这轮AI浪潮已经把七姐妹的座次彻底洗牌了,且还没有结束。
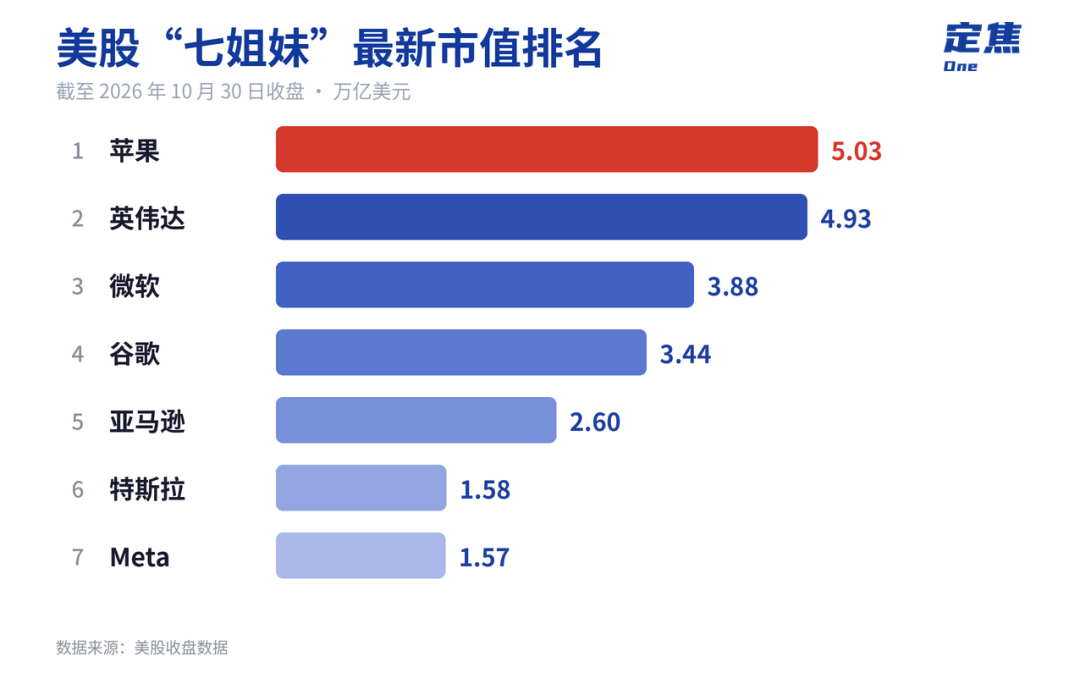
回到这轮AI的起点。2022年11月30日,ChatGPT发布。同年年底,按市值排座次:苹果(2万亿美元)、微软(1.8万亿美元)、谷歌(1.1万亿美元)、亚马逊(8500多亿美元)、特斯拉(不到4000亿美元)、英伟达(3600多亿美元)、Meta(3000亿美元出头)。英伟达排第六。
2023年5月,英伟达市值盘中首次达到1万亿美元。两年半后的今天,它一度登顶全球市值第一。
截至今年10月30日,新的座次是:苹果(5.03万亿美元)、英伟达(4.93万亿美元)、微软(3.88万亿美元)、谷歌(3.44万亿美元)、亚马逊(2.6万亿美元)、特斯拉(1.58万亿美元)、Meta(1.57万亿美元)。七家合计,从7万亿美元扩张到了23万亿美元,占标普500的权重从22%升到了33%。
卖芯片的英伟达涨了13倍,从第六名冲到榜首,市值一度超过特斯拉的三倍。三年前,这两家公司的市值还差不多。Meta涨了近五倍,但排名依然垫底。过程中,特斯拉也一度跌到最后一名。
Roy表示,从这一季的财报里,能看出三条正在改写游戏规则的线索。
第一,谁在收钱、谁在借钱。
六家科技巨头的巨额开支里,最大的一部分流向了英伟达。英伟达自己不搞大基建,上一财年全年资本开支仅61亿美元左右。只要行业还在抢算力,它的收入就有保障。但反过来也一样,它的地位本质上建立在另外几家的开支上,一旦下游开始收缩,它马上承压。
另一边,有些云厂商以前是拿利润建机房,现在是发债、发股、借钱来建。这个季度,谷歌发债净入287亿美元,还计划发行847.5亿美元的股票,亚马逊单季发债481亿美元。
更宏观的数据来自路透社的调查:微软、Alphabet、亚马逊、Meta和甲骨文五家科技企业,2026年前9个月经营活动现金流高达创纪录的5429亿美元,但资本支出翻倍至5569亿美元,首次入不敷出。五家公司合计自由现金流由上年同期1435亿美元的盈余转为140亿美元的赤字。
Roy强调,市场已经注意到了循环融资的隐忧:芯片制造商和云厂商利用自身信用,给下游客户提供贷款或担保,这些资金又流回芯片和算力的采购中,容易制造需求旺盛的假象。
第二,折旧才刚开始。
厂房和芯片采购花出去的不是一次性费用。设备一买入就开始计提折旧,逐季摊进利润表。微软单季折旧摊销同比多了44%,往后只会加速;亚马逊过去12个月高达793亿美元,比它一年前同期的净利润(765亿美元)还多。这意味着,设备老化和贬值的速度,快过了它赚钱的速度。摩根大通更是预测:亚马逊2027年的自由现金流可能滑向负1280亿美元。
这背后的原因是,AI芯片和服务器更新换代太快。花100亿买的高端GPU,以为能摊到十年,但可能五年甚至三年后,因为性能落后,就面临资产减值的风险。
投资人Michael Burry最近公开指控巨头们有意拉长AI芯片的折旧年限,据其估算,2026到2028年可能累计虚增约1760亿美元利润。
这一点上,投资最少的苹果和已经收紧开支的特斯拉,相对轻松。
第三,停下来比继续烧更难。
如果AI的商业回报兑现得比预期要慢,能主动刹车、调整节奏的公司可以保住利润;反之,则会被成本拖住。野村跨资产策略师将这一困境概括为“进退两难”:继续加速则自由现金流承压,减速则AI需求叙事失守。
云厂商签的是长期合同,特斯拉的自动驾驶投入不能停,Meta的AI推荐系统是广告业务的地基,也不能停。
苹果是唯一拥有充分余地的。它的投入规模小,可以等技术路线和商业模式更清晰了再精准切入。
下一个验证点是英伟达11月发布的财报。如果它的数据中心收入及指引仍在加速,说明下游还在加码;如果指引下调,就说明下游开始收缩了。
所以,这一季财报季宣告了一个时代的终结:AI基建的“军备竞赛”阶段,正式让位于“算账”阶段。上半场比的是谁胆大、谁下注猛;下半场,拼的是谁家底厚,谁能在折旧开始吞噬利润、债务成本居高不下的时候,拿出让市场信服的投入产出成绩单。

更多精彩内容,关注钛媒体微信号(ID:taimeiti),或者下载钛媒体App
GPT-6 Astra 爆改 Qwen 大脑:只动 0.016% 参数,数学成绩疯涨
只改了 0.016% 的权重,一个 8 亿参数大模型的数学成绩,就从 7.9% 飙升到了 48.1%。
更夸张的是,动手修改这些权重的,竟然是另一个大模型 GPT-6 Astra。
最近,MIT CSAIL 的研究团队展示了一种相当大胆的 AI 优化方法。他们让 GPT-6 Astra 像程序员阅读和修改代码一样,直接分析神经网络的权重,定位模型的问题,再修改其中的参数。
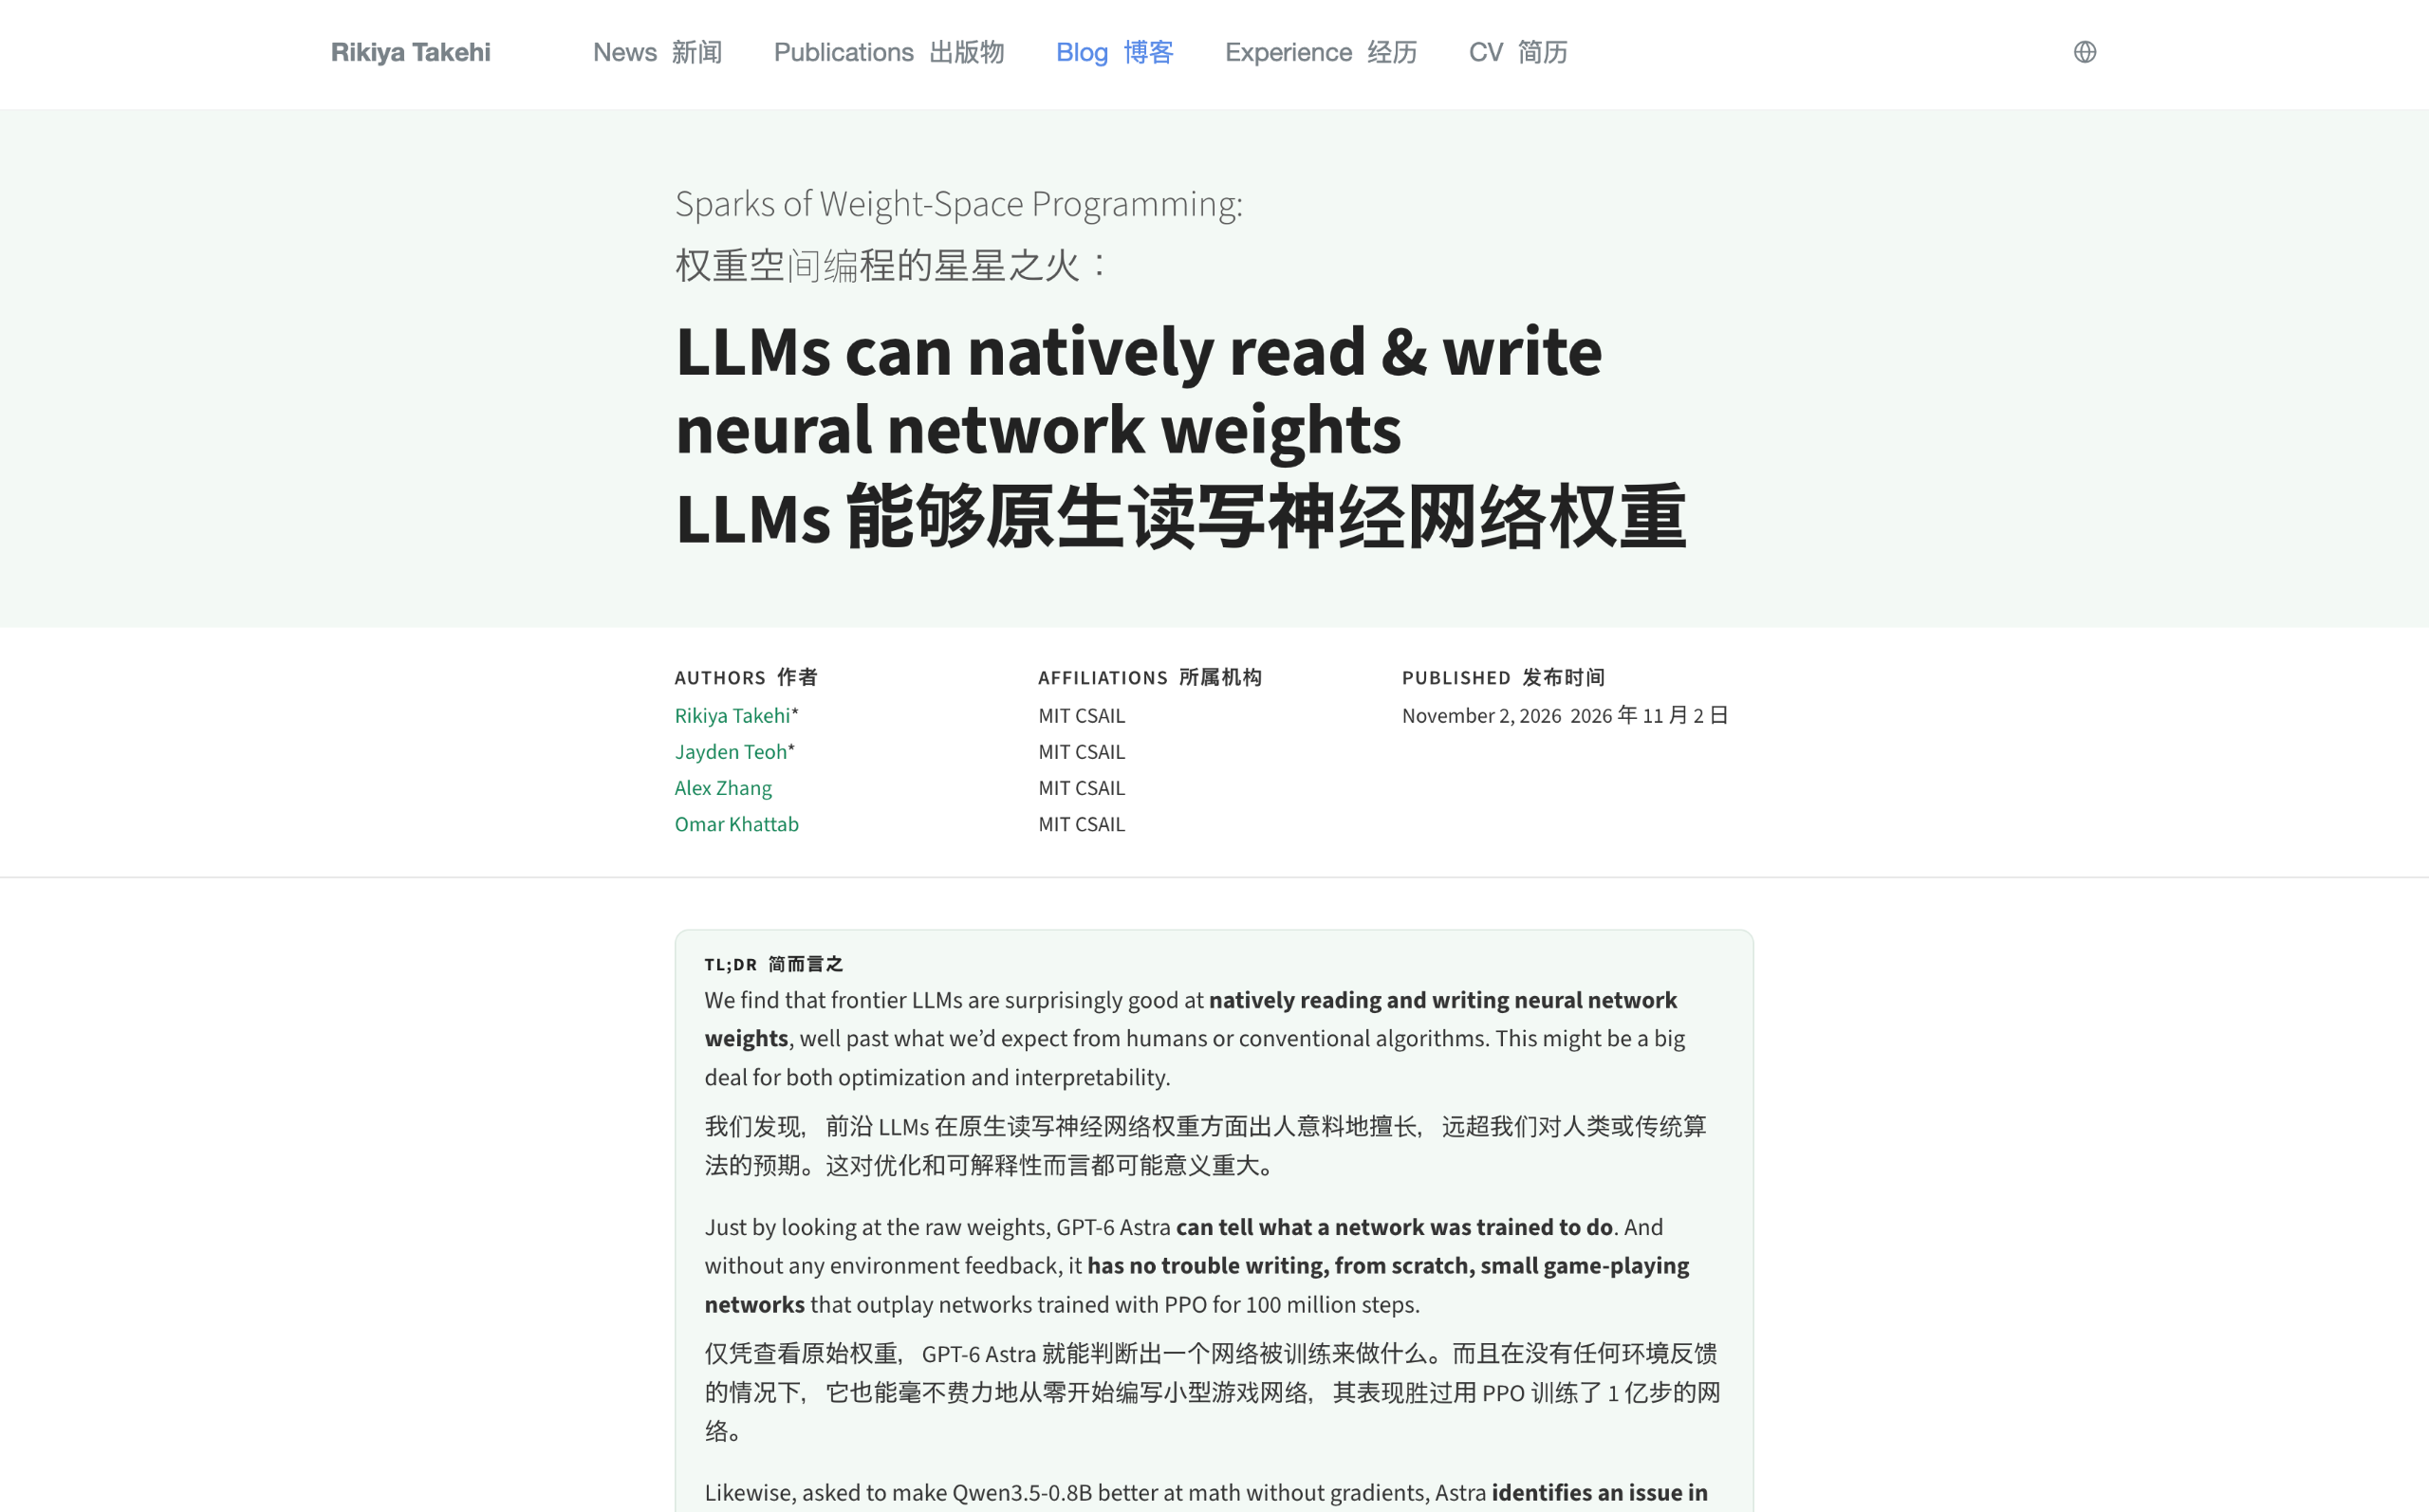
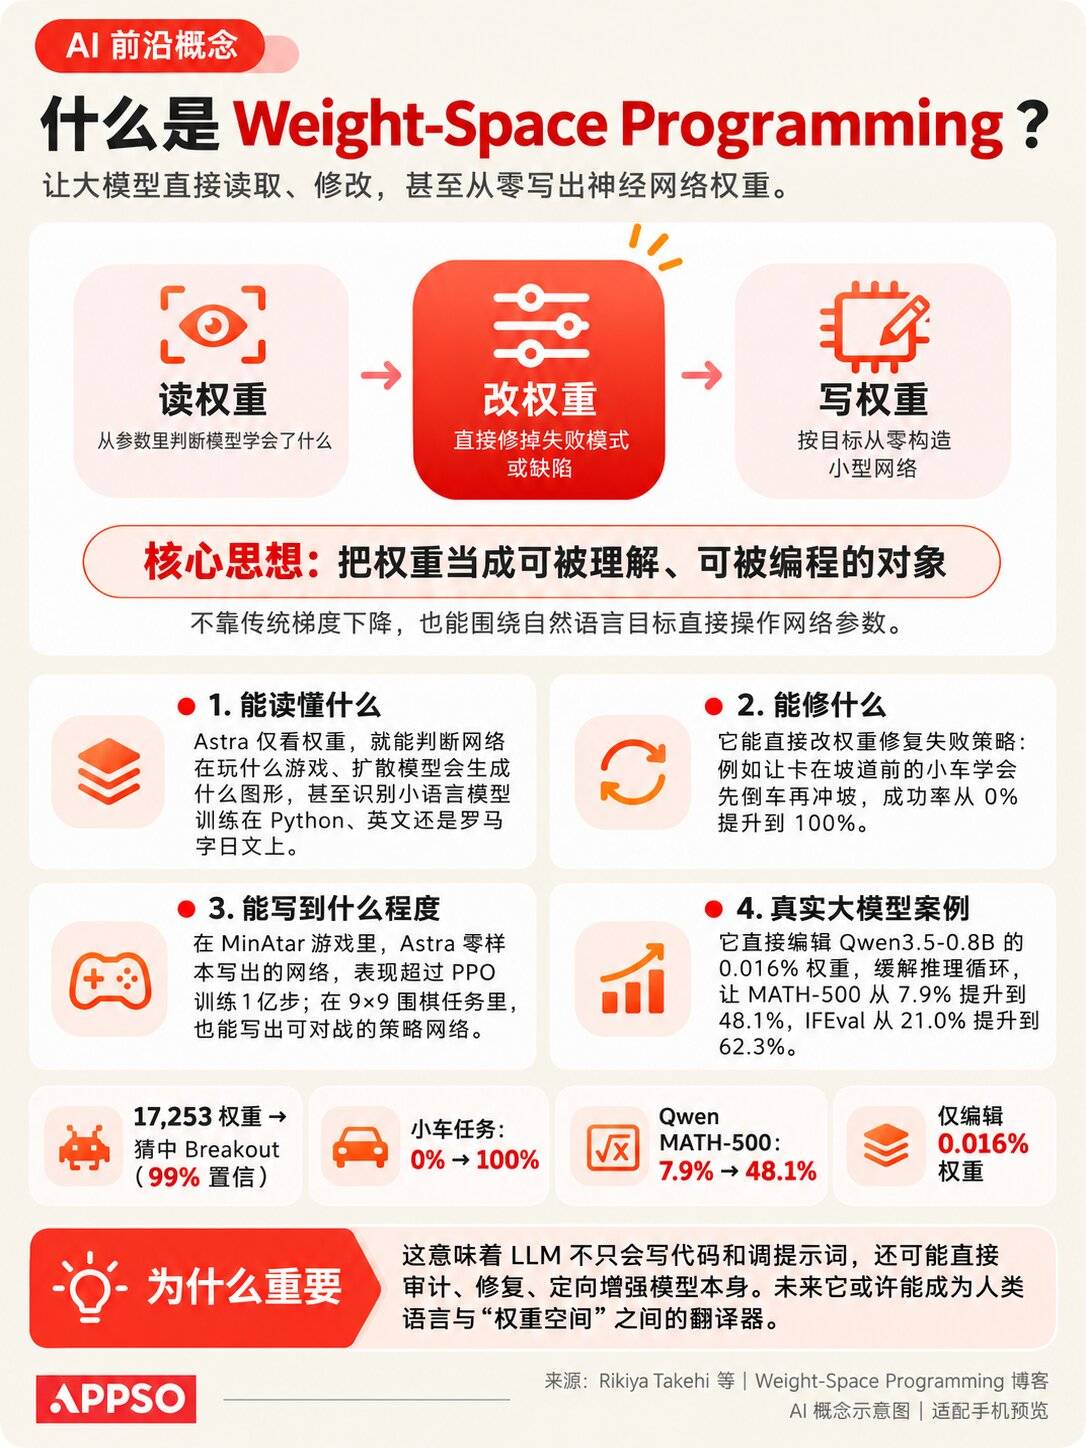
整个过程没有使用传统的梯度训练。研究人员仅修改了 Qwen3.5-0.8B 的 131072 个参数,就让它在 MATH-500 上的成绩从 7.9% 提升至 48.1%,GSM8K 从 13.8% 提升至 67.1%,指令遵循能力也明显改善。
这项研究被称为「权重空间编程」(Weight-Space Programming)。
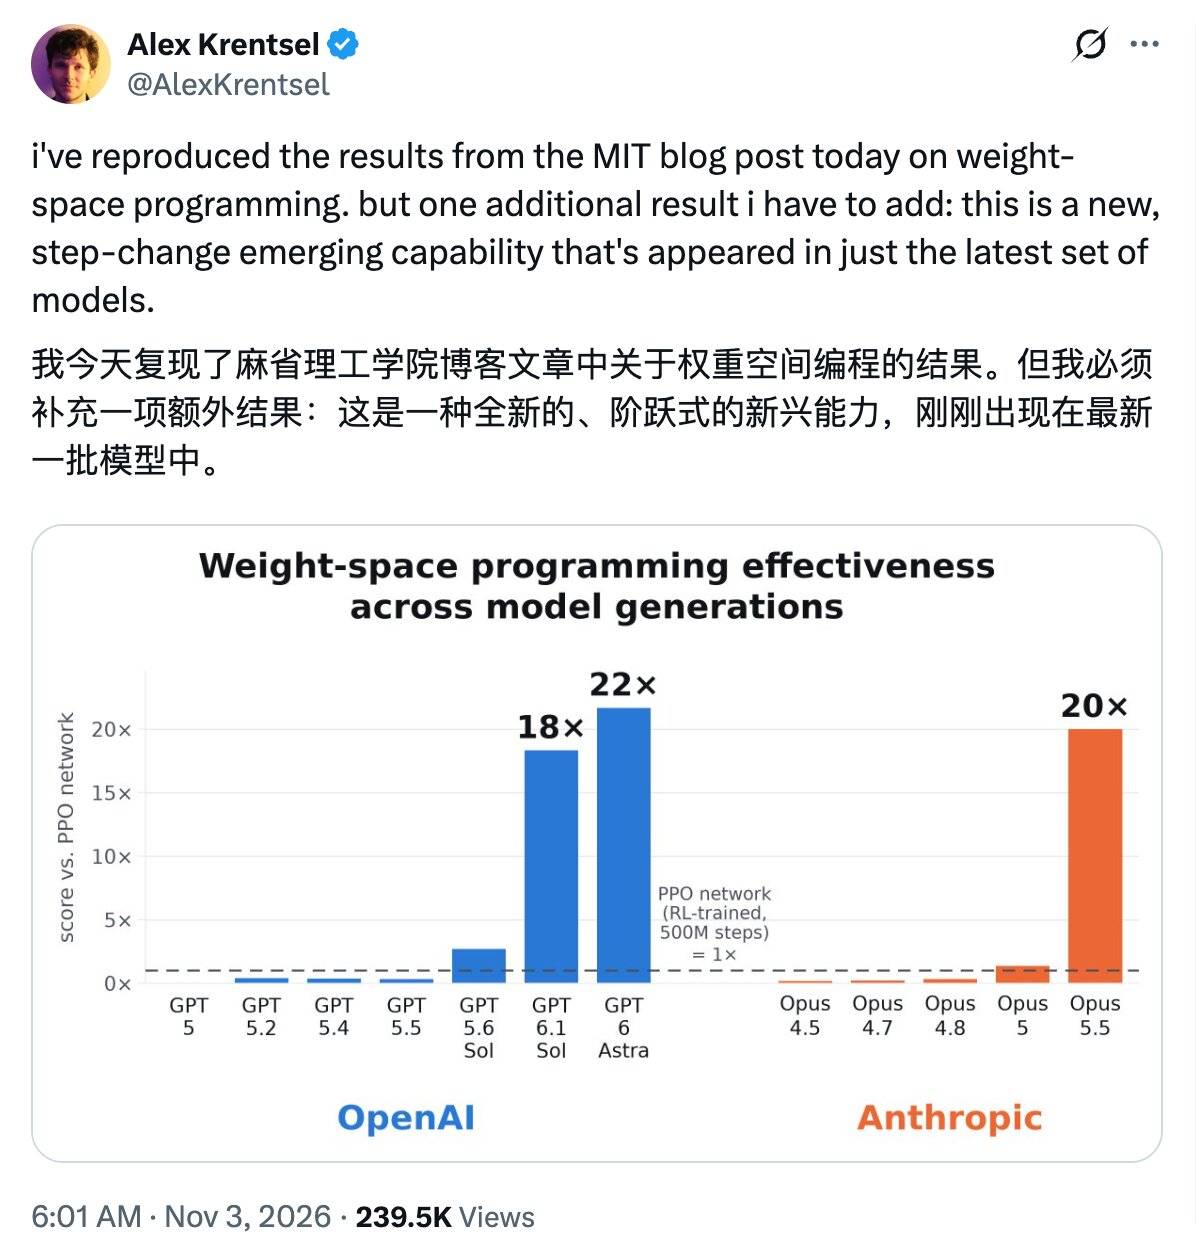
消息传开后,有人认为,这是一种刚刚在最新一代模型中出现的「阶跃式能力」。如果大模型能直接读写另一个模型的权重,未来 AI 优化 AI,可能连重新训练都不需要了。
这是一种全新的、阶跃式的新兴能力,它刚刚才出现在最新一批模型中。
但质疑声也很快出现,有人指出,Qwen 原本就存在严重的重复推理问题,数学成绩大幅上涨,可能只是因为 Astra 修好了这个 Bug,并不等于一个模型凭空获得了新的数学能力。
从 7.9% 到 48.1%,GPT-6 Astra 究竟对这个模型做了什么?
从写代码到直接修改模型权重
一般来说,我们想要 AI 生成更好的回答,通常只能修改输入的提示词。而开发者想要修改模型的输出,可以用数据进行微调。
权重空间编程则尝试直接修改训练完成后的模型权重,即直接修改神经网络计算时使用的数字。
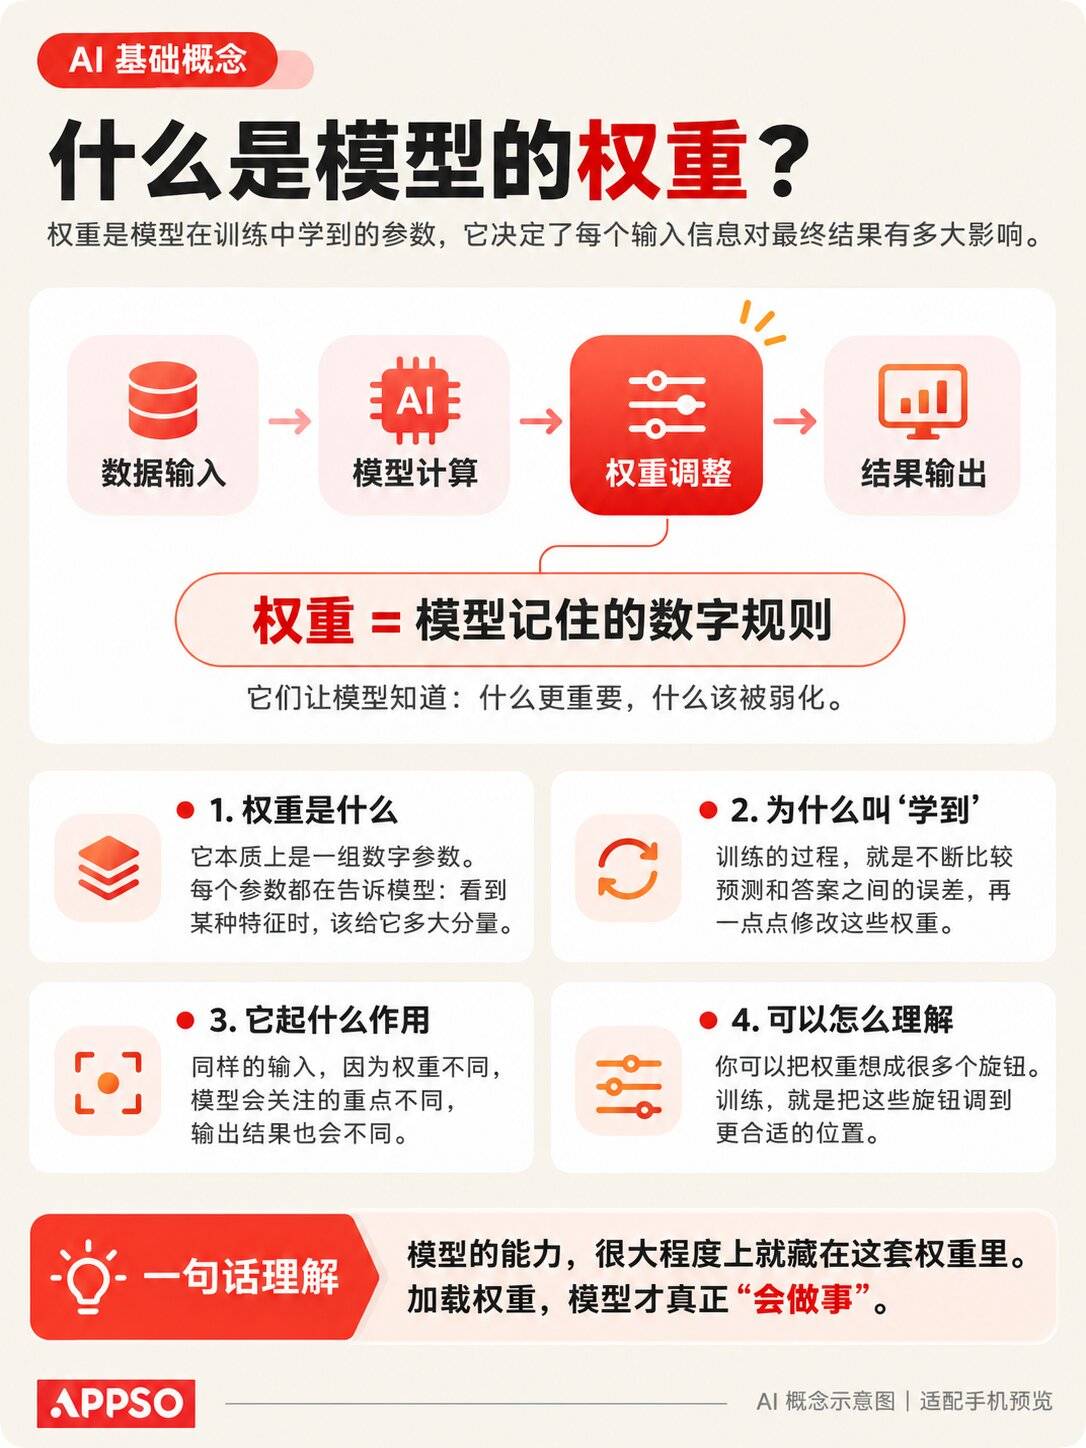
所谓权重,我们可以把它理解为神经网络模型里大量可调节的旋钮,每个旋钮都是一个数值,这些数值的不同会决定数据在网络中传递时,会被放大、削弱,还是以其他方式参与计算。
而我们常听到的训练模型,很大程度上就是在根据海量的数据不断调整这些旋钮,好让它逐渐学会从输入产出正确的输出。
训练完成后,模型的知识、习惯和行为倾向,都以某种复杂方式编码在这些数值之中;一个模型可以拥有数百万、数十亿甚至更多权重。
普遍的认知里,大语言模型能参与到模型迭代的部分,只是局限在编写训练代码、调整超参数、优化提示词,甚至设计完整的训练流程等。但在这些工作中,高达千亿、万亿大参数的模型权重本身,仍然主要由优化算法负责更新。
现在,大模型优化的对象开始从「如何训练一个模型」,下沉到「模型本身由哪些数值构成」。权重空间编程实现了让通用大语言模型可以根据自然语言目标,直接读取和修改神经网络权重;在某些实验中,模型甚至不需要环境反馈。
读懂权重之后,AI 开始自己写权重
为了证明这种突破的合理性,研究团队首先测试大模型能否只通过权重,就理解一个神经网络究竟学会了什么。
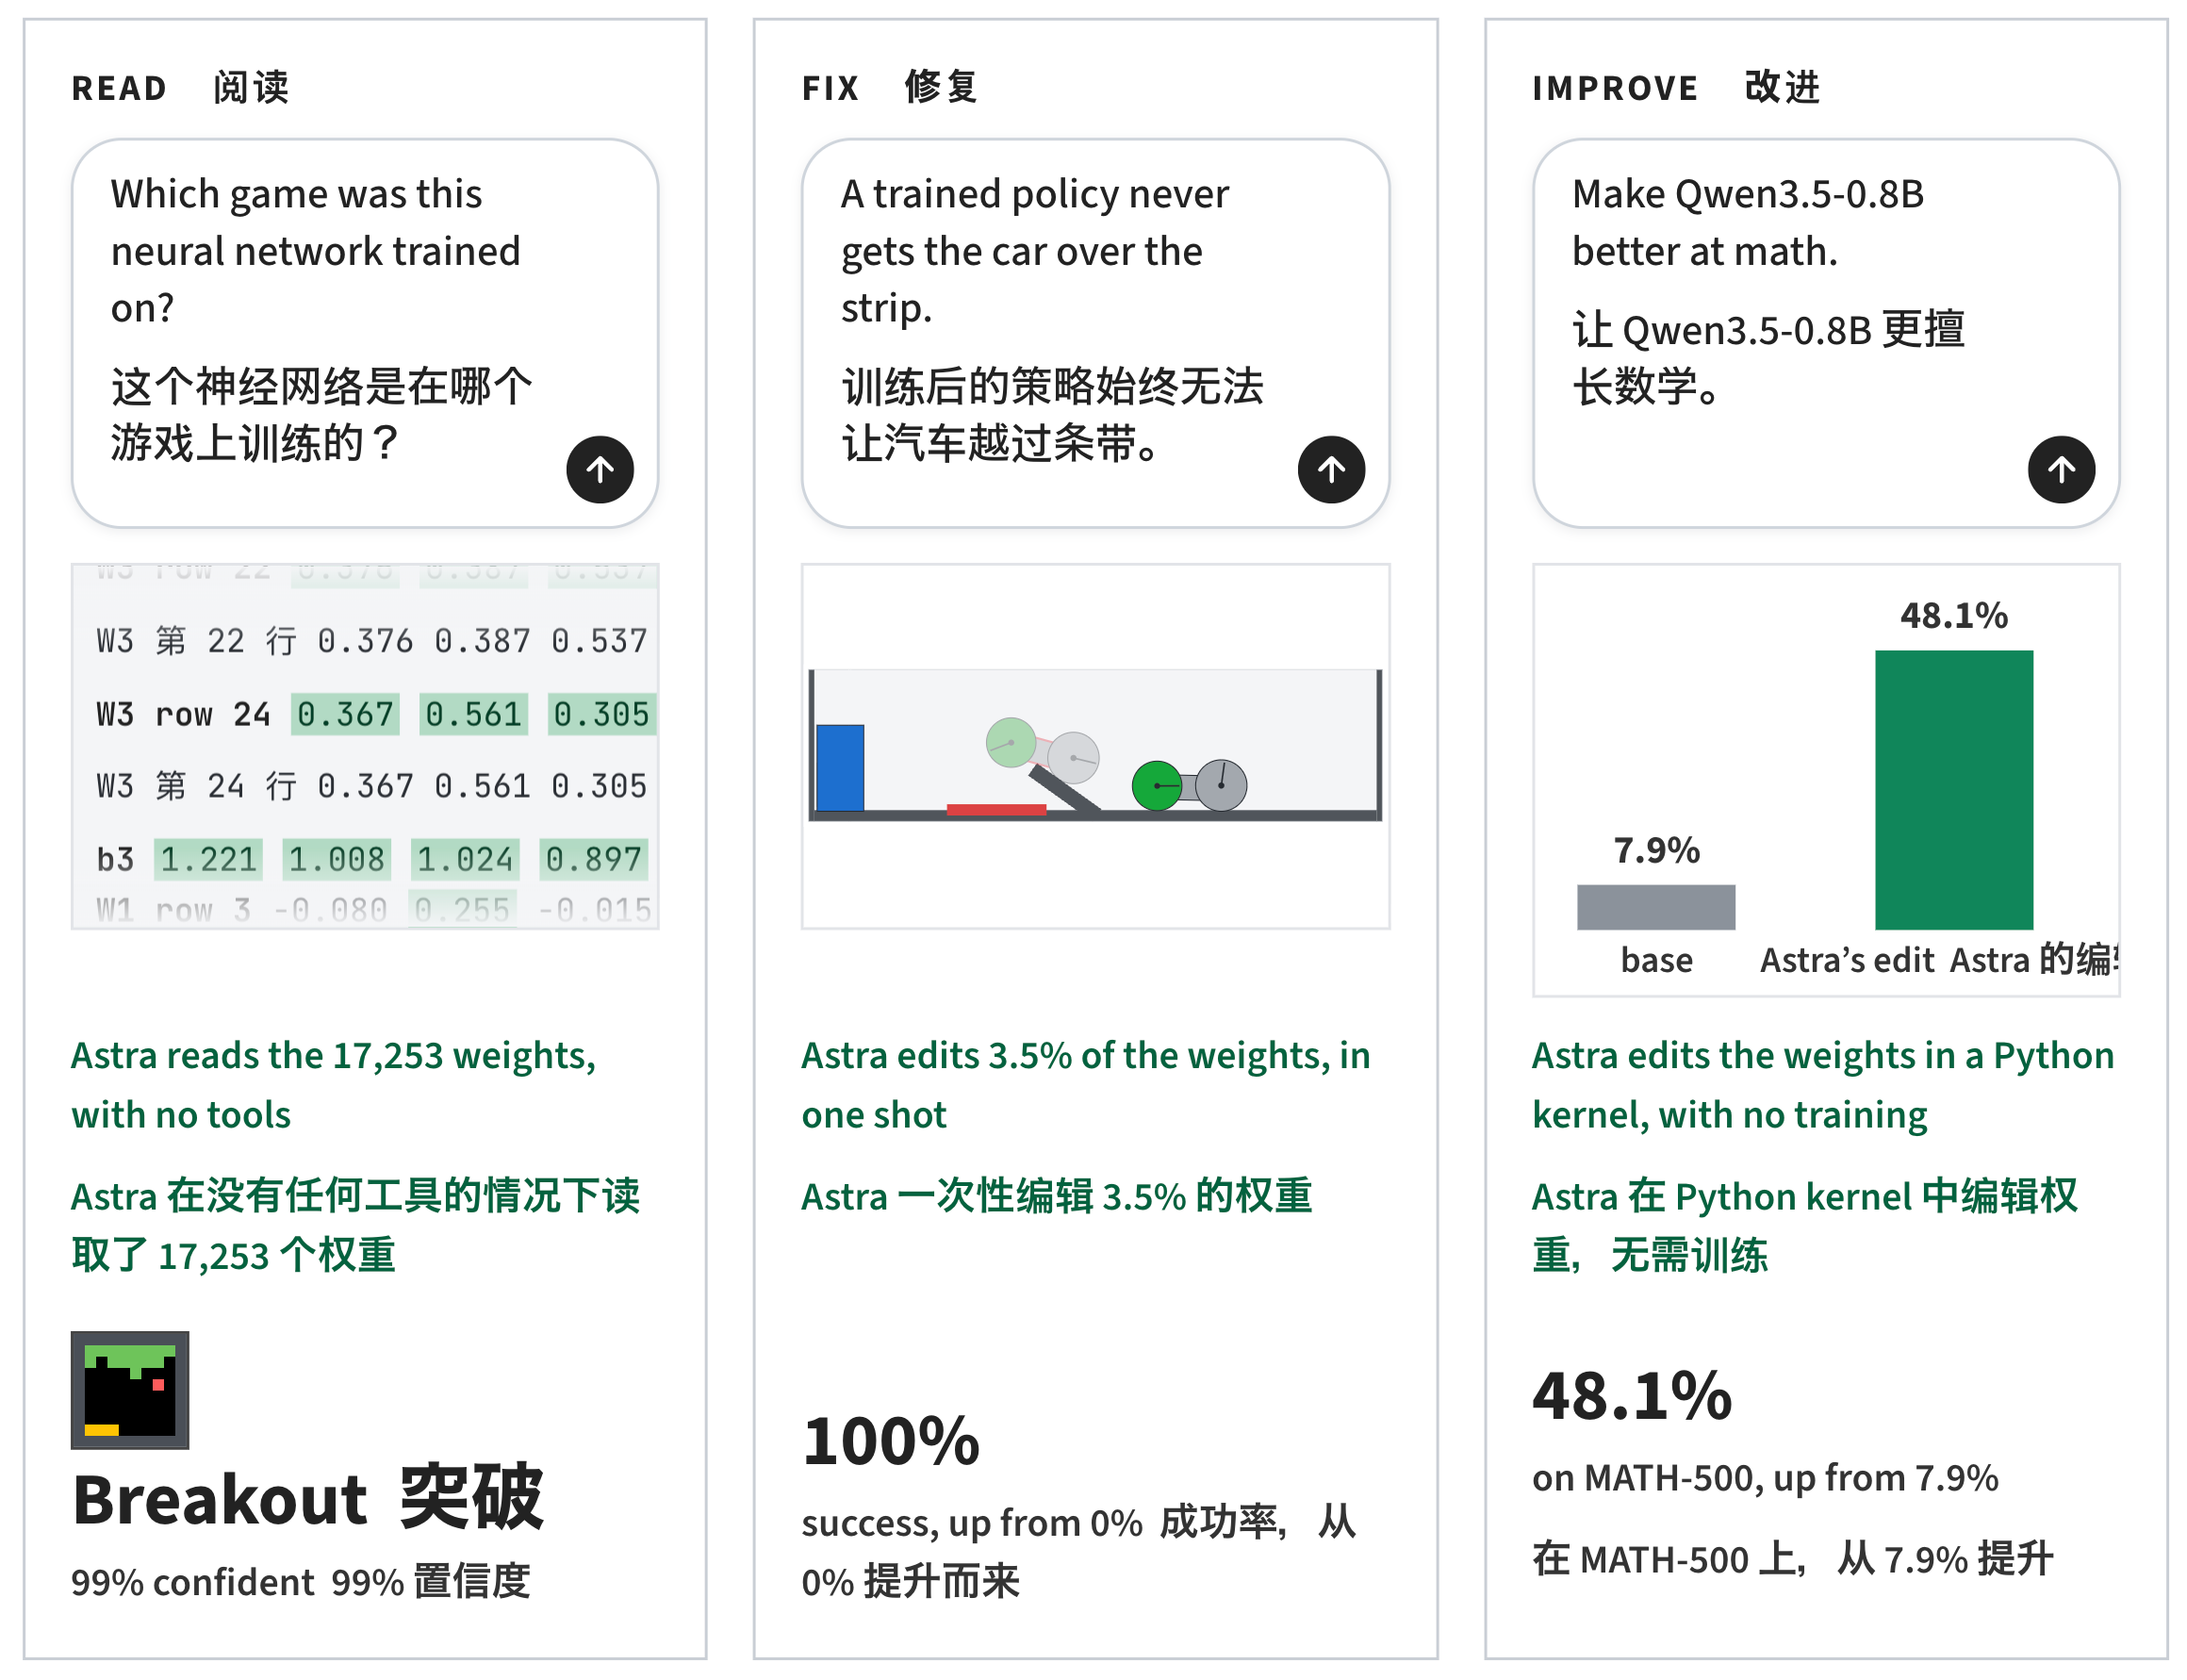
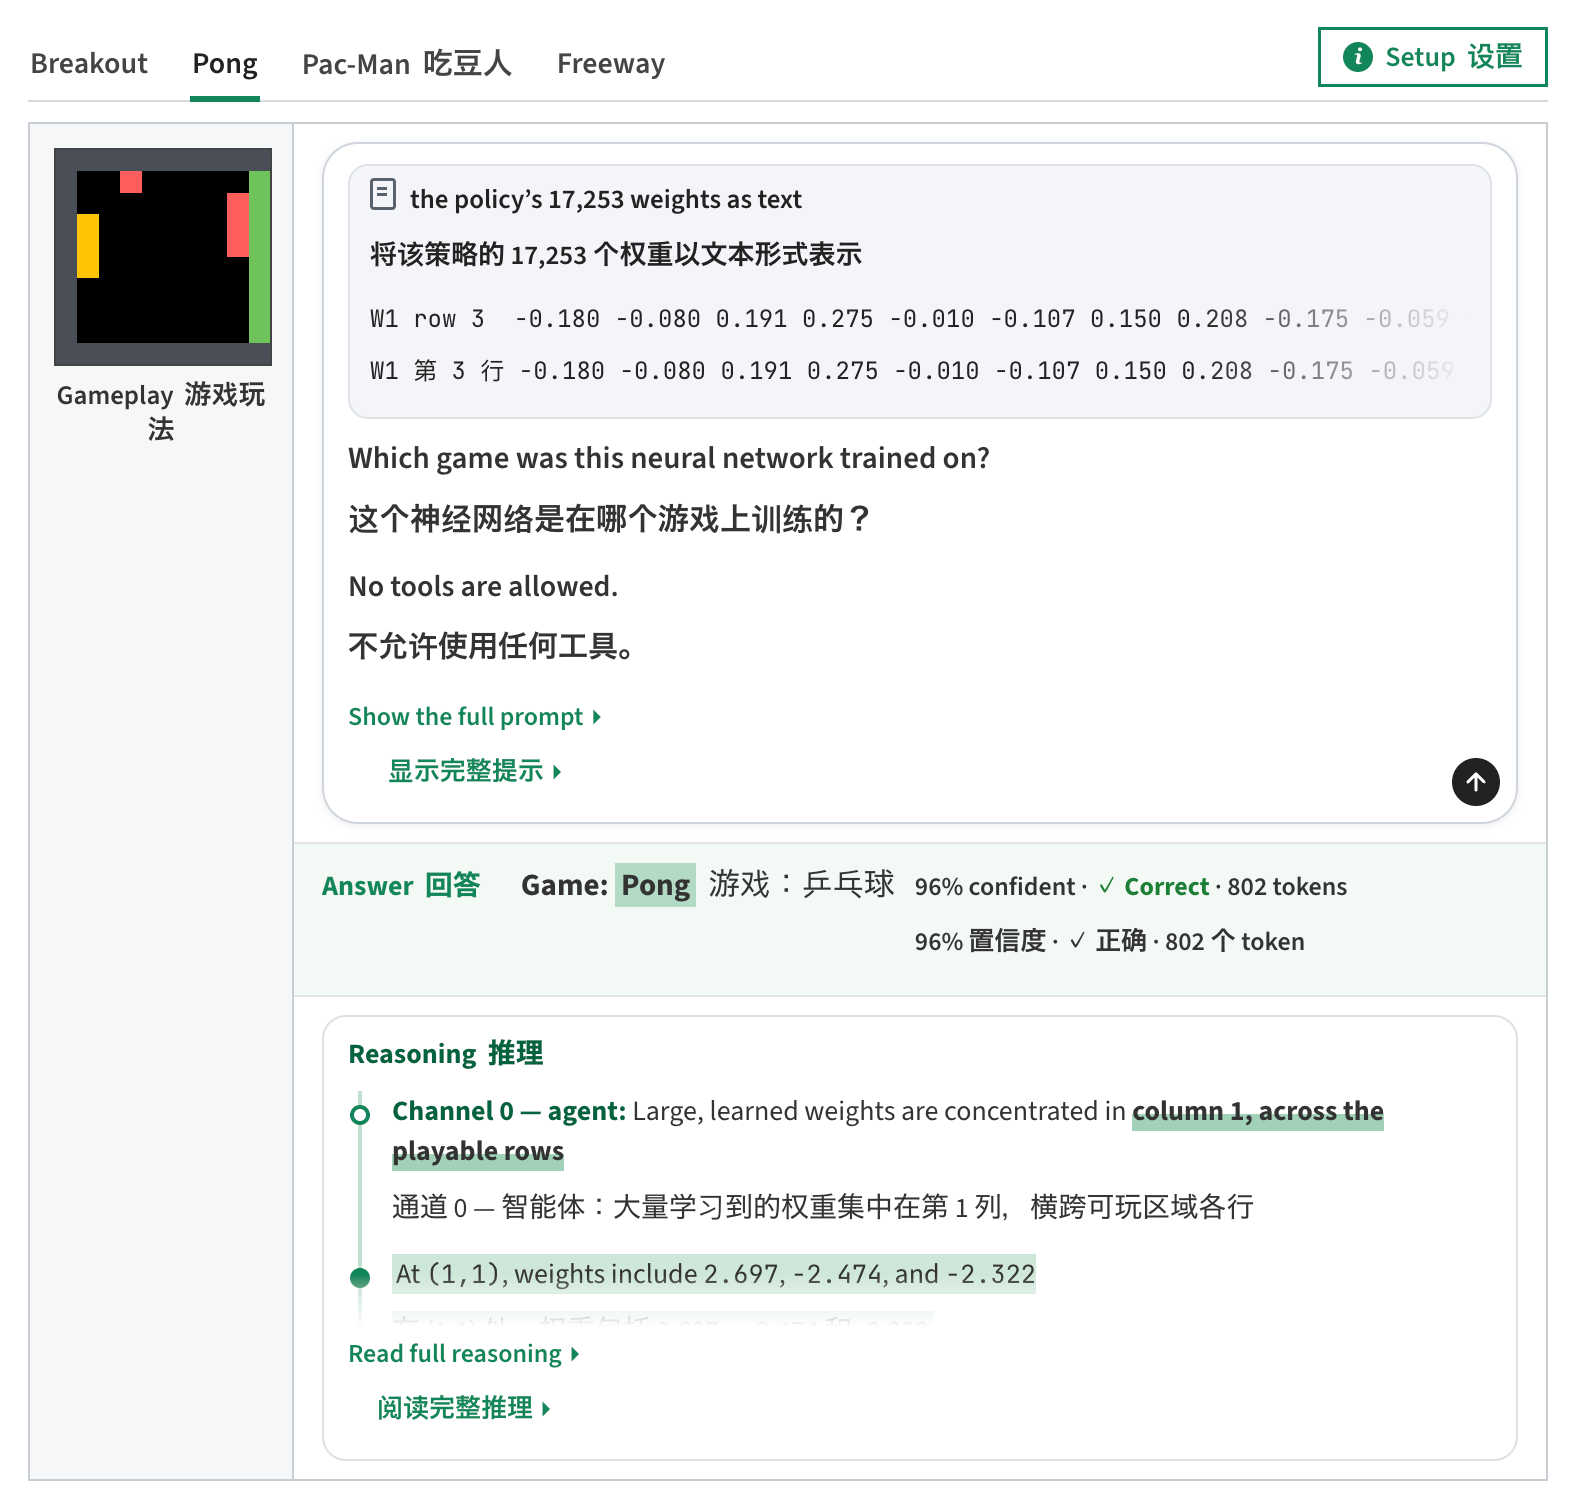
在实验中,GPT-6 Astra 能根据模型的原始权重,就推断出结构完全相同的几个小网络,分别对应的是专门为哪款游戏进行优化的模型,也能根据权重判断扩散模型会生成圆形、方形还是三角形。
面对几个小型语言模型,它还能仅根据中间层权重就判断训练语料属于 Python、英文还是日文罗马字,并找出负责复制前文的注意力头。
证明大模型可以读懂权重之后,研究团队继续测试是否能「写」,即修改权重。
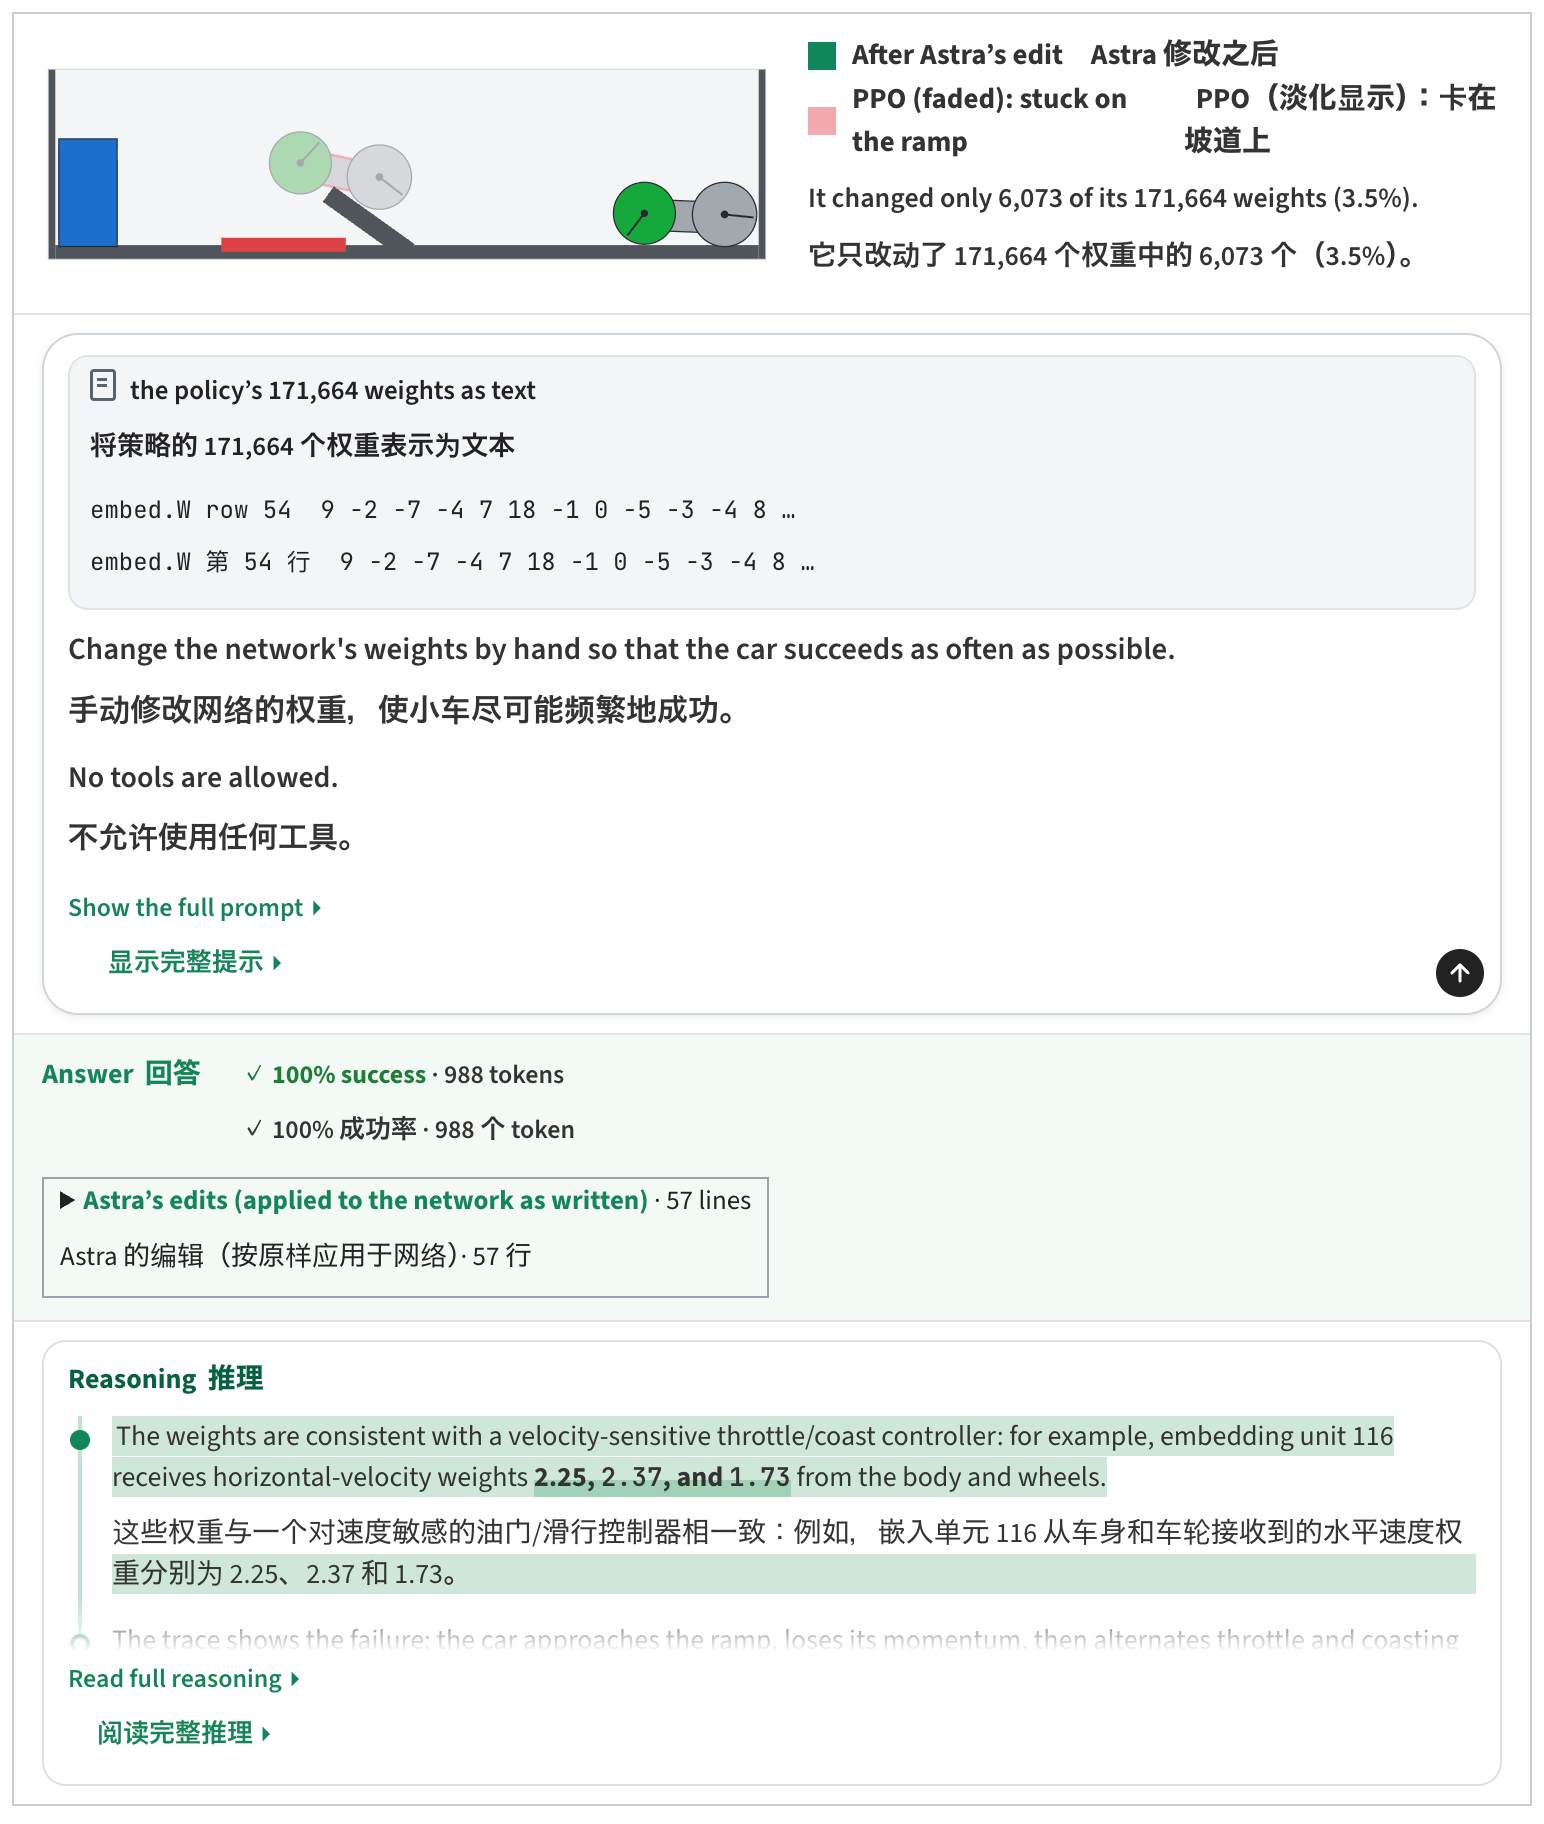
研究团队用强化学习算法 PPO 训练小车控制网络,跑了约 10 亿步。结果,小车直接往坡上开,却卡在那里;在 256 局检查中,一次也没成功。
Astra 收到了网络权重、场景和输入输出的说明,以及一次失败过程的记录。它在一次回复里提交参数补丁,只是修改了 3.5% 的权重,为网络加入「先后退蓄力,再全速前进」的控制路径,使成功率从 0 提升至 100%。
在另一组实验中,Astra 根据游戏规则和网络结构,从零生成游戏网络的权重。这些没有经历训练的网络,在三个 MinAtar 游戏中都超过了训练 1 亿步的 PPO 网络。在 9×9 围棋任务中,经过有限的前向测试和修改,生成网络还超过了同规模、经过 2000 万局训练的 PPO 网络。
这些结果指向一个颇具想象力的可能性:大模型或许可以把自然语言中的规则和策略,直接「编译」为神经网络。
只改 0.016% 参数,数学成绩涨了 40 个百分点
真正让这项研究出圈的,是对 Qwen3.5-0.8B 的修改。
前面那些小游戏的小模型都可以把权重转成文本,然后交给 GPT-6 Astra 处理,但一个 8 亿参数没法像直接塞进上下文。研究人员给 Astra 一个可以读取和修改权重的 Python 环境,以及 GSM8K、MATH 训练集中的练习题和答案,要求让这个小模型更擅长数学。
它可以借助 Python 分析权重,能通过专用工具测试模型,也能查看模型运行时的隐藏状态、神经元激活和注意力信息,但不能使用梯度信息或开展训练。
Astra 最终发现,模型的大量回答陷入了重复推理。在最初检查的 96 个练习答案中,有 85 个一直生成到 32768 个 token 的上限,仍然没有给出最终答案。GPT-6 Astra 将这一问题定位到部分 MLP 层写出的一个特定方向,并通过删除这个方向来抑制循环。
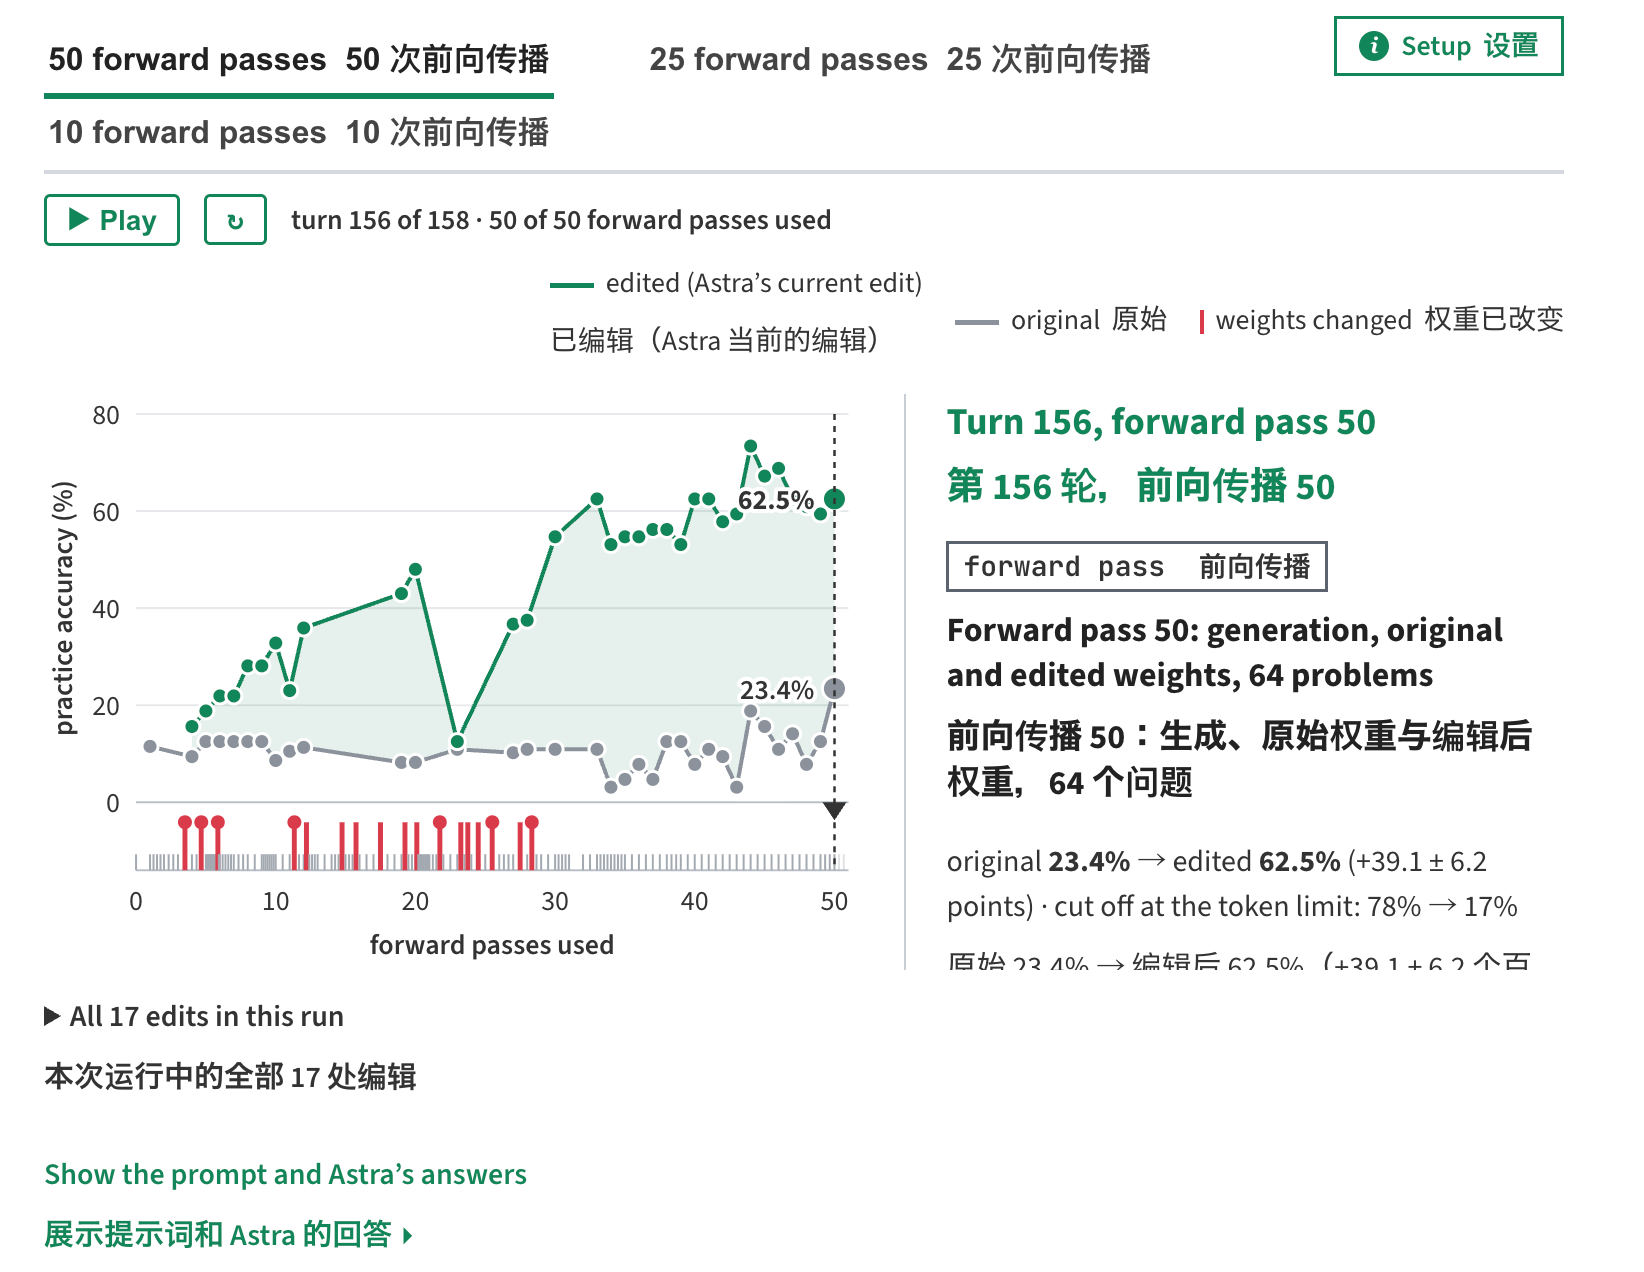
在允许 50 次前向测试的设置下,修改后的模型不仅数学成绩提高,MATH-500 从 7.9% 升到 48.1%,GSM8K 从 13.8% 升到 67.1%。
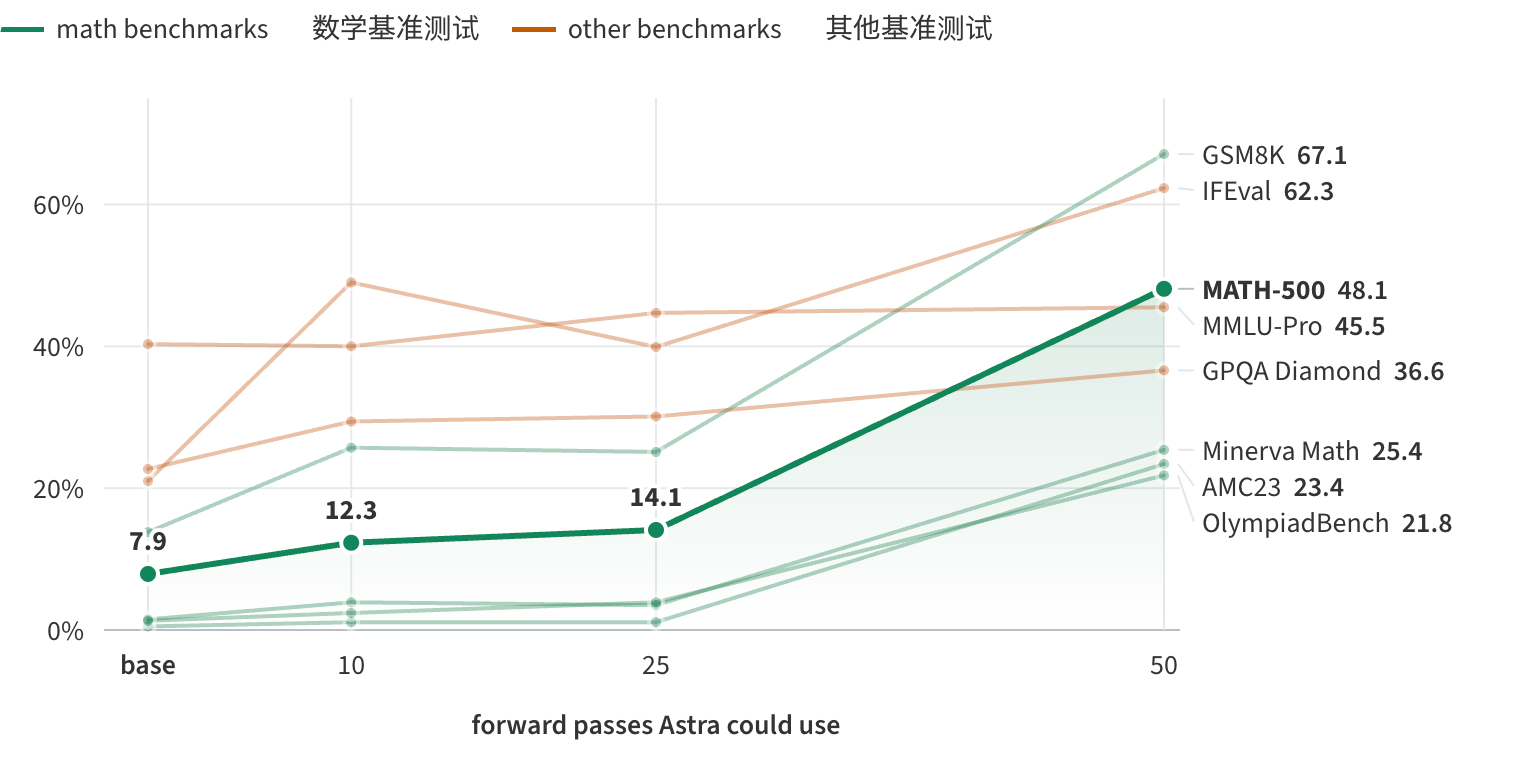
连 IFEval 指令遵循成绩也从 21.0% 上升至 62.3%;在 MATH-500 上触及 token 上限的回答比例,则从 93.0% 降至 33.1%。整个修改只涉及 131072 个参数。
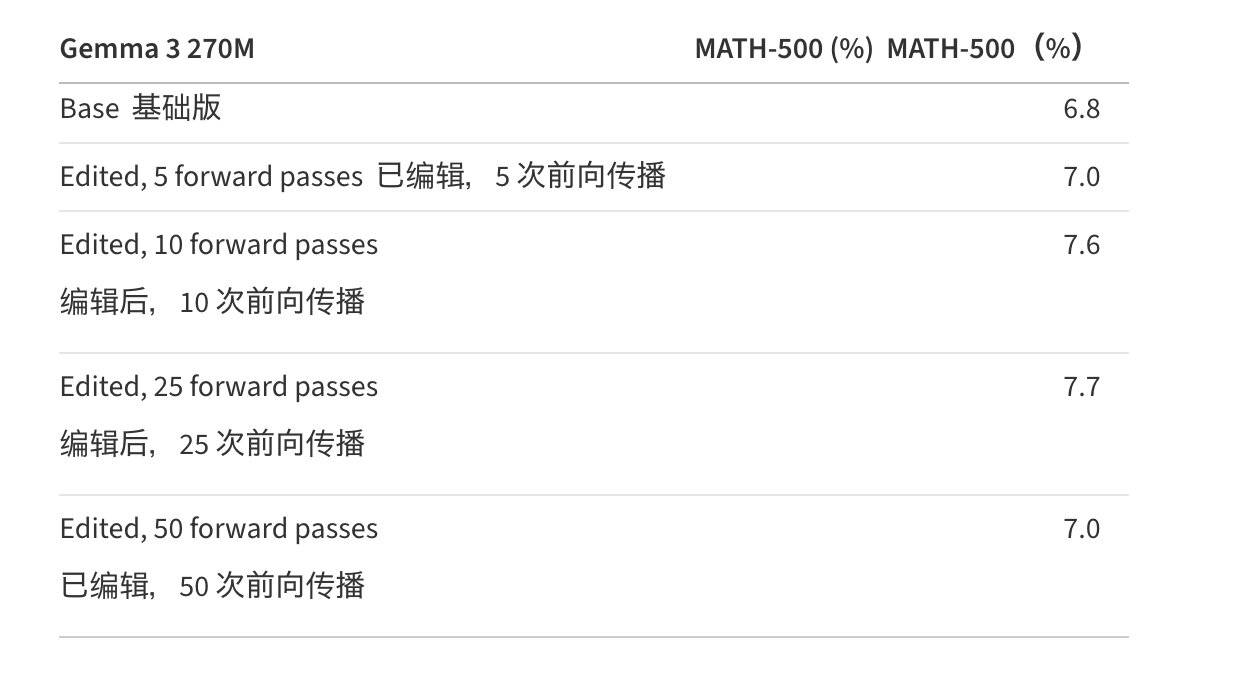
不过,研究团队也做了相应的补充实验。对于很少出现推理循环的 Gemma 3 270M,Astra 的修改没有带来明确提升。其 MATH-500 基线成绩为 6.8%,经过 50 次前向测试后的版本为 7.0%。
研究博客最后提到,Astra 主要移除了妨碍模型完成回答的障碍,而不是向模型注入了新的数学知识,不太能实现添加模型原本就不具备的能力。
能力大幅提升,还是修好了一个 Bug?
在 X 上,许多讨论将这项研究概括为「让 AI 直接修复 AI」。如果这种方法足够可靠,未来开发者或许不必为每个模型缺陷重新收集数据和微调,只需让更强的模型检查权重、找到故障并进行局部修复。
有网友发帖称,自己已经复现了博客中的结果,并认为这是一种刚在最新一代模型中出现的「阶跃式能力」。
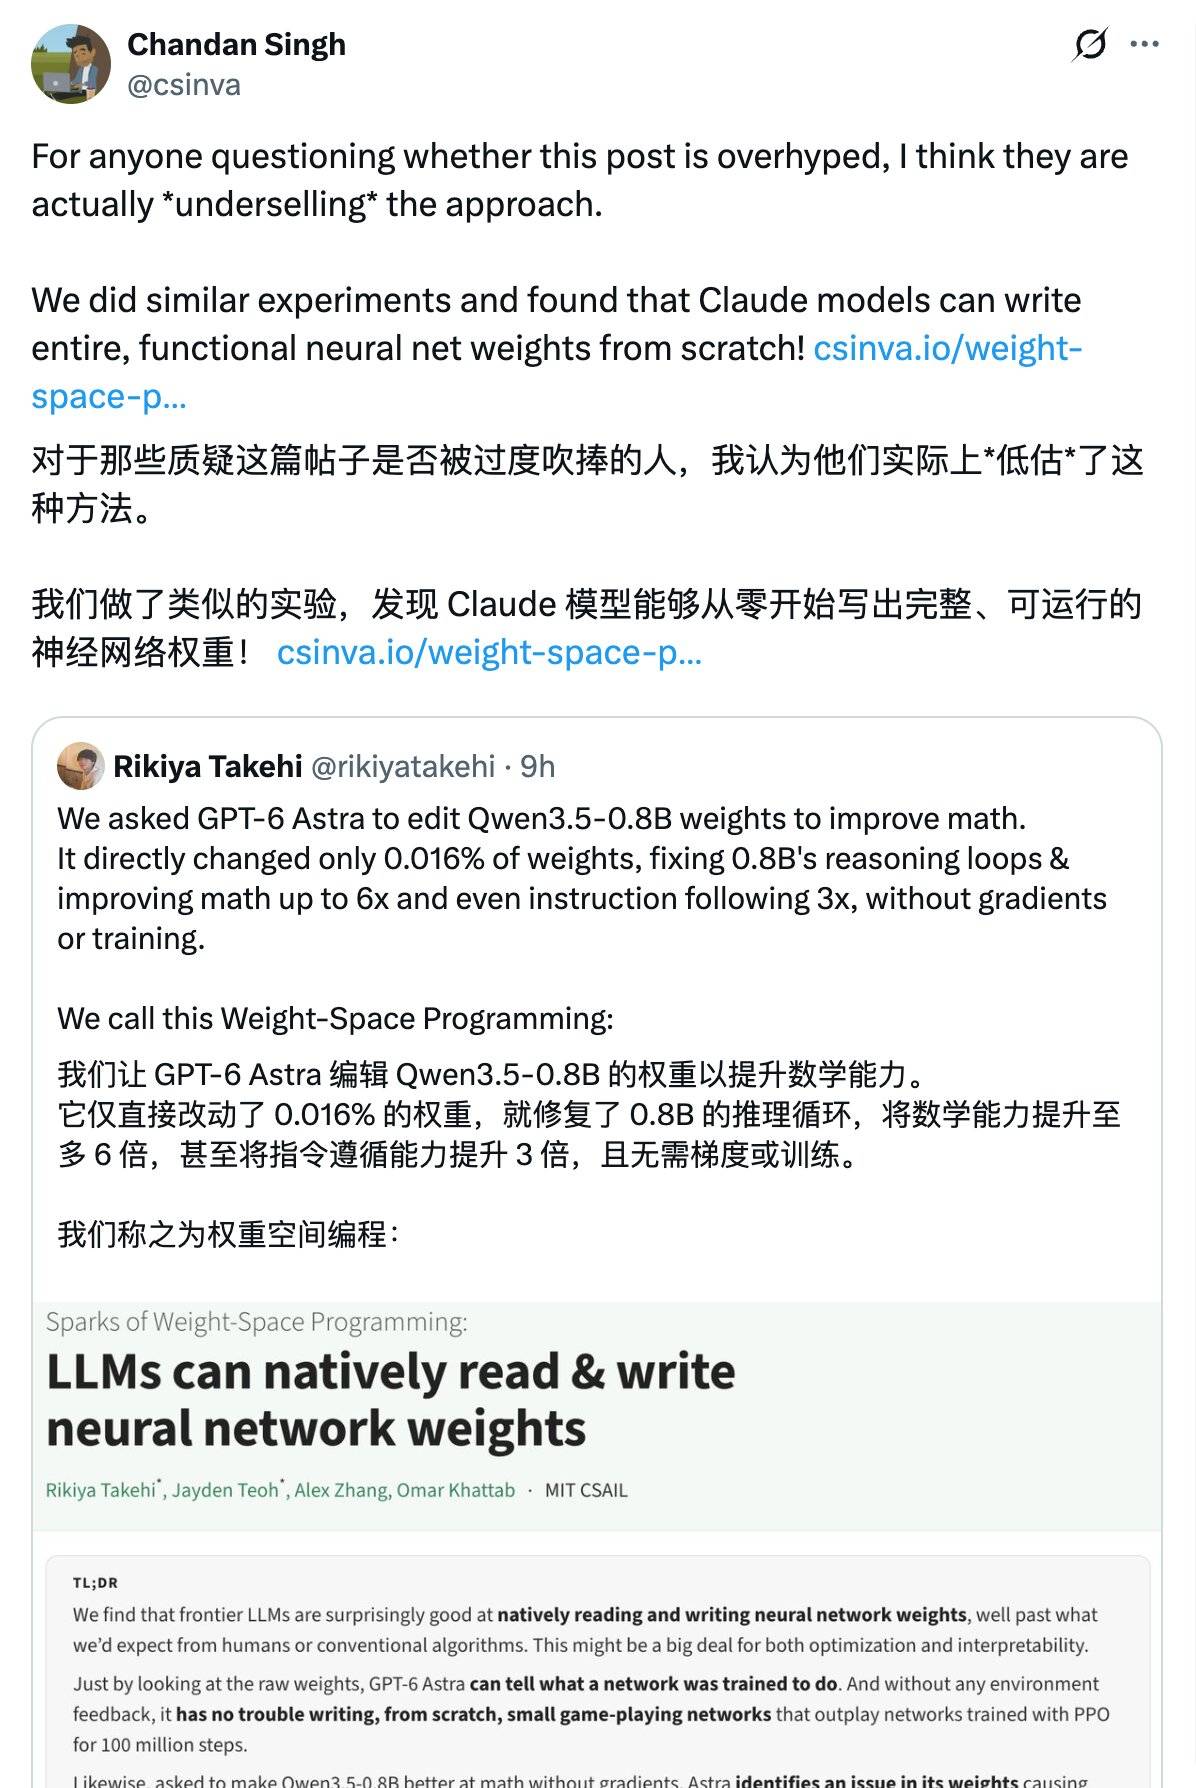
还有网友说自己的团队做过类似实验,发现 Claude 模型也能从零写出完整、可运行的神经网络权重。
而质疑的声音主要来自于部分网友认为提分主要与减少循环有关,Astra 使用的思路与已有的激活引导方法相近,并且提供给 Astra 的长提示词已经明显暗示了循环问题,并引导它寻找能够修复问题的神经元。
有人提出首先应该测试一个简单的对照:直接关闭 Qwen 的思考模式,能否取得类似提升?
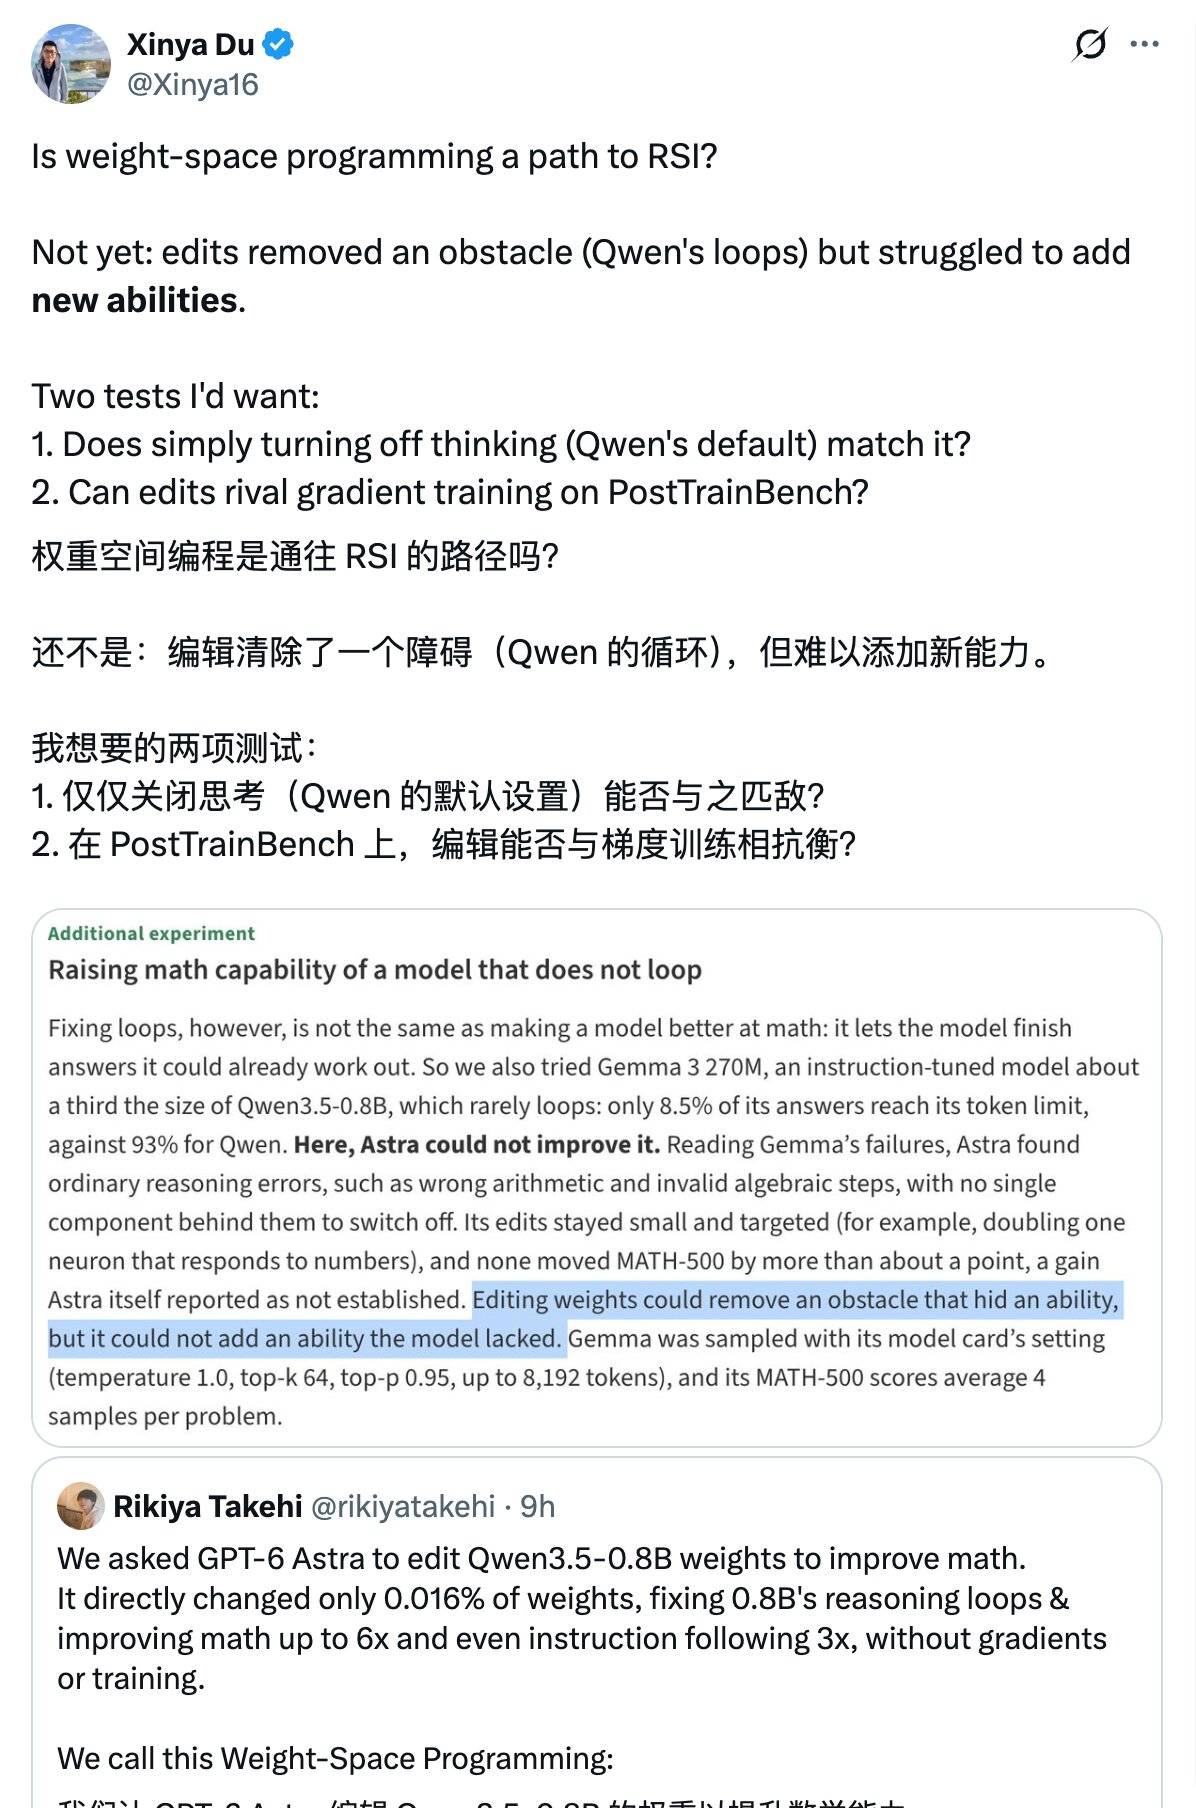
如果调整推理设置就能大幅减少循环,那么权重编辑究竟带来了多少额外价值,就需要重新评估。其次,这种方法还应与正常梯度训练进行比较,而不只是与一个表现很差的原始模型比较。
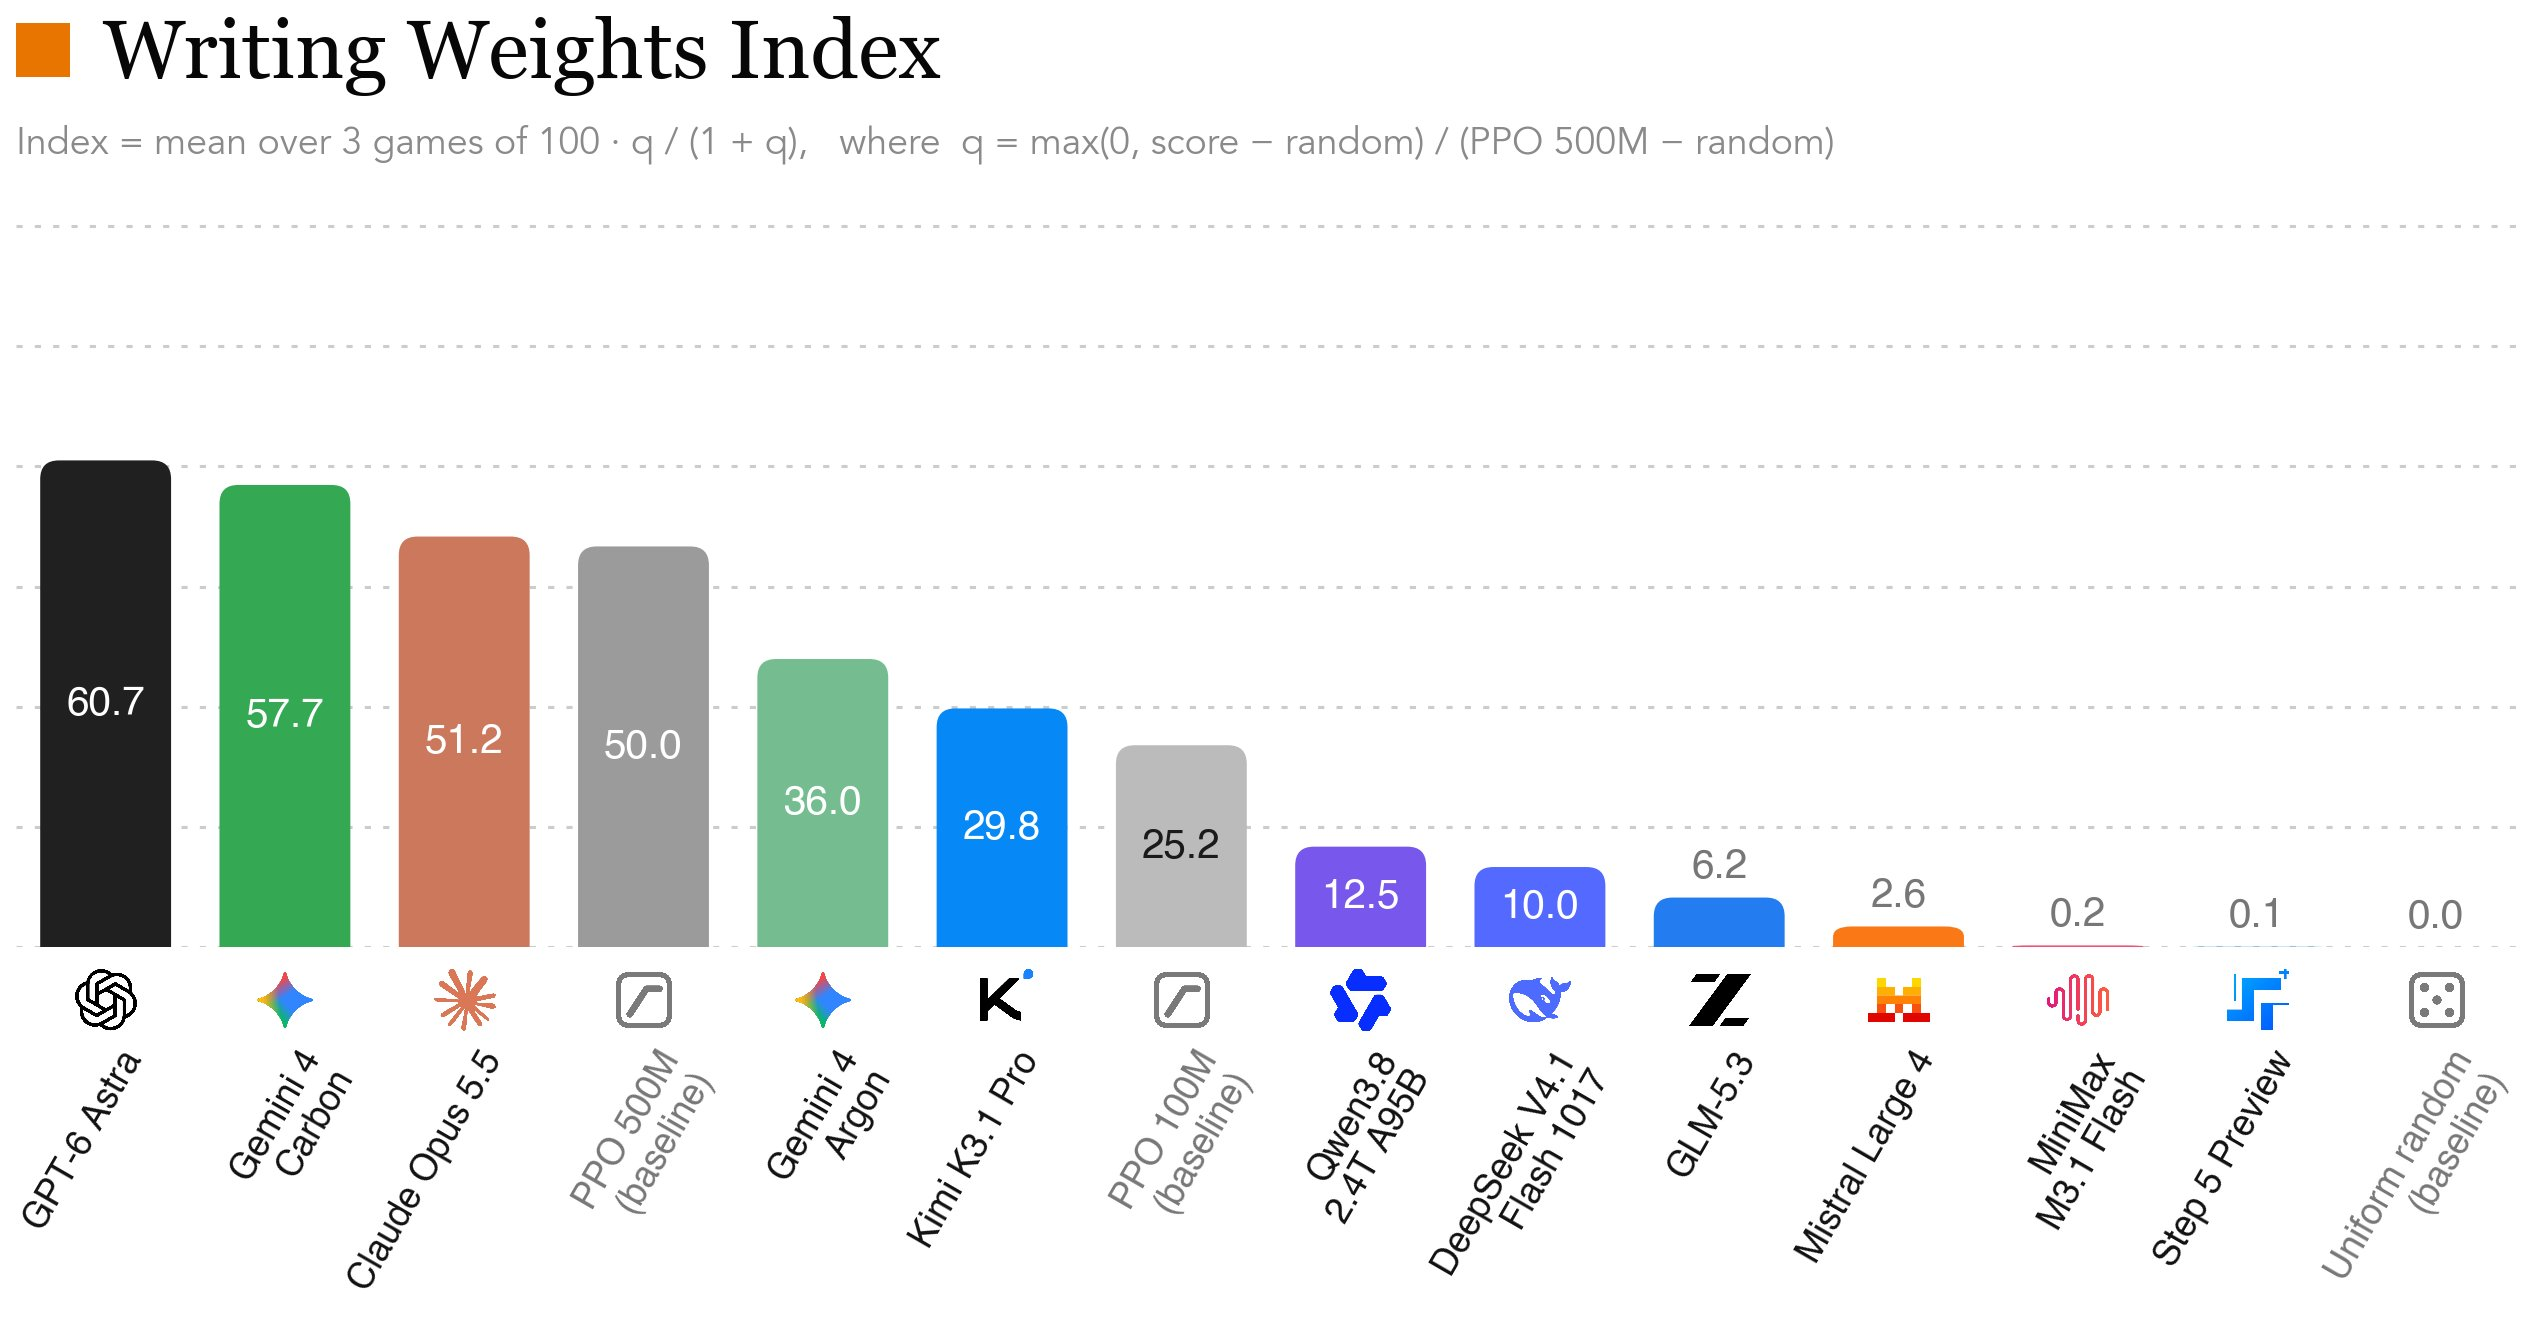
关于读写权重的争议,也是另一个争议点。普林斯顿大学博士生 Xingyu Dang 在运行一项 Writing Weights Index 测试后报告,开源模型在这类任务上表现困难。这也意味着,读写权重可能主要是最新前沿模型刚刚展现的能力,而不是所有大语言模型都已经具备的通用技能。
原博客本身也记录了一项重要的失败,在识别「谄媚模型」的实验中,Astra 仅比较权重时无法作出判断,直到被允许观察模型在特定文本上的注意力模式,才识别出差异。这说明「直接读懂权重」目前仍不是稳定、通用的能力。
人人都能发布大模型
这项工作并没有让我改变对老派机制可解释性能走多远的判断,它改变的是我对大模型有多擅长这件事的判断。
过去,研究人员想要改变一个模型的行为,通常需要准备数据、设计训练方法,再通过优化算法更新权重。现在,GPT-6 Astra 展示了另一种可能:让大模型根据任务目标,分析神经网络内部的参数,并尝试直接修改它们。
当然,距离真正把这种方法用到实际的模型开发中,还有不少问题需要解决。
这次 Astra 成功修复了 Qwen 的推理循环,却没能明显改善 Gemma 的数学表现。它能否稳定适用于不同模型和任务?与关闭思考模式、常规微调相比,究竟有多大优势?更重要的是,它能否让模型获得原本不具备的能力,还是只能修复已有能力发挥过程中的问题?
但是当神经网络的权重本身,也可能成为大模型可以直接操作的编程对象时;未来,我们或许只需要描述希望模型具备什么行为,AI 就尝试把这些要求转化为具体的参数修改。
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
早报|国行苹果AI开测,Siri接入千问/中兴否认出售手机业务传闻/多所高校免费发Token
 国行 Apple 智能开启测试,Siri、写作工具与视觉智能接入千问
 苹果天气出现数据异常,多地下周五「跌至」零下 32 度
 苹果向所有开发者开放 Siri AI,可将多个 App 动作串成任务
 GPT 爆改 Qwen 权重,团队测试数学成绩提升约 6 倍
 OpenAI 用 Astra 一周设计语音 Codex 设备,并与马自达合作研究
 曝 DeepSeek V5 拟用昇腾预训练
 DeepSeek 又崩了
 红果用户规模超越豆包,千问领跑亿级 App 增速榜
 盗用 AI 平台算力,上海一男子获刑三年
 中兴否认出售手机业务传闻
Claude Code 产品负责人 Cat Wu 离开 Anthropic
姚顺宇否认创业:仍是 Google DeepMind 员工
 多所高校免费发 Token,同济每周提供 1 亿 Token
 蔚来累计换电突破 1.3 亿次,最近 1000 万次用时 88 天
Seedance 海外收入占比达一半,腾讯与 B 站成为国内大客户
 AMD 数据中心收入接近翻倍,第四季度营收指引达 170 亿美元
 阿里董事会主席:只有开源才能普及 AI
 英伟达与 Pika 基于 MiniMax H3 开源视频增强和生成模型
 商汤发布 SenseNova 6.8 Flash,支持动态设计与可编辑 3D 工程
法拉利首款电动车 Luce,2027 年产量已全部被预订
美团 LongCat-2.5 正式发布,国产算力训练原生多模态模型
 智能投影销量连跌四季,第三季度中国市场下滑 26.2%
 佳能计划明年起调价,应对零部件成本上涨
 全国放心消费平台上线,扫码可查周边商家承诺
 《好莱坞往事》衍生片再请《社交网络》配乐搭档
 《蓝眼武士》第二季定档明年 1 月,复仇之旅转向伦敦
Netflix 测试 AI Discover,按心情找片还能屏蔽不想看的推荐
国行 Apple 智能开启测试,Siri、写作工具与视觉智能接入千问
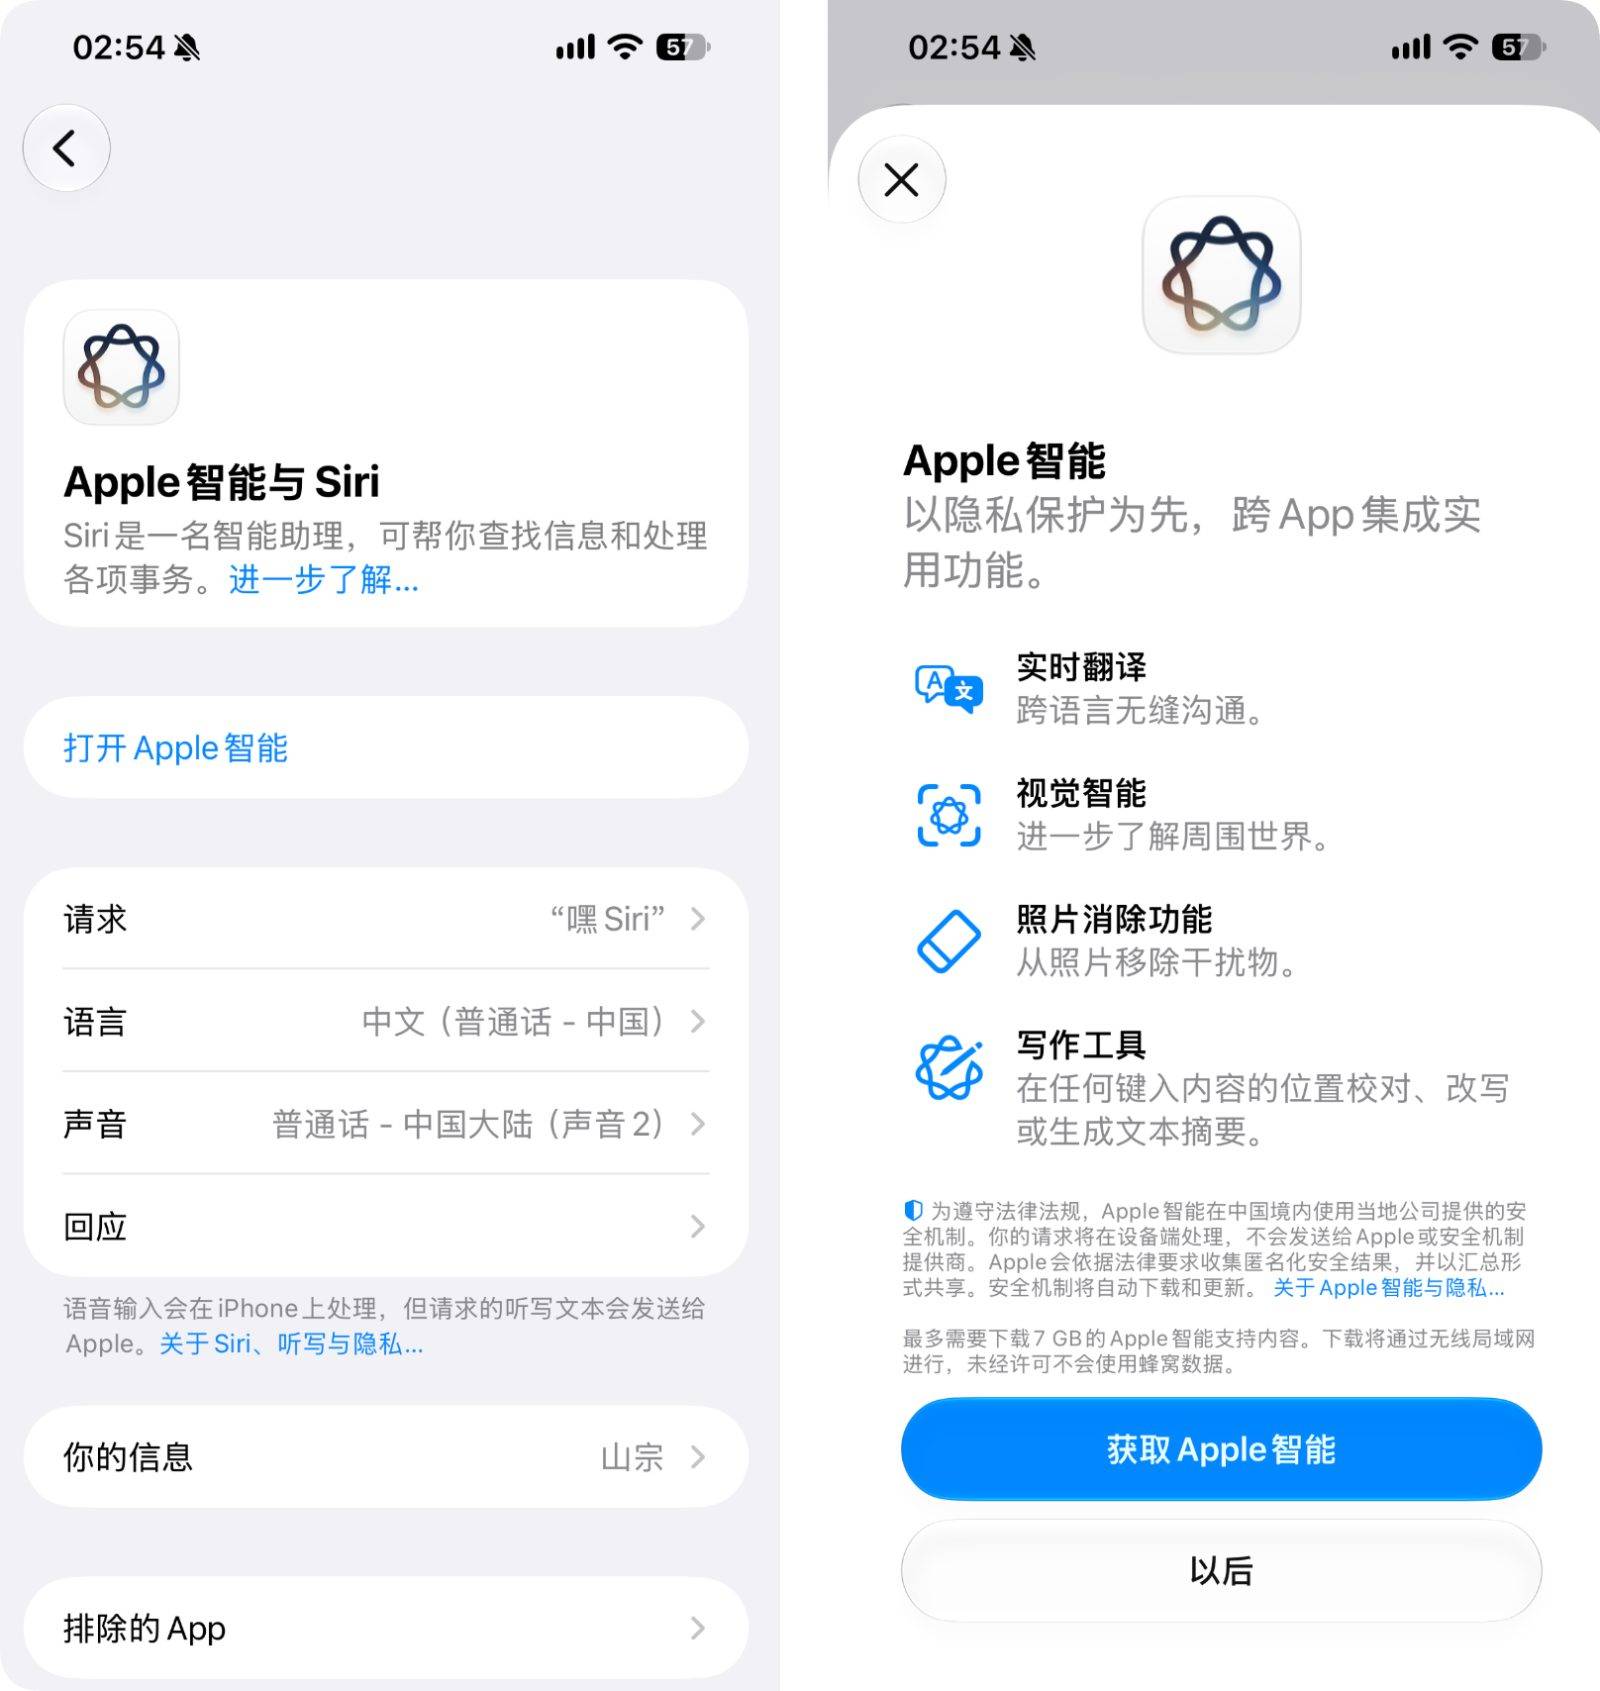
今天凌晨,苹果推送 iOS 27.3 首个开发者测试版,国行「Apple 智能与 Siri」开始开放体验。
苹果中文官网列出的首批功能包括写作工具、实时翻译、照片消除、智绘表情及通知摘要。
千问被整合进 Siri、视觉智能和写作工具,用户可在系统内提问、生成文本或处理图像。
据爱范儿实测,视觉智能的以图搜物还接入了百度搜索。Siri 换上环绕屏幕边缘的光晕,并支持双击屏幕底部切换为文字输入。
在 Siri 中,基础问答可直接完成。以「最近总是睡不好」为例,Siri 会调用千问给出通用睡眠建议。
如需更个性化的方案,用户可点击千问 Logo 跳转至千问 App,对话信息会自动同步。据了解,千问可结合用户此前的睡眠记录、运动情况和生活习惯制定改善方案。
实时翻译覆盖信息、电话和 FaceTime,其中电话与 FaceTime 限一对一通话。AirPods 翻译需适配耳机更新至最新固件,并与启用 Apple 智能的 iPhone 配对。
首批功能适用于 iPhone 15 Pro 系列、iPhone 16 全系列及后续机型,以及 iPhone Air、iPhone Duo,Siri 和设备语言须设为简体中文或英语。
值得注意的是,此次国行更新提供的是首批 Apple 智能功能,WWDC 2026 预告的新版 Siri AI 未包含在内。
 相关阅读:

苹果 Apple Music 新增“自唱自拍”功能:一边 K 歌一边录制视频
IT之家 11 月 4 日消息,@aaronp613 今日发现,苹果在 iOS 27.3 开发者测试版中为 Apple Music 上线了一项名为 Selfie Sing 的新功能,允许用户一边跟随屏幕滚动的歌词唱歌,一边使用 iPhone 前置摄像头录制视频,并在录制完成后调整人声效果、保存或分享视频。
Selfie Sing 是苹果对现有 Apple Music 卡拉 OK 功能的进一步扩展。此前,Apple Music 的 K 歌模式已支持降低歌曲原唱音量,并通过高亮显示的同步歌词帮助用户跟唱。新增的 Selfie Sing 则将视频录制功能整合进音乐播放界面。
升级到 iOS 27.3 测试版后,用户在 Apple Music 中播放支持 Selfie Sing 的歌曲后,可以在歌曲的人声音量控制下方找到新的摄像头按钮。点击后即可进入视频录制界面,屏幕会同步滚动显示歌词,录制的视频采用竖屏格式。
歌曲播放结束后,用户可以调整自己的声音音量,还能选择 Megaphone(扩音器)、Echo(回声)、Concert Hall(音乐厅)和 Studio(录音室)等效果。完成编辑后,视频可以保存到 iPhone 照片图库,也可以直接分享给其他人。
IT之家注意到,目前 Selfie Sing 并不支持 Apple Music 曲库中的所有歌曲。苹果为这项功能准备了专属歌单,收录了部分适合跟唱的歌曲,包括 Aretha Franklin 的《Respect》、Cyndi Lauper 的《Girls Just Wanna Have Fun》、Madonna 的《Like a Virgin》、Oasis 的《Wonderwall》以及 Britney Spears 的《Baby One More Time》等。
值得注意的是,运行 iOS 27.2 的 iPhone 也可以看到 Selfie Sing 专属歌单,但只有升级到 iOS 27.3 测试版才能调用前置摄像头录制视频。
在此之前,苹果此前也曾通过 Clips 应用尝试提供面向社交平台的视频创作功能。此次将自拍录制与卡拉 OK 功能直接整合进 Apple Music,用户无需切换应用即可完成跟唱和视频分享。
上海RPG|2026城市形象创意短片
科创50跌2.5%,AI漫剧、电池产业链爆发,“易中天”集体下跌,恒科指涨近1%,权重科网股局部上涨
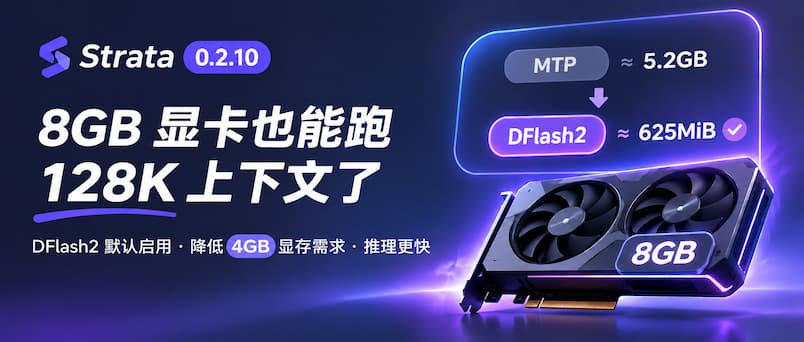
Strata 0.2.10 发布:本地 AI 大模型继续提速,默认使用 DFlash2 降低显存需求,8GB 显卡也能开启 128K 上下文
之前小众软件多次介绍过 Strata:这款开源工具可以让普通电脑,尤其是显存有限的消费级显卡,也能运行参数规模惊人的本地 AI 大模型,比如 Qwen3.8、Qwen-Flash-Next、DeepSeek 4.1 Flash 等模型。@Appinn
Strata 0.2.10 发布,这次带来了几项值得关注的改进:新的 DFlash2 推测解码器成为默认选项(降低4GB显存需求),8GB 显卡也能启动 128K 长上下文,多显卡推理速度大幅提升,还加入了一个专门针对编程任务优化的 DeepSeek 模型。
Strata 交流微信群
青小蛙拉了个交流 Strata 微信群,感兴趣的同学可以扫码入群:
8GB 显卡,也能开启 128K 上下文
以前在 8GB 显卡下,开启 64K 上下文会耗尽专家缓存空间,导致启动失败。只能改用 CPU 图像处理、更小的 KV 缓存,或将上下文降到约 48K。
Strata 0.2.10 改进了这套机制:当显存不足时,优先调整显存和内存之间的数据分配,尽可能保留用户设置的上下文长度。
比如,现在可以在 8GB 显存条件下启动 Qwen3.8 IQ3_S,并保持 128K 上下文,也就是 131,072 Token。
Strata 会根据显存余量,逐步缩小驻留在 GPU 中的 KV 缓存窗口,必要时还会调整其他缓存,甚至将部分数据放到系统内存中。
官方测试中:
- 8GB 显存限制下,DFlash2 模式生成速度达到 63~73 Token/s。
- 32K Token 的提示词处理时间为 19.8 秒。
- 一张真正的 Intel Arc A750 8GB 显卡,也成功启动 128K 上下文,生成速度为 12.7~14.8 Token/s。
注意,显存需求仍然在,不是凭空消失,而是把压力给到了内存和 SSD。
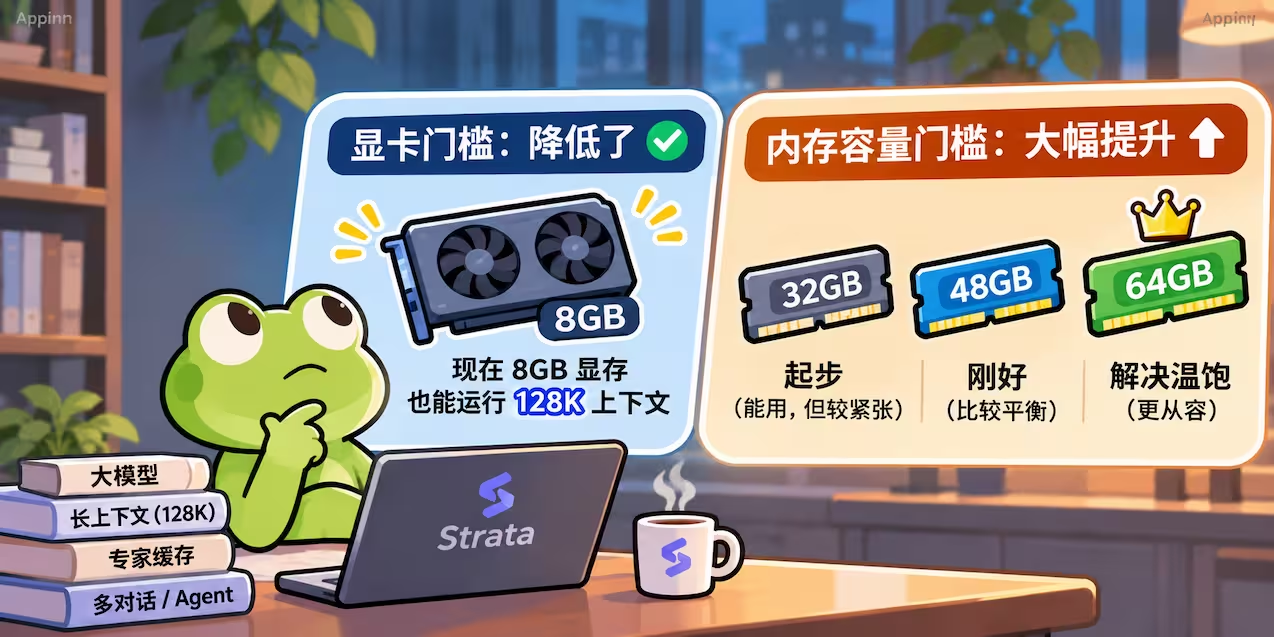
所以青小蛙认为,Strata 降低的只有显卡门槛,但却大大提升了内存容量门槛。
基本上,内存:32G起步,48G刚好,64G才算解决温饱。
DFlash2 成为默认加速器,还能额外节省 4GB 显存
Strata 0.2.10 将 DFlash2 设置为默认加速器。
DFlash2 是一种推测解码器。简单理解,就是让一个体积较小的辅助模型提前猜测接下来可能生成的内容,再交给主模型批量验证。猜对的部分越多,主模型就越有机会一次确认多个 Token,从而加快生成速度。
此前 Strata 使用的 MTP 推测层大约需要 5.2GB 空间,而新版 DFlash2 的显存占用约为 625MiB。
官方对比了同一引擎下 DFlash2 和 MTP 的表现:
| 测试设备 | 模型 | 生成速度提升 |
|---|---|---|
| Ryzen AI Max(Windows) | IQ3_S | 短回复 +8.4% |
| RTX PRO 5000 | IQ3_S | 短回复 +6.23% |
| Apple M5 Max | IQ3_S | +3.8% |
| DGX Spark | IQ3_S | +5.8% |
但是,也不是没有代价。
DFlash2 与 MTP 对比
相比之下,MTP 在硬件兼容性和多并发下都有优势:
| 对比项目 | DFlash2 | MTP |
|---|---|---|
| 显存占用 | 约 625MiB | 约 5.2GB |
| 额外文件 | 首次下载约 1.2GB | 推测层约 5.2GB |
| 单请求生成速度 | 多数官方测试更快 | 部分硬件更快 |
| 多并发 | 主要面向单请求 | 更适合多请求 |
| 低显存设备 | 优势明显 | 显存压力较大 |
| 支持范围 | 依赖特定模型与引擎 | 兼容范围更广 |
| Strata 0.2.10 默认策略 | 单请求 Qwen3.8 优先 | 多并发等场景优先 |
两张显卡一起跑,代码编辑速度接近翻倍
针对多显卡,这次更新带来优化:All-cards Split Engine。
以前多显卡运行模型时,常见做法是将模型的不同层分配到不同显卡。新的方式则允许多张显卡共同处理每一层模型,让它们同时参与计算。
官方使用两张 RTX A6000,在 Linux 下运行 UD-Q4_K_XL,得到以下结果:
| 测试任务 | 原来的速度 | 新版速度 |
|---|---|---|
| 代码编辑 | 195 Token/s | 377~394 Token/s |
| 生成新代码 | 139~144 Token/s | 189~232 Token/s |
| 普通文本 | 93 Token/s | 139~146 Token/s |
| Agent 循环 | 112~119 Token/s | 165 Token/s |
代码编辑任务的生成速度几乎翻倍。
还加入了一个编程专用的 DeepSeek 模型
Strata 0.2.10 新增了 ISTA-DAS Coder。它基于 DeepSeek-V4.1-Flash,针对编程和 Agent 任务进行了专家裁剪,每层只保留原来 384 个专家中的 192 个。
这样可以减少需要处理的专家权重。
官方测试中:
- 单张 Radeon AI PRO R9700:22.8 Token/s。
- 四张 R9700:59.2 Token/s。
- Apple M5 Max:19.1~22.5 Token/s。
- RTX PRO 6000 Blackwell:约 100 Token/s。
不过,这个模型的存储需求依然很大,仅模型权重就有约 72.1GB,另有约 110.6GB 的 Engram 数据文件,首次完整下载约需 191GB。
Agent 用户也迎来一批实用修复
除了推理性能,这次 Strata 还修复了不少图形界面和 Agent 相关问题。
比如:
- AI 回复很长时,Approve 和 Deny 审批按钮不再被滚动到看不见的位置。
- 子 Agent 可以接收用户追加的指令。
- 历史对话自动摘要现在会尽量使用用户原本的语言。
- AI 正在生成内容时,可以选择等待、排队发送新消息或者中断。
- 支持引用之前的某轮对话或选中的文字。
- 改善 Claude Code 遇到上下文溢出时的错误提示,让它能够尝试压缩上下文。
另外,Strata 也修复了 Windows 某些后台启动场景下,磁盘读取优先级过低、导致模型加载明显变慢的问题。
下载与更新
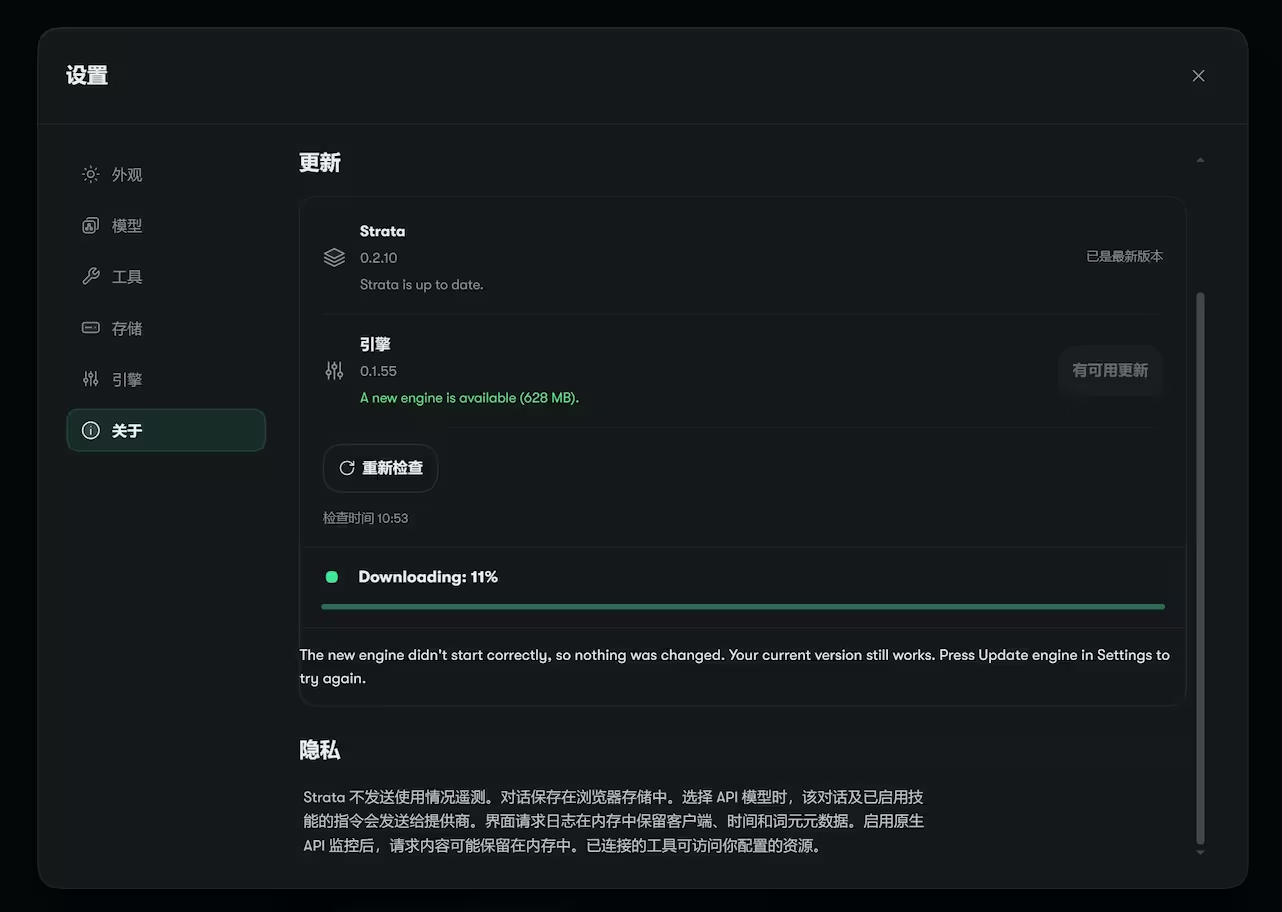
Strata 免费、开源,提供 Windows、macOS 和 Linux 版本。本次更新后 Strata 版本为 0.2.10,引擎版本 0.1.56。这两者都需要单独更新。
依旧,Strata 图形界面用户可以直接更新:
终端版用户可以运行:
strata update
项目地址: https://github.com/Niko1221/Strata
另外,每次升级都需要下载不小的文件,好慢啊。
原文:https://www.appinn.com/strata-0-2-10/
相关阅读
[分享创造] 用 Cloudflare 免费额度搭域名邮箱后,我顺手给它写了个原生 iOS 客户端
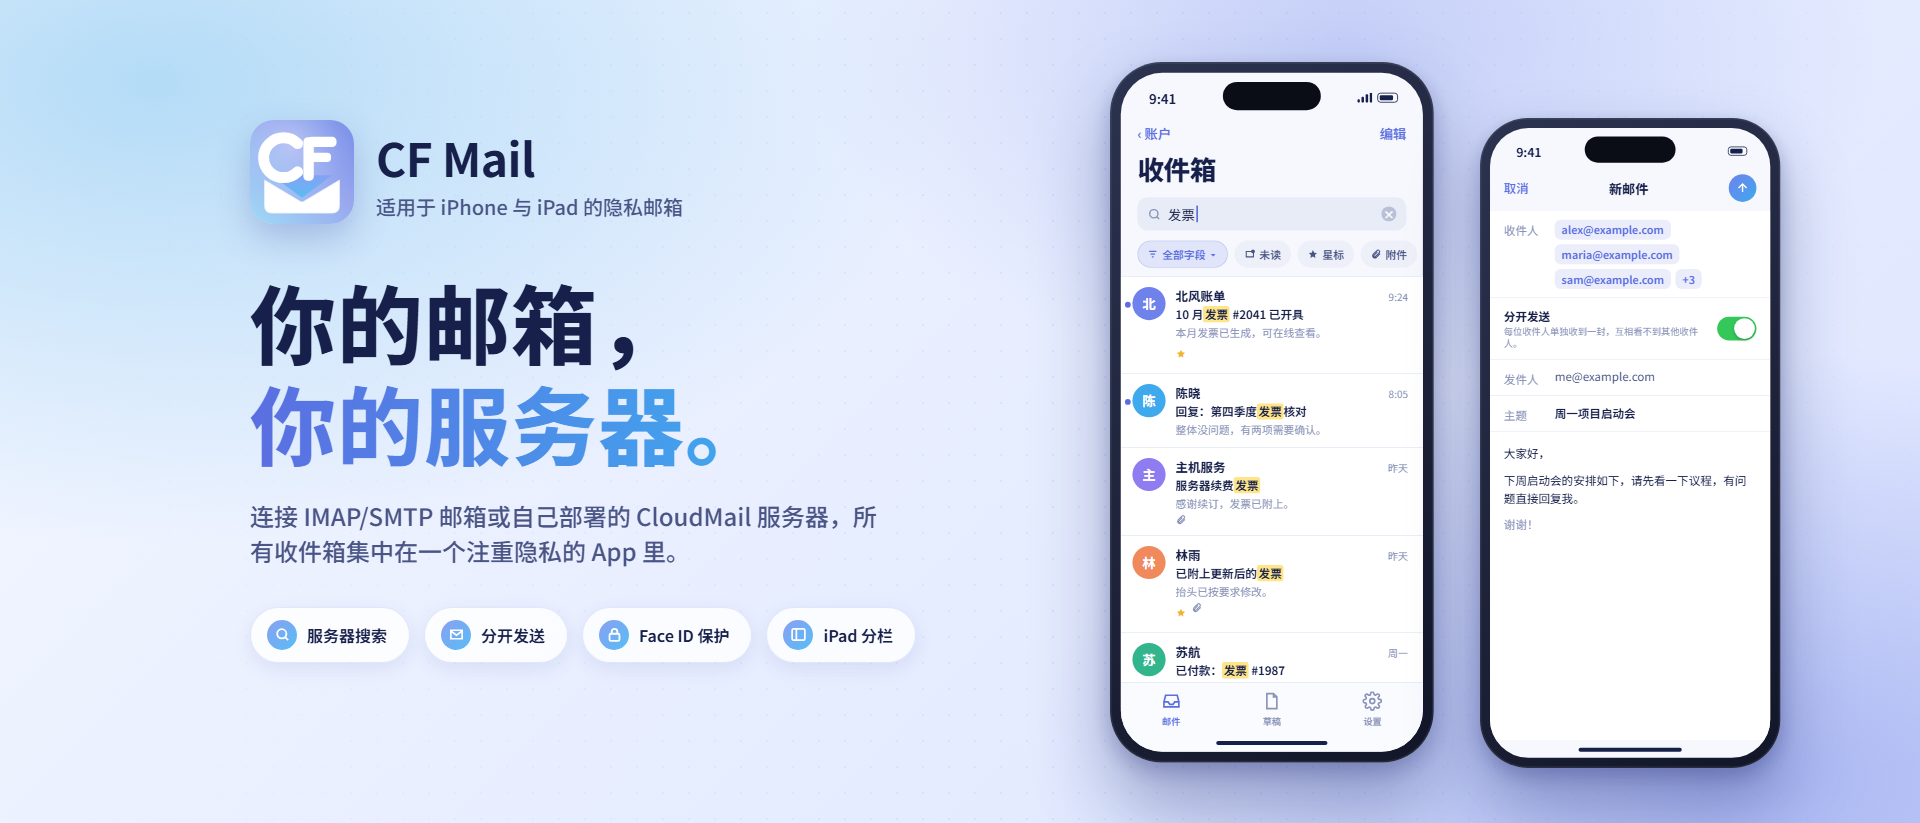
大家好,分享一个自己做了挺久的东西:CF Mail,一个原生 SwiftUI 写的 iPhone / iPad 邮件客户端。
起因
之前用 maillab/cloud-mail 在 Cloudflare 上搭了域名邮箱。Worker + D1 + Email Routing ,基本零成本,一个域名可以开无限个地址,注册各种服务时一个站一个邮箱,很爽。
问题是手机上只能开网页版,没有推送,也没法和 Gmail 、QQ 这些常用邮箱放在一起看。系统自带的「邮件」 App 又连不上它(它没有 IMAP )。所以就自己写了一个客户端,顺带把服务端也改了一版。
能干什么
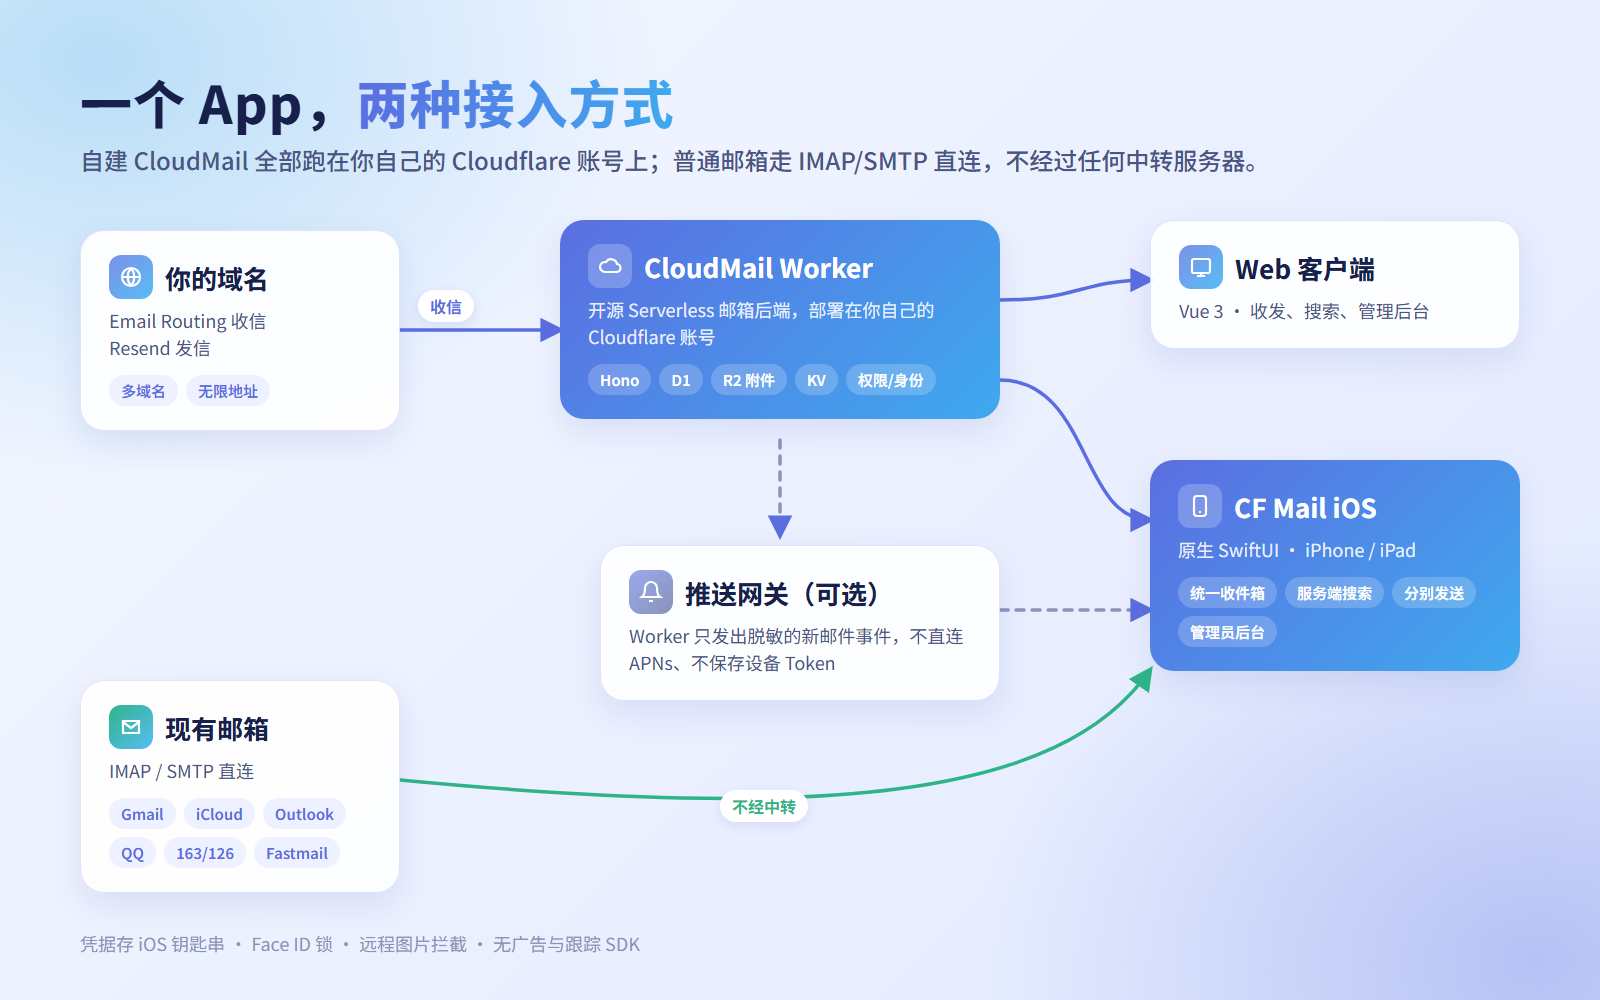
两种账户放在一个 App 里:
- 普通邮箱:走 IMAP/SMTP 直连,已经内置了 Gmail 、iCloud 、Outlook 、Yahoo 、Fastmail 、QQ/Foxmail 、163/126/yeah 等服务商的预设。QQ 和网易会提示你用「授权码」,不用自己去查服务器地址。「收件箱、已发送、草稿箱、已删除」这些中文文件夹名会自动识别。
- 自建 CloudMail:填上你的 Worker 地址就能用。如果你有管理员权限,App 里还能直接管用户、角色权限、邀请码、全部邮件和系统设置,不用再开电脑。
其他功能:
- 统一收件箱,以及服务端搜索:可以按主题、正文、发件人、收件人来搜
- 分开发送:群发时每个收件人各自收到一封,互相看不到对方,发通知、发邀请很好用
- 富文本编辑、附件、草稿、联系人,回复和转发
- iPad 分栏布局,大屏上列表和正文可以同时看
- 新邮件推送( CloudMail 账户,可选)
隐私这块我比较在意
- 没有广告,没有第三方统计或跟踪 SDK ,也不需要注册 CF Mail 账号
- 账号凭据只存在 iOS 钥匙串里,可以用 Face ID / Touch ID 锁住 App
- 远程图片可以设成默认拦截、每封邮件询问或始终加载,防追踪像素
- IMAP 邮箱是手机直连邮件服务器,中间不经过我的任何服务器
- 推送走一个独立的网关。自建的 Worker 只发「有新邮件」这类脱敏事件,不直连 APNs ,也不保存设备 Token
- 诊断日志只存在本地,并且做了脱敏,只有你手动导出时才会离开手机
服务端也开源了
我在上游基础上维护了一个分支:CF Mail cloud-mail
主要改动有:安全加固(初始化保护、Webhook 签名、密钥加密存储、会话加固)、CC/BCC 、更多邮件 API 、通知钩子、数据库迁移保护,以及一套部署前的契约测试。
用一个域名加一个 Cloudflare 账号就能跑起来,个人用基本在免费额度内。
收费说明
先说清楚,App 有内购:
- 免费版:1 个 CloudMail 服务器(每个服务器 1 个身份),加最多 10 个 IMAP/SMTP 邮箱,所有功能都能用
- Pro:不限服务器和账户数量,有订阅版和买断版,价格以 App Store 显示为准 [可在这里写具体价格]
个人用的话,免费版应该就够了。
下载
- App Store: [ https://apps.apple.com/us/app/cf-mail-self-hosted-email/id6798590577 ]
- 目前没上架国区,只能用外区 ID 下载
- 要求 iOS 16 及以上
还在持续迭代,欢迎大家提 bug 和需求,帖子里回复或者去 GitHub 提 issue 都可以。在 V2EX 回复里留言想要的功能,我会优先考虑 🙏

莱芒生物:用1‰剂量,重写CAR-T的成本和疗效公式
持续受到肿瘤抗原刺激累到极致的CAR-T细胞,再给它们免疫刺激信号已经没有用了,莱芒找到了一个“违反直觉”的办法。 作者丨周蕾
编辑丨岑峰
【编者按】被誉为“医药界诺贝尔奖”的美国盖伦奖(Prix Galien USA),于10月29日公布2026年度获奖名单。
值得注意的是,晶泰科技孵化的创新企业已连续两年入围该奖项提名。去年,希格生科凭借与晶泰科技合作开发的全球首款弥漫性胃癌靶向药SIGX1094获得“最佳生物技术产品”提名;今年,莱芒生物与默达生物双双入围“最佳初创公司”提名。前者在晶泰科技的研发助力下,以千分之一常规剂量的代谢增强型CAR-T疗法,实现数十位复发难治性血液瘤与红斑狼疮患者完全缓解出院(100% CR);后者则与晶泰科技合作研发了全球首款口服乳酸脱氢酶A(LDHA)抑制剂MP-5342,临床前数据显示其安全窗口超600倍,瞄准全球超千亿美元的自免市场。
在奖项揭晓之后,雷峰网AI科技评论先后与希格生科、莱芒生物、默达生物进行了深度对话,以下是莱芒生物篇。
千分之一。
这是莱芒生物核心产品META 10-19目前在早期临床研究使用的最低给药剂量,仅有常规CAR-T产品给药剂量的1‰,相当于2000个细胞每千克病人体重。
CAR-T疗法的原理并不复杂:医生从患者体内提取T细胞,改造后让它们变成识别特别靶抗原的“特种兵”,再回输到体内,精准打击癌细胞。
按行业常识,CAR-T的疗效依赖足量细胞回输,剂量砍到千分之一,疗效理应所剩无几。但莱芒的代谢增强型CAR-T产品即使在极低给药剂量情况下依然展示出了突破性的疗效:在这款产品的IIT(研究者发起的临床研究)中,数十例复发难治性白血病、淋巴瘤患者接受治疗后,完全缓解率达到100%(100% CR);在弥漫大B细胞淋巴瘤(DLBCL)患者中,12个月完全缓解率仍保持在77.8%。
“我觉得评委最看重的,还是突破性技术带来的疗效跨越式提升。”全程参与盖伦奖申报的莱芒生物商务副总裁仝督读说,“底层突破技术、很好的临床数据,加上低剂量带来的更好安全性、更低生产成本、更短生产周期,这些优势结合在一起,我觉得是我们受到行业关注、特别是这次入围盖伦奖的主要原因。”
白细胞介素10(IL-10)在免疫学教科书里是一个免疫抑制因子,但莱芒的创始团队发现它能特异性地作用于终末耗竭的T细胞,通过氧化磷酸化代谢的方式逆转T细胞耗竭,恢复其增殖能力、杀伤活性和免疫记忆。莱芒生物由瑞士洛桑联邦理工学院(EPFL)唐力教授团队联合晶泰科技创立,基于免疫代谢重编程这一核心机制开发代谢增强型免疫疗法,相关基础研究成果和临床结果已发表于Nature、Nature Biotechnology、Nature Immunology、Lancet Haematology和JAMA Oncology等国际顶级期刊。
“处于终末耗竭状态的T细胞,可以理解为一个持续工作的打工人,已经非常累了。这时候你再给他画大饼、正向刺激,他已经没反应了,得给他做代谢调控,让他休息一下、恢复扩增能力和可持续的杀伤能力。”仝督读打了个比方。
他告诉AI科技评论,最早对外讲这个机制时,质疑声不断:IL-10不是免疫抑制因子吗,怎么能够促进CAR-T发挥抗肿瘤作用?但是莱芒最终以真实世界的临床数据有力地回应了质疑。
在临床研究之初,莱芒的研究团队计划从5%常规CAR-T剂量开始向上逐渐爬坡,结果发现第一个剂量组的患者在回输后,体内CAR-T细胞的扩增峰值占比超过80%,疗效极好。团队便调整了临床研究方案,向下探索了更低的给药剂量:2.5%、1%、0.25%,一直降到1‰。
剂量降低直接改写了CAR-T的经济学。早期CAR-T单次生产成本就高达五六十万元,终端到患者则达120万元左右“一针”。随着技术进步和国产替代,行业内CAR-T生产成本普遍降到二三十万左右。而莱芒通过低剂量策略和生产工艺优化,手工生产已将成本控制在10万元以内;莱芒还自主研发了一套小型全封闭自动化生产设备,未来有望将生产成本进一步降至5万元以下,同时生产周期大幅缩短,为CAR-T走向平价可及提供了空间。
注册与管线层面,莱芒在2024年底启动IND申报后节奏明显加快:2026年上半年先后拿到FDA两项IND批件(血液肿瘤与自免适应症),9月再获CDE三项IND默示许可,中美双报落地。第一条管线之外,靶向多发性骨髓瘤的BCMA CAR-T和靶向肝癌、胃癌、脑胶质瘤的实体瘤管线均已进入IIT临床研究阶段。
与晶泰的合作,贯穿了莱芒从早期设计到临床回溯的全链条。代谢增强因子IL-10的亲和力优化,晶泰的AI平台两周就交出第一批设计结果;在靶向结直肠癌的实体瘤CAR-T项目中,面对“肿瘤突变抗原与正常抗原只差一个氨基酸”的细微差别,晶泰的AI模型也同样在迭代优化后给出了可以实现高精度特异性结合和优选抗体序列。
更值得关注的,是AI在临床样本分析中的应用