美民主党料近40年首获得州联邦参议院席位和州长职位

经典版ChatGPT将在明年1月停用 用户需升级到ChatGPT&Codex整合版
苹果更新开发者规则要求月约会和AI恋爱陪伴应用最低分级18+ 即必须成年人才能使用
好功能!谷歌为安卓推出照片/视频自动备份 通过快速共享直接保存到Windows PC
Windows 11新增还原摘要功能:在新设备或重装系统还原配置后 可检查缺失哪些应用

[分享创造] WebDAV Lite 1.2.0:菜单栏一键把 Mac 文件夹变成 WebDAV 服务器,新版本支持浏览器直接管理文件
V2EX 的朋友们好,之前在社区分享过几个 macOS 小工具。
这次分享 WebDAV Lite 的 1.2.0 大版本更新。做这个工具的初衷很简单:经常 需要把 Mac 里的电影推到 Apple TV ( Infuse )、把文件传到 iPad ,微信传文件 又慢又压缩画质,所以做了这个菜单栏 app——一键把任意文件夹变成局域网 WebDAV 服务器。
1.2.0 新增的能力:
- 浏览器直接管理文件:手机/平板开个网页就能上传、重命名、删除、建文件夹
- 网页内直接预览照片、视频、音乐、PDF ,文件夹可打包 ZIP 下载
- 兼容 Finder (⌘K 连接)、iOS 文件 App 、Infuse 、VLC 、Windows 资源管理器
- 可选密码保护 + HTTPS ,纯局域网,数据不出你的路由器
免费版就能用(只读共享); Pro 是一次性买断,本周限时 ¥15 。
下载地址
Mac App Store: https://apps.apple.com/us/app/id6779282964 (国区搜「 WebDAV Lite 局域网服务器」,Pro 限时 ¥15 )
系统要求 macOS 14.6+,Apple Silicon / Intel 原生支持。用 AnyData/流媒体 场景遇到问题的欢迎在回复里提,我基本都在。
[推广] [🎁附福利] 静态 ISP 和 动态住宅代理怎么选?适用行业介绍
静态( ISP )住宅代理有哪些应用场景?
-
社交媒体营销
在不同的账号之间切换,收集公开的社交媒体平台数据。 -
电子商务账户管理
进入市场,将您的产品或服务带给新的受众。 -
SEO 监控
收集最新的搜索引擎数据,进行关键词研究,并跟踪排名。 -
价格和旅行信息聚合
更快地从多个来源收集实时价格和可用性数据。 -
广告技术任务
运行广告验证和效果分析任务,确保您的广告展示给正确的受众。 -
市场调研
识别用户行为的变化,监测不同行业的价格和发展趋势,并从竞争对手那里收集准确的数据。 -
网络数据收集
绕过反抓取措施和基于 IP 的限制,快速从各种目标收集数据。 -
品牌保护
检测商标侵权行为,监控品牌提及情况,并保持您的品牌形象清晰无瑕。
动态住宅代理有哪些应用场景?
-
数据采集与市场情报 轮换真实住宅 IP ,分散请求来源,降低被封禁或触发验证码的风险;用于公开数据抓取、价格与库存监控、SEO 排名监测等。
-
跨境电商与社媒运营
模拟目标地区普通用户访问,分散账号关联风险;用于多账号管理、本地化页面预览、店铺与内容展示效果核查。 -
广告验证与品牌保护
从目标地区住宅 IP 访问,验证广告展示、落地页可用性和本地化内容;也可用于侵权监测、假冒行为排查和广告欺诈识别。 -
地域访问与隐私保护
突破仅限特定国家或地区开放的内容与服务限制;隐藏真实网络出口,使访问行为更接近普通家庭用户。 -
票务与限量抢购
在限量商品发售或票务抢购时,通过多 IP 分散访问,提升访问成功率并降低单一 IP 被限制的概率。 -
金融与受限数据收集
采集受地域限制或对访问频率敏感的金融、股市等数据,通过轮换 IP 降低访问受限风险。
Zooproxy ——全球领先的高性能代理服务平台
聚合超 1 亿真实 IP 资源,覆盖 195 + 国家和地区。每日动态更新 IP 池,确保节点纯净度与匿名性,为数据采集、跨境业务提供稳定可靠的网络桥梁。
三大核心 IP 服务
- 动态住宅 IP:**$0.38 / GB**,不限 IP 数量
- 静态 ISP 独享 IP:**$0.9 / IP**,不限流量
- 端口无限套餐:**$0.38 / 端口 / 天**,无限流量,不限 IP
✅ 免费测试:提供全功能试用资源,零门槛体验核心服务 ✅ 超值定价:行业标杆级性价比,新老用户专享限时折扣,高流量套餐享额外优惠
| 🎁200MB 动态住宅 IP 兑换码 |
|---|
| WJLH-EREK-LYRQ |
| HAFR-TVWP-US7R |
| 3DSF-UPJU-7GM6 |
| 5V2D-E7U2-CBY4 |
| EN4W-Z6L4-GXX9 |
| AMDM-GCWL-PXER |
| HK4S-7R92-34YB |
| A2KA-TLUY-453L |
| FFJH-YV44-8AB8 |
| 8SKJ-V55J-5XAD |
复制前往控制台 CDK 栏兑换,领不到的留言 👉https://zooproxy.com/?kwd=zsy-v2ex
[程序员] 晚上用 Grok Bot 把我手上的项目全管起来了。
以前是挨个打开 Cursor 和 Codex ,在每个 tab 里一轮一轮地跟它们对话。现在我只对着一个 bot 聊,想到什么说什么,它会自动把事情转给对应负责的 bot 。
负责开发的 bot 会先判断这个任务适合用什么模型,再去创建对应的 Cursor 云端任务:普通发版用 Composer ,做规划用 Opus ,真正写代码用 Grok 4.7 。
这样我的注意力就被释放出来了。我只跟一个 bot 聊,它负责判断任务、分发任务、收集结果、反馈给我,我再接着和它聊、做决策,如此往复。
不用再管一堆 tab ,只管一段对话。
顺着这个思路,我也搭起了自己的产品团队:一个 bot 对应一个产品,各有各的开发习惯,我给它们定了不同的开发规则。比如 iOS 应用,涉及签名或验证的环节,必须连到我本机的 Mac 上操作;普通 Web 开发,在 Grok Bot 自己的云端主机上做就够了。
另外还建了个健康助手。最近总有些健康问题想问,干脆让一个 bot 专门回答这些,并告诉它可以去我的 Notion 和 Dropbox 里查阅、更新健康笔记和健康档案。这样它会越来越了解我。
晚上下班回到小区,我会快走散步半小时,算是做点小有氧。这 30 分钟里我一直在跟 Grok Bot 打电话,聊各种想到的问题,大多是提前记在 Todoist 待办里的:看到的好点子、好项目,想聊的、想调研的工作,就趁这个时候一个个跟它聊。
Grok Bot 的语音模式回复简短又快,很适合打电话聊。不像文字模式那样甩给我一大段文本,语音里它的回答往往很精炼,应该是专门优化过的。
用 Personal Agent 最大的感受是:碎片时间终于被用起来了。散步的时候打个电话聊聊天,调研、写作、记笔记、做开发、清理邮件,聊着聊着就都做完了。
人在散步,事情也在往前推进。
真的有点贾维斯的感觉了。
[分享创造] 用 Astro + microfeed 搭了一个中英日三语技术博客,外加一档每日 AI 新闻播客,分享流程和踩坑
-
为什么做:想每天用中文、英文、日文同时看一份 AI / 开发者新闻摘要,再配一个通勤能听的音频版。
-
Surfing (surfing.salty.vip):Astro 站点,部署在 Cloudflare ,三语( zh/en/ja ),有 hreflang 和 RSS ;里面的「每日 AI 乱炖」是 AI 辅助生成、我审过再发的。
-
咸话咸说(播客):microfeed (跑在 Cloudflare 上,已升到 1.0.13 ),每日更新;已上 Apple Podcasts 、Spotify 、小宇宙、YouTube 等。
-
流程:选题 → AI 辅助起草 → 我审稿 → 配音 → 发布(用自己的 knowledge-kit 流水线)。
-
踩坑:三语 sitemap 和 hreflang 、microfeed 的 SEO 限制、怎么标注 AI 辅助内容、Cloudflare Worker cron 的 CPU 超限。
-
求反馈(内容质量、三语体验、播客音质),不求流量。
地址参看这里
[分享创造] ChatGPT 网页版没目录?我搞定了 500+ 轮完整目录,还能导航和搜索!
ChatGPT 网页版我觉得是真的聪明,而且不用操心 token ,我超级爱用,一聊就是几百轮。可惜听说以后可能要合并额度了,不知道还能不能继续这么愉快地聊天了。
8 月底那次改版以后,官方目录就经常出问题。有时候只显示一部分,有时候干脆没了。
短对话还好,长对话就真的难受。我有些对话几百轮,光靠滚动页面基本没戏。
于是就开始折腾怎么把目录完整弄出来。
一开始想得挺简单,不就是把用户提问和 AI 回答里的标题抓出来吗?
但是 ChatGPT 长对话的历史消息不是一次性全部加载出来的。
我当时观察到,8 月 23 日之后,页面实际渲染出来的用户提问有时候只有 5 条左右,右侧目录甚至只剩下 2 ~ 5 条。
直接从当前页面提取,肯定拿不到完整目录。
后来就改成分批去拿历史内容,每拿到一批就先缓存,再跟之前的数据合并。不能每次刷新都从头来,更不能把之前已经拿到的目录弄丢。
听起来也不复杂,但实际做的时候各种坑。
而且不能只是把目录生成一次就完事,还得一边保留旧目录,一边把新产生的内容补进去。用户继续聊天,目录也要跟着更新。
这块来回折腾了不少次。
目前我自己实测过 500 轮问答,也就是 500 个用户提问,加上对应的 500 个 AI 回答, 合计 1000 条消息,目录可以导航准确无误。
但我觉得 AI 的回答还是太长了。为了更好地找到重点,我又给 AI 的回答做了二级目录,一级是用户提问,二级是 AI 回答中的标题。继续聊天时,目录也会跟着更新。
我以为这下高枕无忧了,肯定能找到重点了。
结果又发现一个问题:
500 条一级目录,加上几千条二级标题,眼睛都看花了……
于是又干了个目录检索功能,直接搜关键词,把相关的提问和标题筛出来。
本来以为这下终于可以了,结果又碰到新的坑。
目录里搜到了,点过去却不一定能马上找到对应的内容。因为那条历史消息可能根本还没加载到页面上。
所以现在又在折腾目录跳转和定位,尤其是几百轮长对话的情况。ChatGPT 的页面是活的,他会不停的卸载和挂载新的内容。所以搜索定位不一定靠谱。又狠狠的优化一通,现在即使搜索不能直接跳,知道知道在那条,用目录的导航能力也能跳过去,就是慢一点。远的话可能要 1 分多钟,如果搜索可用时候就很快几秒。
一个目录能折腾几个月。ChatGPT 要让用户真正找到长聊天里的重点,做好还真不容易。
ChatGPT 完整目录导航和目录搜索这些功能,现在已经放到我自己做的 Chrome 浏览器插件 OutlineSave 里了。除了目录和检索,还有高亮、书签、备注、离线 HTML 导出等。不过这次主要还是想聊聊目录的实现。
顺便问一下,独立开发这个 Chrome 插件,做了 10 个月,目前大概 1800 个用户,43 条评价,4.9 星,这个成绩算怎么样?有经验的朋友给点参考。
[分享发现] Qoder 感觉比 WorkBuddy 还强,大家体验怎么样?
昨天看了一篇关于 Agent 的报道,说 Qoder 是用户量最大的 Agent ,这个跟我们的直观感受不太一样,我一直以为 WorkBuddy 才是用户量最大的。
然后我看介绍发现最新版的 Qwen3.8 Flash 在 Qoder 是免费的,于是就下载下来试用,发现 Qoder 跟企微、钉钉的对接比其他同类产品方便很多,我花了几分钟就对接上了,然后又让他学习到我在 Hermes 里总结的一些 Skill ,也都很快搞定了。
最让人惊喜的是它跟钉钉的整合能力,除了可以读取常用的文档、日历之类的,还能读取钉钉的聊天记录,这也太 N 了,想到日常工作基本上在钉钉上沟通,让它总结具体日常工作不是方便很多,于是让它读取我的所有聊天记录分析我的沟通风格,然后它的分析有理有据,非常准确。
绝对算是近期发现的一个很惊艳的产品,也推荐大家可以试用下。
https://qoder.cn/activities?referral_code=EjdmfREDOMwSkyPqca0vgwXdHBICKC8O

[推广] 我用 WorkBuddy + Lexmount 整理了三个岗位,聊聊网页读取之后的核对
代同事分享一篇 WorkBuddy 查招聘信息的使用记录,以下是原文。
三个名字里都带着“AI”的岗位,放到一起看,做的事却差得挺远:一个偏海外增长,一个做企业里的 Agent 平台,一个做游戏中的 AI 模块。
这次我用 WorkBuddy 搭配 Lexmount 云浏览器,把腾讯招聘官网的三个深圳岗位整理成了一张对照表。除了工作内容和要求,表里还留了来源链接和读取日期,方便比较,也方便回查原文。
下面是 2026 年 11 月 3 日重新核对后的结果节选,完整条件另有文件保留。
图 1:11 月 3 日的真实界面,按审校后的内容另行简排。“9s”仅是这一轮排版用时,网页读取和审校另计。
我想试的是,让 WorkBuddy 把到官网找资料这一步也接过去:搜索岗位,打开详情,读完之后再整理。这样交给它的就可以是一个网页任务,不用先把几个页面的内容逐段搬进对话框。
Lexmount 提供的就是其中的网页操作能力。它把浏览器放在云端,让 WorkBuddy 这样的 Agent 调用,完成打开页面、搜索、点击和读取内容等操作。它和 WorkBuddy 各有分工:一个负责操作网页,一个负责安排任务、理解内容和整理结果。产品接入说明
要找到它,可以从 WorkBuddy 的技能广场入手。按官网给出的路径,进入“专家·技能·连接器”,选择“技能”,切到 SkillHub,搜索 lexmount,就能找到“lexmount 云浏览器”这个 Skill。第一次使用还需要按提示完成安装和 Lexmount 官网授权。官方接入说明
我选择这个组合,主要看中两点:能在 WorkBuddy 里通过现成的 Skill 调用;也能实际操作页面,把正文和截图留下来。查招聘资料需要在列表和详情页之间来回查看,正好用得上这些功能,所以先拿三个岗位试。
给 WorkBuddy 的要求,我也拆得很具体:列出岗位名称、地点、主要工作和要求,把优先或加分条件单独放一列。页面没写的信息,就标成“未披露”,不要补猜。
这三个岗位在 10 月 22—23 日整理过一次。11 月 3 日,我又让它先到官网搜索“AI 产品”,再沿着原来的三个链接逐一核对,看看页面有没有变化。
这轮由 WorkBuddy 调用 Lexmount,完成搜索、打开详情和读取正文。执行界面里能看到它调用云浏览器、打开官网的过程。

图 2:11 月 3 日,WorkBuddy 调用 Lexmount 的实际执行界面。
官网的搜索结果里,既有深圳岗位,也有广州等其他城市的岗位。这次还是沿着之前保存的三个深圳岗位链接往下查,范围没有扩大到整份搜索列表。

图 3:11 月 3 日,官网“AI 产品”的搜索结果。81 条是不同城市的总结果数;本次复核的是此前保存的三条链接。
列表里能看到岗位名、地点和一小段职责,但具体要什么经历,还得打开详情。读到正文后,先把岗位名、地点和网址对上,再分别整理工作内容、明确要求、优先条件,读取日期也跟着这一条记录留下来。
这样整理,几个岗位才有了能放在一起比较的内容。想核对某个条件,可以回到对应原文,不必只凭表里的一句概括判断。
不过,能把网页读回来,和能把要求分对,还是两回事。
10 月首次整理时,我另外用 Codex 对照原文审校。它发现,首版表格把一些“优先”条件放进了必需条件。问题反馈给 WorkBuddy 后,表格才改过来。
《三角洲行动》的 AI 产品运营岗,有一句就很容易分错:
有 AI 产品经历,具有游戏 AI 产品实践经验者优先;
“有 AI 产品经历”是要求,游戏 AI 产品实践则是优先条件。整句放进“必需”那一列,读表的人就可能以为,没有游戏 AI 项目经历便不符合要求。
页面顶部还有“两年以上工作经验”的标签,也不能和这句话拼成“两年以上游戏 AI 经验”。原文没有这样写。

图 4:11 月 3 日重新打开的岗位原页。这部分关键要求与 10 月 23 日记录一致。
所以我会把原文留在结果旁边。表格把信息缩短了,有些词却不能顺手省掉。少了一个“优先”,条件就变严了;没写学历,也不能替招聘方写成“学历不限”。这三个岗位的薪资都没有披露,表里就照实保留“未披露”。
来源和日期也用上了。对照 10 月保存的岗位表,原先那条“AI 产品运营”的链接,11 月 3 日打开时,已经变成了“增长产品经理(AI/Agent 方向)”。页面标注更新于 10 月 30 日。
变化也不只是名字。旧要求写的是“3 年以上全球化产品运营、增长经验”,新页面改成了“3 年以上产品经理经验”,并明确提出要具备 Agent/AI 产品设计或策划经验。看工作经历是否匹配时,这个差别不能省略。

图 5:11 月 3 日读取的岗位原页,页面标注更新于 10 月 30 日。上面的变化来自它与 10 月留存记录的对照。
这让我觉得,表格里留一个网址还不够,也得知道内容是什么时候读到的。之后再拿这份资料做判断,就能沿着原链接重新确认,不至于一直用旧要求看新岗位。
最后留下的文件有 CSV 表格和 Markdown 文档。前者可以放进表格软件继续比较,后者方便逐条读完整内容。想仔细看某个岗位,就沿着链接回官网。这次没有登录或投递,岗位是否仍能申请,还需要另外确认。
这套组合也有需要留心的地方。浏览器调用过程中出现过导航报错;WorkBuddy 里也遇到了模型繁忙,重试后才继续完成整理。最后的摘要还有几处要按原文修正。这次仍需要跟进重试、检查结果,暂时还不能把任务交出去就不管。
这次用下来,Lexmount 完成了这几个页面的访问和操作,能和 WorkBuddy 配合,把网页资料带到后面的整理里。对需要在网站里搜索、点开详情、留下原文和截图的任务,这种用法值得继续试。至于省了多少时间、换更多网站是否一样顺利,这次还下不了结论。
只偶尔看两三条岗位,手动打开官网也很合理。如果经常需要把几个网页的内容整理到一起,我会先用这样的小任务试试,并把要求写清楚:
逐条读取这些岗位页面,保留岗位名、来源链接和读取日期。工作内容、岗位要求、优先或加分条件分开整理;即使没有单独的“加分项”标题,也检查正文里的“优先”表述。没写的信息标成“未披露”,不要补猜。整理后对照原文检查,拿不准的地方单独列出来。
新一批岗位还没试过。下次再用,我仍会先核对几条,确认表里的说法对得上原文,再继续往下整理。
[分享创造] 我让 AI 给我 vibe coding 做了一个电视版音乐播放器
这俩日在互联网上发现了一个落雪音乐,然后找到了 Github 作者 SincereXing 写的 walkman-tv ,结果安装上去的一点播放就崩溃,看着反正都是 AI 写的,与其等待别人更新,干脆自己也写了一个,感谢 GPT 、DeepSeek 两位赛博合伙人,我人生第一个电视 App 也开源啦!
开源里没有带任何音乐源,自己在 Github 上找一些 musicfree 协议的订阅就好或者让 AI 写
[Claude] Claude 封号汇总+个人使用和企业内部号池方法(持续更新版)
Claude 封号汇总+个人使用和企业内部号池方法(持续更新版)
https://linux.do/t/topic/2916824 这是我之前发的帖子(方法仍然有效,解决一下住宅 ip 问题)前几天养好的号放进 cpa 号池仍然存活,是 pro 升级到 20x 的,目前有不少反馈 5x 和 20x 订阅报错,这个是 claude 升级了订阅的核对你是卡付款一定要和你的卡是一致的,claude 对高等级订阅核对地址。
之前养号贴用的是 buypersonalproxy ,然后弄 claude 客户端用这个 buypersonalproxy 的 ip 死了 4 个就换了住宅 ip 用的 VIRCS 现在叫 nodemach
用的是虚拟 visa 卡,查了下是美国联邦社区银行的卡 coinepay.net
以上使用的产品纯自用,最重要的差不多就是这几样。
应该有不少人在公司上班,公司都想用 claude 或者几个朋友一起用一个号,cpa 基本都可以解决,但是弄出来的号都需要养,养好了在放到 cpa 才不会封,新号订阅 ip 质量没问题,养号环境,当天订阅,多消耗 token 周额度 10%以上,第二天中午 12 点前没封基本稳定在养一个星期就可以放到 cpa 了,强烈不推荐使用 claude 客户端,用 cli ,我的号基本全是 cli 养出来的,claude 客户端全封没一个存活。
刚刚用海外企业邮箱注册后订阅企业 claude 25 美金一个月的没有 kyc ,网络用的美国梯子 ikuuu ,ads 指纹浏览器,应该是可以继续添加成员,款项应该是直接从企业邮箱车头的卡里出,应该是不用 kyc ,做公司小团队的号池就是不用考虑那么多 kyc 的问题账号问题以及一卡一号,通过车头订阅号坐席,就是没有 max20 额度多。claude 没有 5 小时限额了其实针对企业 100 美金的号也很划算。
持续养号中,有什么问题都可以问我,可以互相交流。
[推广] GPT-6.2 Astra 拳打 Opus 5.5 脚踢 6astra 成本比 6astra 低 60%,将同步官方更新,欢迎 V 佬们来领鸡蛋测试。
吉吉 api ,全网首家主打企业级不降智的 api 中转站,不降智模型源头价格低至 0.15 倍率。
用户 1.7 万,社群 6000 人,发票专票公开一应支持。
回复送测试鸡蛋,欢迎 V 佬来尝试。
OpenAI即将发布新模型?GPT-6.2 Astra曝光
11月2日,多位用户在X发帖称,OpenAI似乎已经开始测试GPT-6.2 Astra模型。目前,OpenAI公开发布的最新模型为GPT-6.1 Terra,还没有推出GPT-6.1 Astra。跟踪AI模型最新动态的X用户Token Gremlin发帖称,OpenAI正在悄悄对一个名为GPT-6.2 Astra的新版本进行A/B测试,而该型号已经出现在Codex的使用情况统计数据中。
阅读全文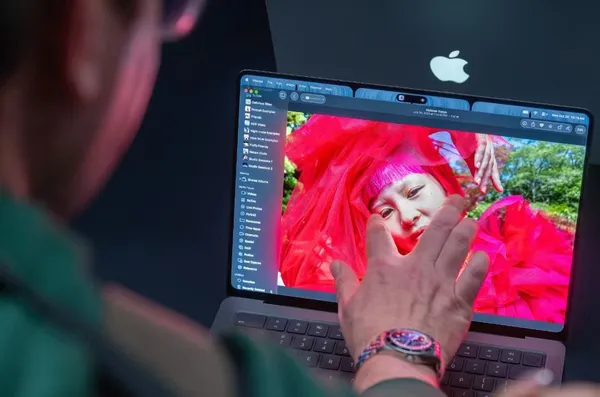
彭博:苹果错失触屏革命机遇 五年来最大变革却被当作常规升级
11月2日,彭博社发文称,苹果原本有机会把Mac上的触摸屏打造成一种全新体验,但是该公司为了稳妥只是把它当成了一次常规升级,并没有提供多少吸引用户使用该功能的理由。
阅读全文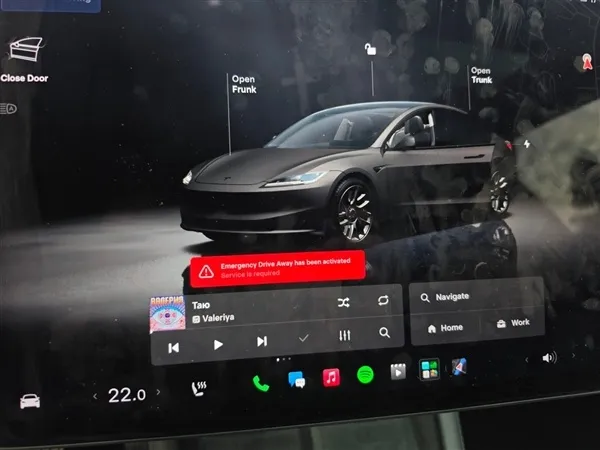
特斯拉新功能可拖着充电枪跑路 但弄坏设施需赔偿高达17万
特斯拉在软件更新2026.38.3中推出了Emergency Drive Away(紧急驶离)功能,允许车主在紧急情况下不拔充电枪直接驶离超充桩,但使用代价相当高昂。特斯拉车辆正常情况下在插枪状态下无法挂挡驶离。新功能上线后,如果车主尝试在插枪时挂挡,触控屏会弹出红色警告,提示“连接超充桩时无法挂挡,激活紧急驶离功能可强制解除”。
阅读全文