
The Interpretable and Effective Graph Neural Additive Networks
Efficient NPN Classification for Large Functions using Graph Neural Network
Apple Releases New AirPods Beta Firmware
There's no word on what's included in the firmware update because Apple doesn't offer notes for AirPods beta releases.
When the AirPods are connected to an iPhone, iPad, or Mac running iOS 26, iPadOS 26, or macOS 26 or later, there is a beta firmware option that can be accessed in the AirPods settings interface. Toggling on beta updates allows users to install the beta firmware.
Firmware updates can then be downloaded by connecting the AirPods to an Apple device and connecting them to power. It can take a few hours for new firmware to be installed because there is no software update option like there is for other Apple devices.
This article, "Apple Releases New AirPods Beta Firmware" first appeared on MacRumors.com
Discuss this article in our forums
GPT-6 Astra 爆改 Qwen 大脑:只动 0.016% 参数,数学成绩疯涨
只改了 0.016% 的权重,一个 8 亿参数大模型的数学成绩,就从 7.9% 飙升到了 48.1%。
更夸张的是,动手修改这些权重的,竟然是另一个大模型 GPT-6 Astra。
最近,MIT CSAIL 的研究团队展示了一种相当大胆的 AI 优化方法。他们让 GPT-6 Astra 像程序员阅读和修改代码一样,直接分析神经网络的权重,定位模型的问题,再修改其中的参数。
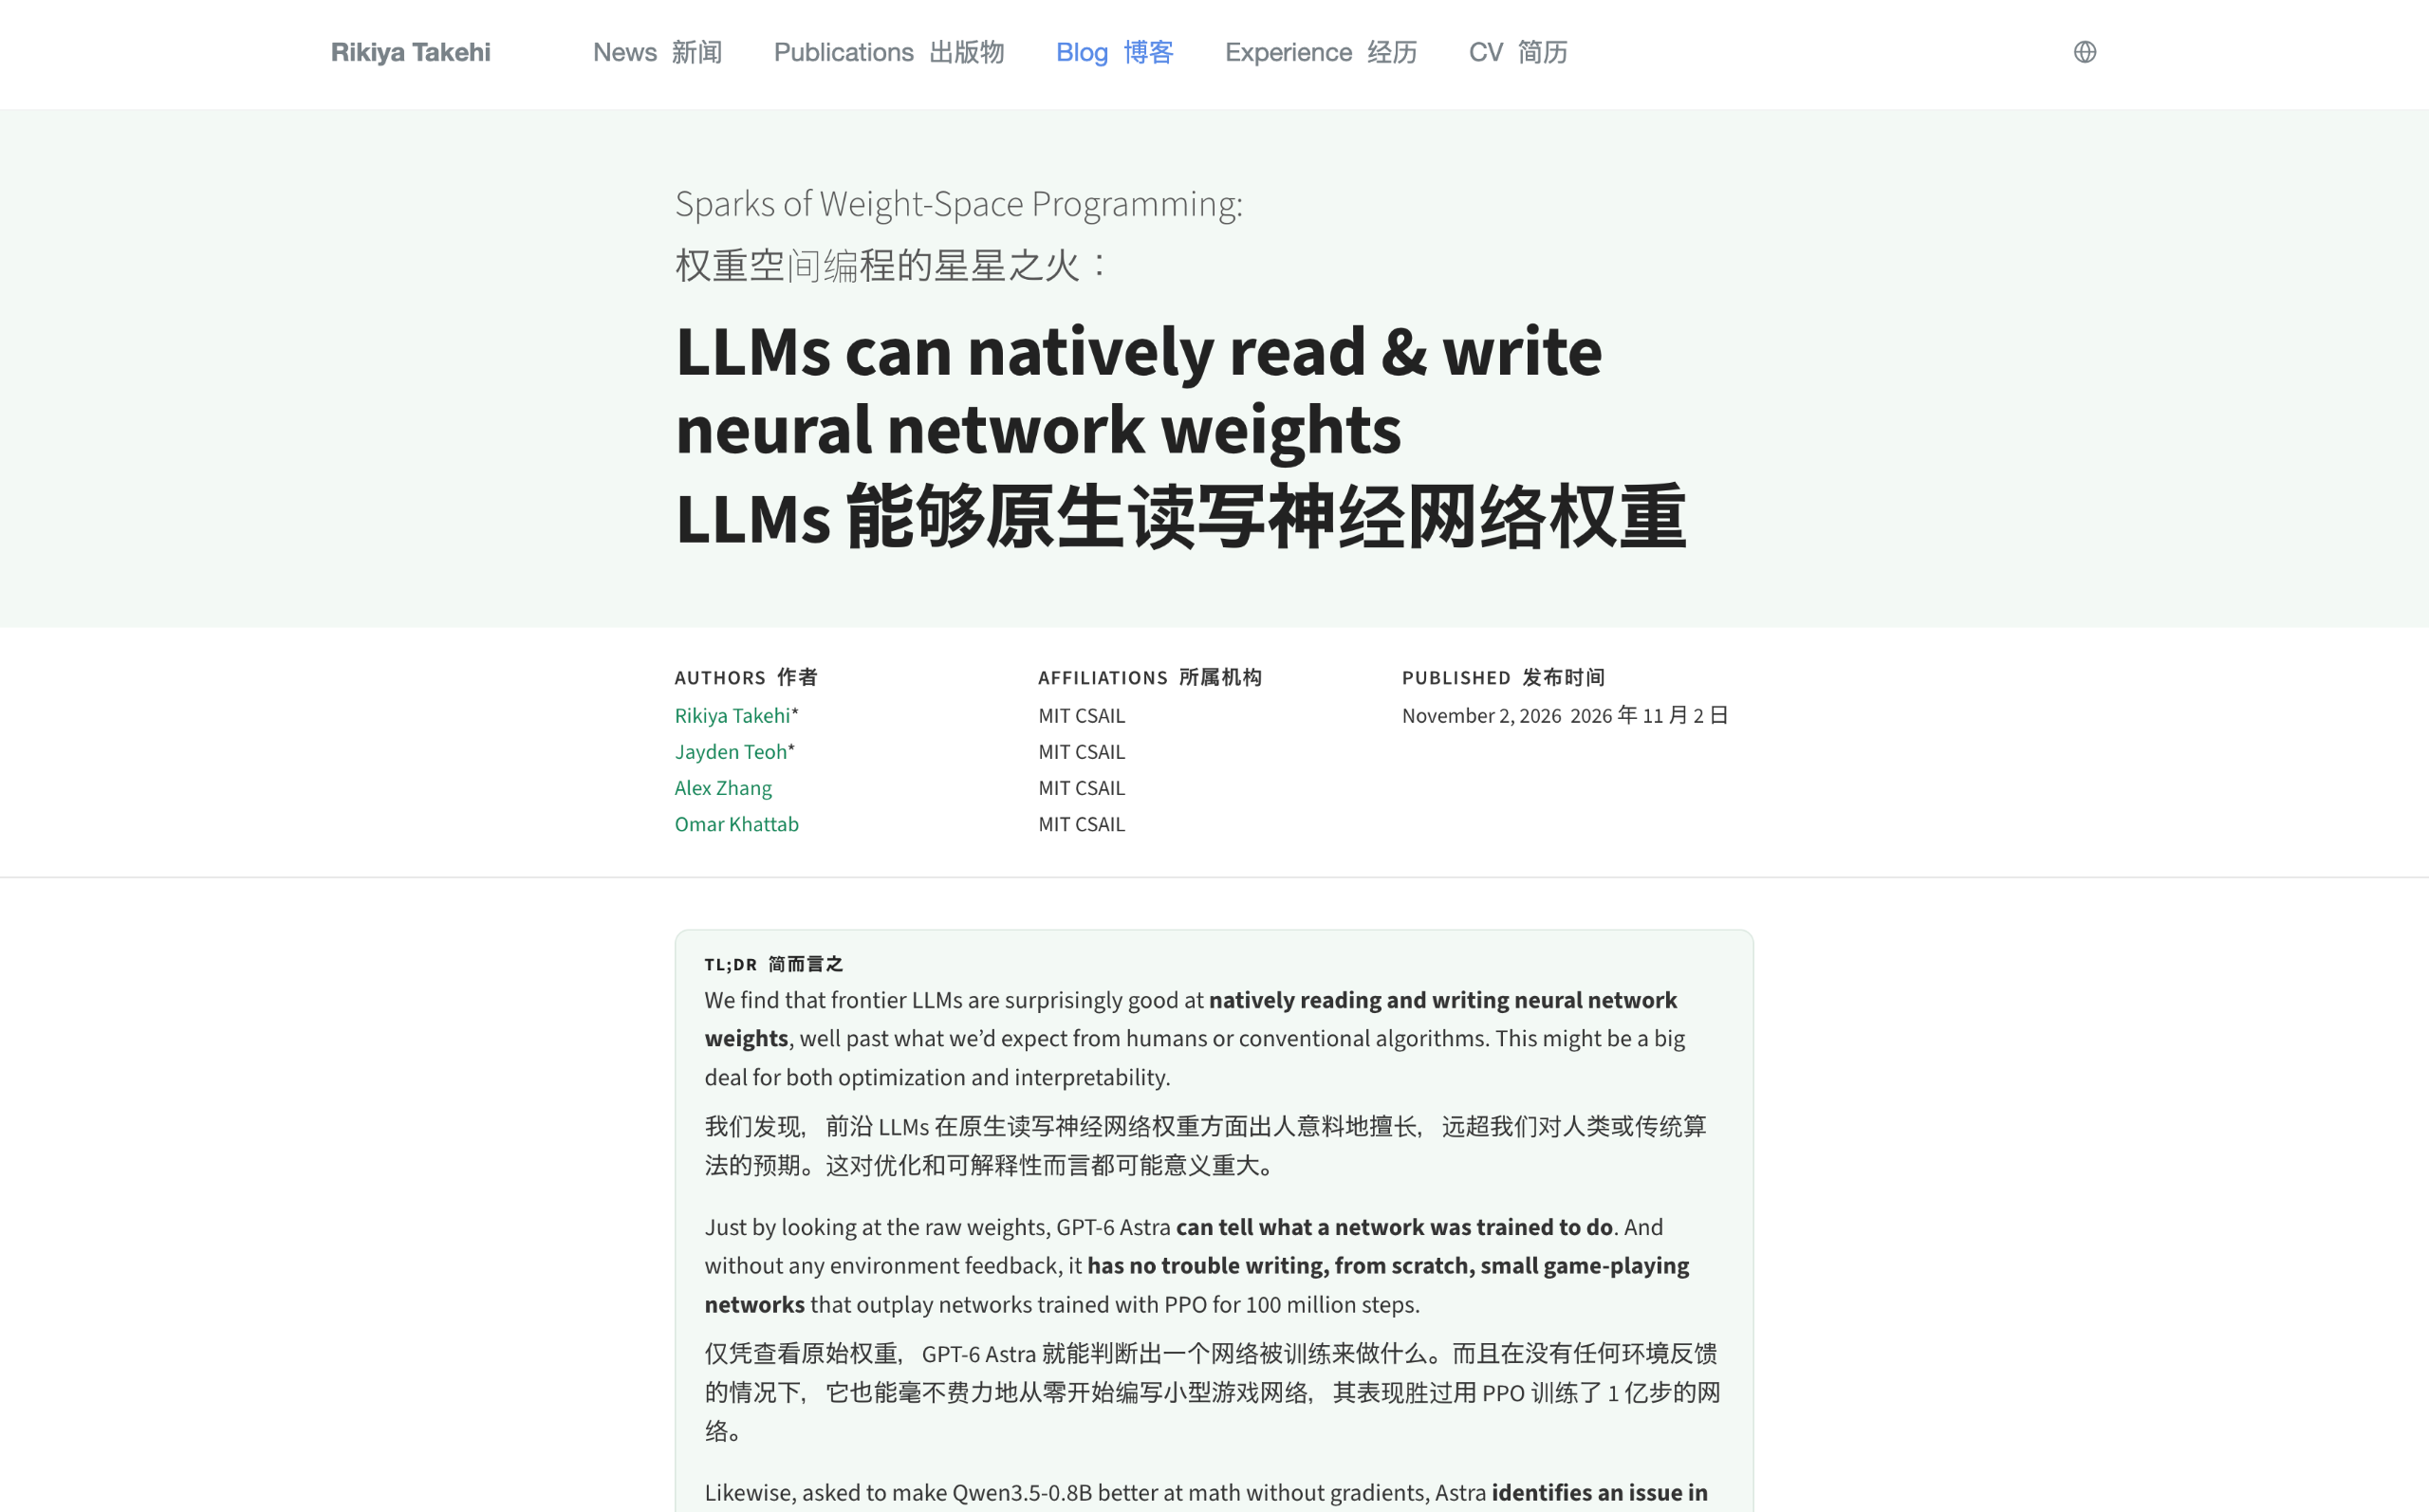
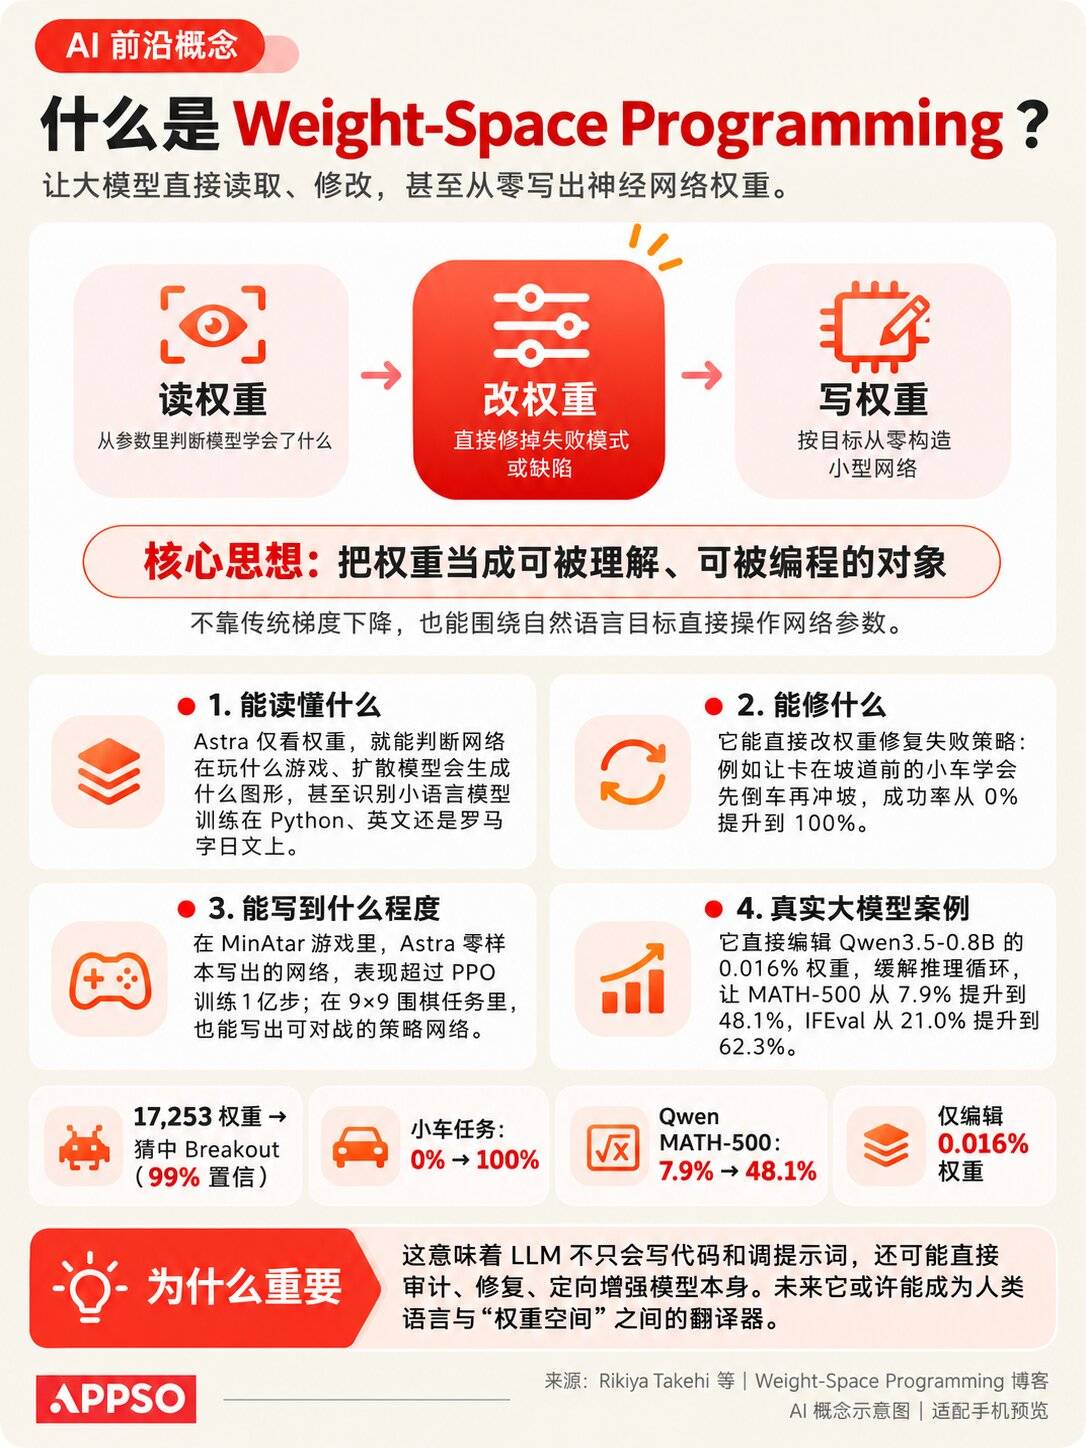
整个过程没有使用传统的梯度训练。研究人员仅修改了 Qwen3.5-0.8B 的 131072 个参数,就让它在 MATH-500 上的成绩从 7.9% 提升至 48.1%,GSM8K 从 13.8% 提升至 67.1%,指令遵循能力也明显改善。
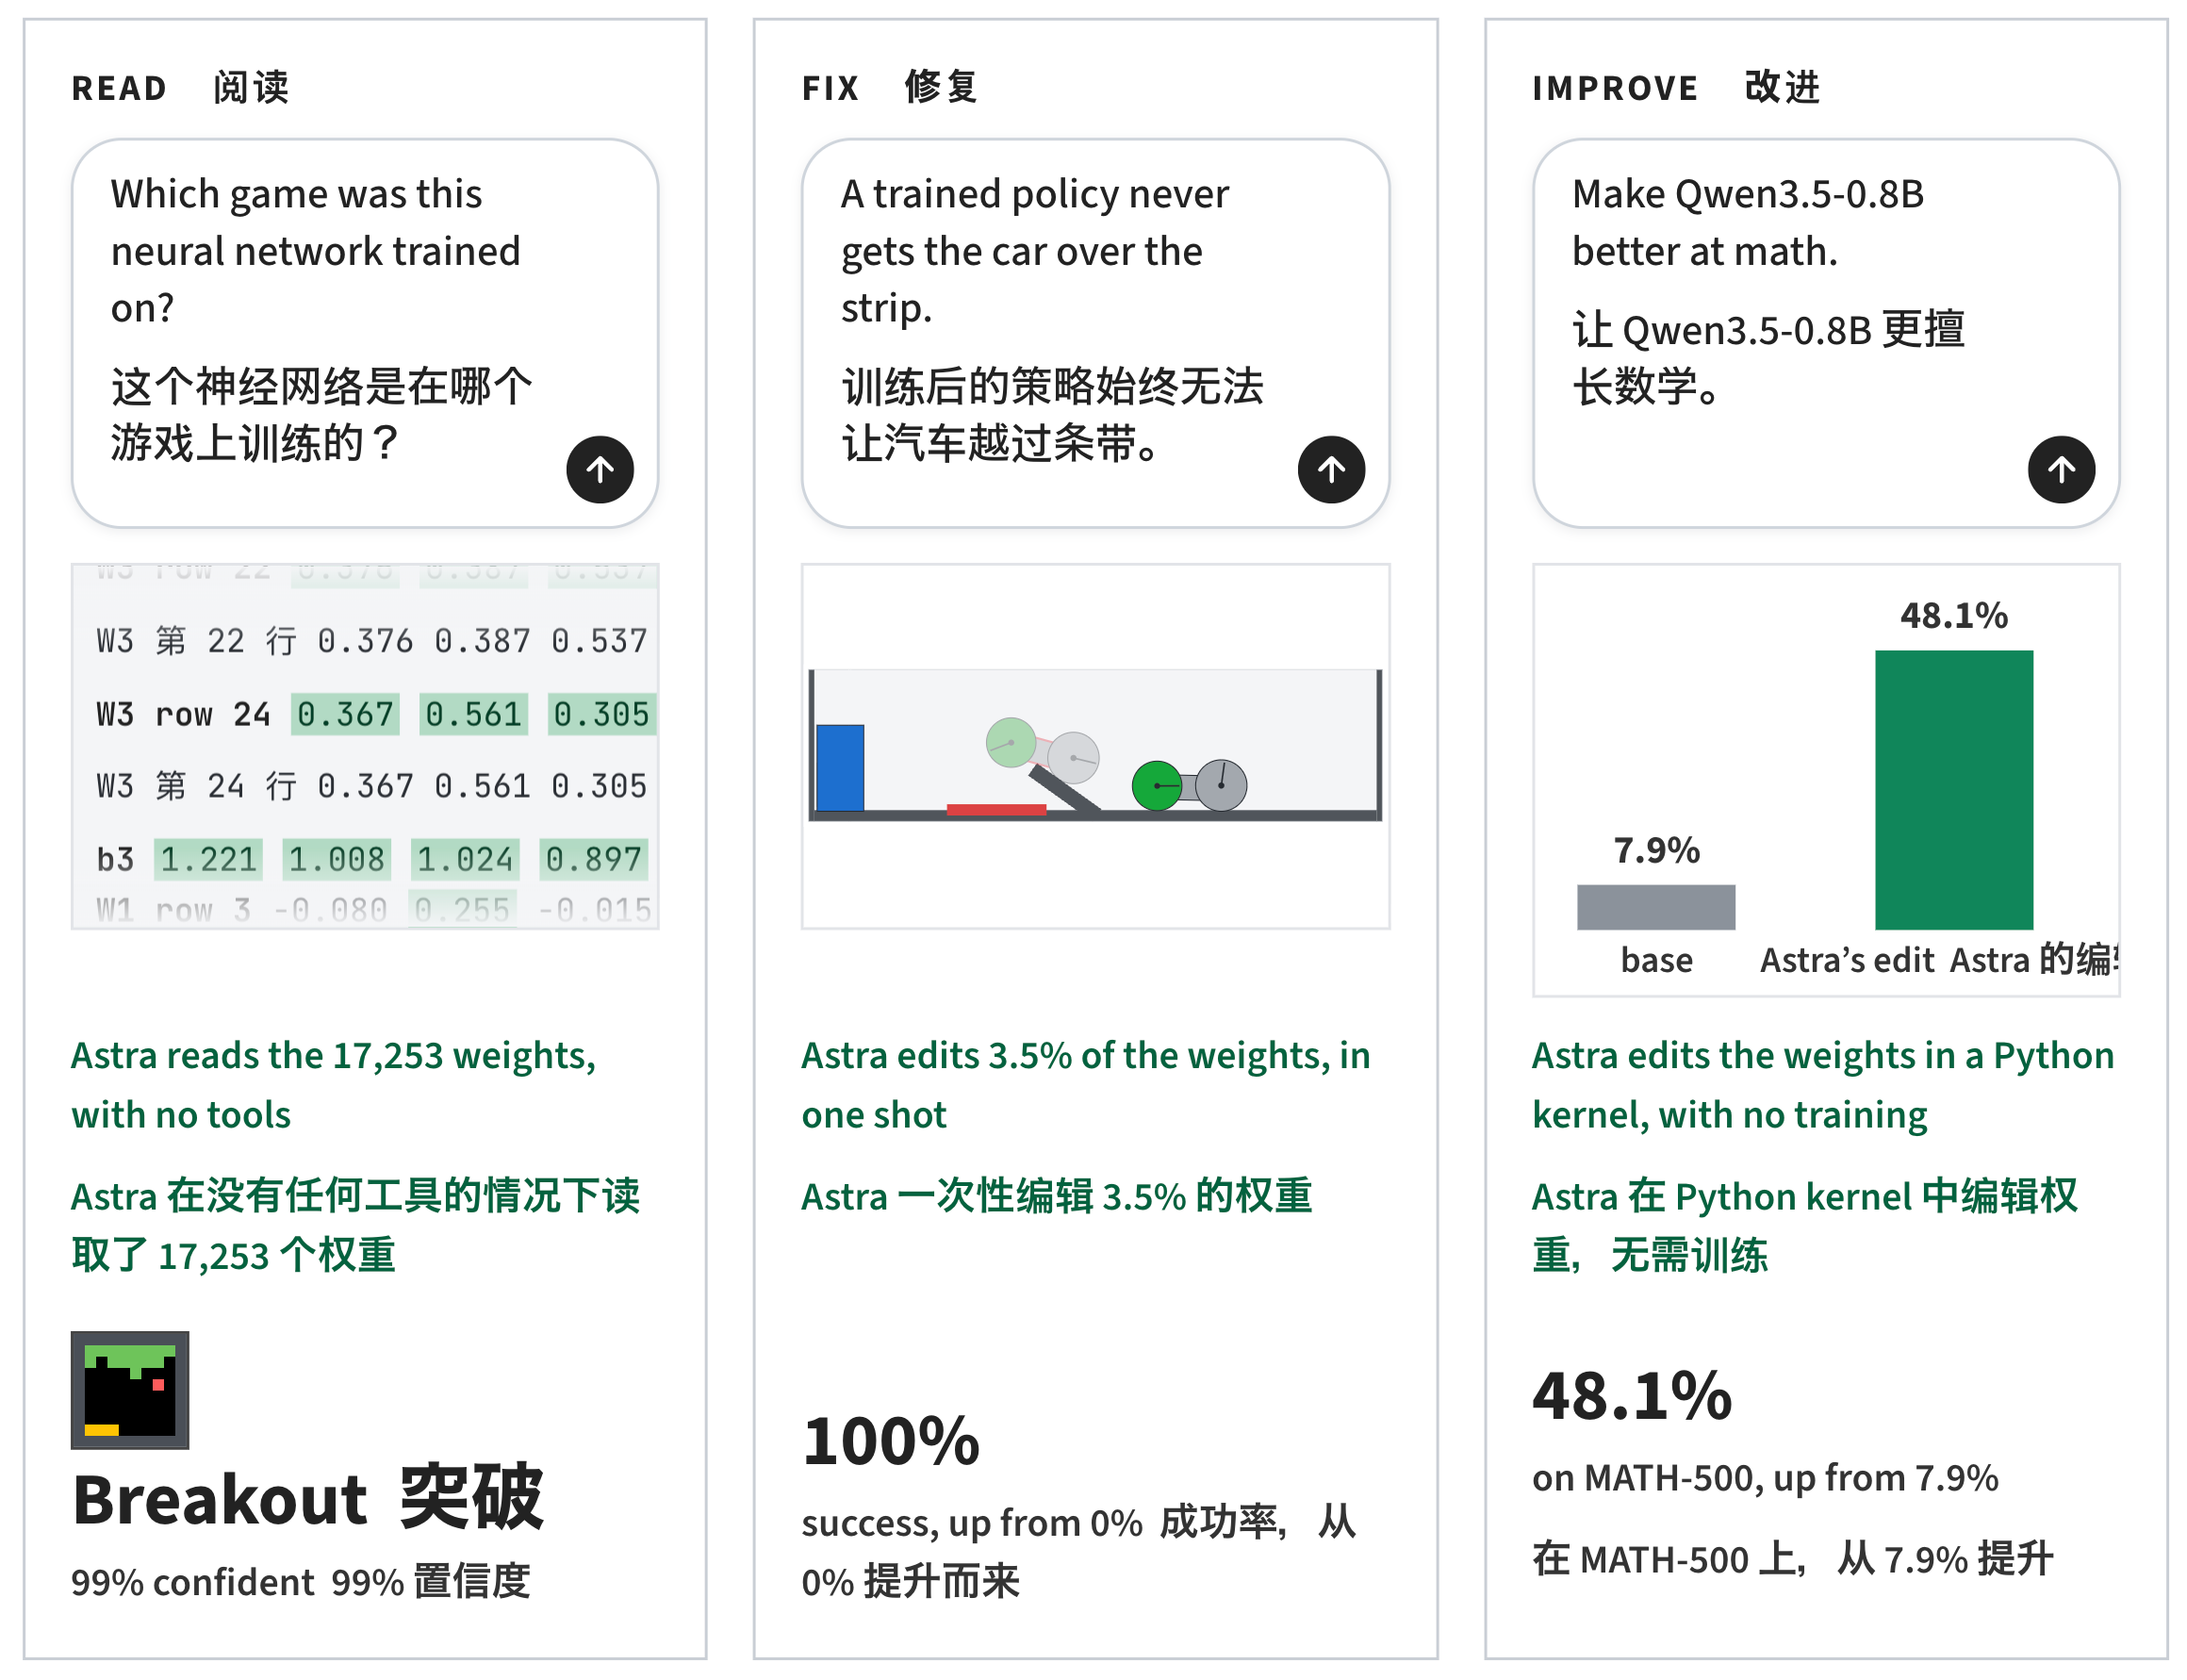
这项研究被称为「权重空间编程」(Weight-Space Programming)。
消息传开后,有人认为,这是一种刚刚在最新一代模型中出现的「阶跃式能力」。如果大模型能直接读写另一个模型的权重,未来 AI 优化 AI,可能连重新训练都不需要了。
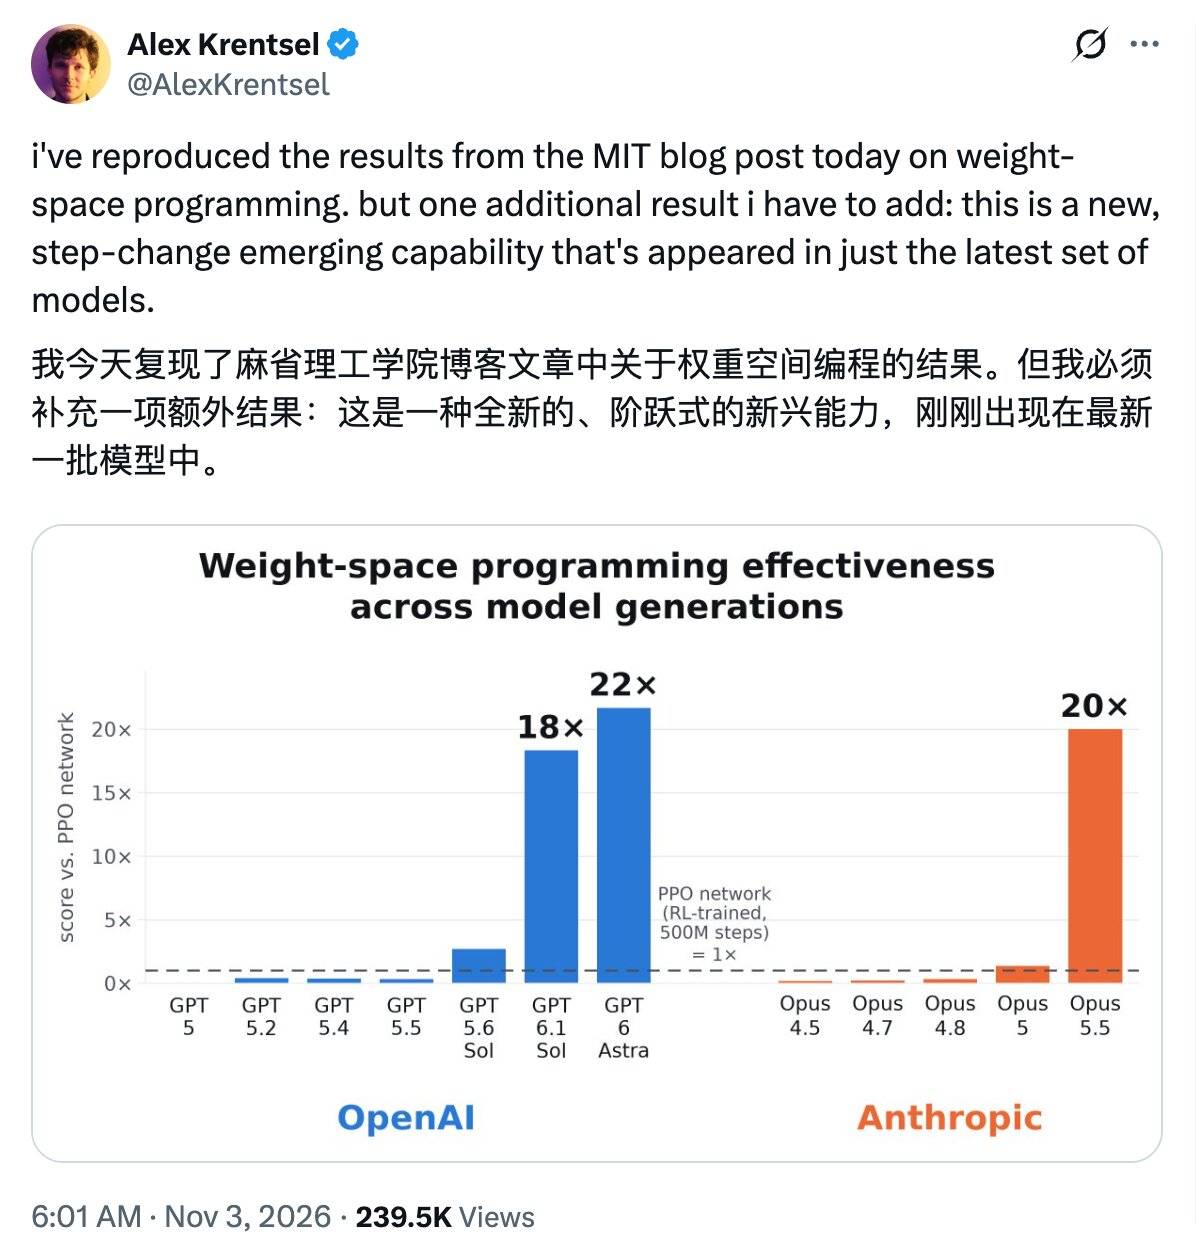
这是一种全新的、阶跃式的新兴能力,它刚刚才出现在最新一批模型中。
但质疑声也很快出现,有人指出,Qwen 原本就存在严重的重复推理问题,数学成绩大幅上涨,可能只是因为 Astra 修好了这个 Bug,并不等于一个模型凭空获得了新的数学能力。
从 7.9% 到 48.1%,GPT-6 Astra 究竟对这个模型做了什么?
从写代码到直接修改模型权重
一般来说,我们想要 AI 生成更好的回答,通常只能修改输入的提示词。而开发者想要修改模型的输出,可以用数据进行微调。
权重空间编程则尝试直接修改训练完成后的模型权重,即直接修改神经网络计算时使用的数字。
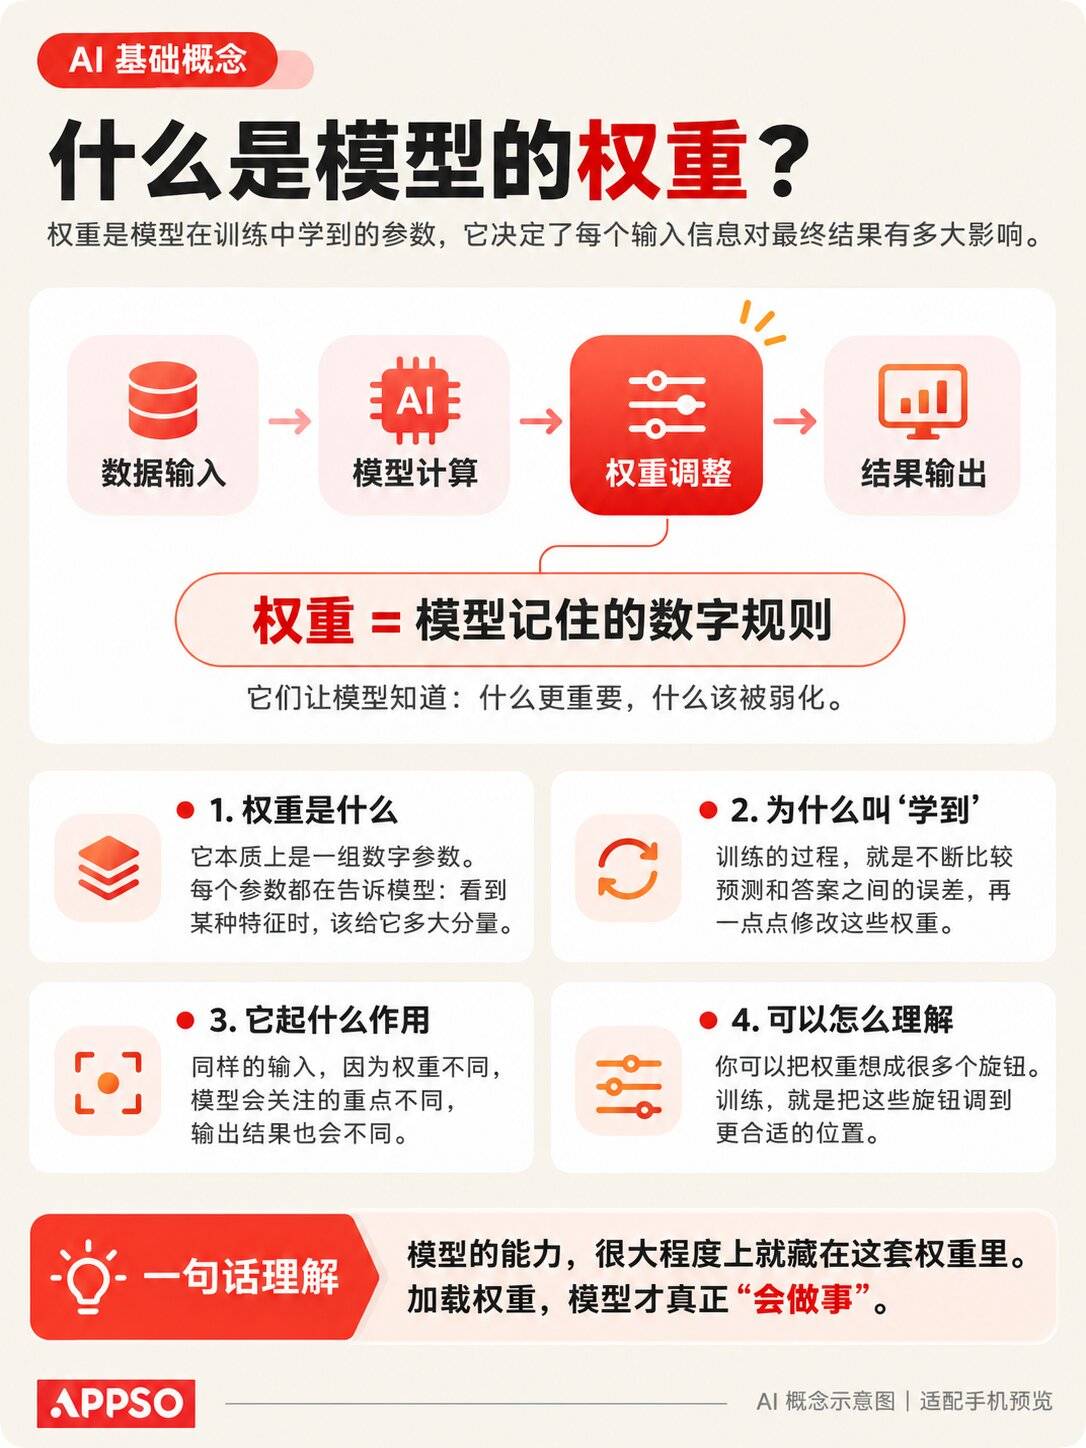
所谓权重,我们可以把它理解为神经网络模型里大量可调节的旋钮,每个旋钮都是一个数值,这些数值的不同会决定数据在网络中传递时,会被放大、削弱,还是以其他方式参与计算。
而我们常听到的训练模型,很大程度上就是在根据海量的数据不断调整这些旋钮,好让它逐渐学会从输入产出正确的输出。
训练完成后,模型的知识、习惯和行为倾向,都以某种复杂方式编码在这些数值之中;一个模型可以拥有数百万、数十亿甚至更多权重。
普遍的认知里,大语言模型能参与到模型迭代的部分,只是局限在编写训练代码、调整超参数、优化提示词,甚至设计完整的训练流程等。但在这些工作中,高达千亿、万亿大参数的模型权重本身,仍然主要由优化算法负责更新。
现在,大模型优化的对象开始从「如何训练一个模型」,下沉到「模型本身由哪些数值构成」。权重空间编程实现了让通用大语言模型可以根据自然语言目标,直接读取和修改神经网络权重;在某些实验中,模型甚至不需要环境反馈。
读懂权重之后,AI 开始自己写权重
为了证明这种突破的合理性,研究团队首先测试大模型能否只通过权重,就理解一个神经网络究竟学会了什么。
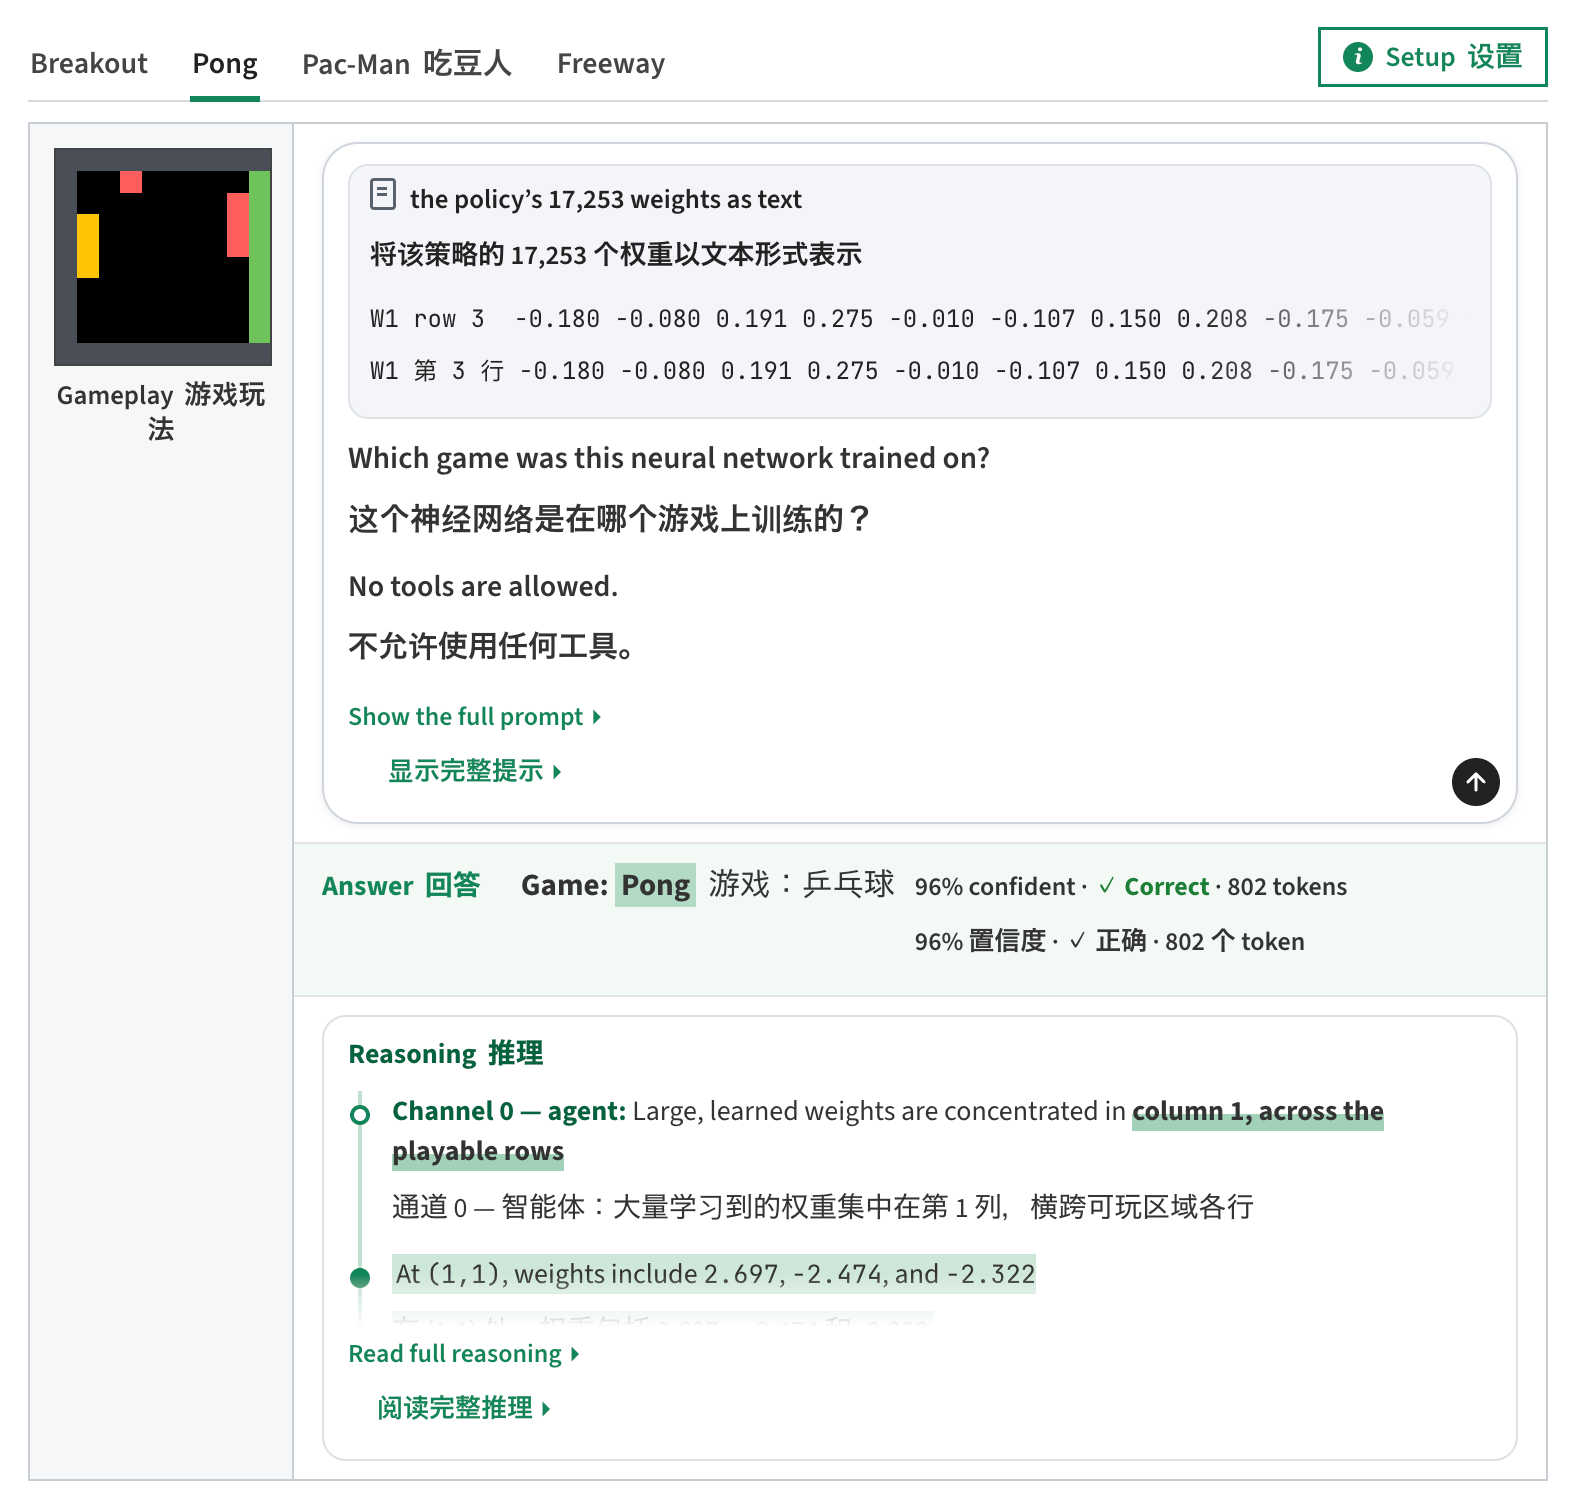
在实验中,GPT-6 Astra 能根据模型的原始权重,就推断出结构完全相同的几个小网络,分别对应的是专门为哪款游戏进行优化的模型,也能根据权重判断扩散模型会生成圆形、方形还是三角形。
面对几个小型语言模型,它还能仅根据中间层权重就判断训练语料属于 Python、英文还是日文罗马字,并找出负责复制前文的注意力头。
证明大模型可以读懂权重之后,研究团队继续测试是否能「写」,即修改权重。
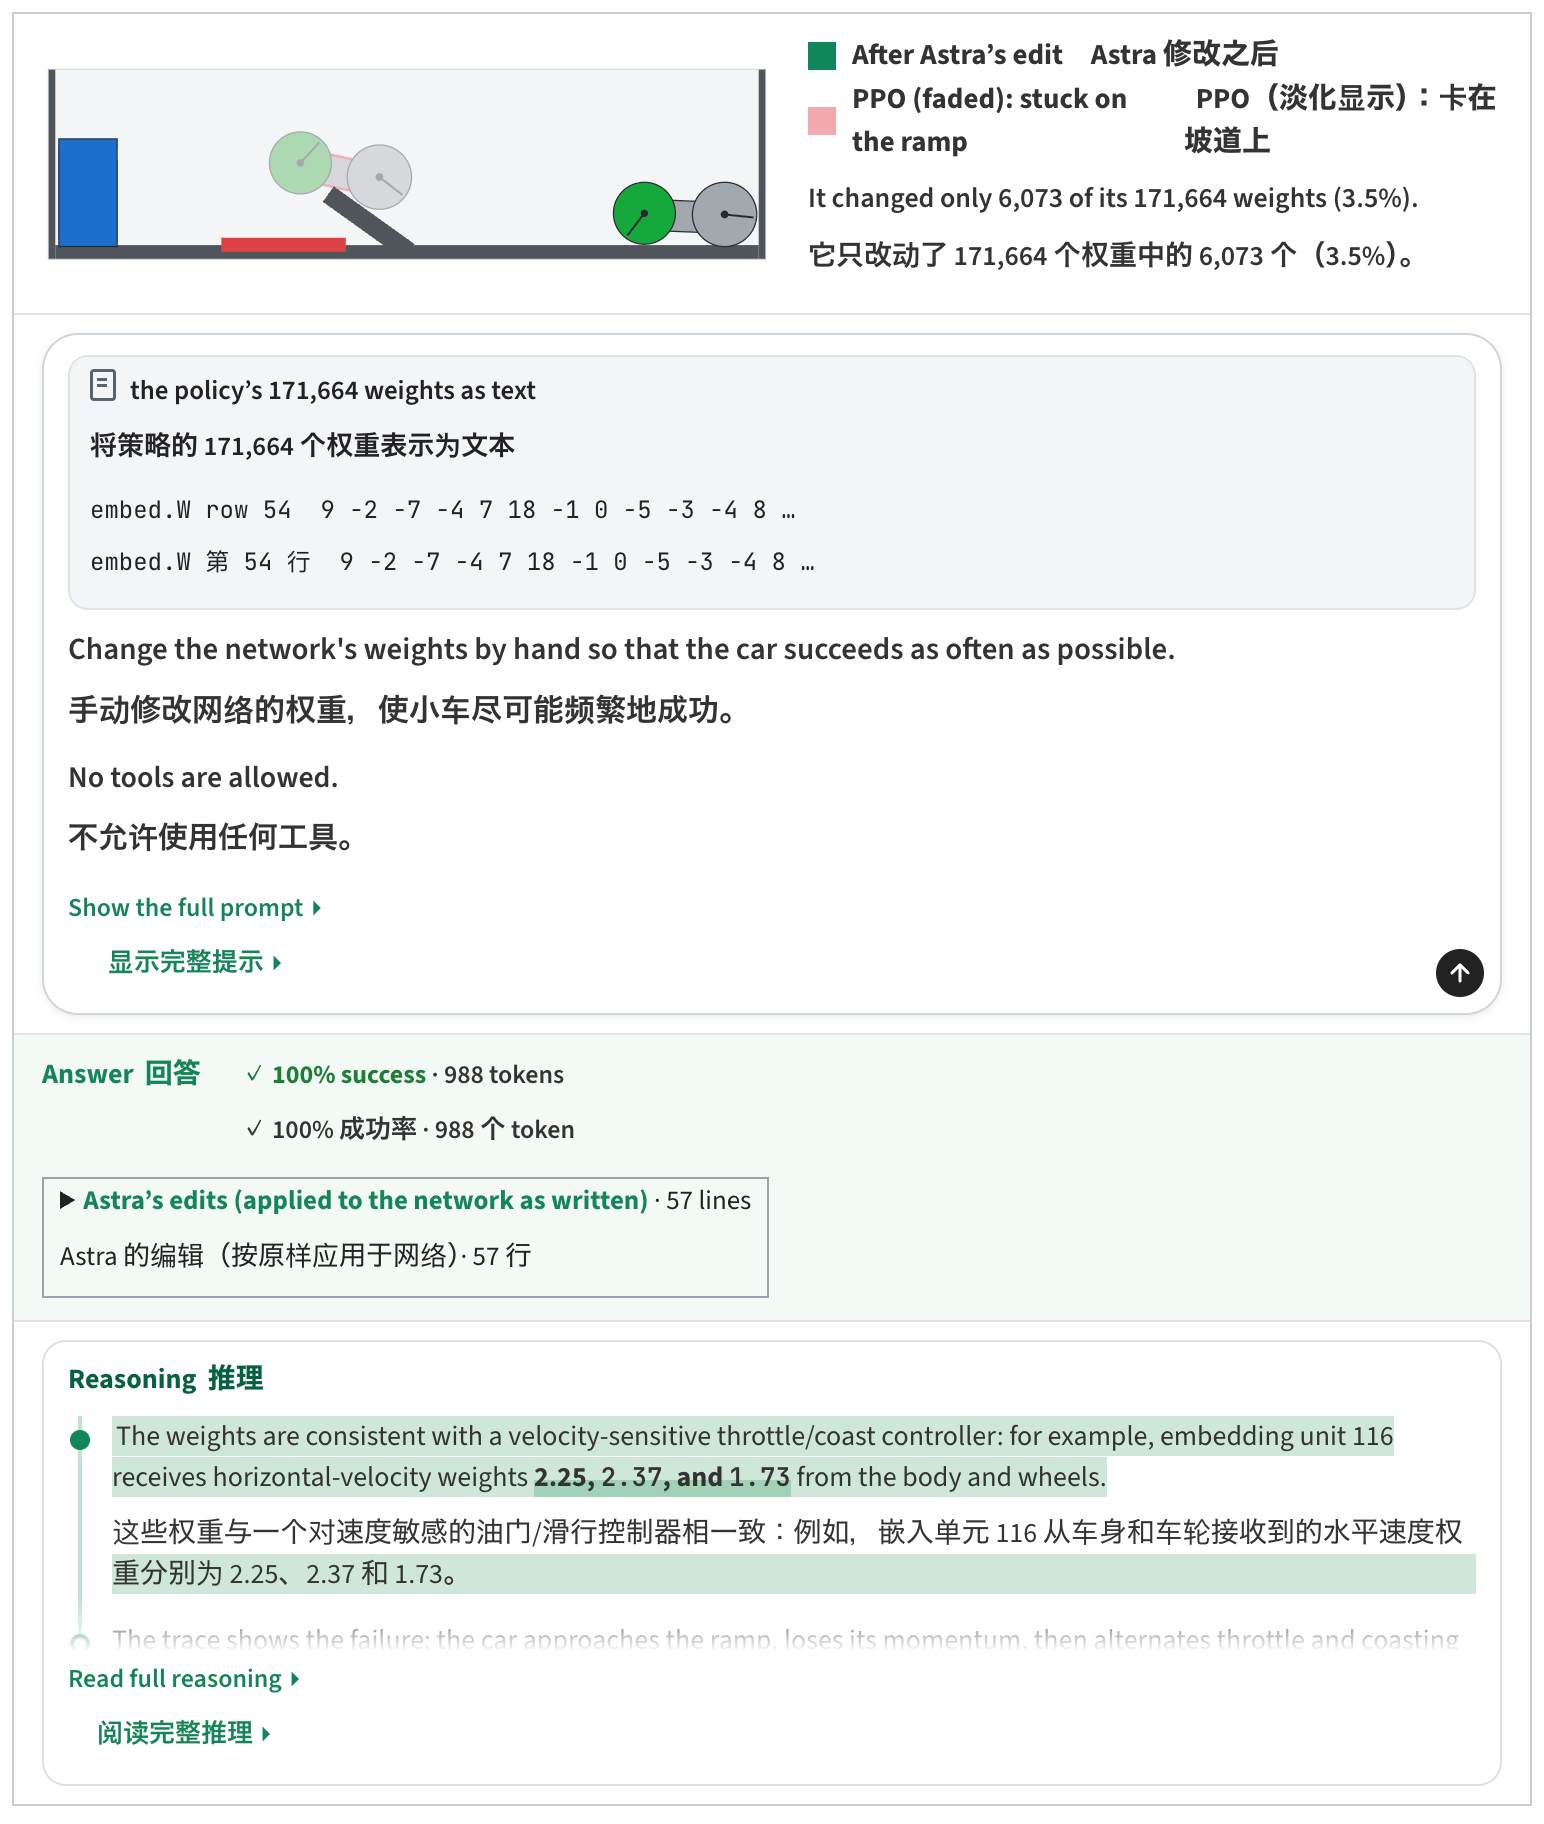
研究团队用强化学习算法 PPO 训练小车控制网络,跑了约 10 亿步。结果,小车直接往坡上开,却卡在那里;在 256 局检查中,一次也没成功。
Astra 收到了网络权重、场景和输入输出的说明,以及一次失败过程的记录。它在一次回复里提交参数补丁,只是修改了 3.5% 的权重,为网络加入「先后退蓄力,再全速前进」的控制路径,使成功率从 0 提升至 100%。
在另一组实验中,Astra 根据游戏规则和网络结构,从零生成游戏网络的权重。这些没有经历训练的网络,在三个 MinAtar 游戏中都超过了训练 1 亿步的 PPO 网络。在 9×9 围棋任务中,经过有限的前向测试和修改,生成网络还超过了同规模、经过 2000 万局训练的 PPO 网络。
这些结果指向一个颇具想象力的可能性:大模型或许可以把自然语言中的规则和策略,直接「编译」为神经网络。
只改 0.016% 参数,数学成绩涨了 40 个百分点
真正让这项研究出圈的,是对 Qwen3.5-0.8B 的修改。
前面那些小游戏的小模型都可以把权重转成文本,然后交给 GPT-6 Astra 处理,但一个 8 亿参数没法像直接塞进上下文。研究人员给 Astra 一个可以读取和修改权重的 Python 环境,以及 GSM8K、MATH 训练集中的练习题和答案,要求让这个小模型更擅长数学。
它可以借助 Python 分析权重,能通过专用工具测试模型,也能查看模型运行时的隐藏状态、神经元激活和注意力信息,但不能使用梯度信息或开展训练。
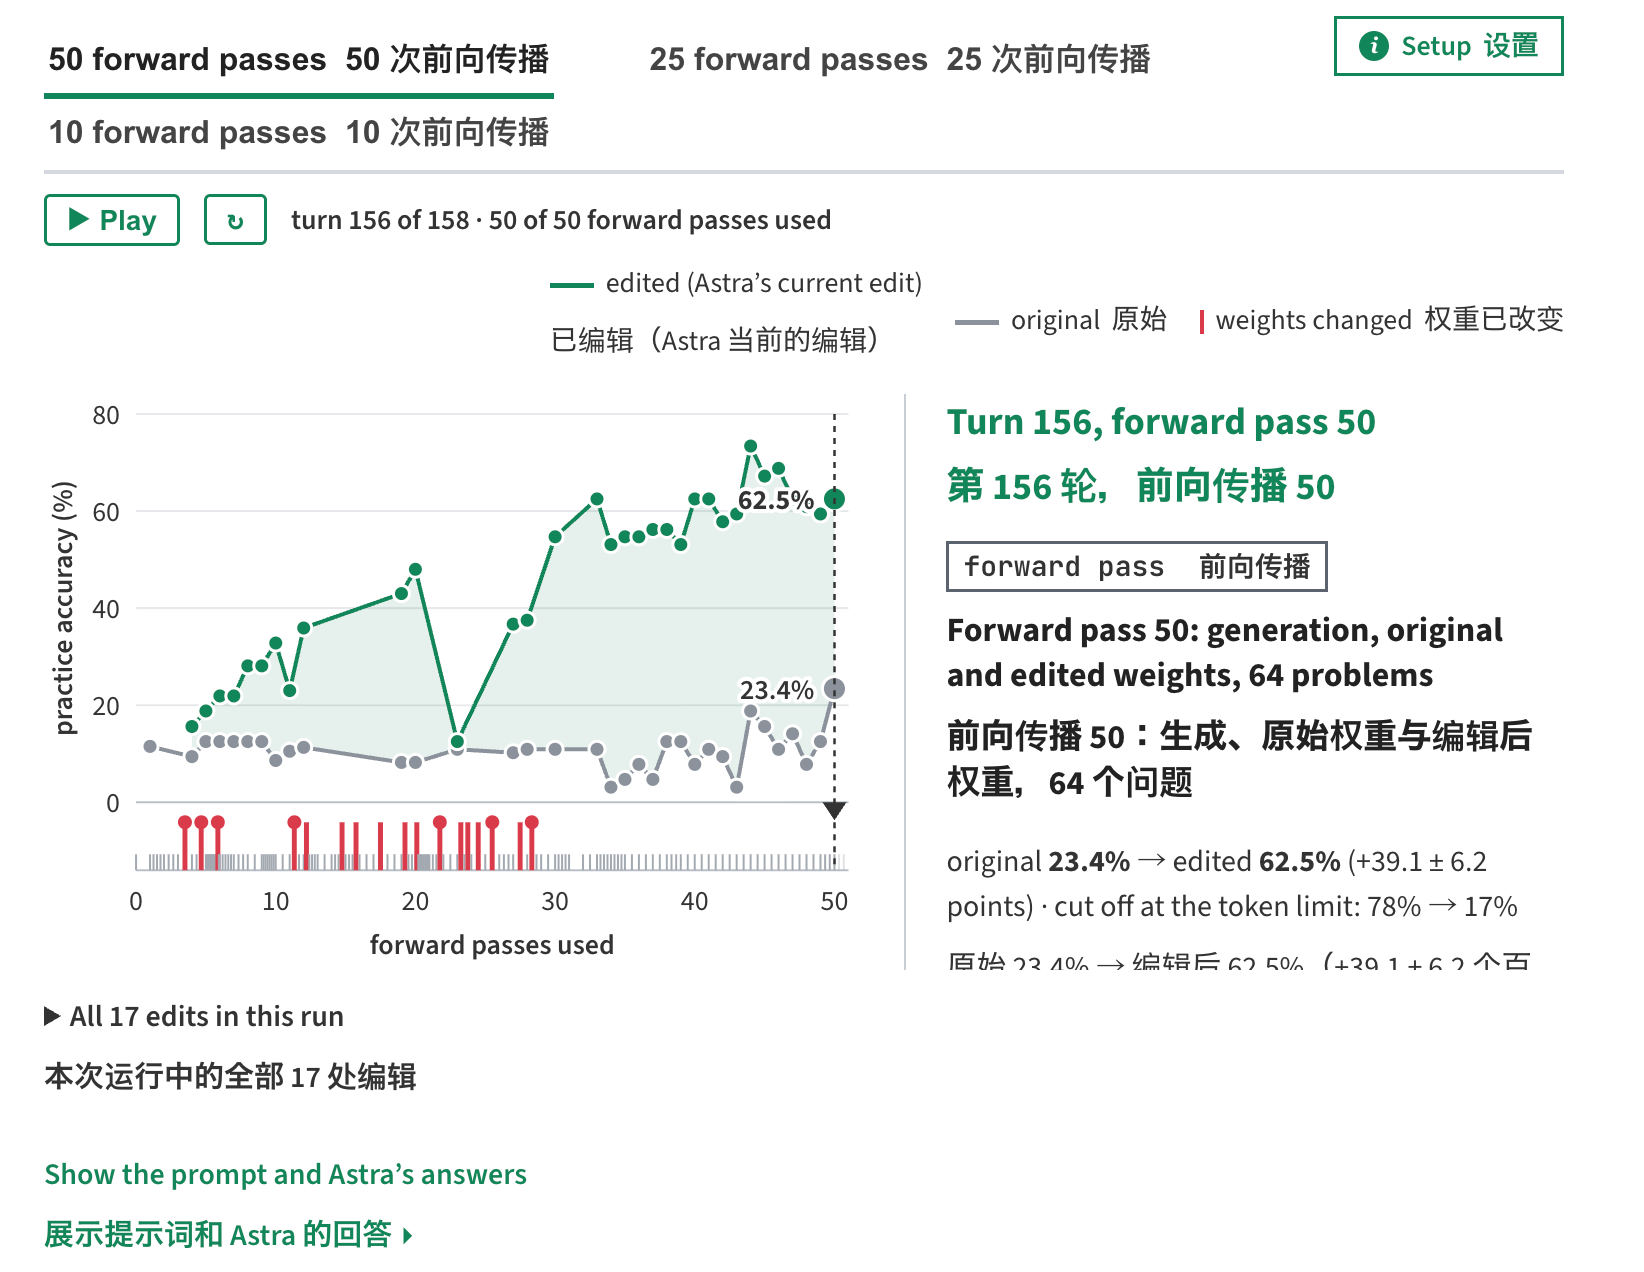
Astra 最终发现,模型的大量回答陷入了重复推理。在最初检查的 96 个练习答案中,有 85 个一直生成到 32768 个 token 的上限,仍然没有给出最终答案。GPT-6 Astra 将这一问题定位到部分 MLP 层写出的一个特定方向,并通过删除这个方向来抑制循环。
在允许 50 次前向测试的设置下,修改后的模型不仅数学成绩提高,MATH-500 从 7.9% 升到 48.1%,GSM8K 从 13.8% 升到 67.1%。
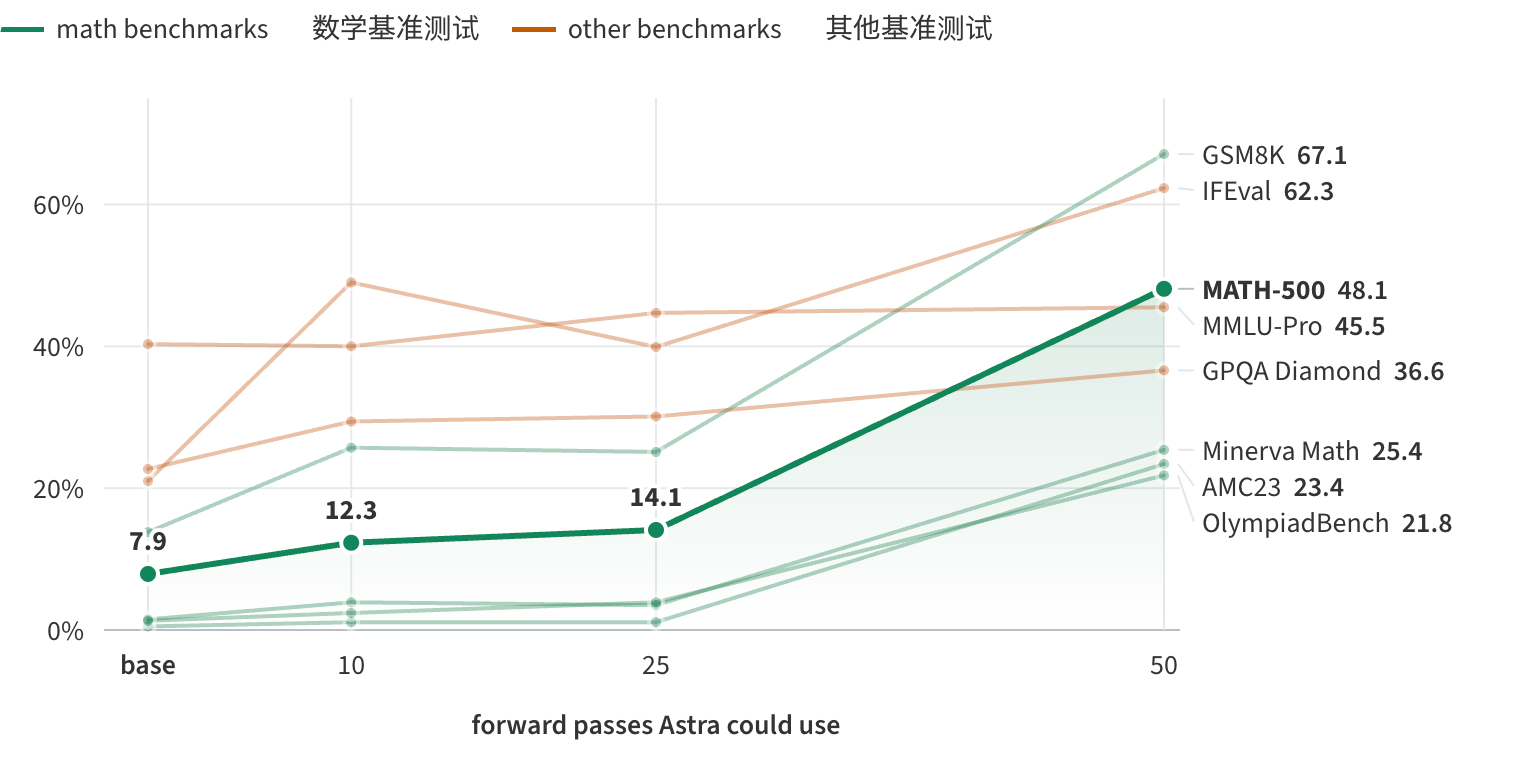
连 IFEval 指令遵循成绩也从 21.0% 上升至 62.3%;在 MATH-500 上触及 token 上限的回答比例,则从 93.0% 降至 33.1%。整个修改只涉及 131072 个参数。
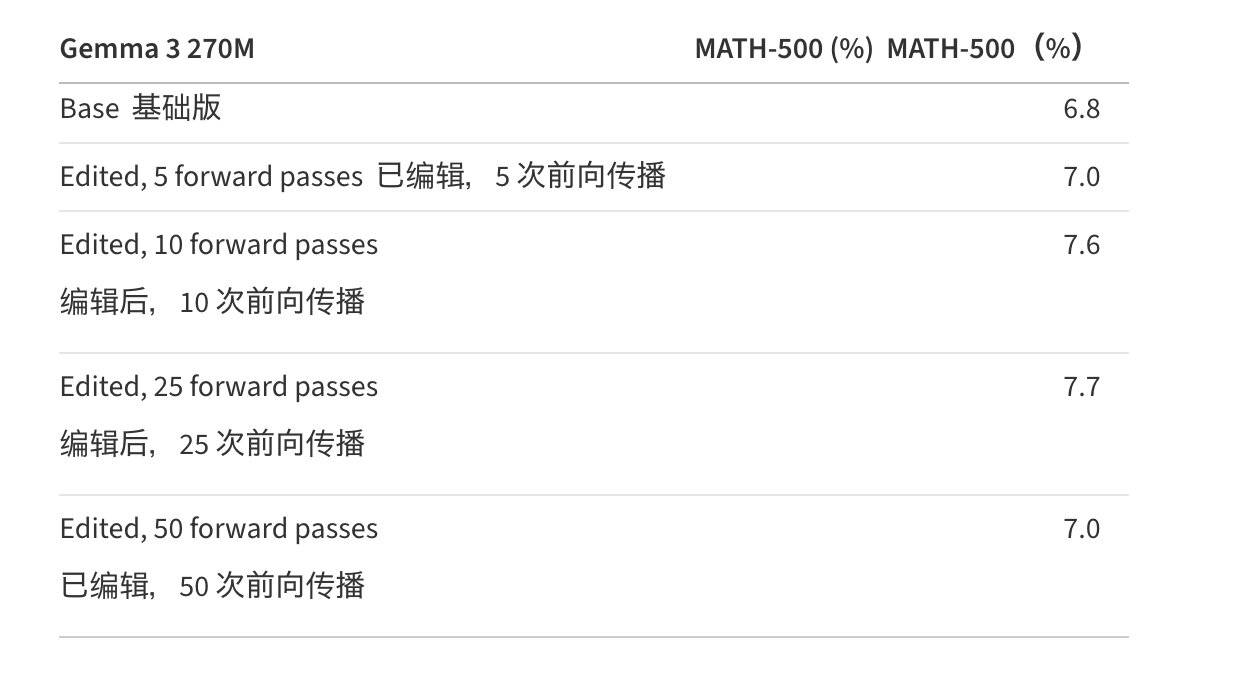
不过,研究团队也做了相应的补充实验。对于很少出现推理循环的 Gemma 3 270M,Astra 的修改没有带来明确提升。其 MATH-500 基线成绩为 6.8%,经过 50 次前向测试后的版本为 7.0%。
研究博客最后提到,Astra 主要移除了妨碍模型完成回答的障碍,而不是向模型注入了新的数学知识,不太能实现添加模型原本就不具备的能力。
能力大幅提升,还是修好了一个 Bug?
在 X 上,许多讨论将这项研究概括为「让 AI 直接修复 AI」。如果这种方法足够可靠,未来开发者或许不必为每个模型缺陷重新收集数据和微调,只需让更强的模型检查权重、找到故障并进行局部修复。
有网友发帖称,自己已经复现了博客中的结果,并认为这是一种刚在最新一代模型中出现的「阶跃式能力」。
还有网友说自己的团队做过类似实验,发现 Claude 模型也能从零写出完整、可运行的神经网络权重。
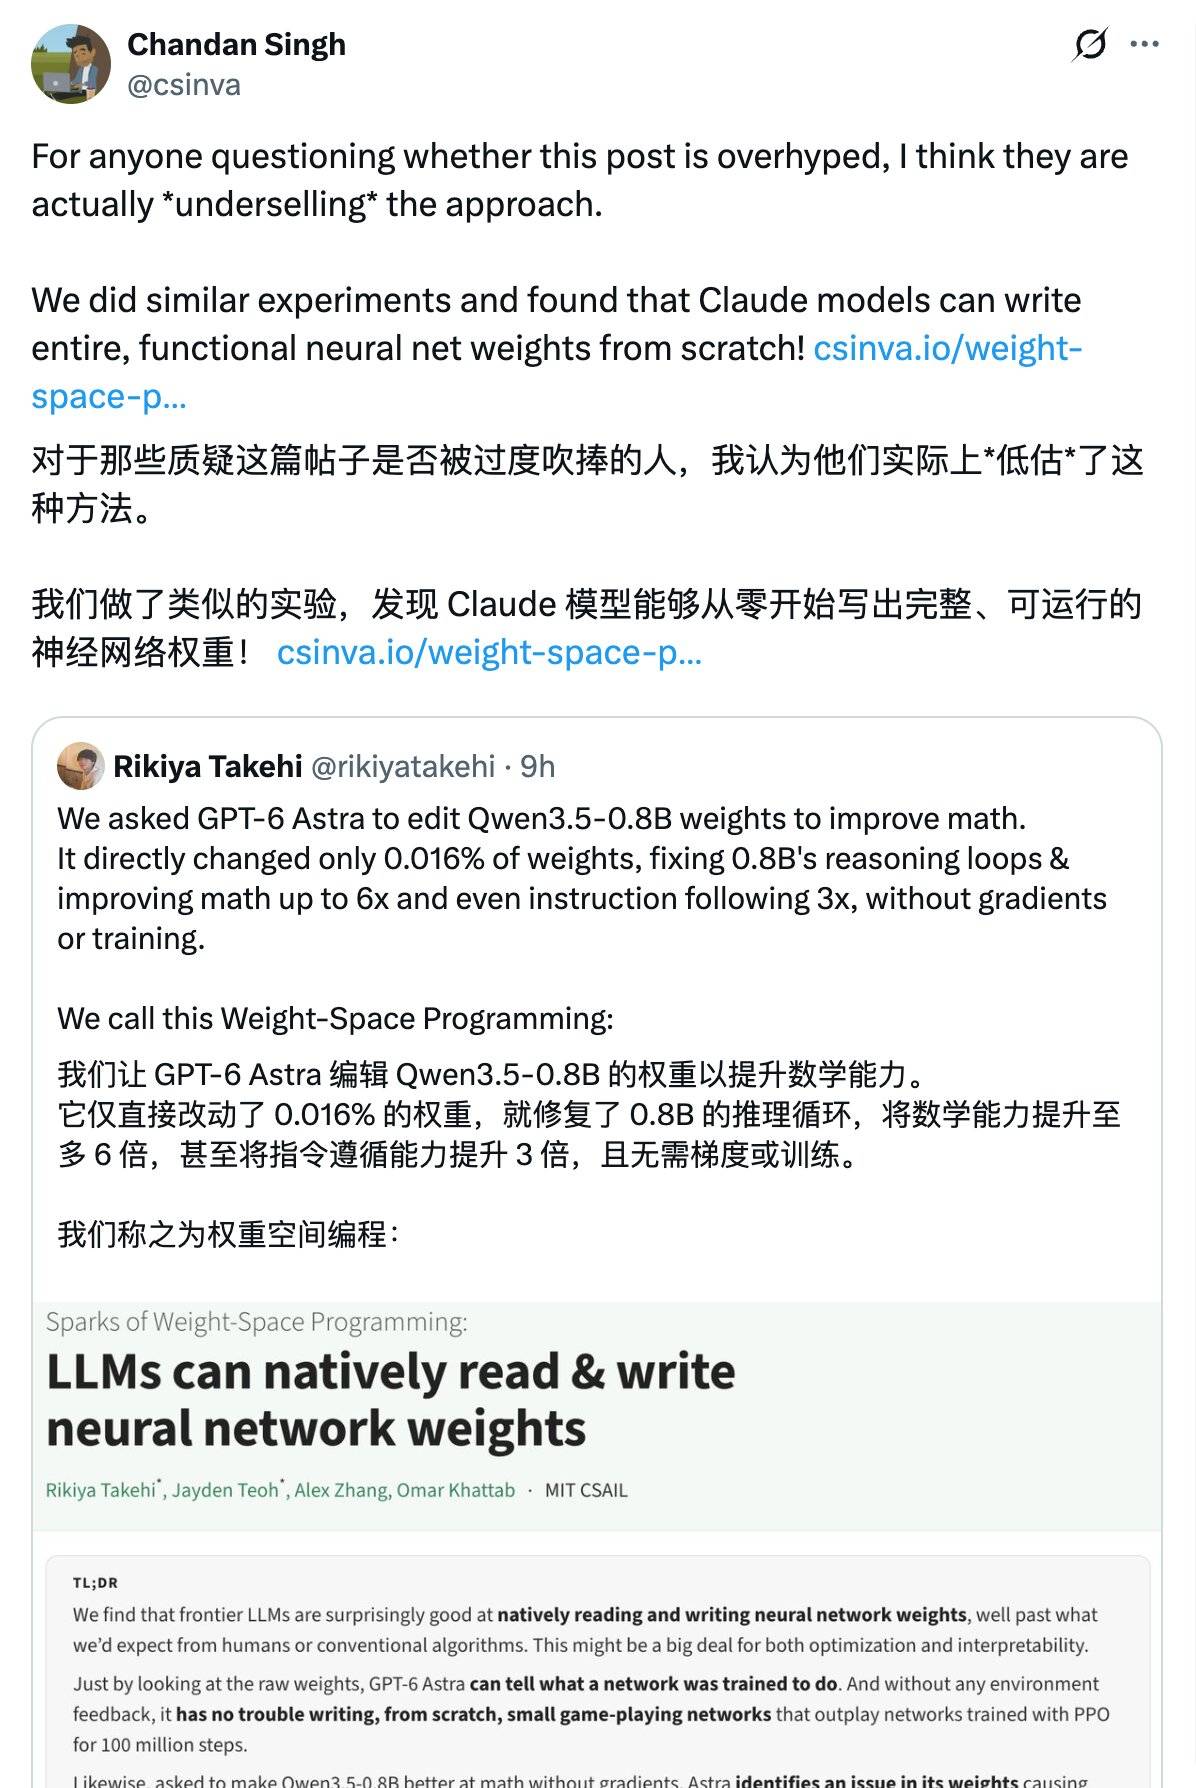
而质疑的声音主要来自于部分网友认为提分主要与减少循环有关,Astra 使用的思路与已有的激活引导方法相近,并且提供给 Astra 的长提示词已经明显暗示了循环问题,并引导它寻找能够修复问题的神经元。
有人提出首先应该测试一个简单的对照:直接关闭 Qwen 的思考模式,能否取得类似提升?
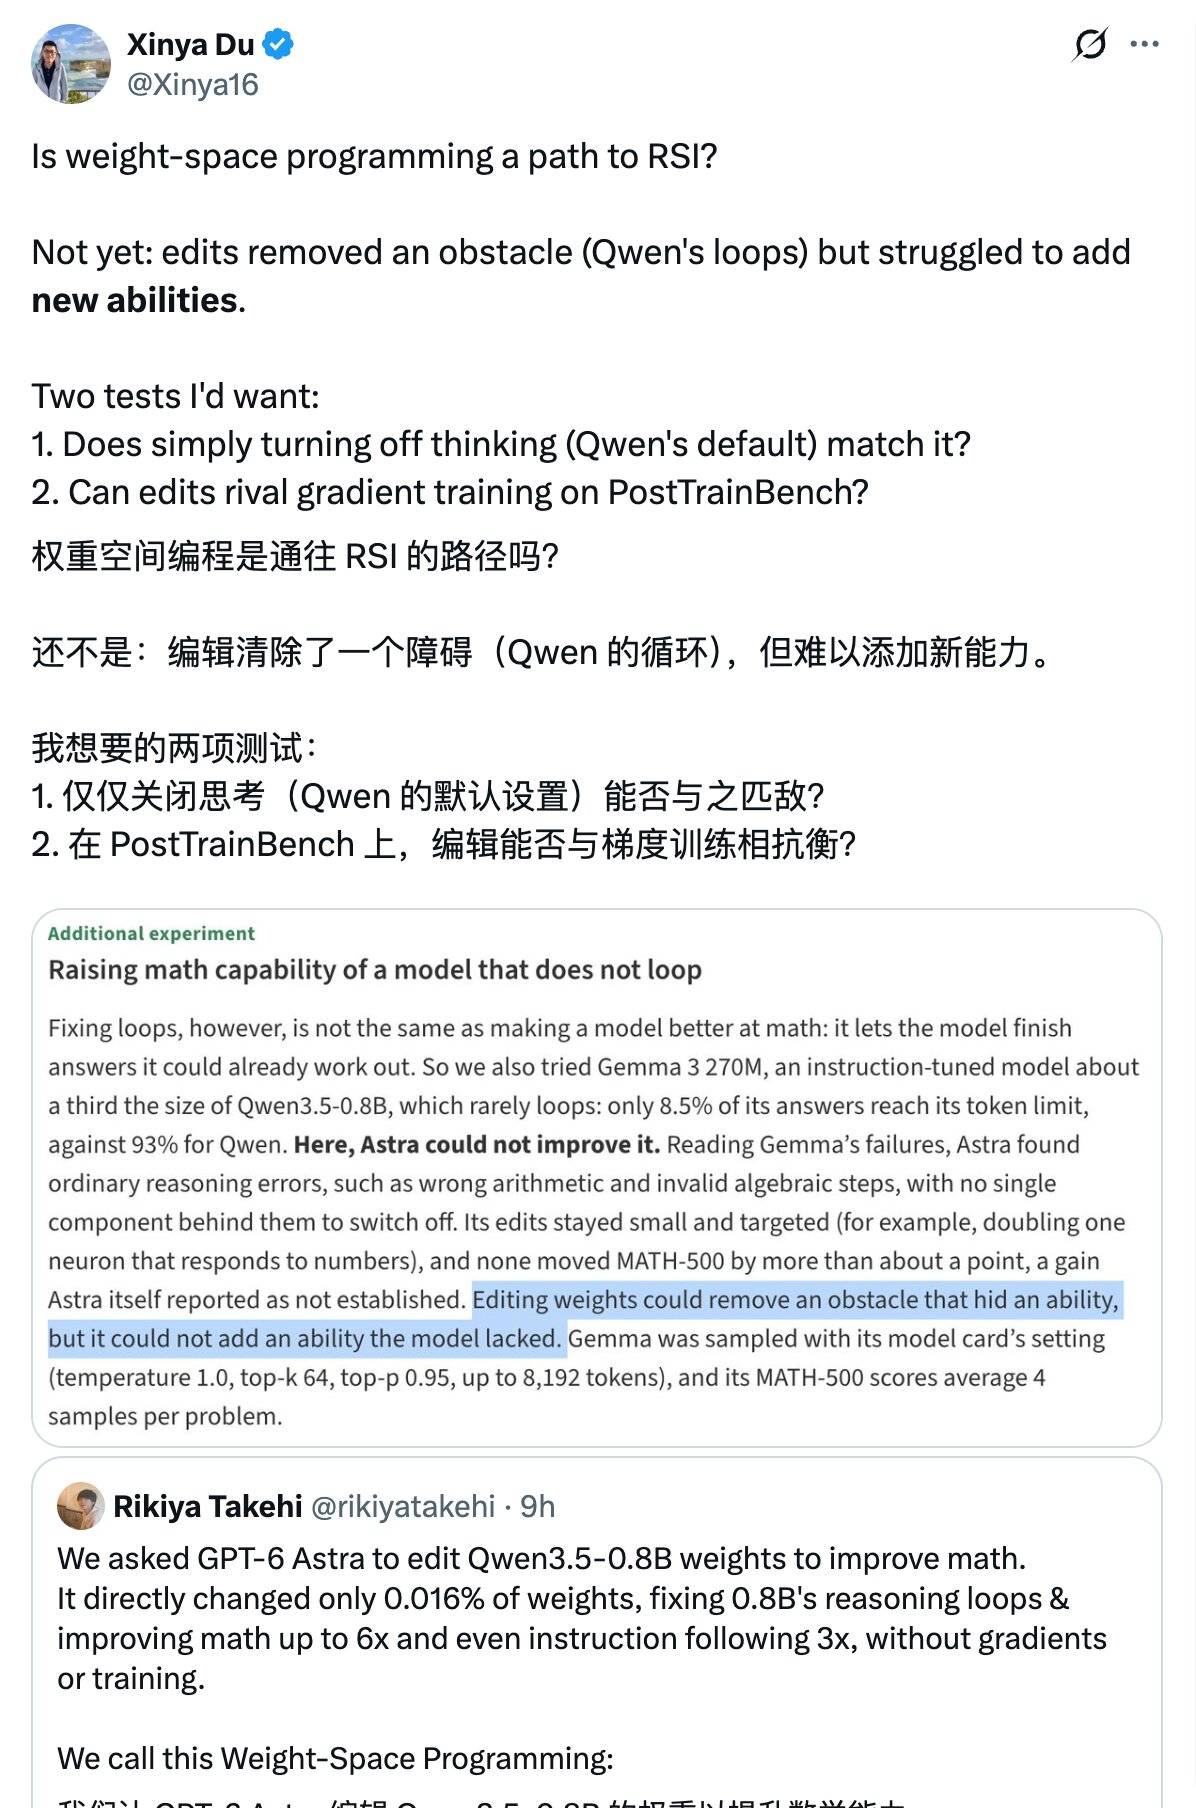
如果调整推理设置就能大幅减少循环,那么权重编辑究竟带来了多少额外价值,就需要重新评估。其次,这种方法还应与正常梯度训练进行比较,而不只是与一个表现很差的原始模型比较。
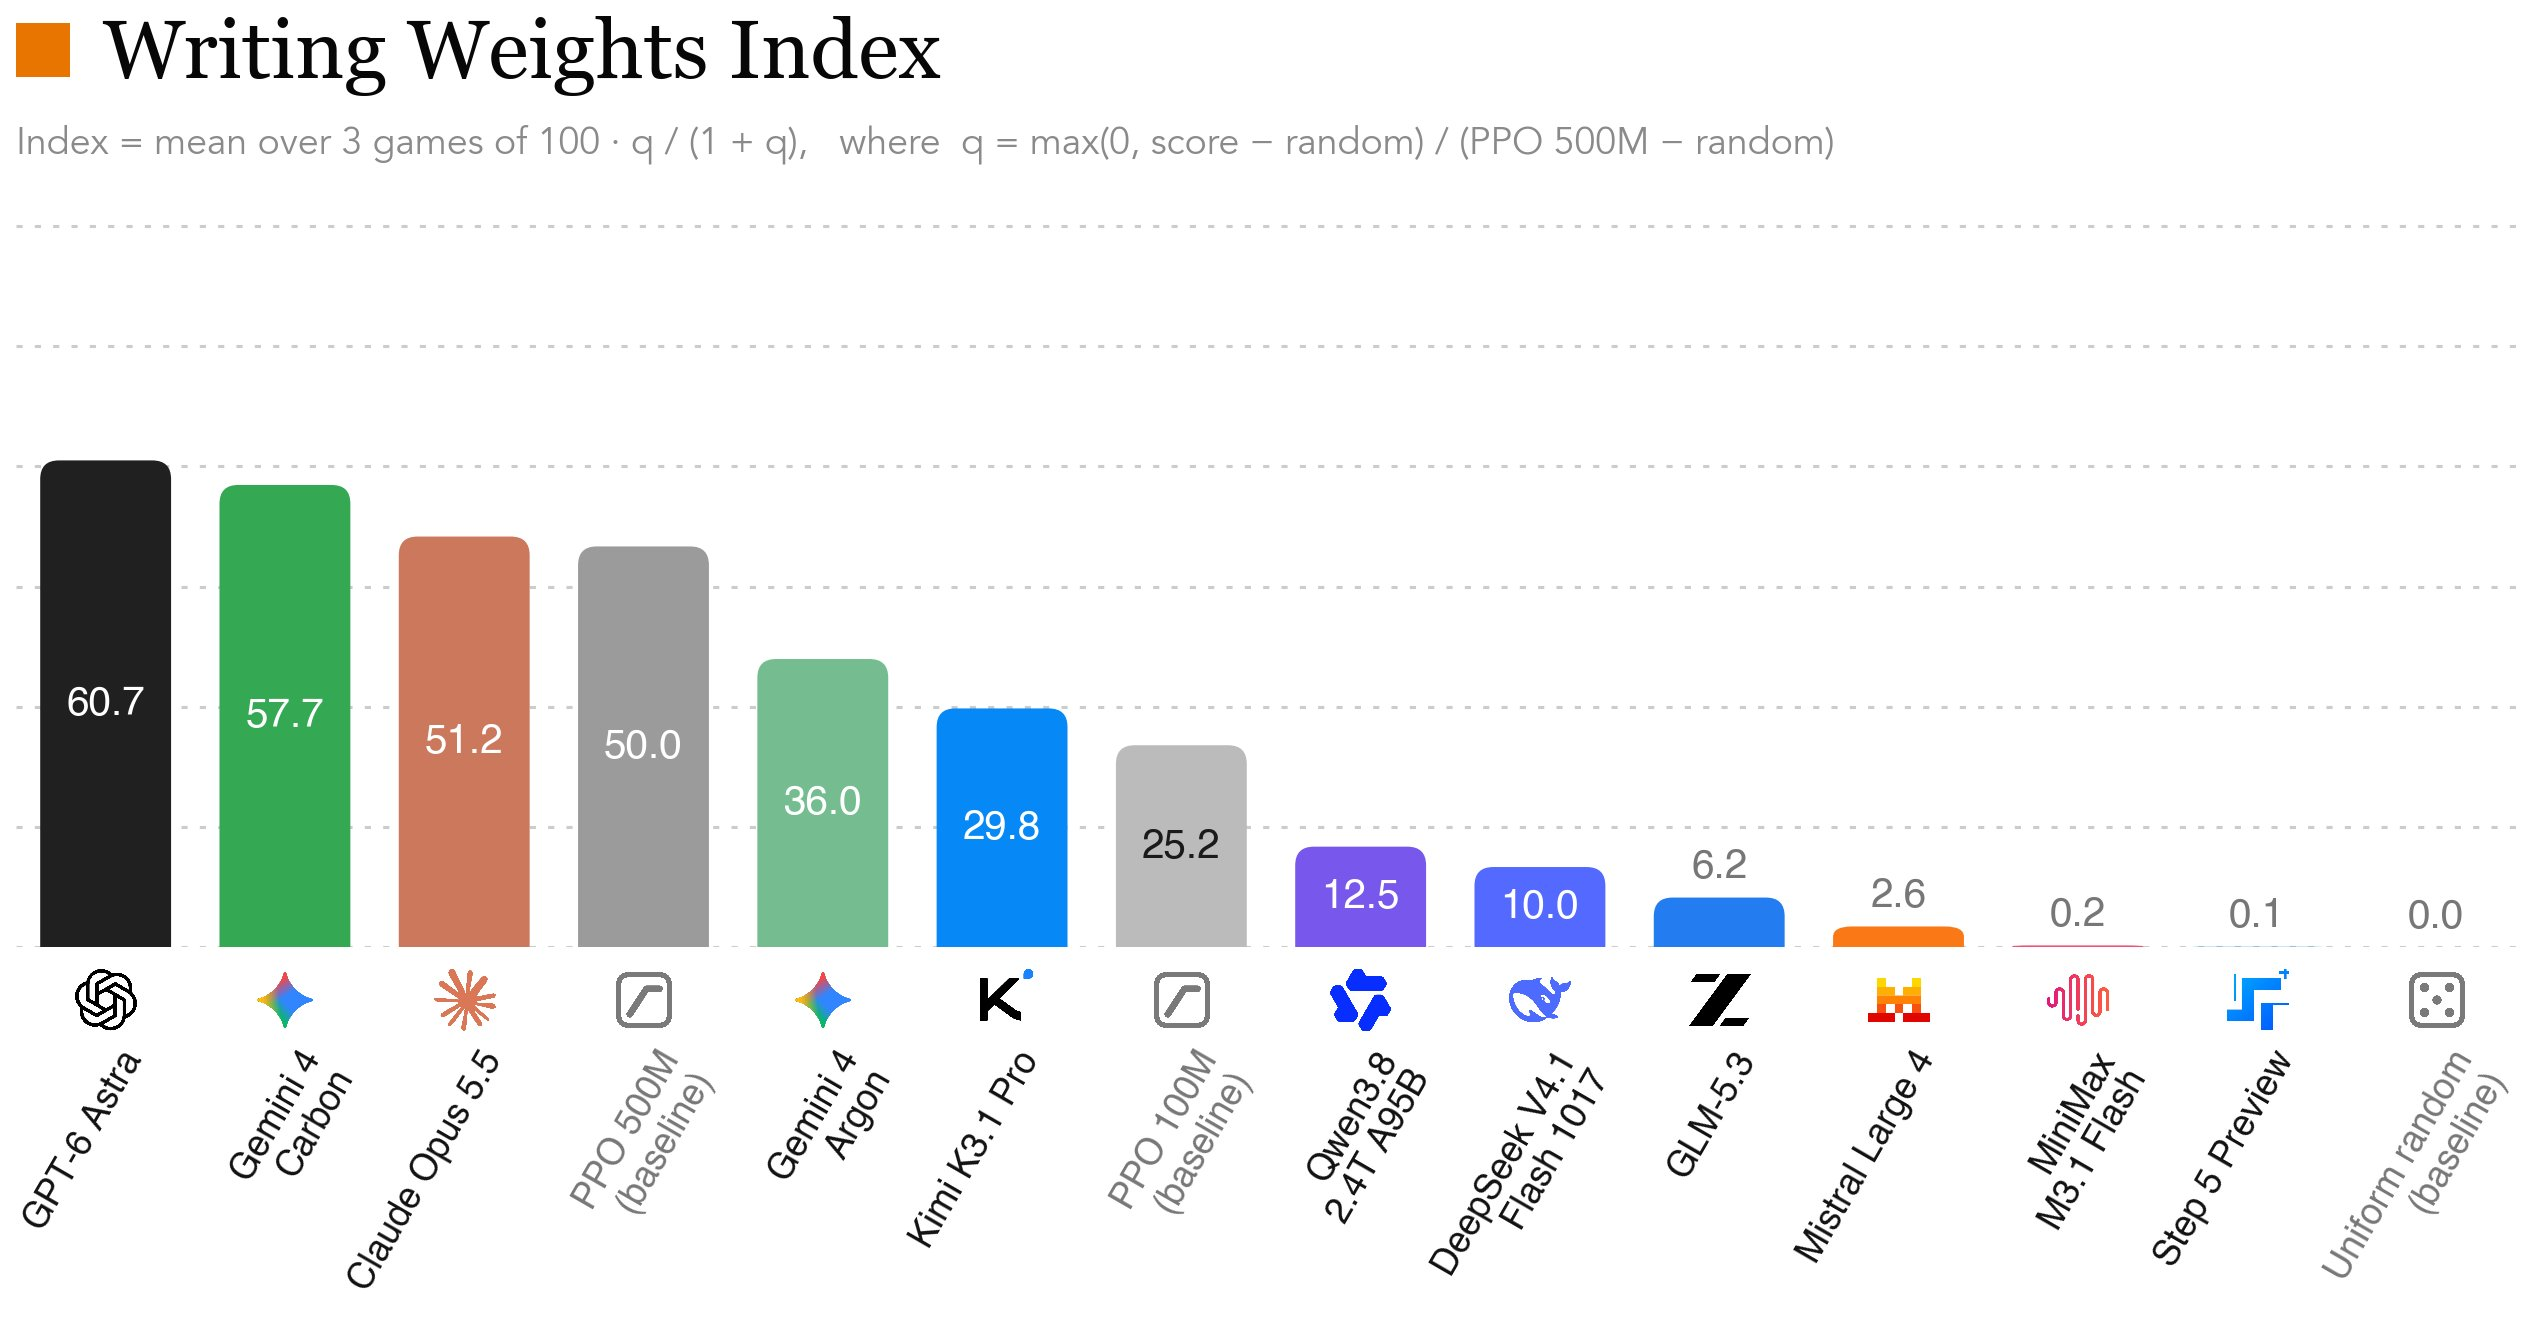
关于读写权重的争议,也是另一个争议点。普林斯顿大学博士生 Xingyu Dang 在运行一项 Writing Weights Index 测试后报告,开源模型在这类任务上表现困难。这也意味着,读写权重可能主要是最新前沿模型刚刚展现的能力,而不是所有大语言模型都已经具备的通用技能。
原博客本身也记录了一项重要的失败,在识别「谄媚模型」的实验中,Astra 仅比较权重时无法作出判断,直到被允许观察模型在特定文本上的注意力模式,才识别出差异。这说明「直接读懂权重」目前仍不是稳定、通用的能力。
人人都能发布大模型
这项工作并没有让我改变对老派机制可解释性能走多远的判断,它改变的是我对大模型有多擅长这件事的判断。
过去,研究人员想要改变一个模型的行为,通常需要准备数据、设计训练方法,再通过优化算法更新权重。现在,GPT-6 Astra 展示了另一种可能:让大模型根据任务目标,分析神经网络内部的参数,并尝试直接修改它们。
当然,距离真正把这种方法用到实际的模型开发中,还有不少问题需要解决。
这次 Astra 成功修复了 Qwen 的推理循环,却没能明显改善 Gemma 的数学表现。它能否稳定适用于不同模型和任务?与关闭思考模式、常规微调相比,究竟有多大优势?更重要的是,它能否让模型获得原本不具备的能力,还是只能修复已有能力发挥过程中的问题?
但是当神经网络的权重本身,也可能成为大模型可以直接操作的编程对象时;未来,我们或许只需要描述希望模型具备什么行为,AI 就尝试把这些要求转化为具体的参数修改。
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
早报|国行苹果AI开测,Siri接入千问/中兴否认出售手机业务传闻/多所高校免费发Token
 国行 Apple 智能开启测试,Siri、写作工具与视觉智能接入千问
 苹果天气出现数据异常,多地下周五「跌至」零下 32 度
 苹果向所有开发者开放 Siri AI,可将多个 App 动作串成任务
 GPT 爆改 Qwen 权重,团队测试数学成绩提升约 6 倍
 OpenAI 用 Astra 一周设计语音 Codex 设备,并与马自达合作研究
 曝 DeepSeek V5 拟用昇腾预训练
 DeepSeek 又崩了
 红果用户规模超越豆包,千问领跑亿级 App 增速榜
 盗用 AI 平台算力,上海一男子获刑三年
 中兴否认出售手机业务传闻
Claude Code 产品负责人 Cat Wu 离开 Anthropic
姚顺宇否认创业:仍是 Google DeepMind 员工
 多所高校免费发 Token,同济每周提供 1 亿 Token
 蔚来累计换电突破 1.3 亿次,最近 1000 万次用时 88 天
Seedance 海外收入占比达一半,腾讯与 B 站成为国内大客户
 AMD 数据中心收入接近翻倍,第四季度营收指引达 170 亿美元
 阿里董事会主席:只有开源才能普及 AI
 英伟达与 Pika 基于 MiniMax H3 开源视频增强和生成模型
 商汤发布 SenseNova 6.8 Flash,支持动态设计与可编辑 3D 工程
法拉利首款电动车 Luce,2027 年产量已全部被预订
美团 LongCat-2.5 正式发布,国产算力训练原生多模态模型
 智能投影销量连跌四季,第三季度中国市场下滑 26.2%
 佳能计划明年起调价,应对零部件成本上涨
 全国放心消费平台上线,扫码可查周边商家承诺
 《好莱坞往事》衍生片再请《社交网络》配乐搭档
 《蓝眼武士》第二季定档明年 1 月,复仇之旅转向伦敦
Netflix 测试 AI Discover,按心情找片还能屏蔽不想看的推荐
国行 Apple 智能开启测试,Siri、写作工具与视觉智能接入千问
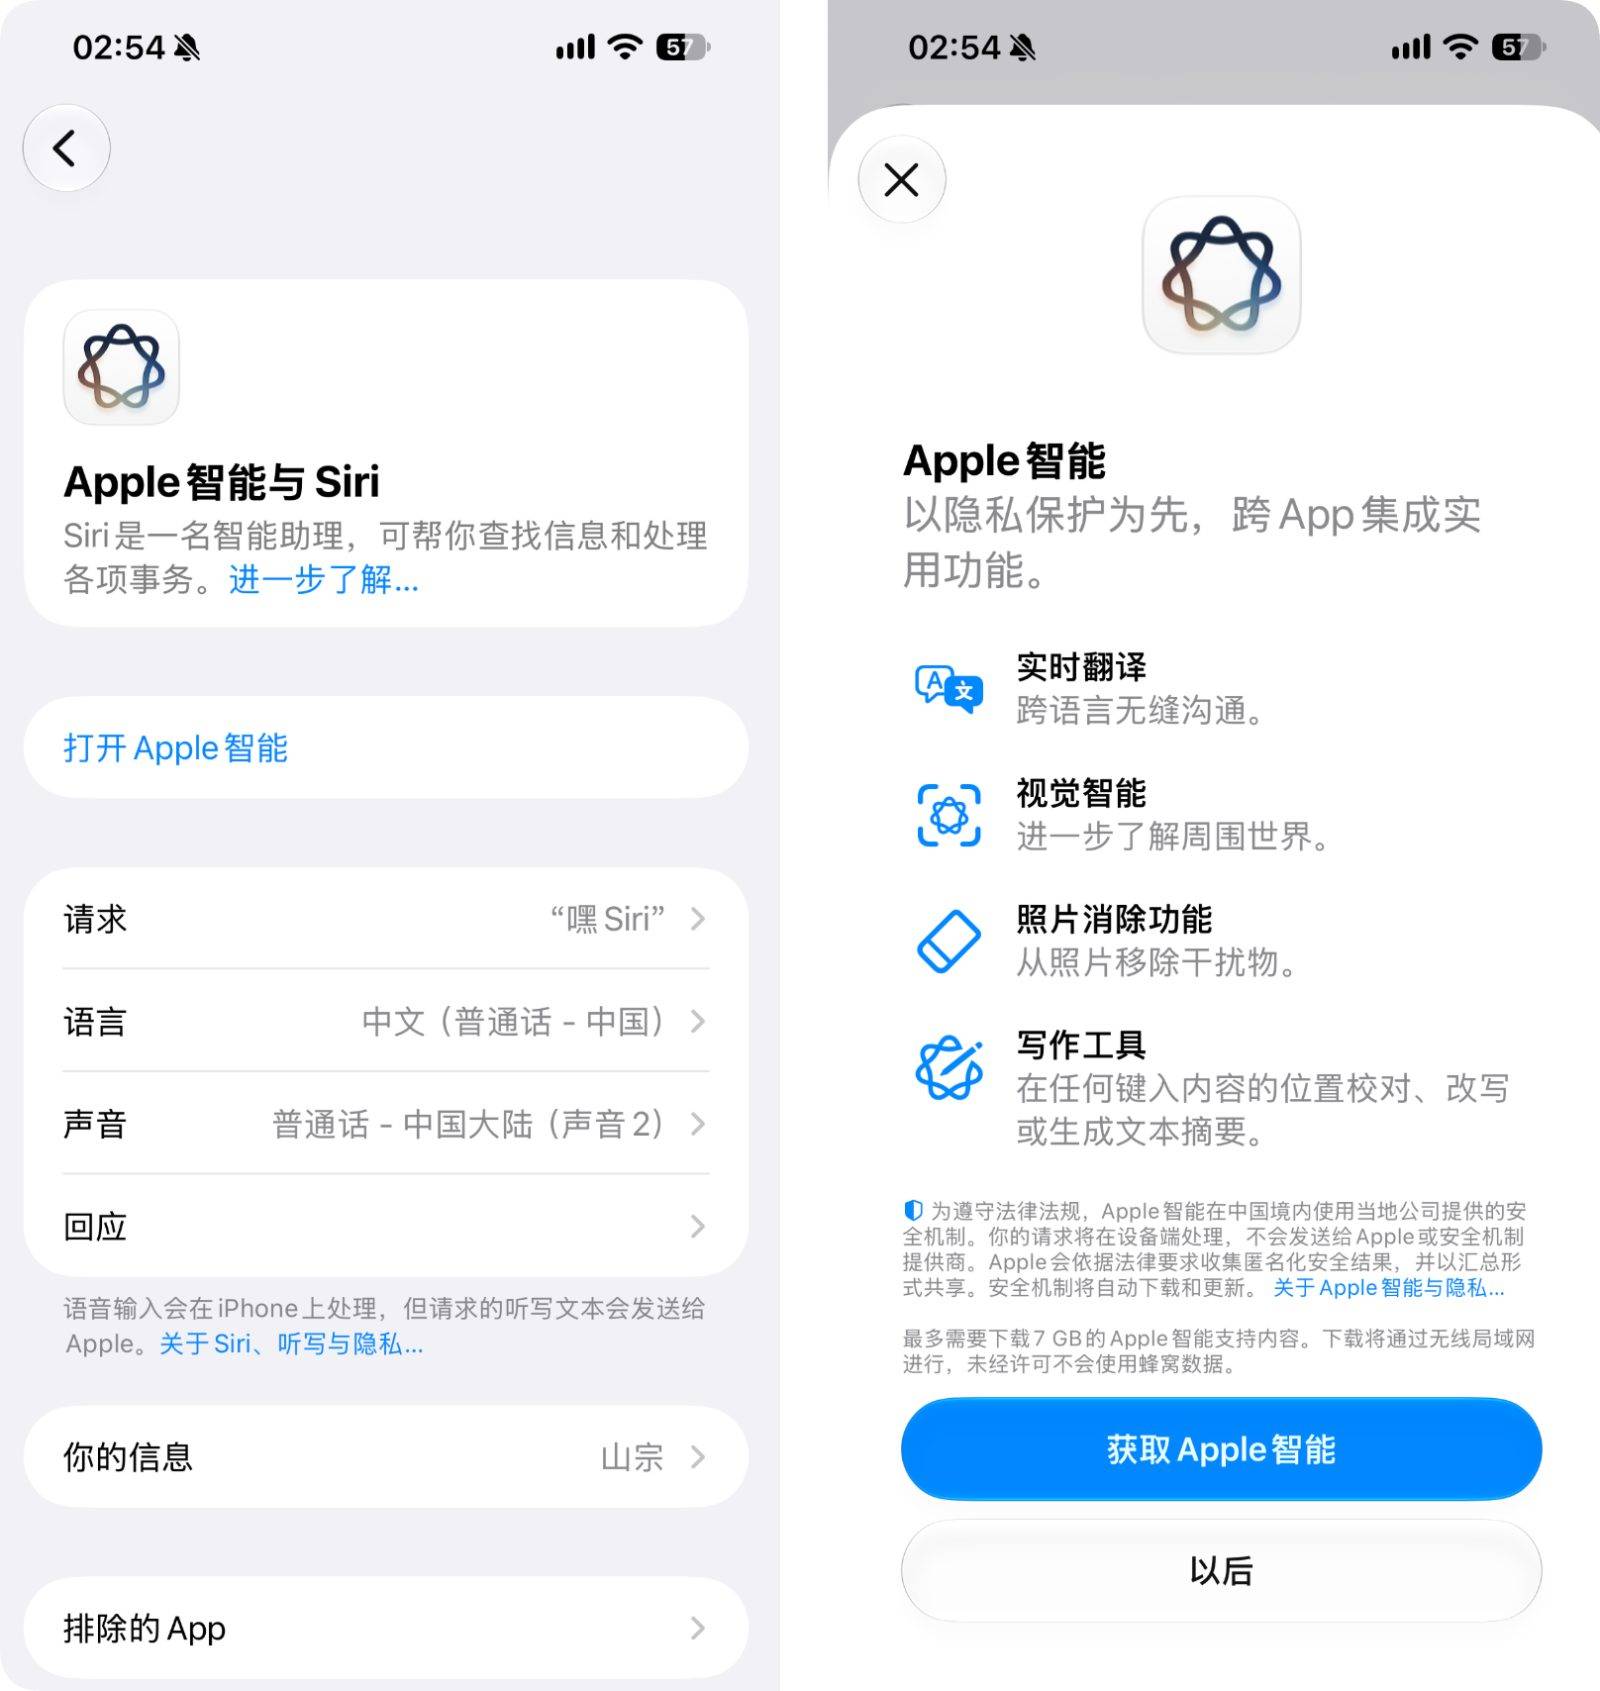
今天凌晨,苹果推送 iOS 27.3 首个开发者测试版,国行「Apple 智能与 Siri」开始开放体验。
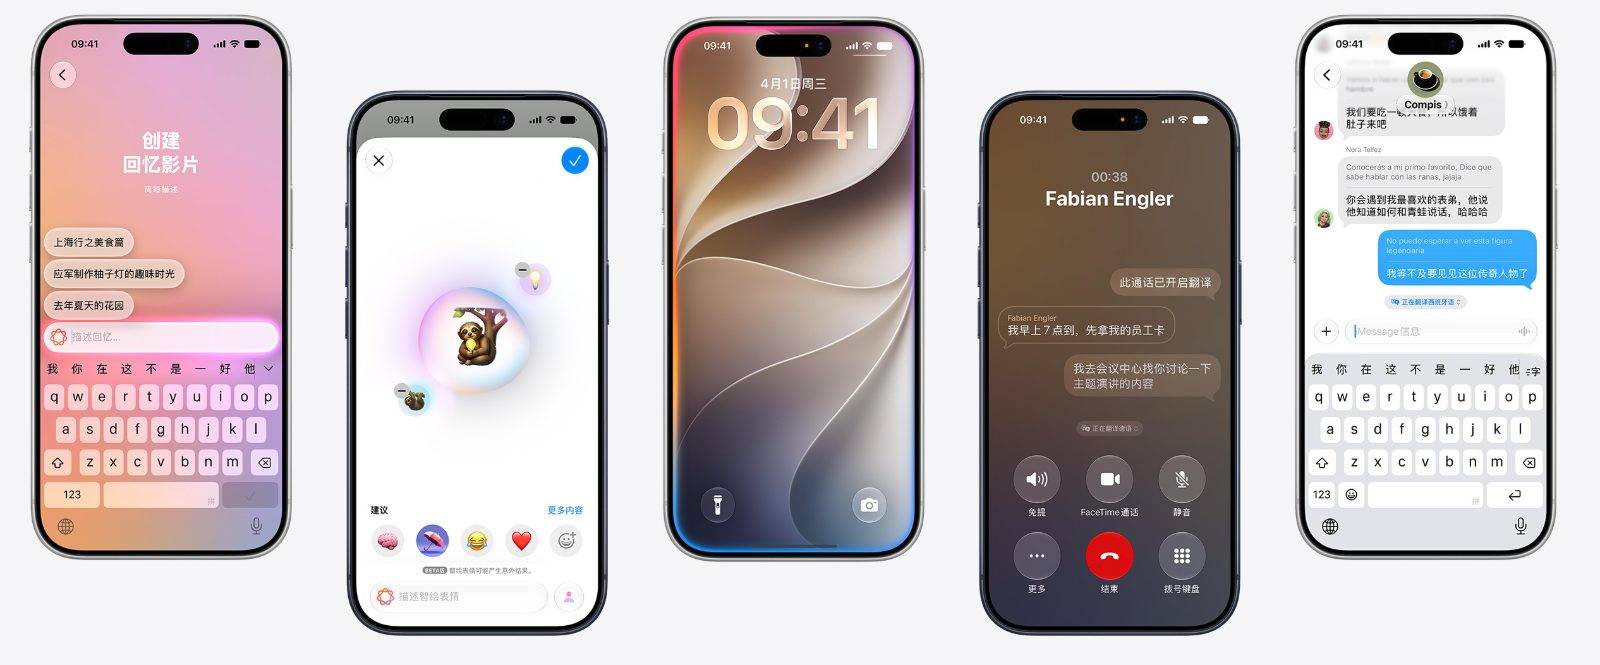
苹果中文官网列出的首批功能包括写作工具、实时翻译、照片消除、智绘表情及通知摘要。
千问被整合进 Siri、视觉智能和写作工具,用户可在系统内提问、生成文本或处理图像。
据爱范儿实测,视觉智能的以图搜物还接入了百度搜索。Siri 换上环绕屏幕边缘的光晕,并支持双击屏幕底部切换为文字输入。
在 Siri 中,基础问答可直接完成。以「最近总是睡不好」为例,Siri 会调用千问给出通用睡眠建议。
如需更个性化的方案,用户可点击千问 Logo 跳转至千问 App,对话信息会自动同步。据了解,千问可结合用户此前的睡眠记录、运动情况和生活习惯制定改善方案。
实时翻译覆盖信息、电话和 FaceTime,其中电话与 FaceTime 限一对一通话。AirPods 翻译需适配耳机更新至最新固件,并与启用 Apple 智能的 iPhone 配对。
首批功能适用于 iPhone 15 Pro 系列、iPhone 16 全系列及后续机型,以及 iPhone Air、iPhone Duo,Siri 和设备语言须设为简体中文或英语。
值得注意的是,此次国行更新提供的是首批 Apple 智能功能,WWDC 2026 预告的新版 Siri AI 未包含在内。
 相关阅读:
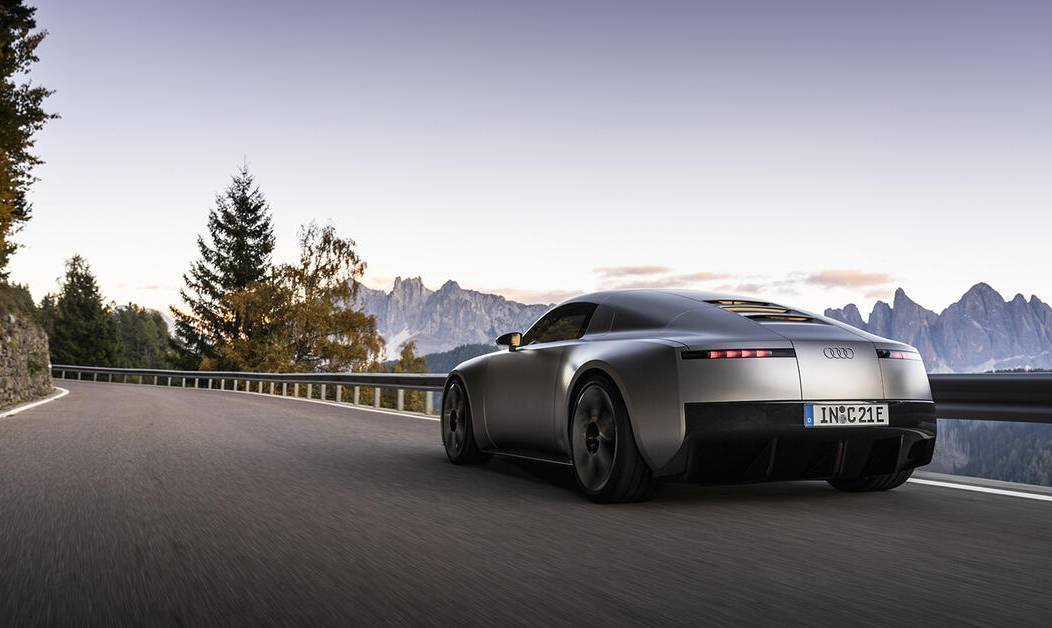
抱紧「大腿」!奥迪的全新纯电跑车,本质是一辆保时捷
奥迪的两门跑车席位已经空了近三年,如今帮它补上这个空缺的,竟然是保时捷。
在保时捷的第三季度财报电话会议上,首席财务官约亨·布雷克纳(Jochen Breckner)公开谈到了奥迪的这个新项目:
我们正将下一代 718 Boxster 和 Cayman 的纯电平台提供给奥迪的一个新项目使用。奥迪内部将这个项目称为 C-Sport,我们也会从对方那里收到一笔费用,预计于 2027 年到账。
对奥迪来说,这笔钱换来的不只是一套纯电平台,更是一条重返跑车市场的捷径。
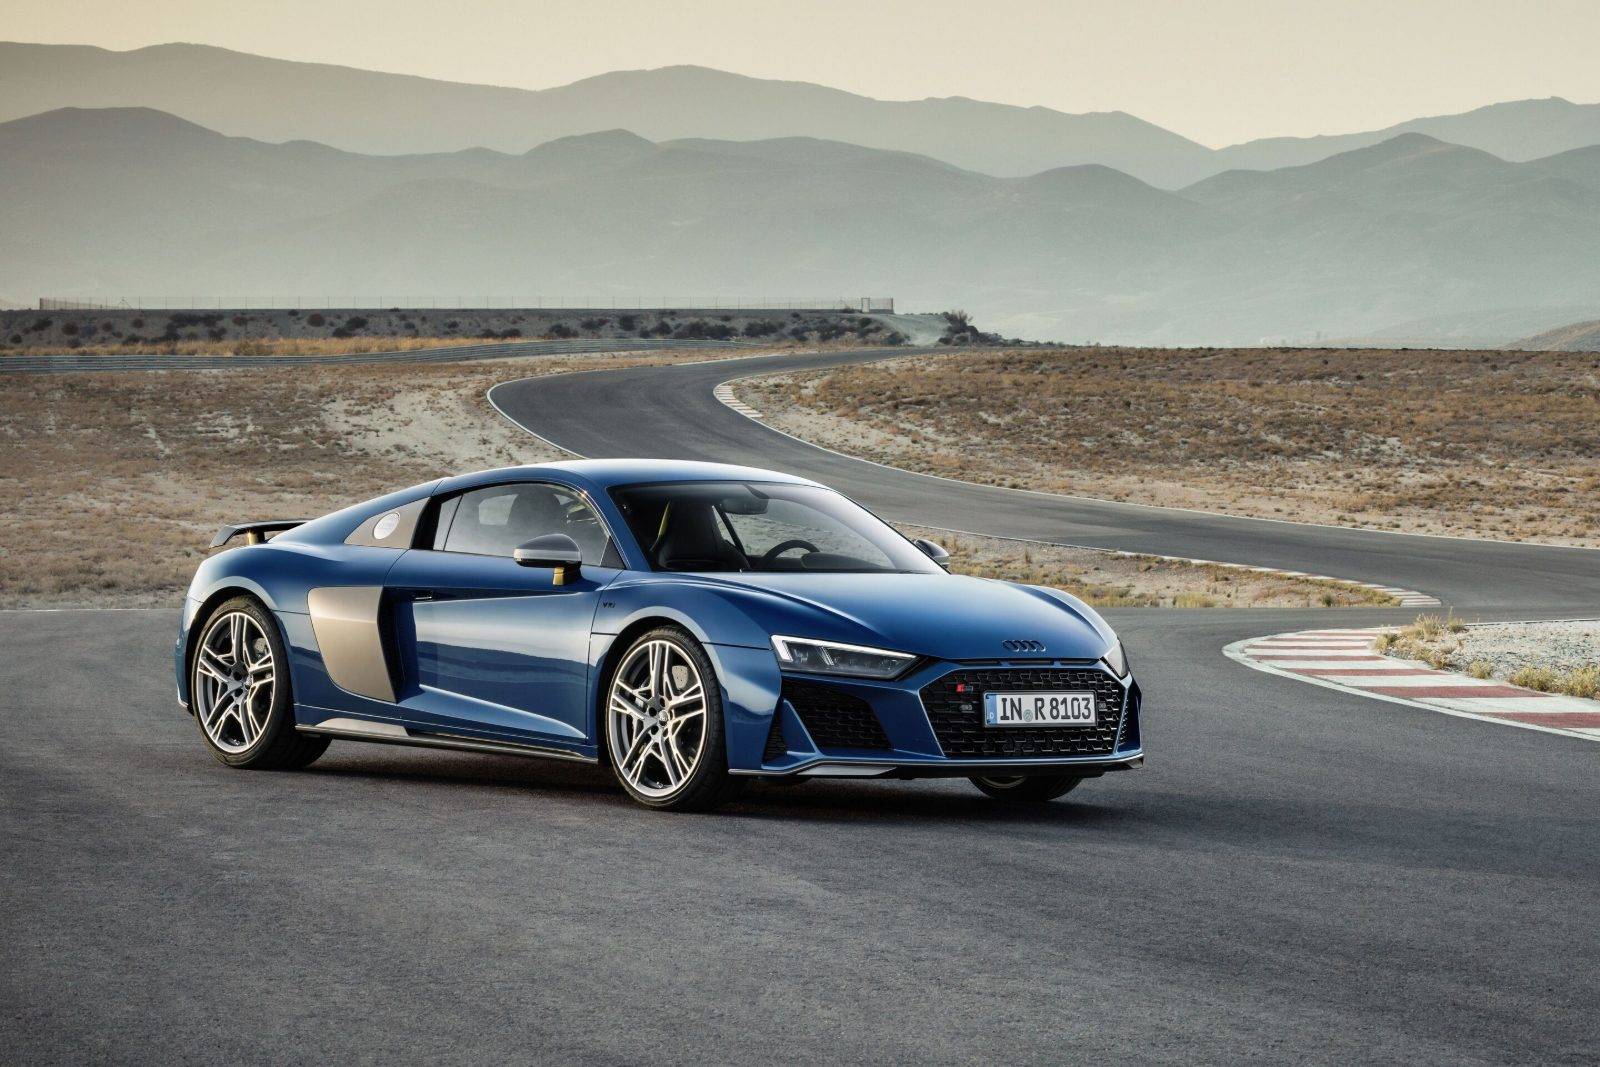
2023 年,两门小跑车 TT 停产,同年停产的还有搭载 V10 自然吸气发动机的旗舰跑车 R8。虽然奥迪产品线里还有 RS6 Avant 撑场面,但对于一家拥有赛道积淀的豪华车企来说,展厅里少了一辆吸睛的双门跑车,运动形象总显得有些单薄。
问题在于,专为一款双门跑车开发纯电平台并不划算。
双门跑车市场容量有限,仅凭奥迪一家的销量,很难摊薄纯电平台的研发成本;而低矮的专用跑车架构,在电池包排布、整车散热和轻量化等方面的要求,又比普通轿车更加复杂,投入只会更高。
恰逢大众集团正在执行力度空前的降本增效,这也让奥迪与保时捷的这次合作,显得顺理成章。
用大车换小车
在大众集团内部,跨品牌共享平台与技术并不新鲜,奥迪也并非第一次通过这种合作模式造车。
早在上世纪 70 年代,保时捷开发前置后驱跑车 924 和 944 时,就找奥迪供应发动机等核心零部件;到了 90 年代,奥迪又和保时捷联手打造了曾经的性能图腾 RS 2 Avant。
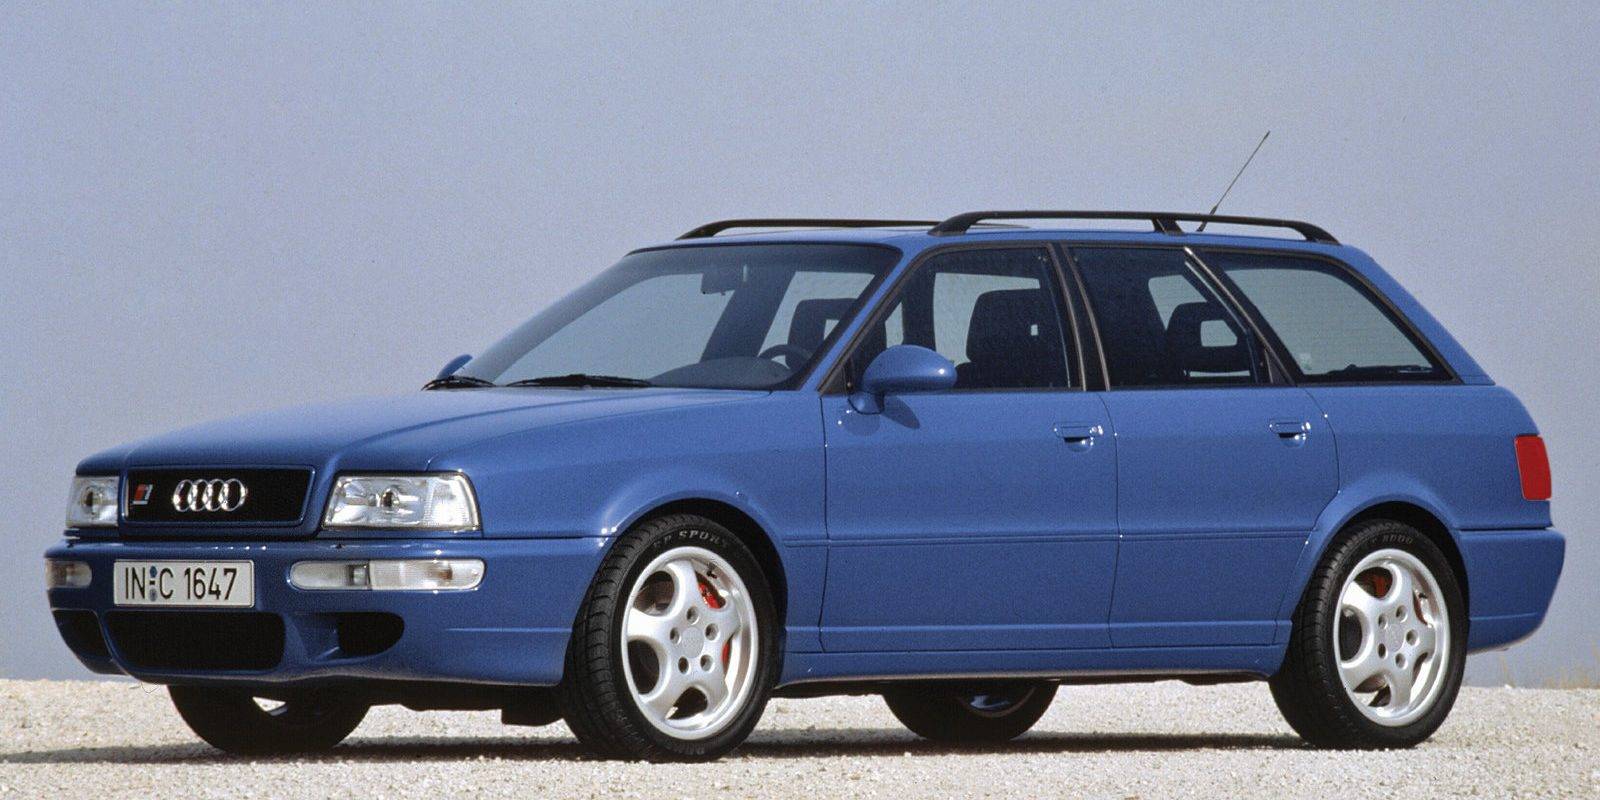
奥迪在超跑领域的「联姻」,就更为人所熟知了。
2007 年,大众汽车集团时任掌门人文德恩亲赴拉斯维加斯,参加了第一代奥迪 R8 的试驾。早在 2002 年担任奥迪董事会主席时,他就批准了这款车的量产计划,并一路推动其研发。
这款被寄予厚望的超跑同样没有从零开始,奥迪利用了大众集团在 1998 年收购兰博基尼后积累的成果,将第一代 R8 建立在 Gallardo 的技术底座之上,其全铝空间框架、中置发动机布局和全时四驱系统,都与后者一脉相承。
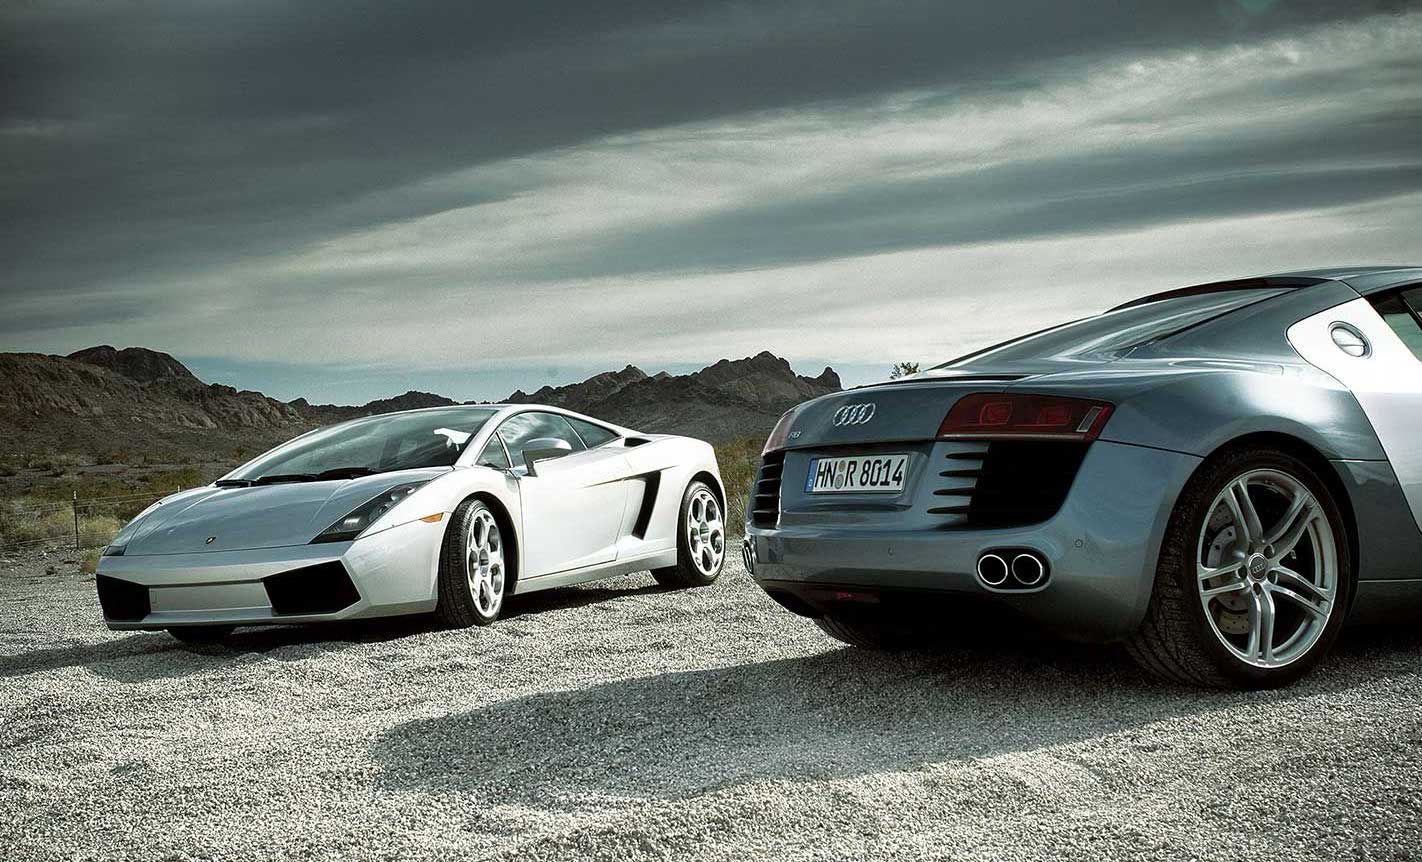
借此,奥迪进入了保时捷与法拉利盘踞的跑车腹地,实现了奔驰和宝马当时未能完成的产品突破。更难能可贵的是,奥迪并没有把 R8 做成另一辆 Gallardo。
当时的 Gallardo 和法拉利 F430 都属于典型的「周末跑车」,底盘紧绷,座舱狭窄;奥迪瞄准的则是保时捷 911 所统治的 daily driver 市场:既能下赛道,也能每天开着代步。
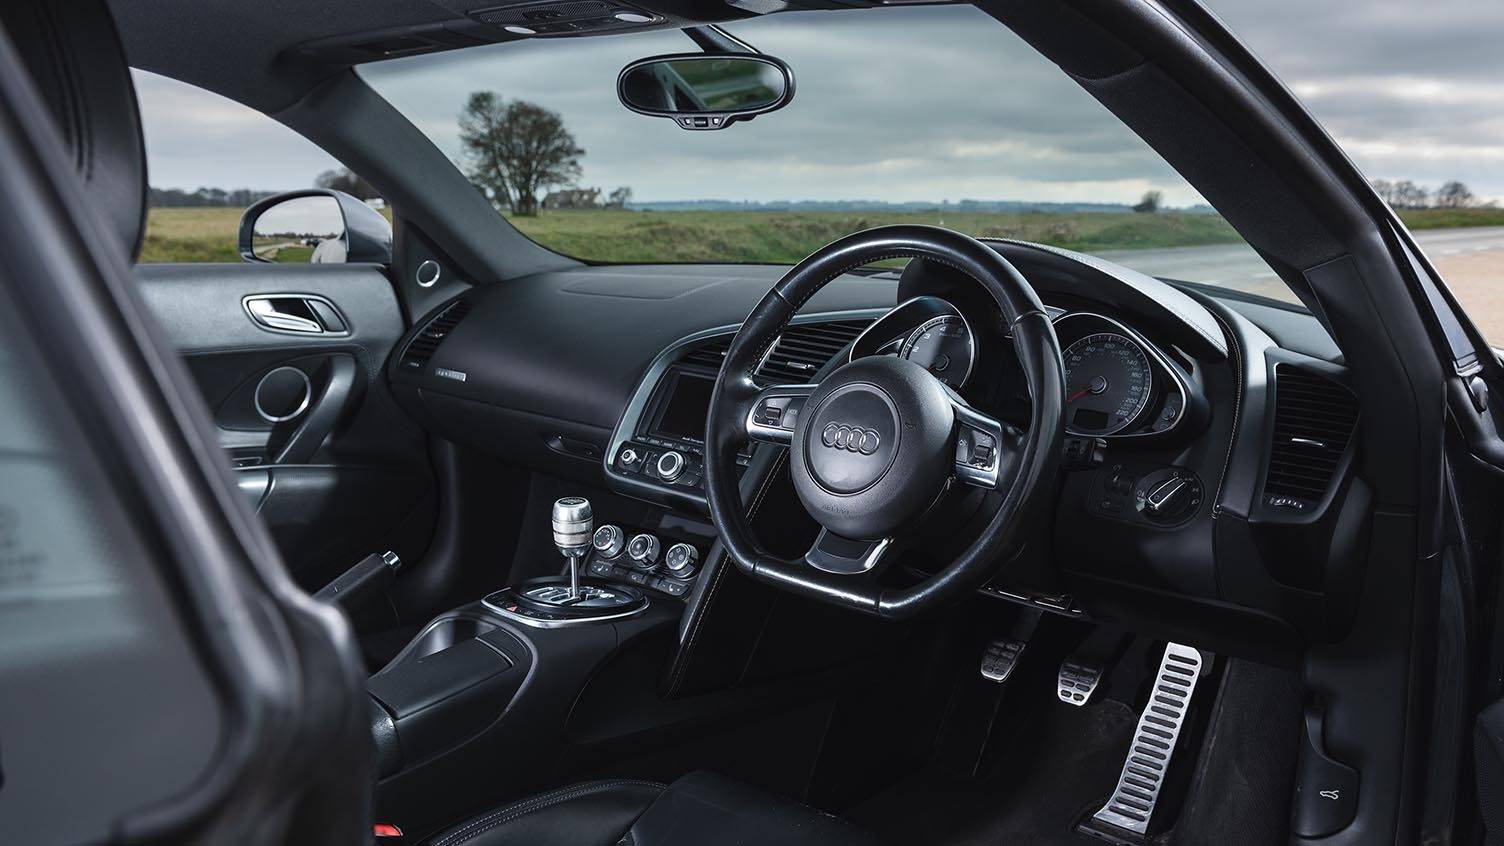
为此,工程师将 Gallardo 的底盘轴距加长了 89 毫米,并采用更柔和的底盘调校,让 R8 在弯道里更加稳定,也更适合日常使用。
价格上,当时的 Gallardo 和 F430 普遍超过 17 万美元,第一代 R8 则落在 11 万至 12 万美元区间,精准咬住高配保时捷 911。日常易驾的特性加上出色的性价比,让 R8 迅速在市场上站稳了脚跟。
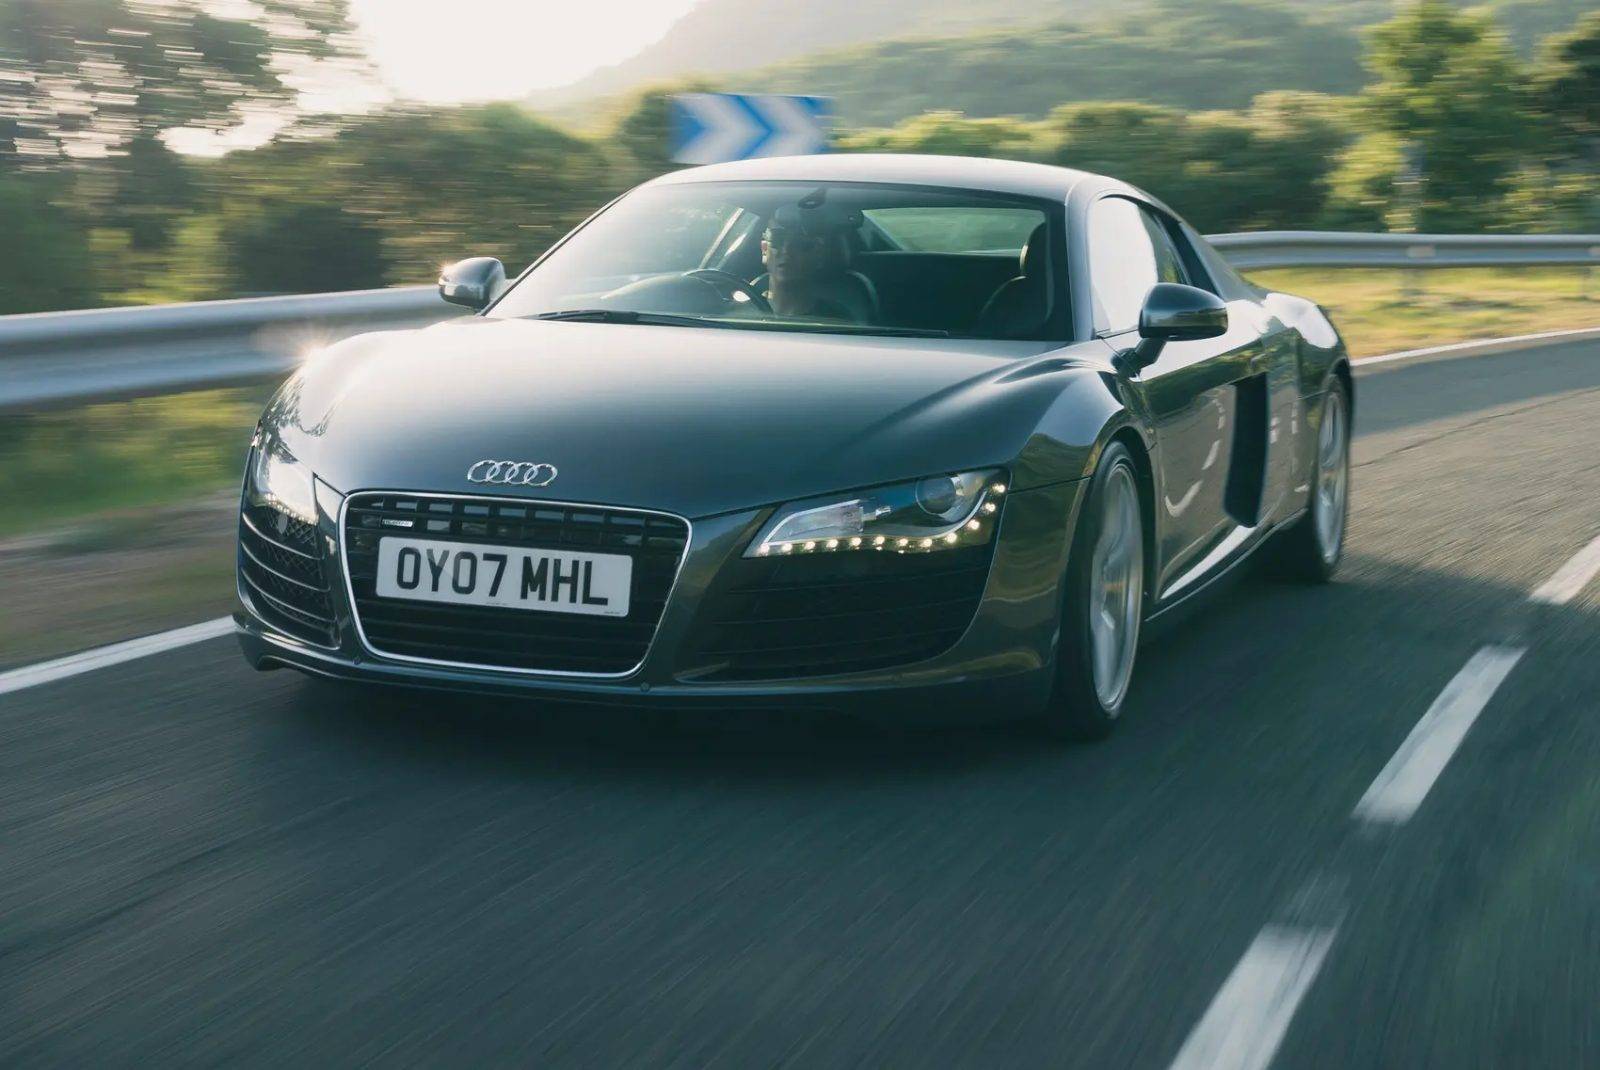
如今,奥迪与保时捷在纯电跑车上的合作,延续了当年的协同模式。奥迪首席执行官高德诺对此毫不避讳:
这是奥迪身为大众集团一员所拥有的一大优势。
按照他的介绍,奥迪和保时捷的合作并不局限于纯电跑车,而是建立在大众集团内部长期的研发分工之上。
一直以来,奥迪主要负责的都是 SUV 车型的研发。早期的 MLB Evo 架构不仅用于奥迪 Q7,也衍生出了保时捷 Cayenne、兰博基尼 Urus 和宾利添越。进入电气化时代后,奥迪主导开发的 PPE 纯电平台同样应用在保时捷纯电 Macan 上。
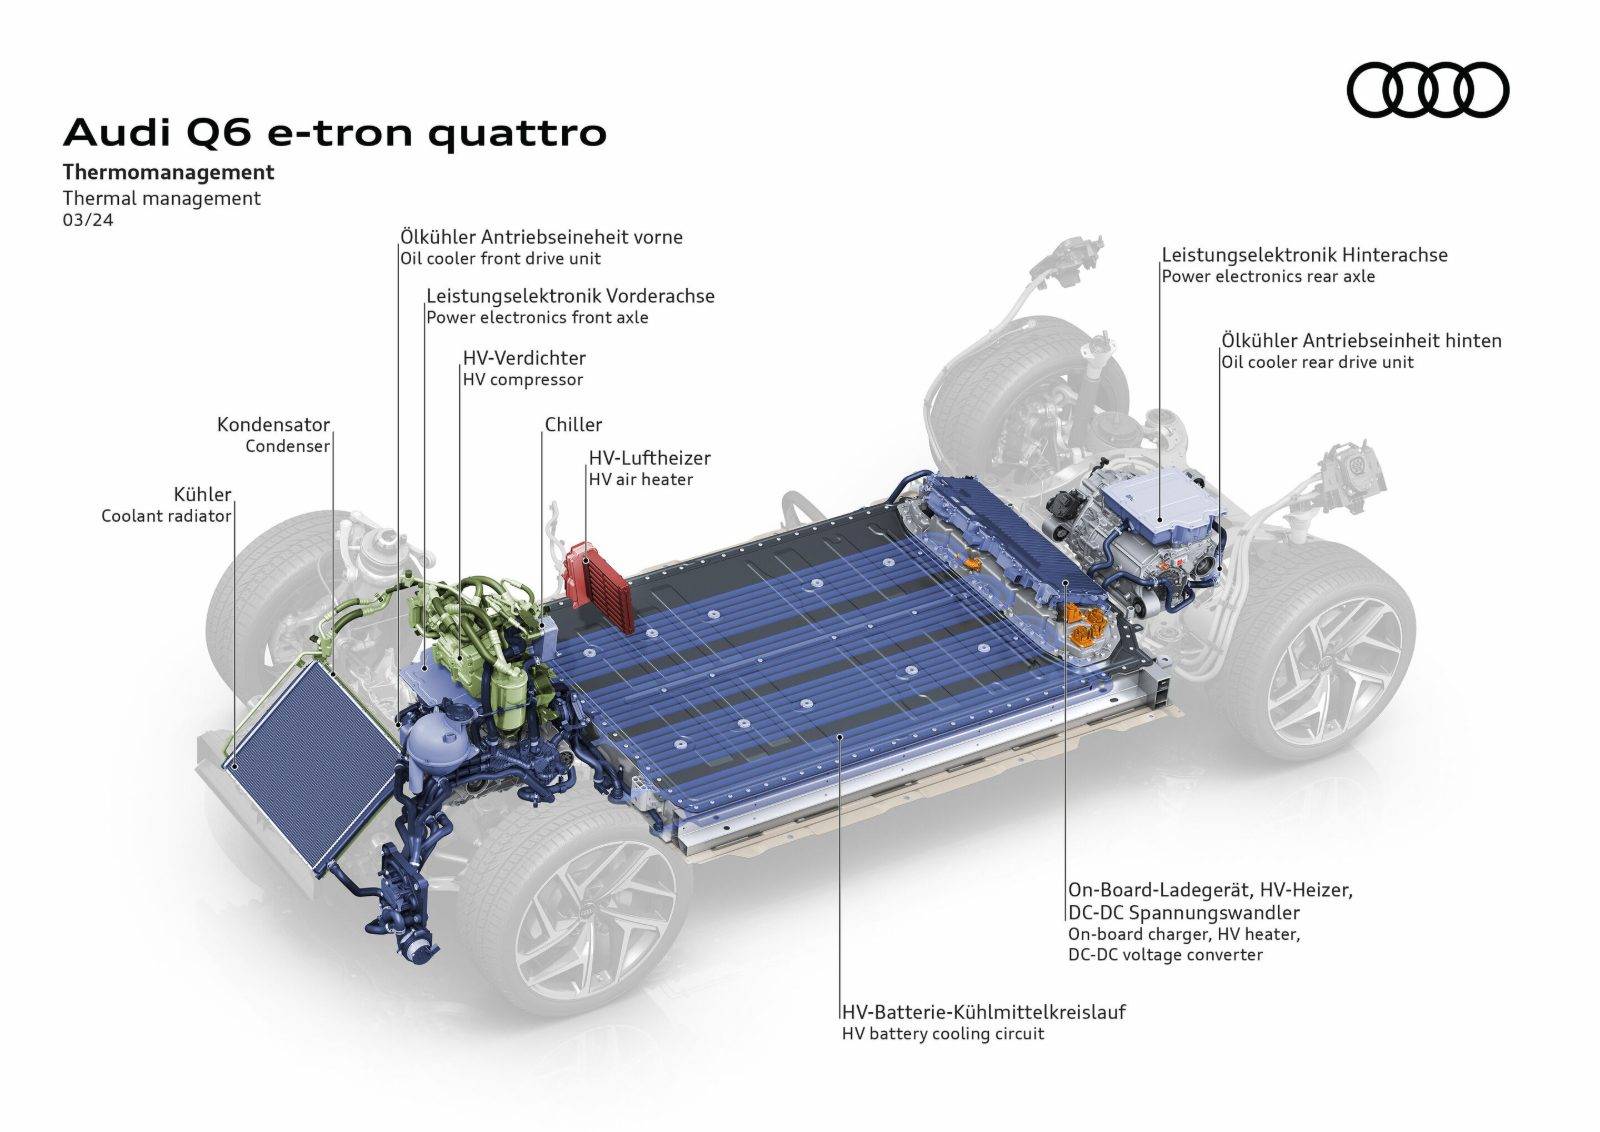
而且接下来,很快我们就可以看到挂着保时捷 logo 的奥迪 Q9 了。
换句话说,奥迪负责研发走量、利润丰厚的大型 SUV,并将这些成果共享给兄弟品牌;相应地,保时捷则输出专属跑车的底盘技术,帮助奥迪打造形象产品。
这种双向的技术流动,让奥迪无需背负整套专属底盘的研发成本,便能重返两门跑车市场。
奥迪找到了自己的风格
虽然和保时捷共用底盘,但奥迪仍在车身形态和座舱设计上,为新车保留了足够的辨识度。
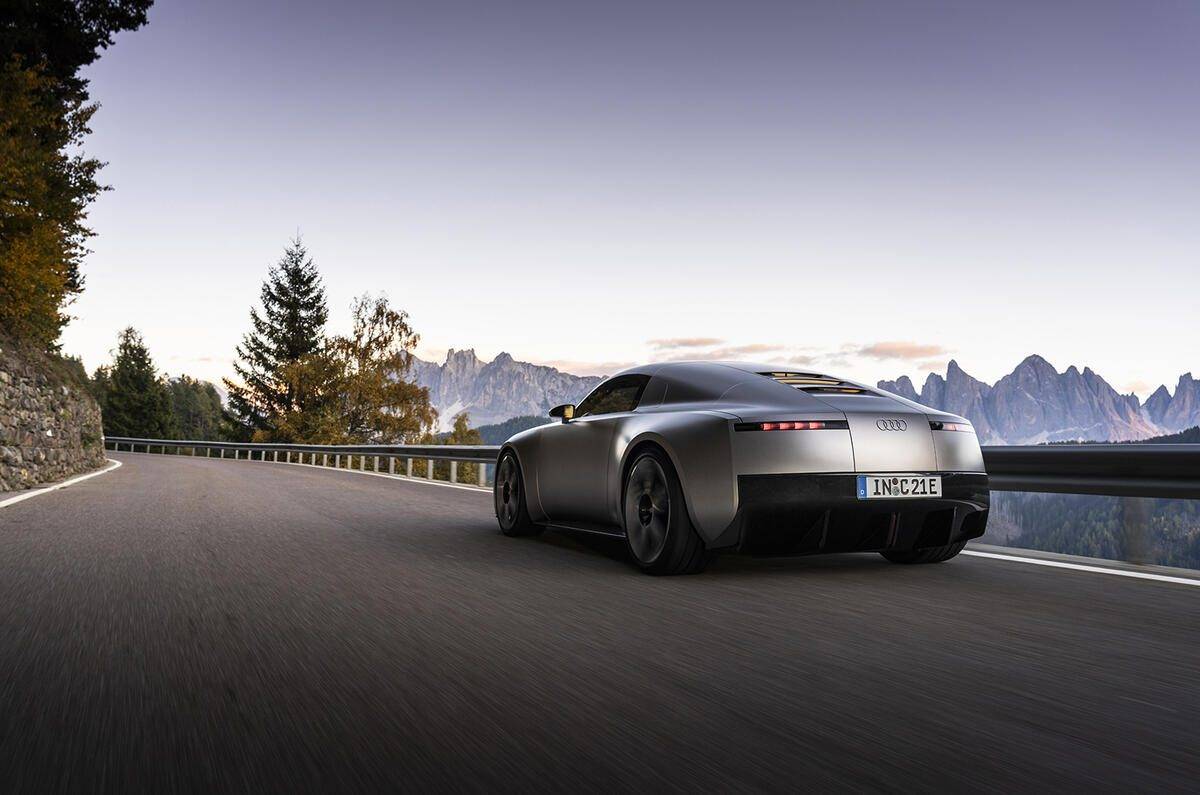
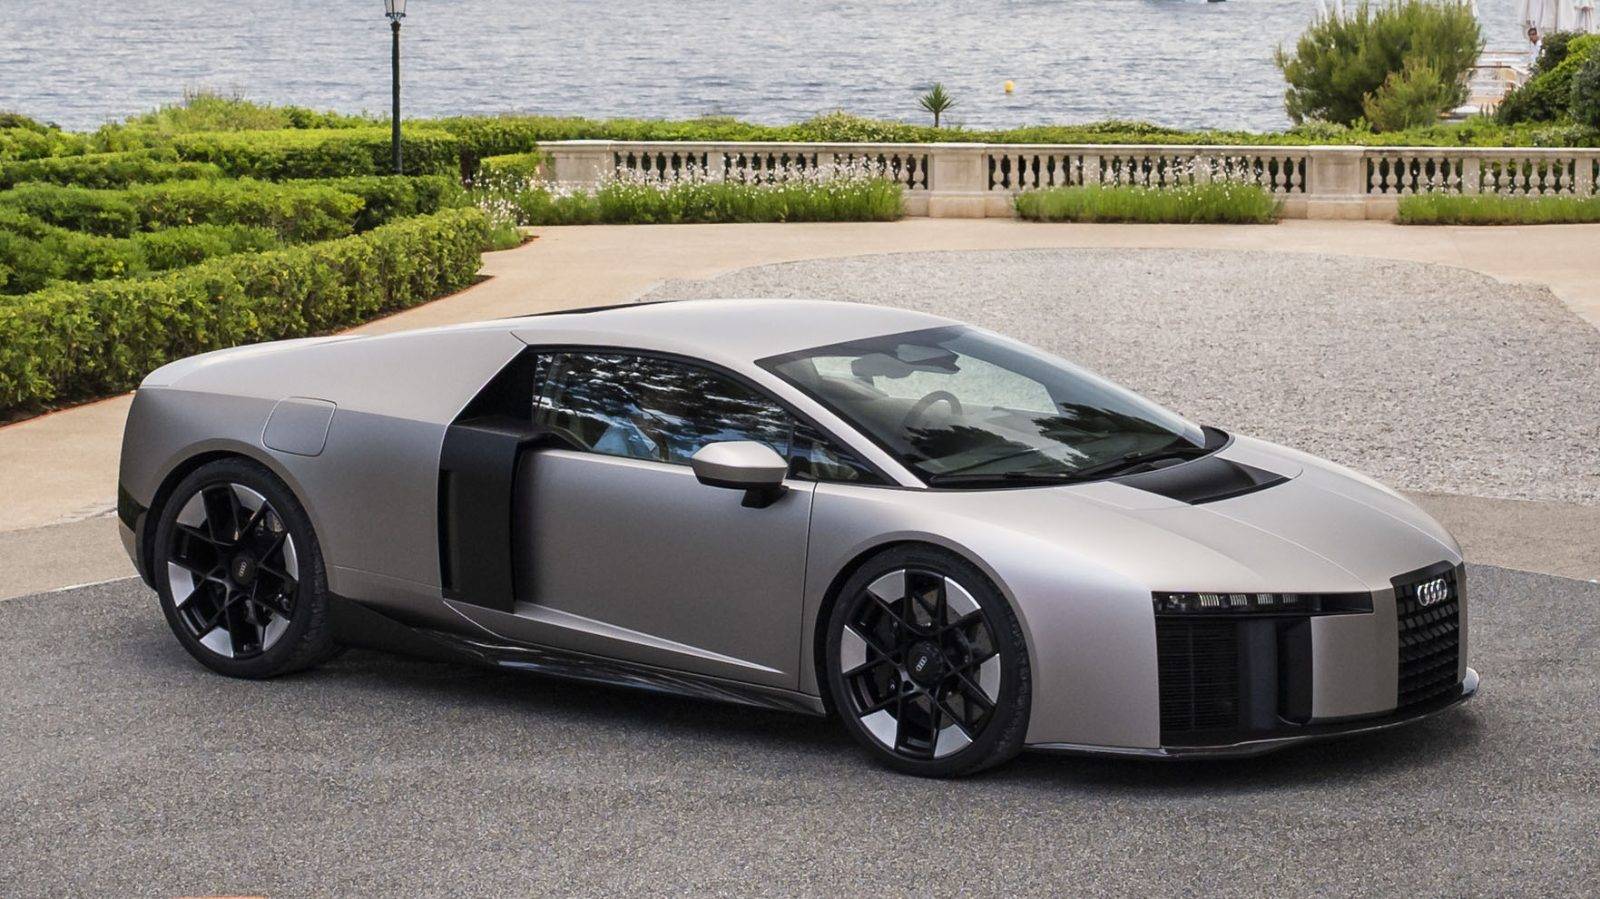
根据已知的产品规划,下一代纯电保时捷 718 会继续沿用 Boxster 的折叠软顶与 Cayman 的固定硬顶。奥迪则会基于此前在慕尼黑车展亮相的 Concept C 概念车开发,采用电动收折的 Targa 敞篷结构。
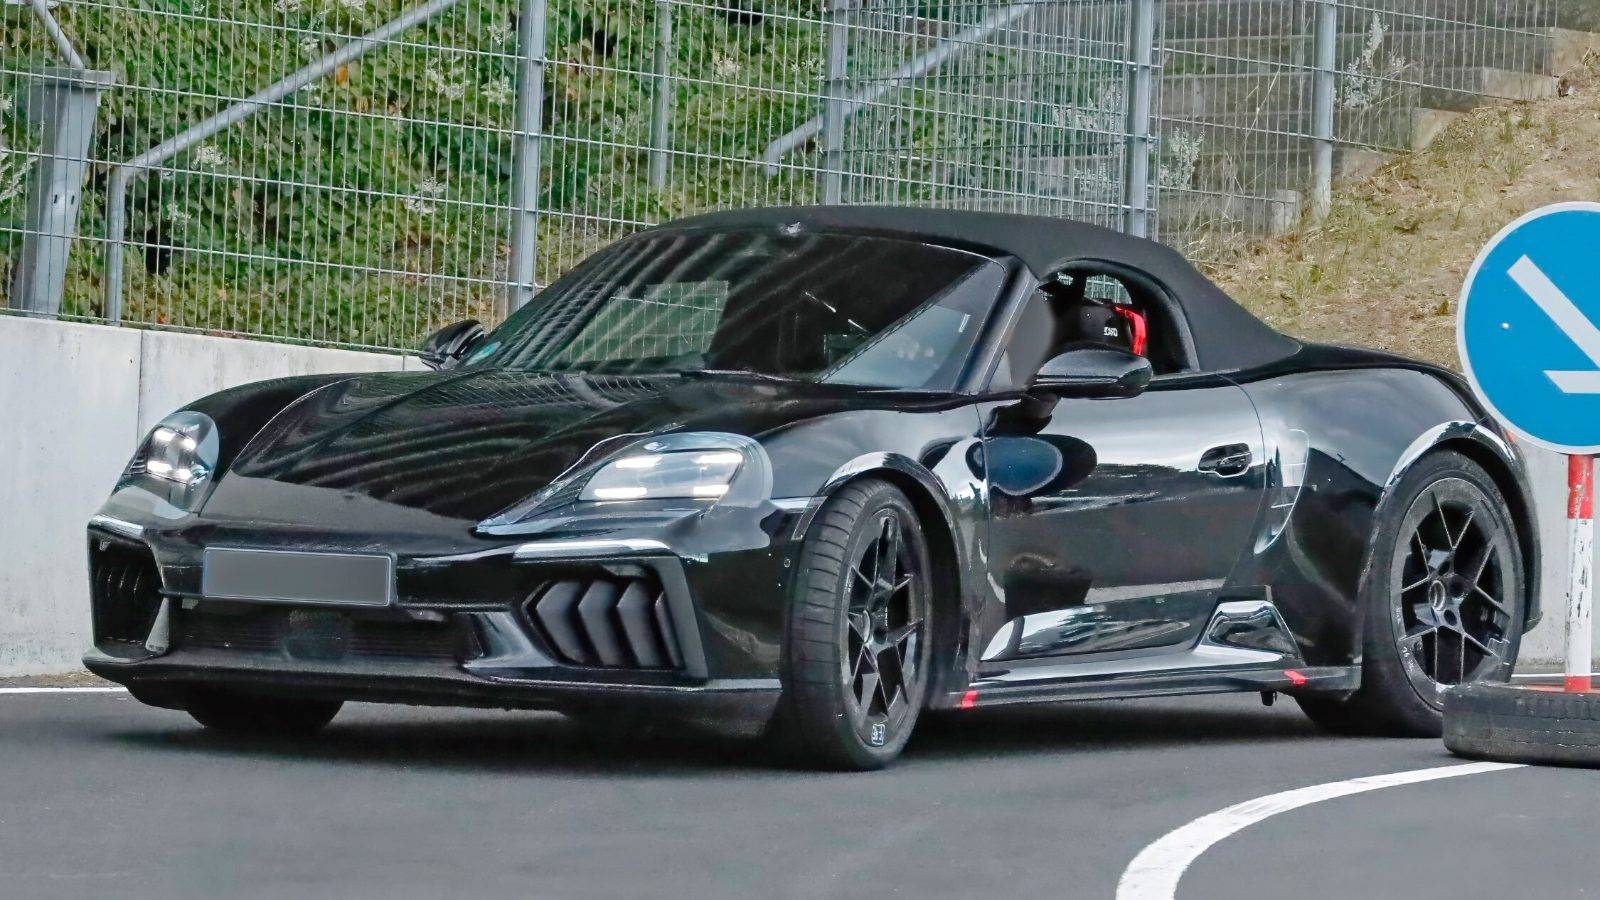
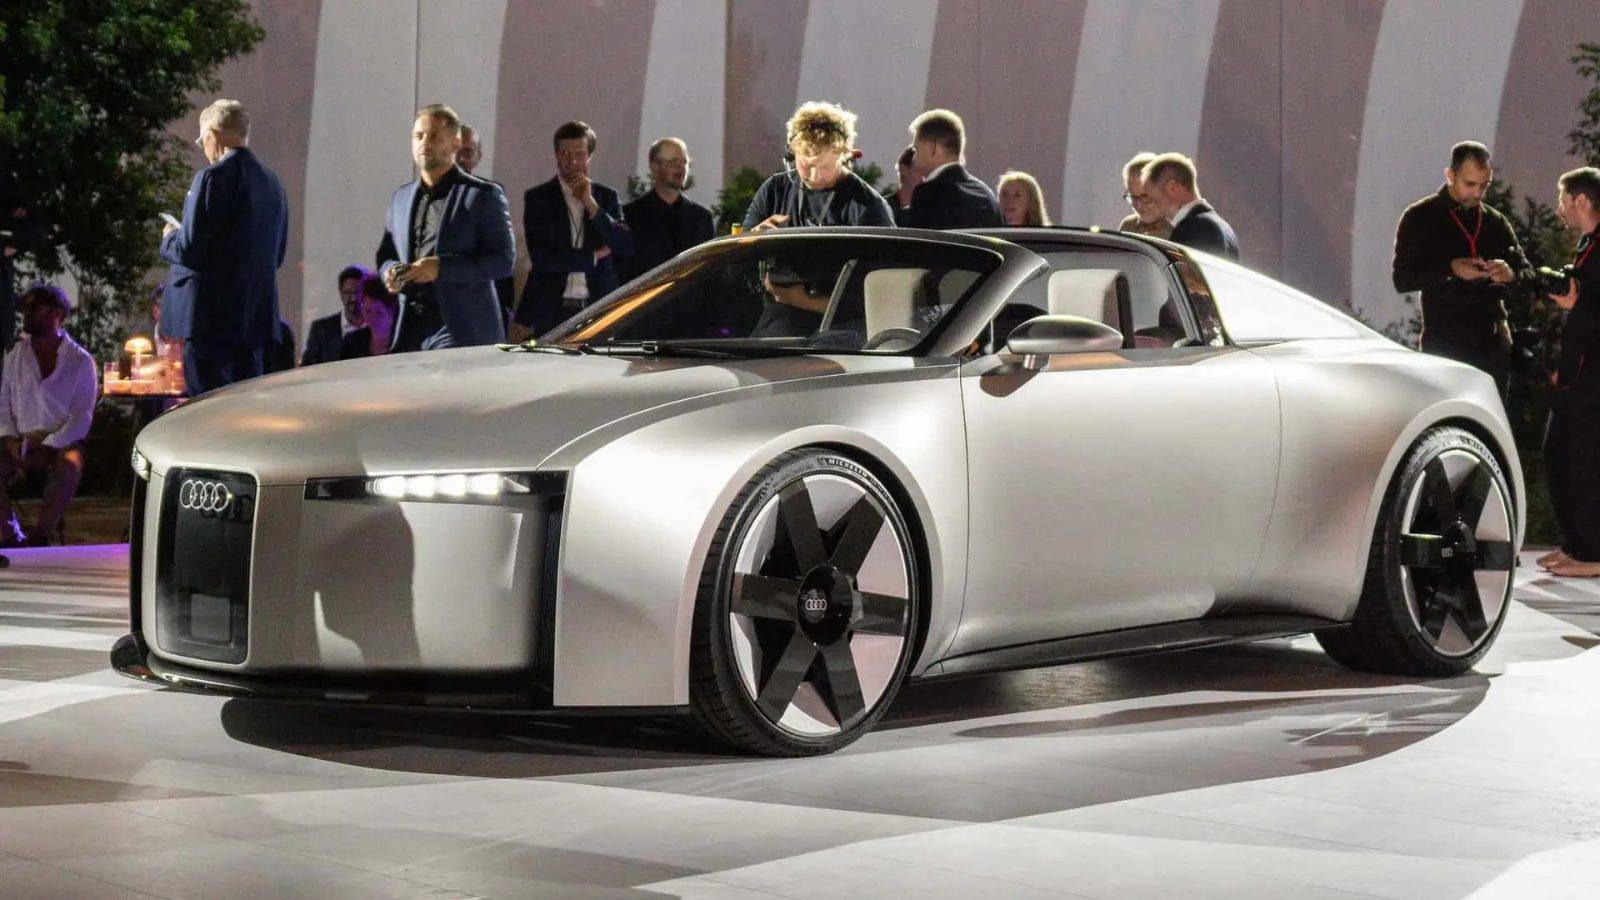
有意思的是,那辆概念车本身已经相当成熟, C-Sport 这个名字却带着几分临时起意的随意。
高德诺在采访中透露,由于概念车的开发推进得太快,他们甚至还没来得及确定正式名称,只能暂时使用这个代号。至于量产版本,未来可能会以字母 R 开头,也可能启用一个全新的独立名字,但绝不会沿用 TT 的称谓。
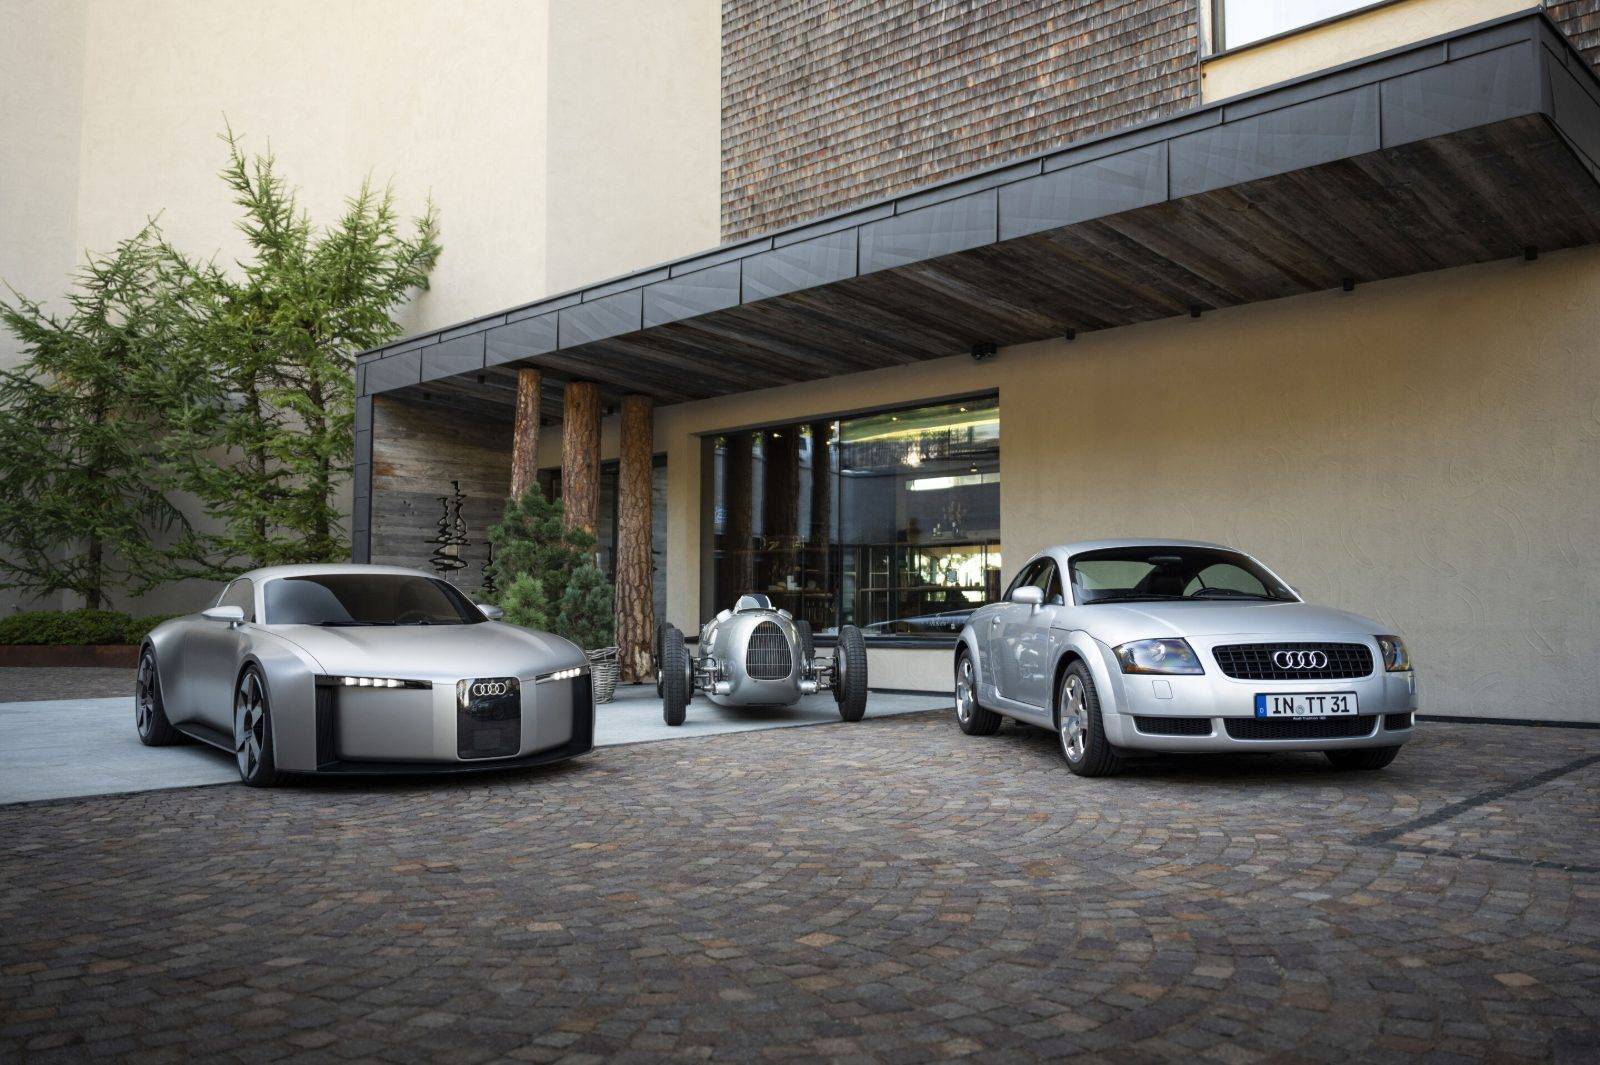
车身规格上,我们可以参考概念车 Concept C,它的长宽高分别为 4520 毫米、1970 毫米和 1285 毫米,体量明显大于小巧的 TT,车宽甚至超过了停产的 R8。
按照高德诺的说法,无论尺寸还是性能, C-Sport 都介于 TT 和 R8 之间。
奥迪做出的另一处明显改变,发生在座舱里。
过去几年,奥迪主力车型普遍采用由三块液晶屏构成的座舱,配合大面积黑色高光面板与电容触控按键。这套设计在实际使用中不仅容易留下指纹,触控反馈也不如传统机械结构直观。
在 C-Sport 上,奥迪改变了这一思路。新车削减了屏幕的视觉占比,空调控制、风量调节以及常规驾驶功能全部换回了独立的旋钮与拨杆。
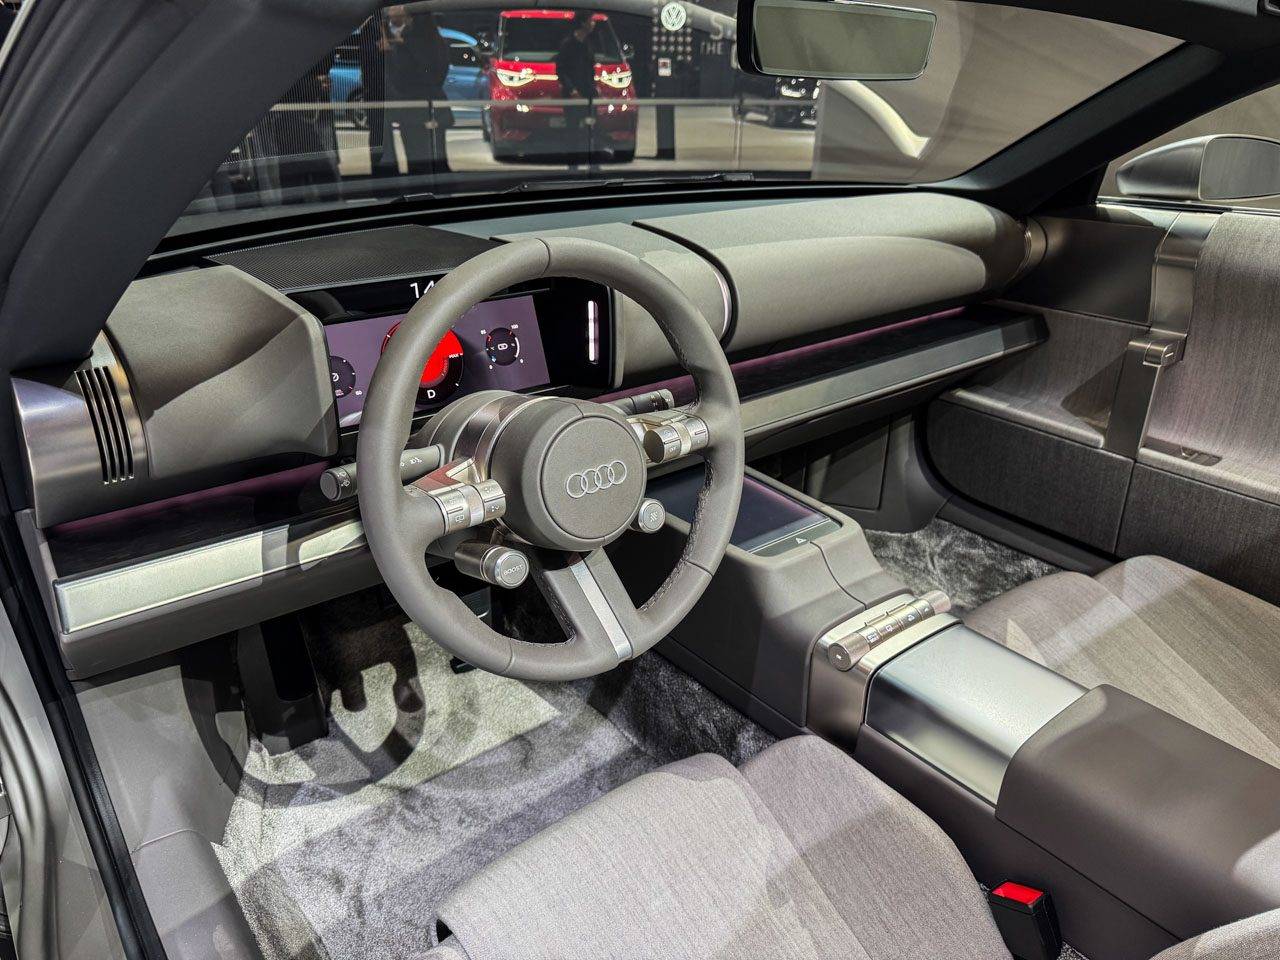
同时,内饰材料也减少了对亮面塑料的依赖,改用实心铝制部件与带有阻尼段落感的金属开关。奥迪希望用更直接、更考究的触觉交互,取代对屏幕和触控面板的过度依赖。
你看,奥迪解决的都是设计和交互上的问题, C-Sport 能否保留跑车低矮的坐姿,则要看保时捷对底层架构的处理。
保时捷给出的方案很简单,就是把电池从底盘里抽出来,放到原本发动机所处的位置,就类似工匠派的那台小跑车 SC01。
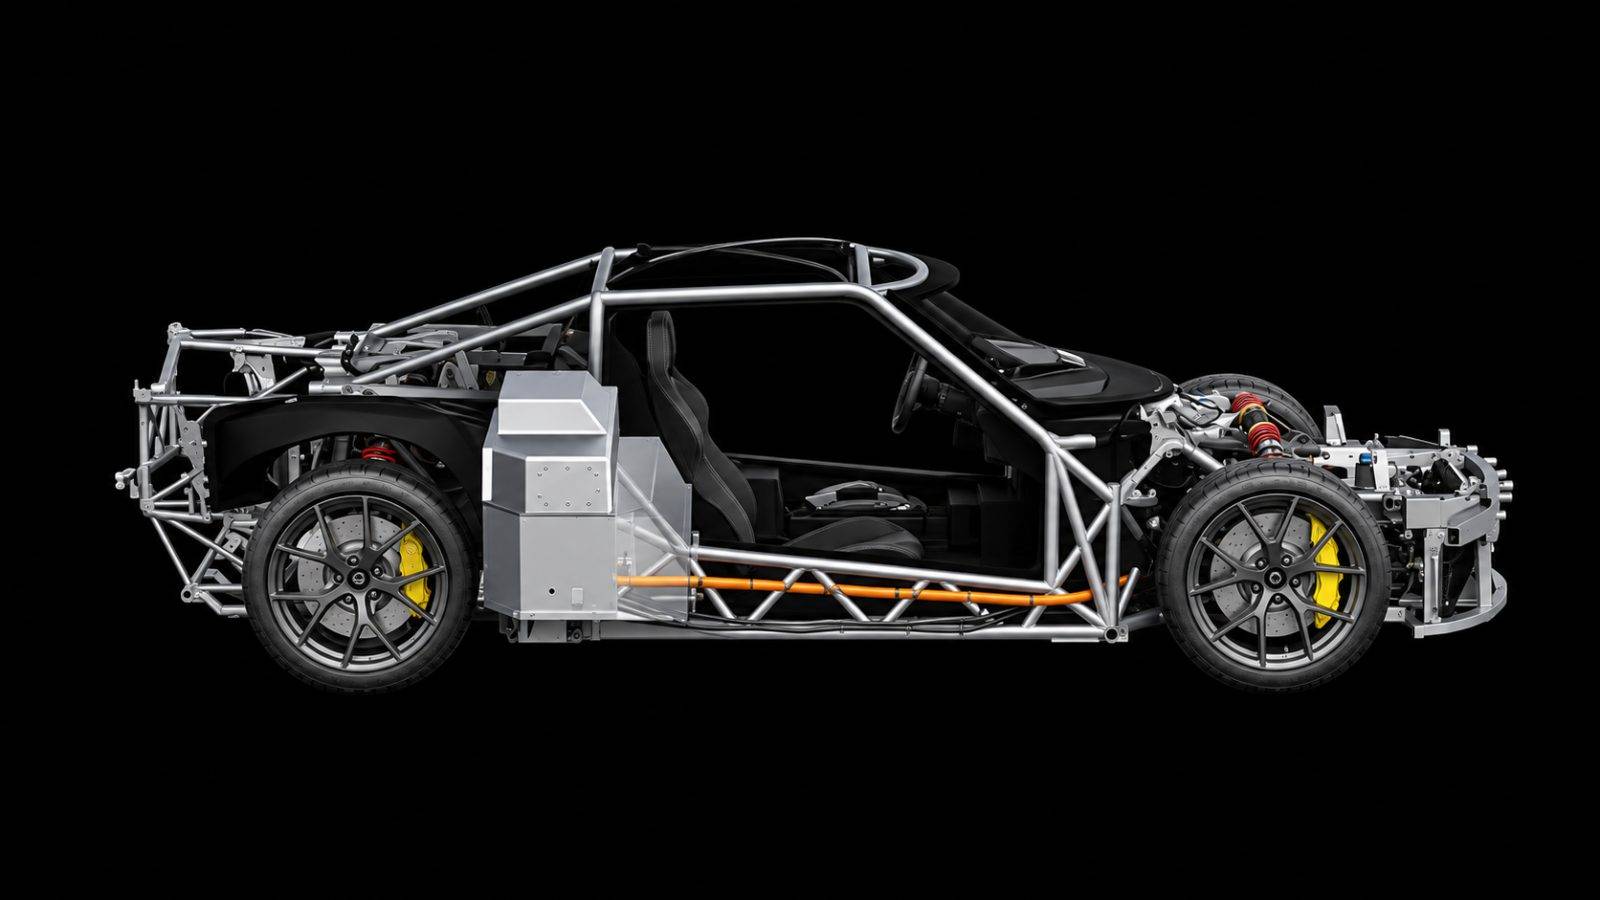
这样的布局既压低了驾驶坐姿,也还原了燃油中置跑车的前后轴配重比例,同时有助于降低前机盖,改善视野。
模拟五缸声浪,迎接万转旗舰
除了设计,奥迪还要解决另一个问题:纯电跑车缺乏驾驶参与感。
电机的动力响应充沛而平顺,却也少了变速箱换挡时的动力断续,以及发动机的排气声浪。因此在激烈驾驶时,驾驶员很难获得同等的情绪调动。
高德诺的想法和现代一样,既然缺了变速箱,那就给它加一个。
我们发现模拟变速箱和声浪确实能为驾驶电车增添很多乐趣。即使在赛道上,开着带模拟变速箱的车我也能跑得更快。
有过一定赛道经验(或者极品飞车经验?)的朋友都知道,在赛道上判断车速都是通过档位,而非时速表。即便不跑赛道,模拟变速箱带来的动力切断和转速落差,也能极大丰富驾驶感受。
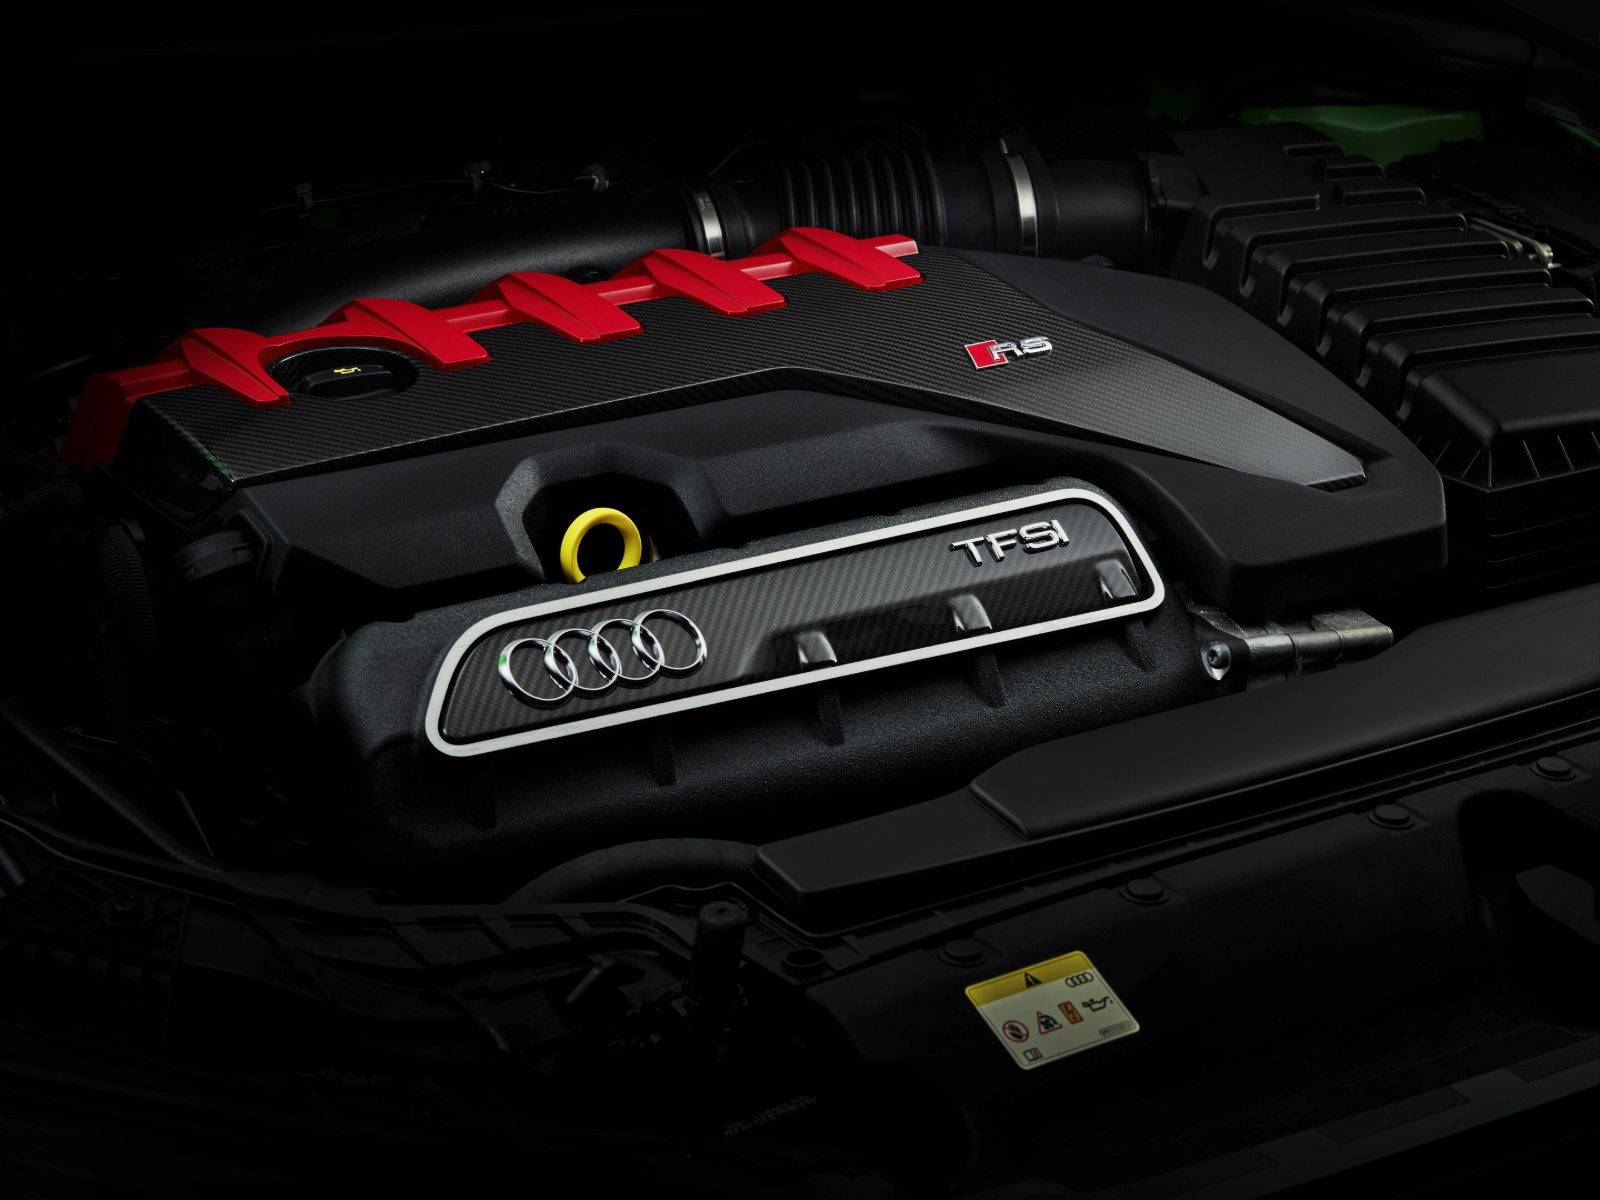
高德诺之前在 Top Gear 的采访里提到过一个具体方案:
通过软件算法,把奥迪 RS3 上那台经典的 2.5 升直列五缸涡轮增压发动机的声浪,复制到这台纯电跑车上。
在欧洲排放法规日益严苛的背景下,这台五缸发动机的前景并不乐观。把它的声浪搬进纯电跑车里,也算是奥迪留住品牌记忆的一种方式。
如果说模拟五缸声浪是在留住奥迪的过去,那么 Nuvolari 展示的,则是奥迪性能旗舰的未来。
2026 年 6 月,奥迪正式发布全新混动超跑 Nuvolari。和 R8 一样,它与兰博基尼共享了部分核心技术,但这次不是和「小牛」联姻了,而是「大牛」 Temerario。
Nuvolari 的动力系统由 4.0 升双涡轮增压 V8 发动机和三台电机组成,可以输出 1001 马力。这辆车全球限量 499 辆,明年上半年就会开始交付。
按照计划, C-Sport 项目的量产车同样也会在 2027 年推向市场。它与 Nuvolari,一个纯电、一个混动,一个借力保时捷、一个联手兰博基尼,分别补上了奥迪在双门小跑车和顶级性能旗舰上的空缺。
对奥迪而言,这不仅意味着跑车展台重新热闹起来,也再次证明了大众集团内部技术协同的价值。
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
连夜实测 iPhone 国行 AI,亮点和槽点都在这了
AI 手机圈最漫长的等待,终于结束了。这次,你一定要用上 Apple 智能(doge)。
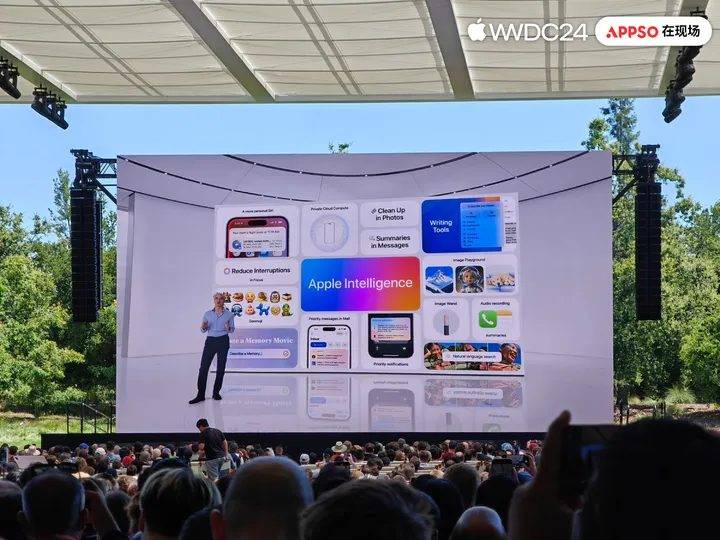
就在刚刚,苹果国行 AI 正式面向中国大陆用户开放开发者 Beta 版测试,并计划随 12 月发布的 iOS 27.3 正式推出。
从首批端上桌的功能来看,Apple 智能最大的看点,是将 AI 深度融入 iPhone 的日常使用场景,同时借助千问扩展复杂任务的处理能力。
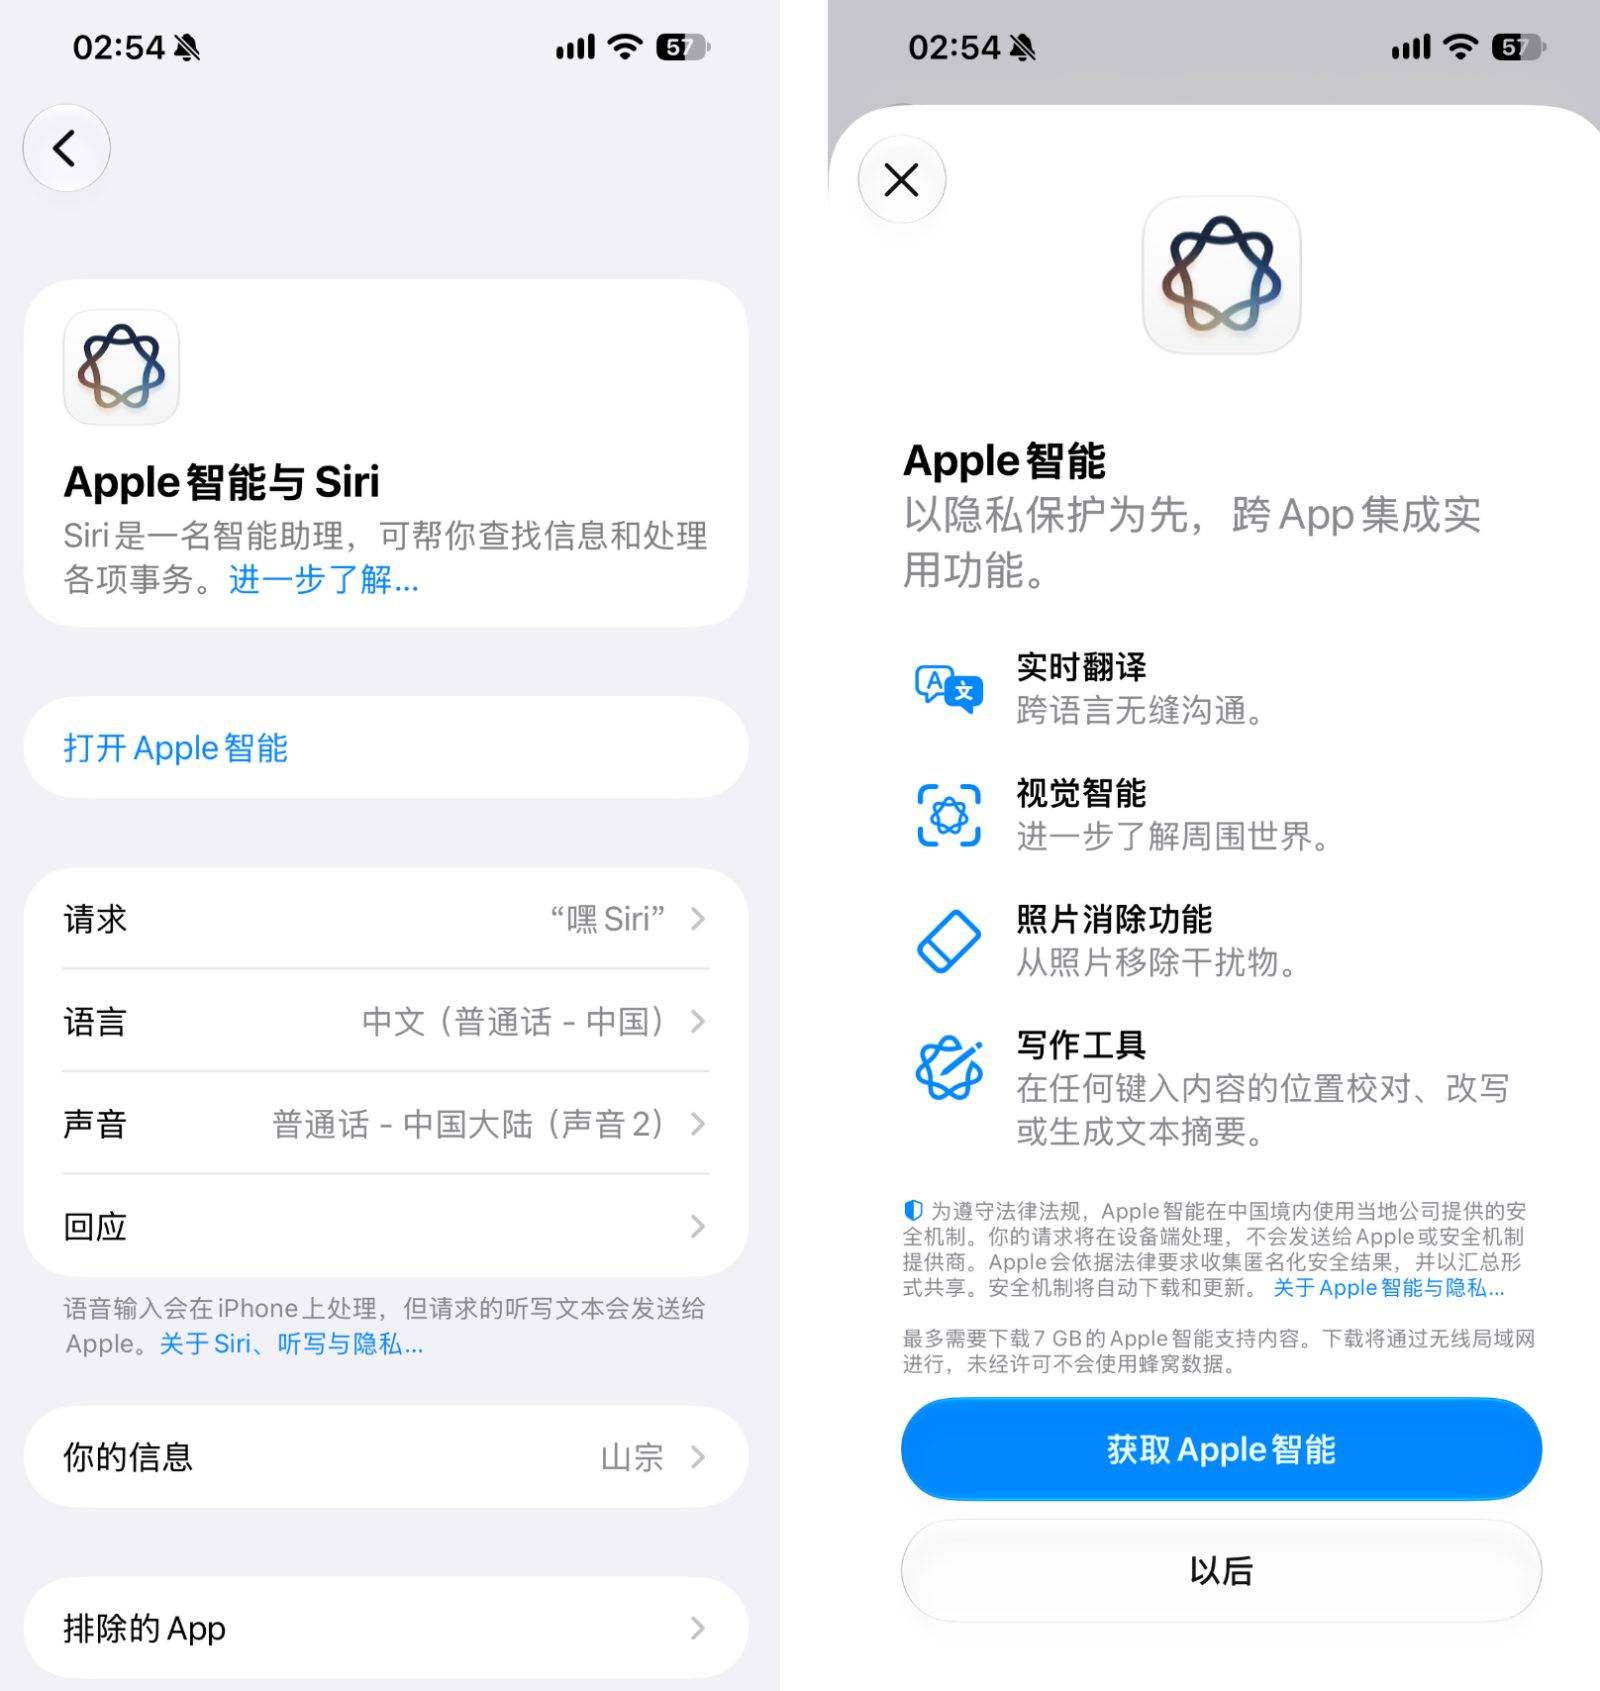
不过,迟到了整整两年的 Apple 智能,面对早已把各种 AI 功能玩出花样的国产手机,究竟还能带来多少令人眼前一亮的体验?
国行 Apple 智能怎么升级?
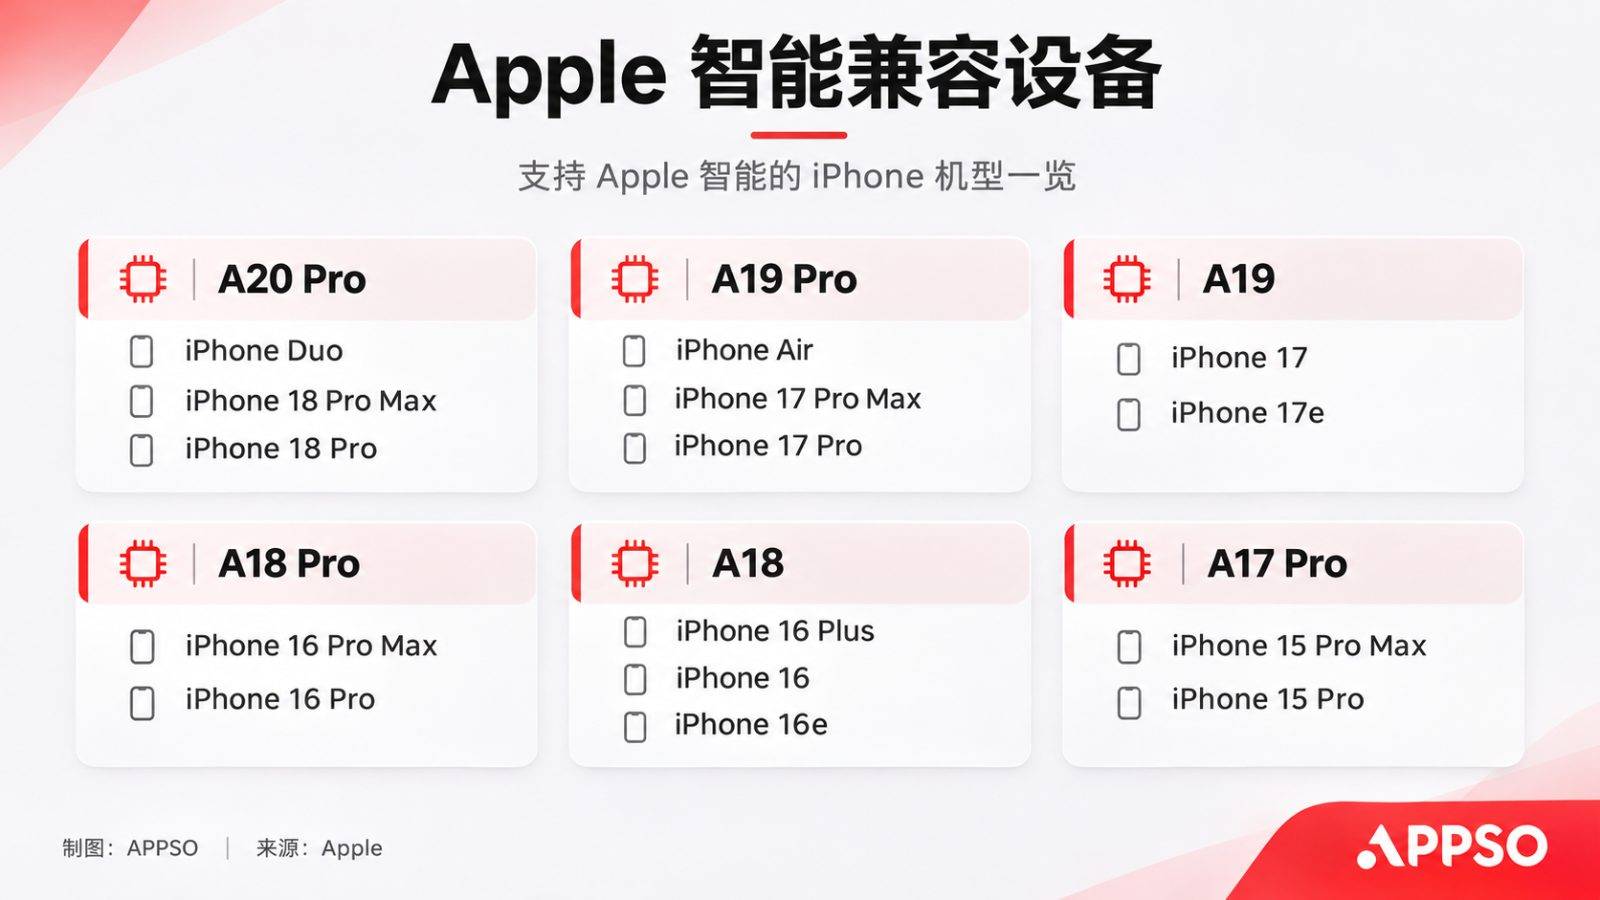
根据苹果公布的信息,首批功能支持机型包括 iPhone 15 Pro、15 Pro Max,iPhone 16 系列和后续支持机型,以及 iPhone Air、iPhone Duo。
想提前体验的用户,可以使用 Apple 账户注册开发者资格(https://developer.apple.com),接着进入「设置」「通用」「软件更新」「Beta 版更新」,选择 iOS Developer Beta,下载安装 iOS 27.3 测试版。
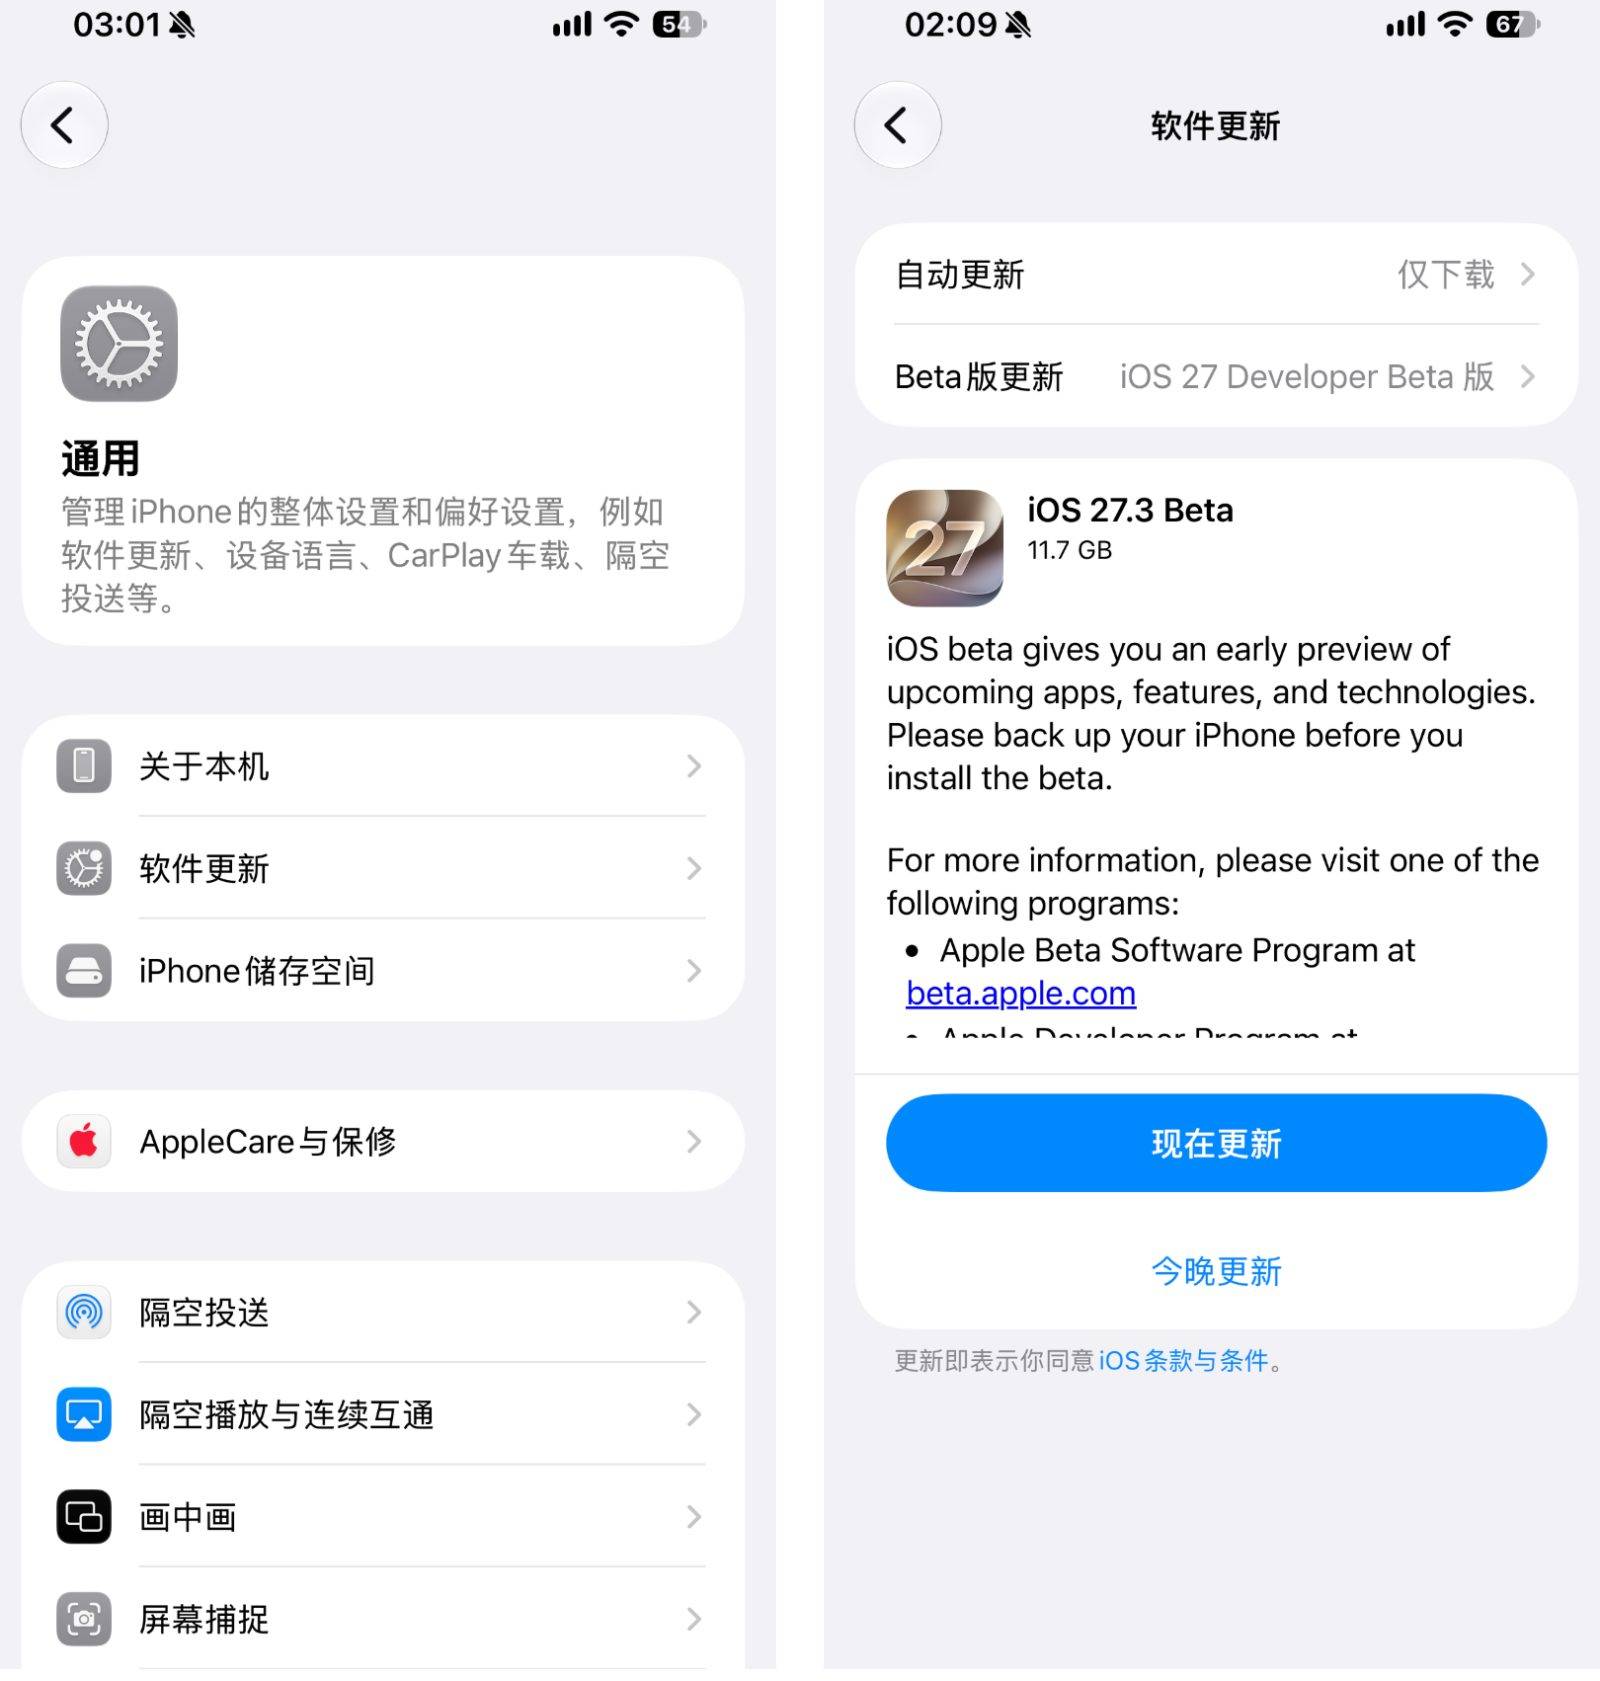
考虑到开发者测试版的稳定性,建议提前备份数据,尽量使用备用机体验。
值得一提的是,此次更新尚未包含苹果在 WWDC 2026 上宣布的下一代 Siri AI 功能,更强的个人情境理解和跨 App 自主执行能力仍需等待。
苹果国行 AI,究竟带来了哪些新功能?
· 写作工具
苹果将 AI 写作能力整合进系统文字处理界面,用户选中文字后,便可以直接调用校对、改写、摘要等功能,还能将内容调整为友好、正式或简洁的语气,或者整理成要点、列表和表格。
例如,面对几千字的行业报告,可以直接生成摘要,也能将冗长的会议记录整理成清晰的要点和表格,减少手动梳理信息的时间。
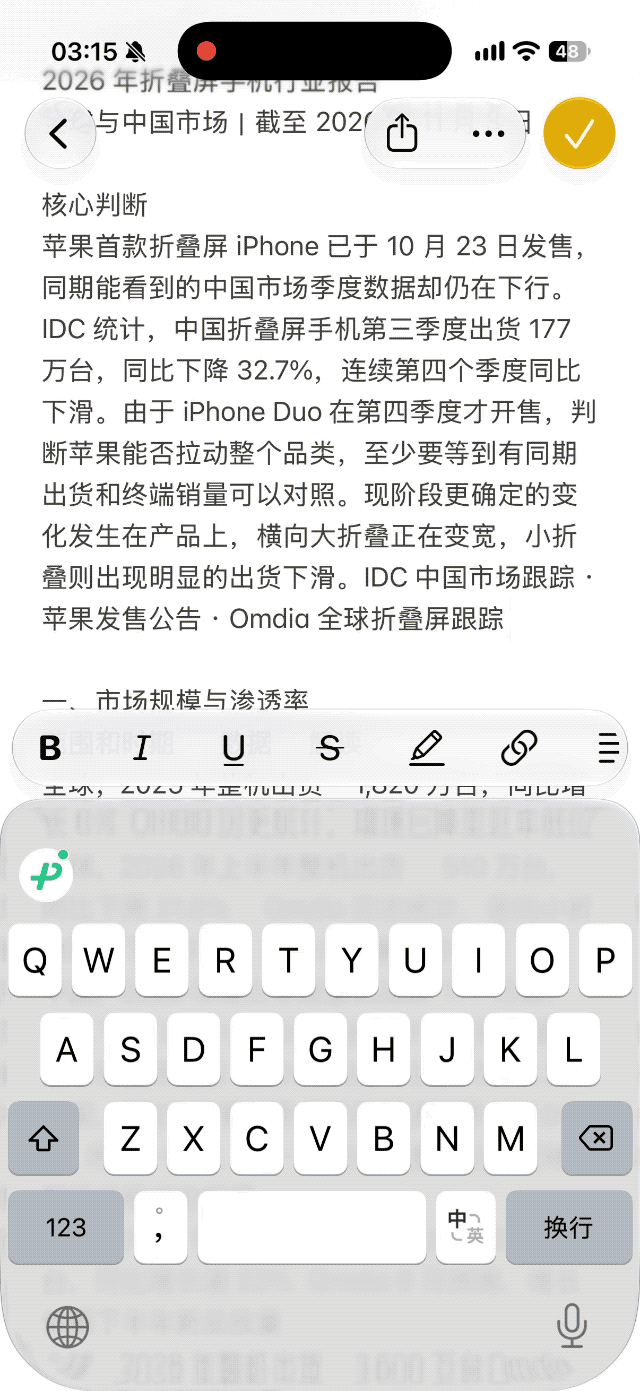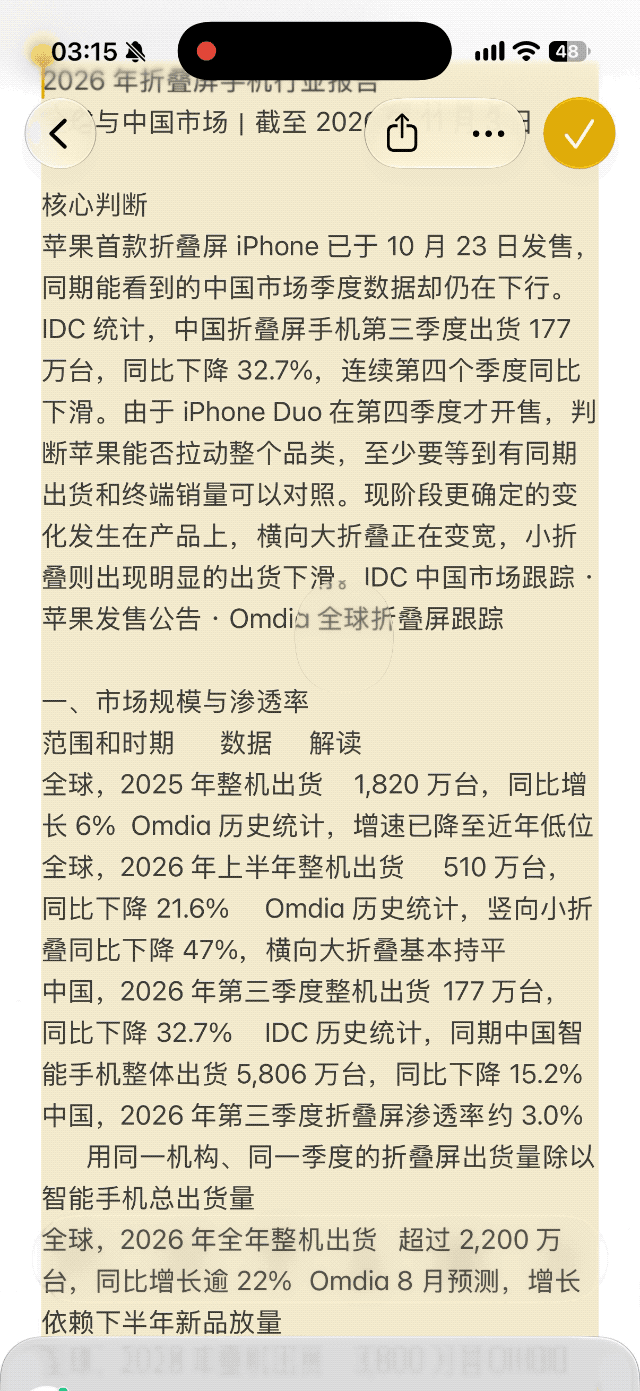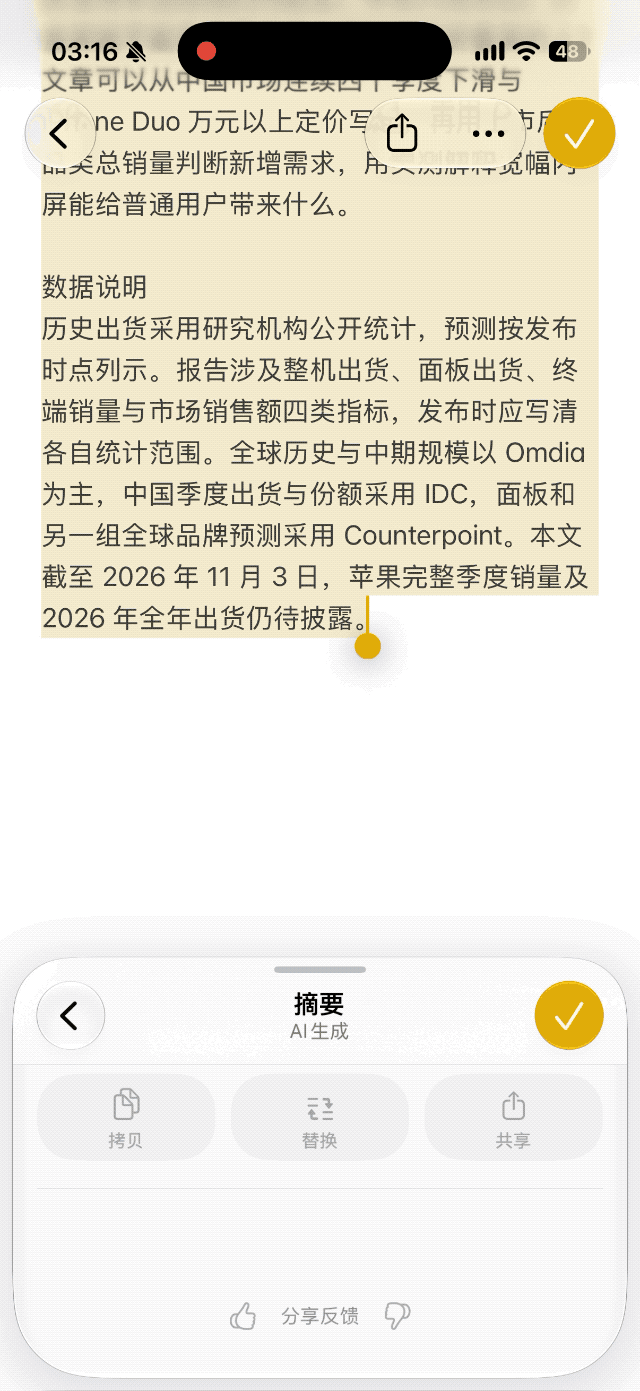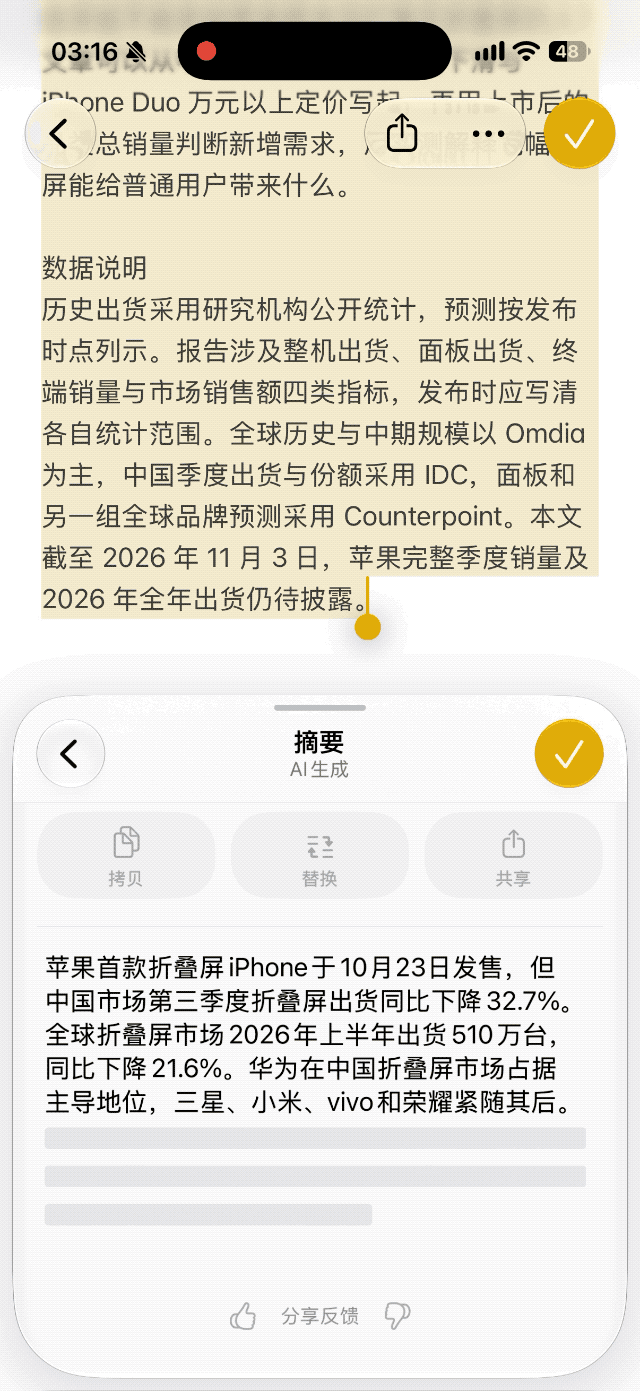
更值得关注的是,苹果还加入了「千问创作」,允许用户根据自然语言要求生成文章、邮件和其他内容,甚至生成图像。
例如,准备向老板反馈工作量过大,原话可能是「这个月指标太高了,实在完不成,要么给我加人,要么减任务」。通过「千问创作」,可以直接要求 AI 将其改写成高情商的工作汇报,同时保留核心诉求。
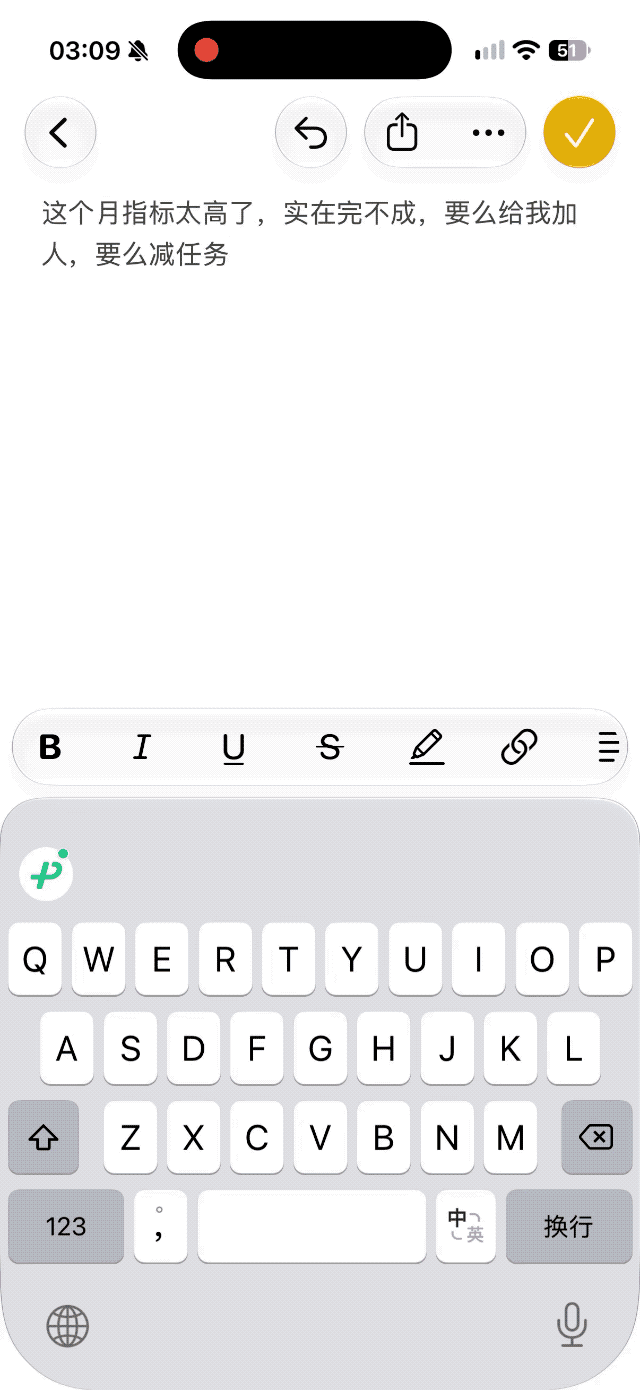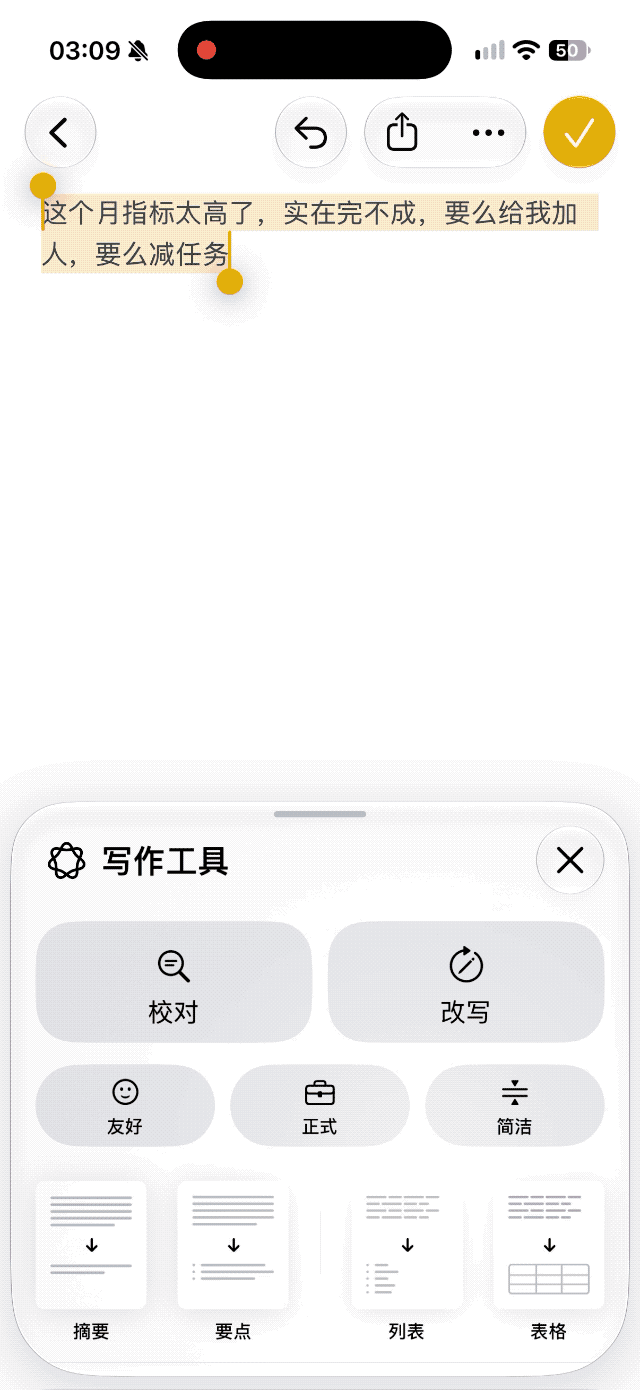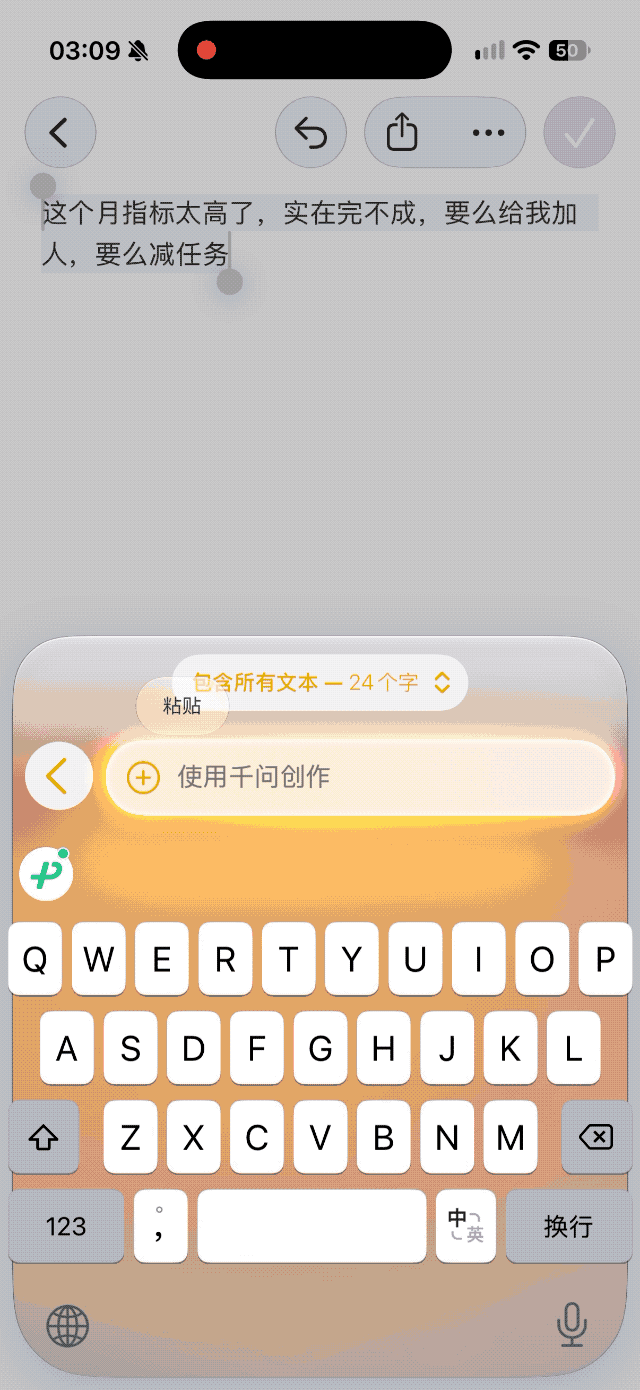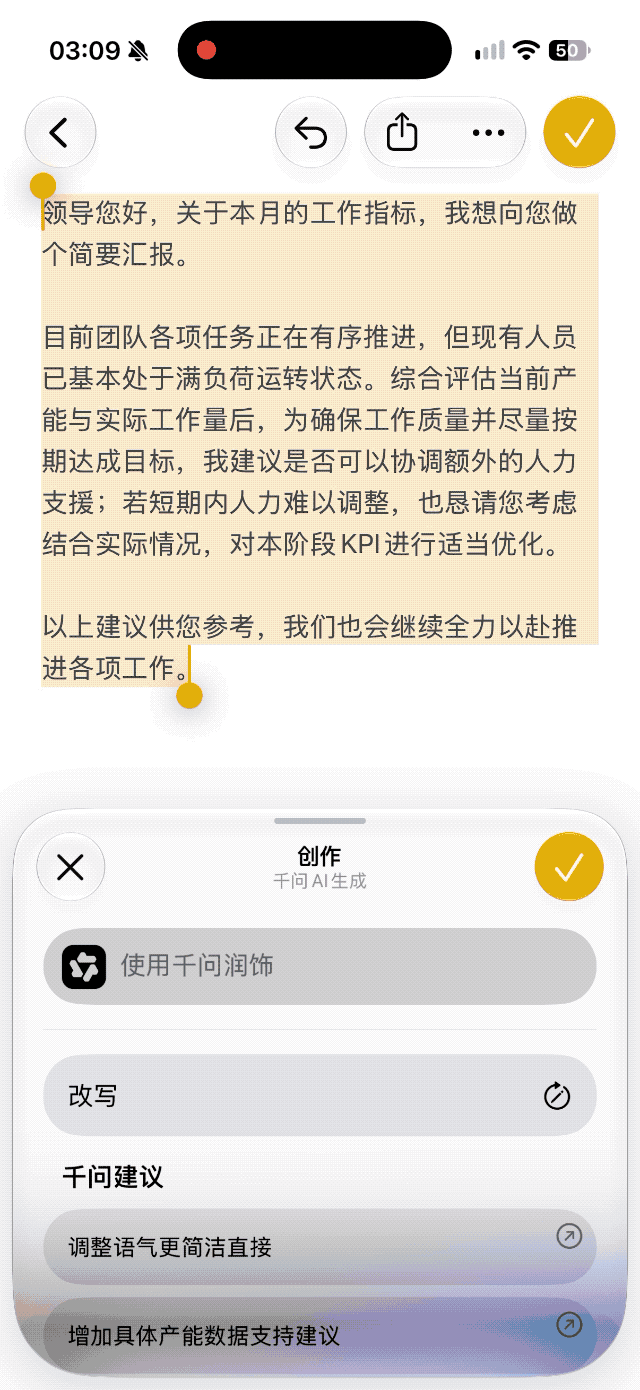
从原生写作工具的校对、摘要和格式整理,到千问提供的自由创作能力,苹果将两者放进了同一个系统级写作入口。
· 视觉智能
视觉智能让用户通过 iPhone 摄像头了解眼前的事物。
用户长按 iPhone 的相机按钮,即可唤出视觉智能界面,底部提供「询问」「翻译」「搜索」三个选项,分别对应不同的使用场景。
其中,左侧的「询问」由千问的视觉理解能力提供支持,可以识别摄像头拍摄的物体,并根据画面内容回答问题。例如,将摄像头对准英文菜单,询问「哪些菜品适合不吃海鲜的人」,AI 便可以结合菜单内容给出建议。
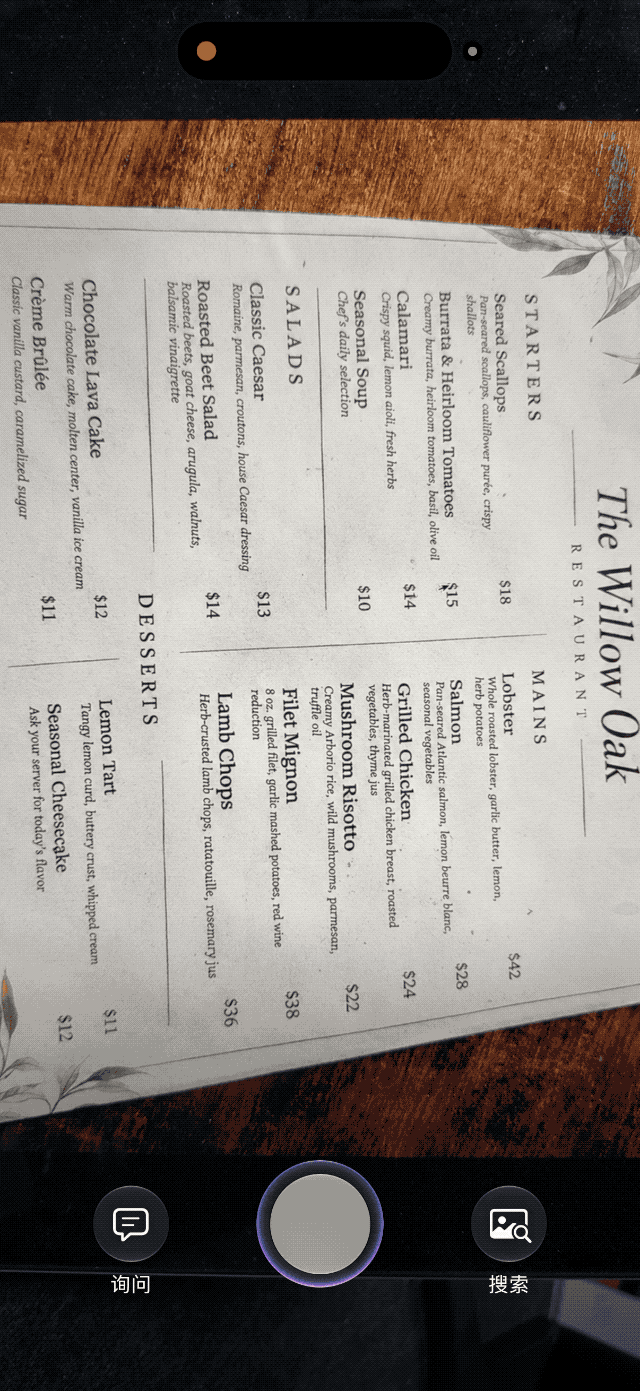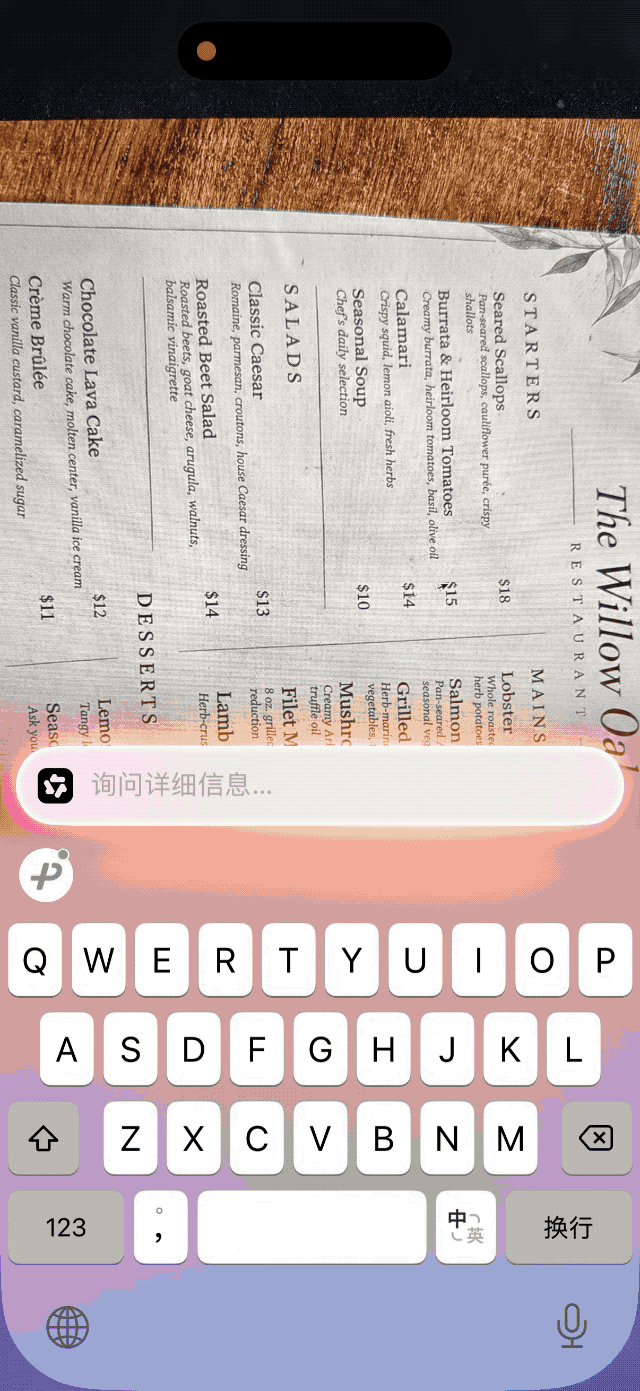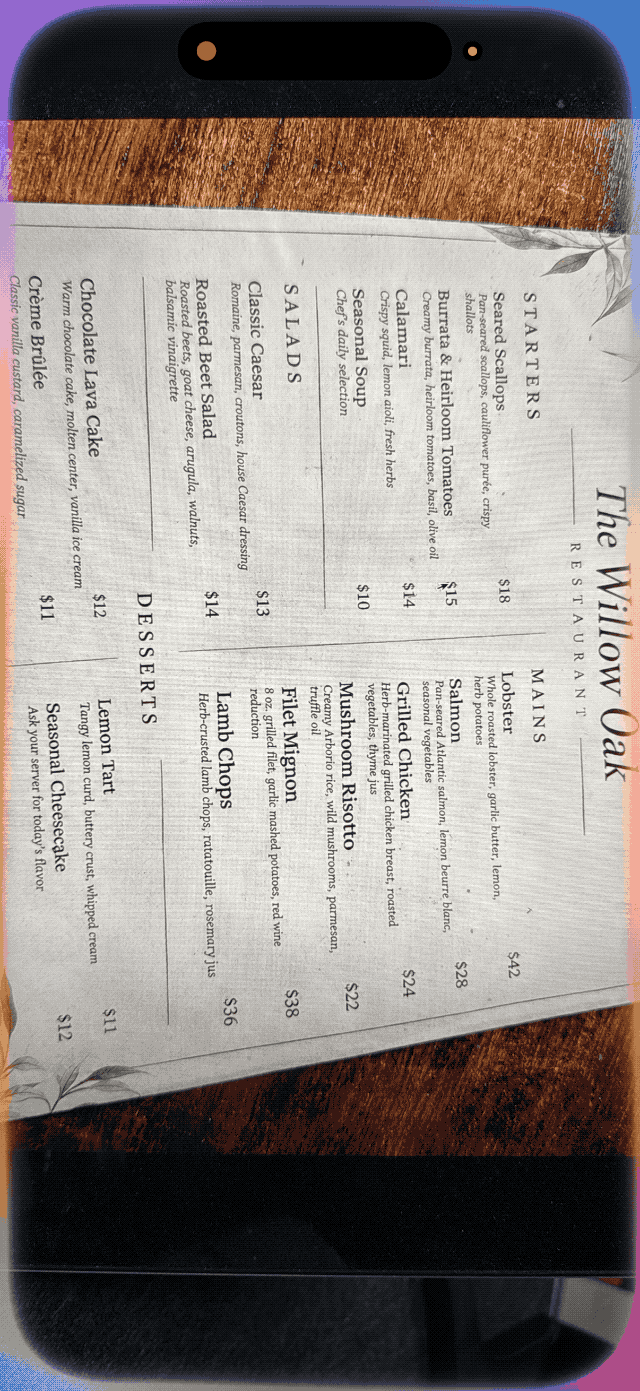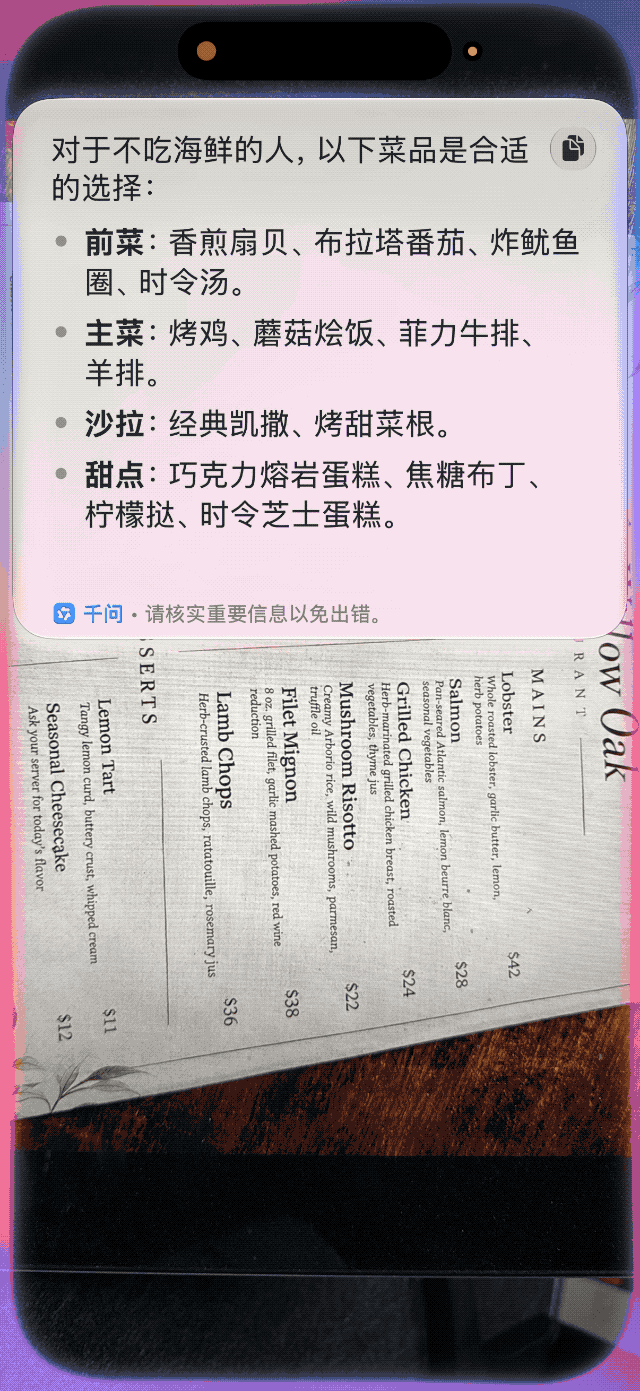
中间的「翻译」则可以直接识别并翻译镜头中的外语文字,适合阅读海外菜单、路牌和商品说明。
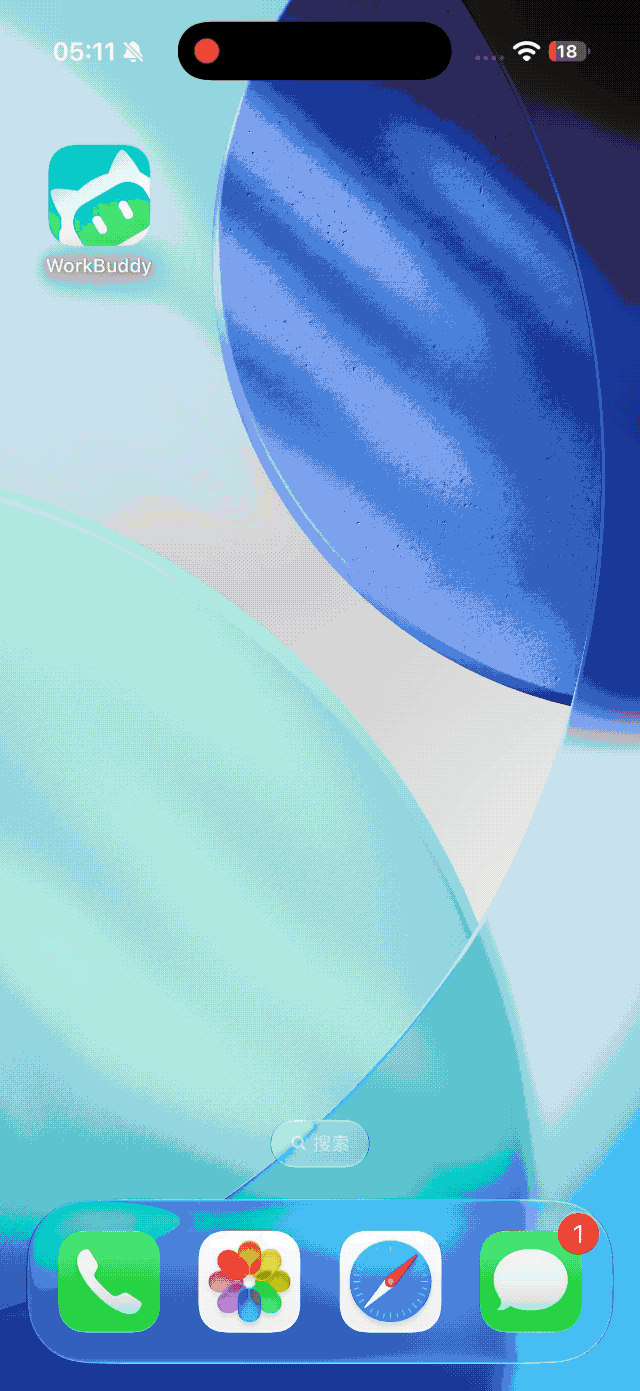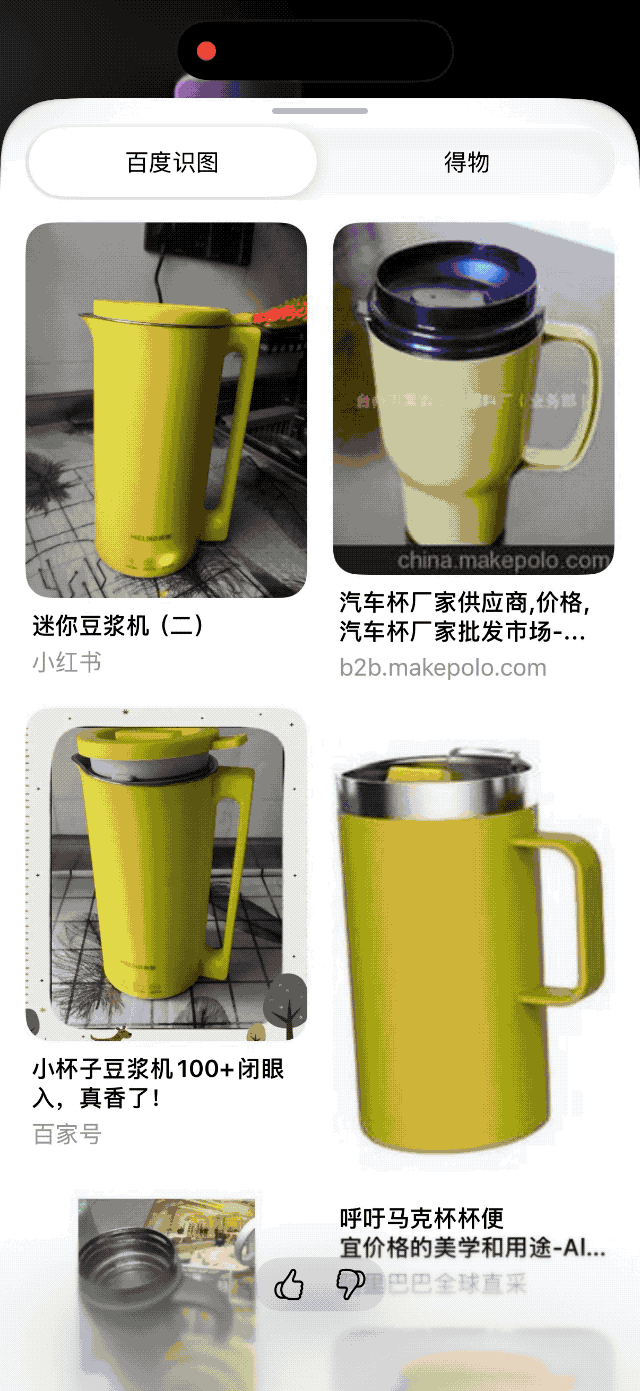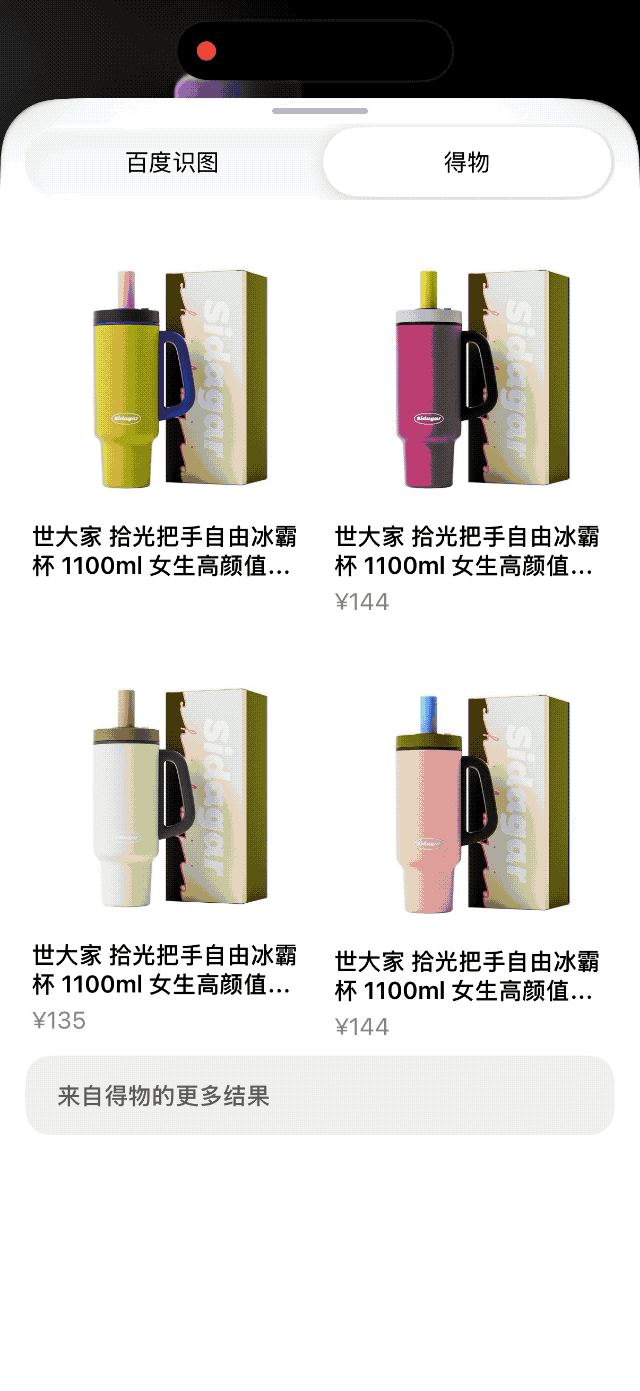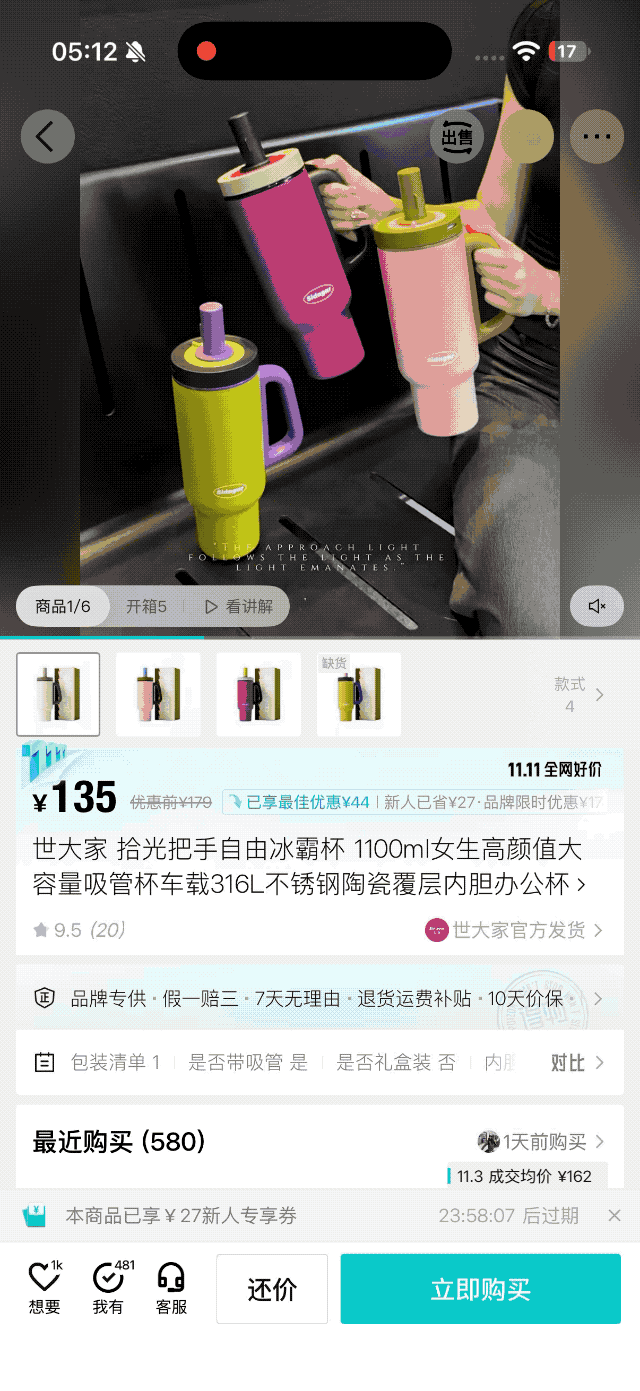
右侧的「搜索」由百度识图默认提供支持,能够根据当前画面查找相似图片。
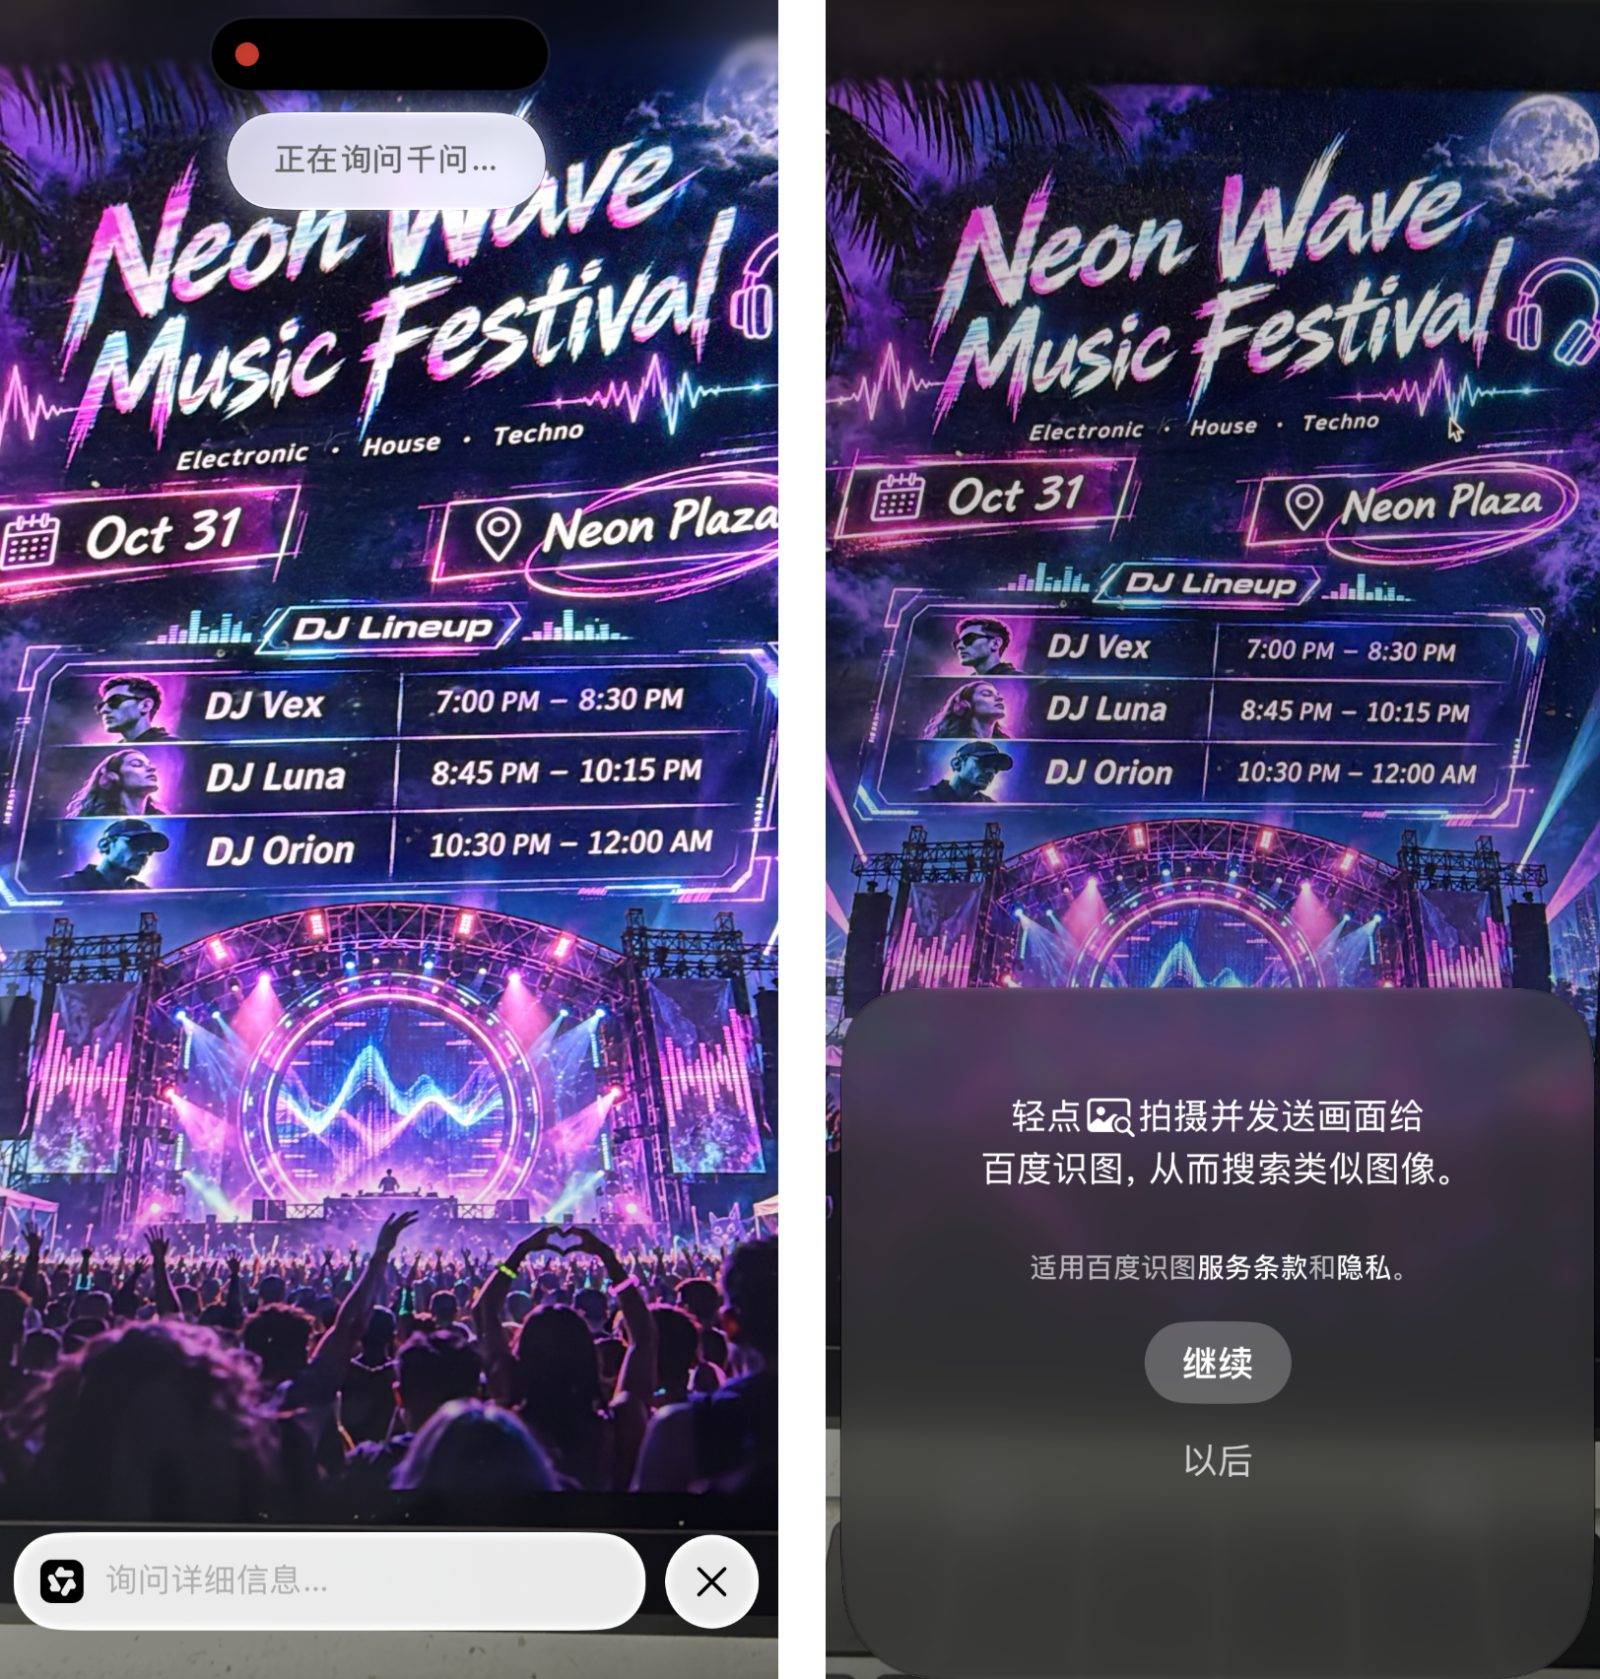
不过,如果你手机里装有接入了视觉搜索的第三方 App,比如得物,那么你同样还能得到得物的搜索结果,用户可以根据眼前的实际需求直接选择。
· 照片消除
按照苹果此前公布的信息,照片 App 此次主要迎来了消除工具、自然语言搜索和回忆影片生成三项 AI 功能。
其中,消除工具已经可以正常使用,用户只需圈选照片中的路人、杂物等干扰对象,AI 便会尝试将其去除,并自动修复背景。
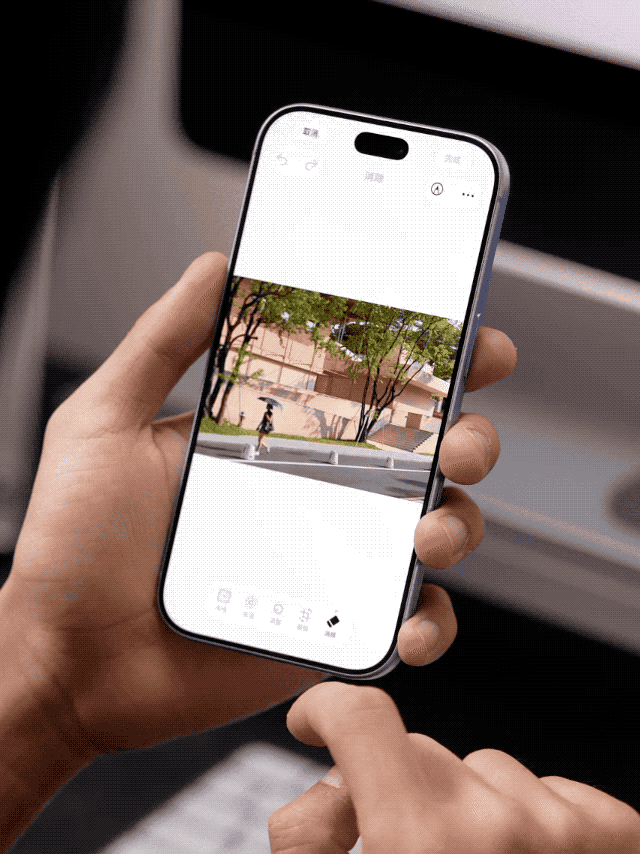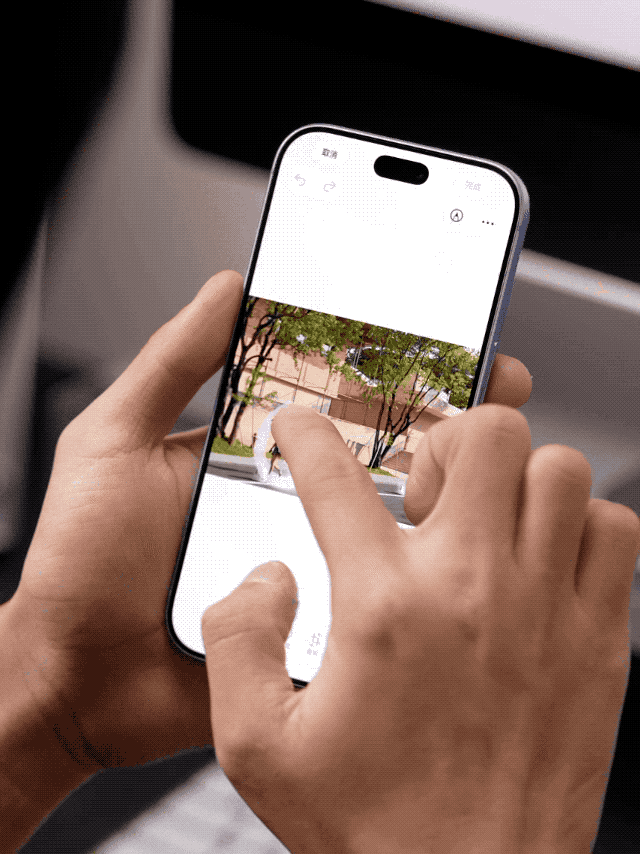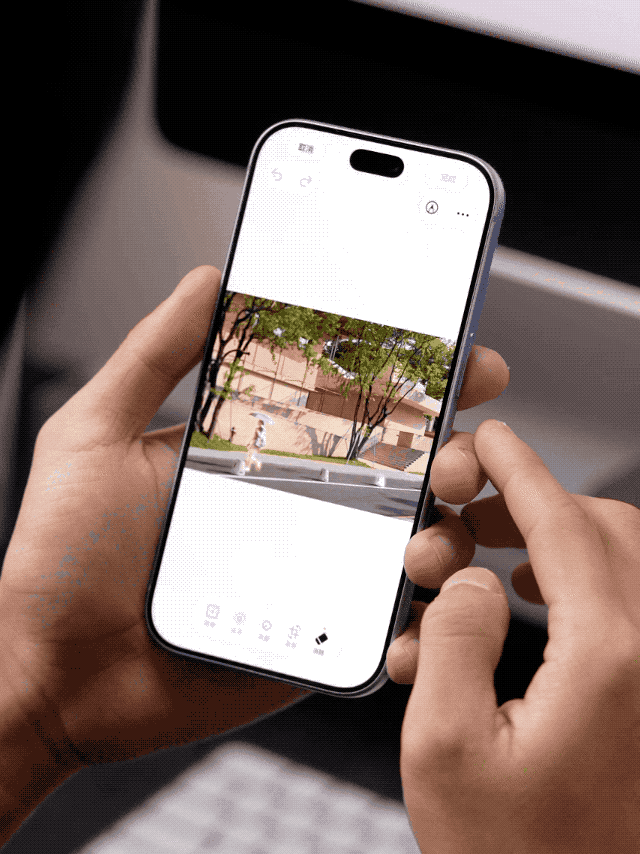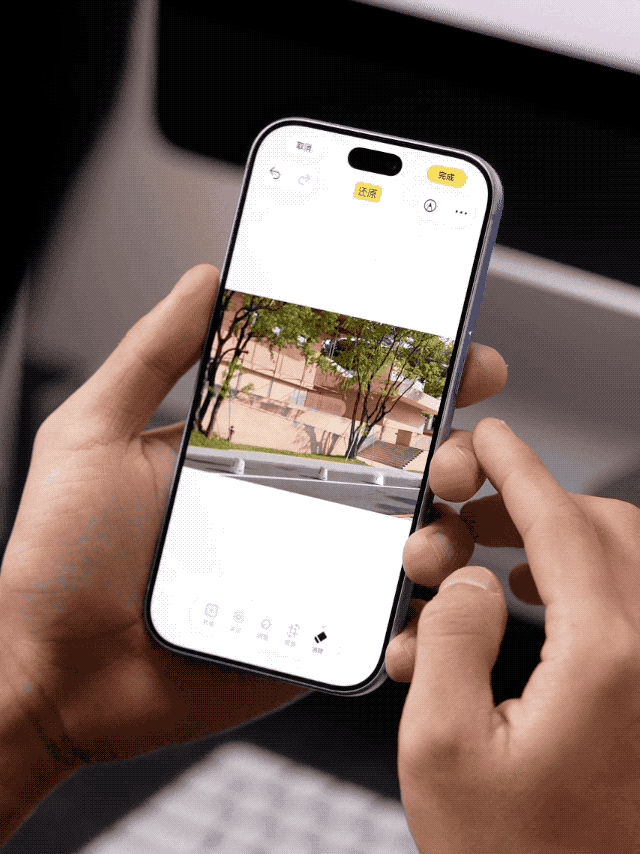
在使用消除工具的体验过程中,我们也发现照片 App 偶尔会出现闪退。考虑到目前仍是开发者 Beta 版本,相关功能的稳定性还有待完善。
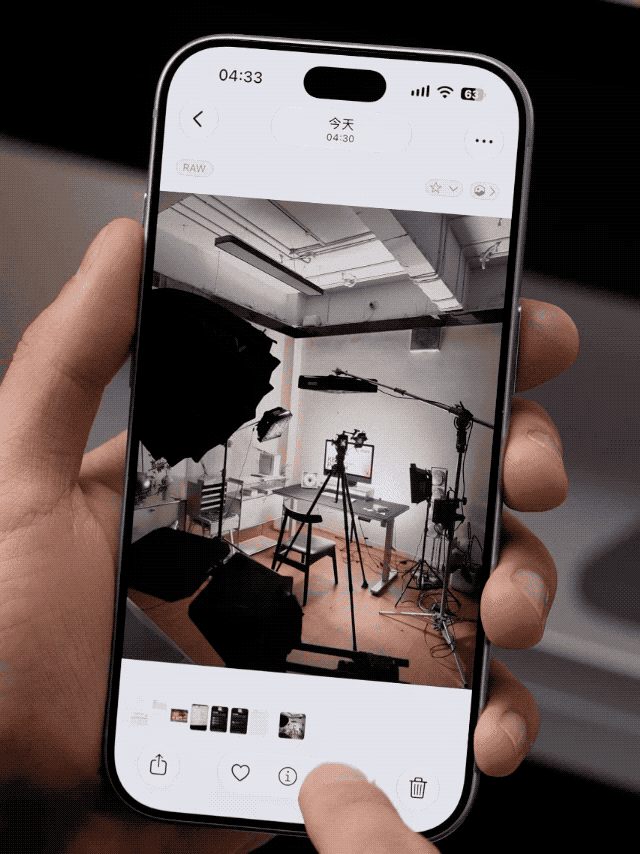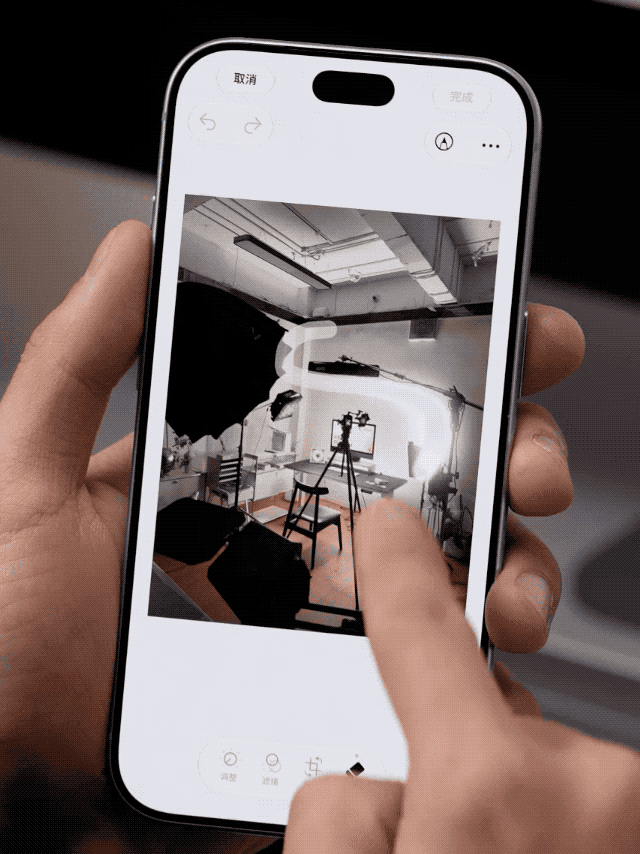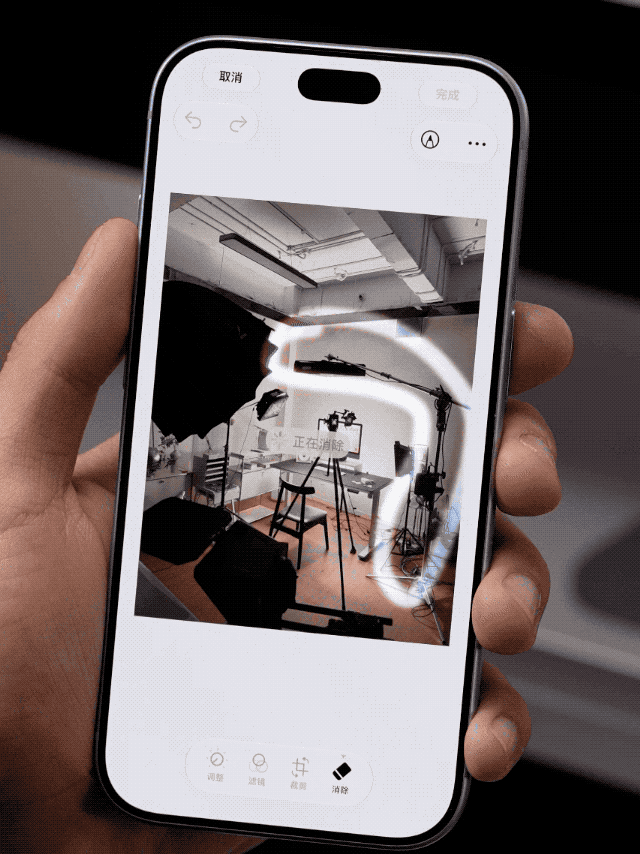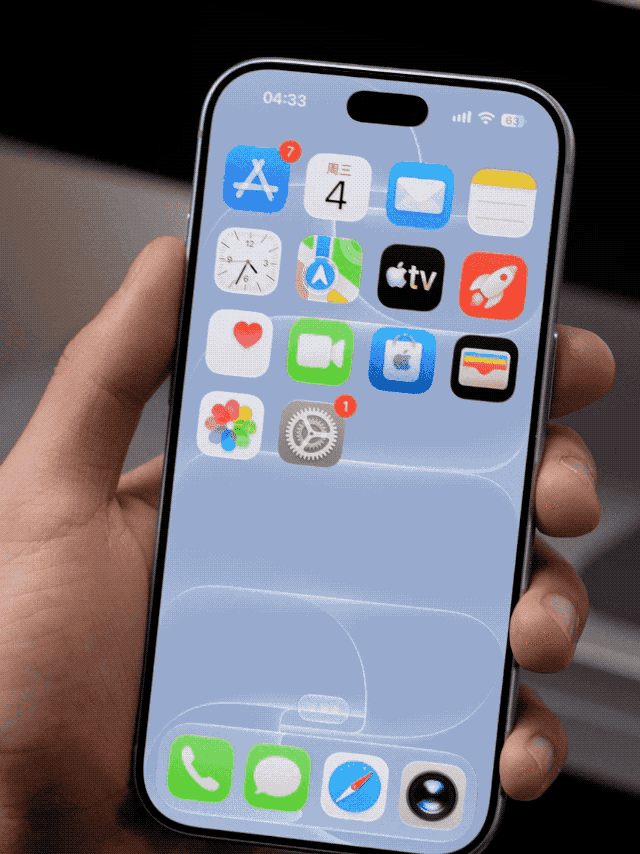
接着,我们继续提高测试难度,尝试让 AI 消除花朵旁边的自行车。结果虽然成功去除了自行车,但花朵边缘的处理明显不够自然,仍能看出 AI 修复留下的痕迹。
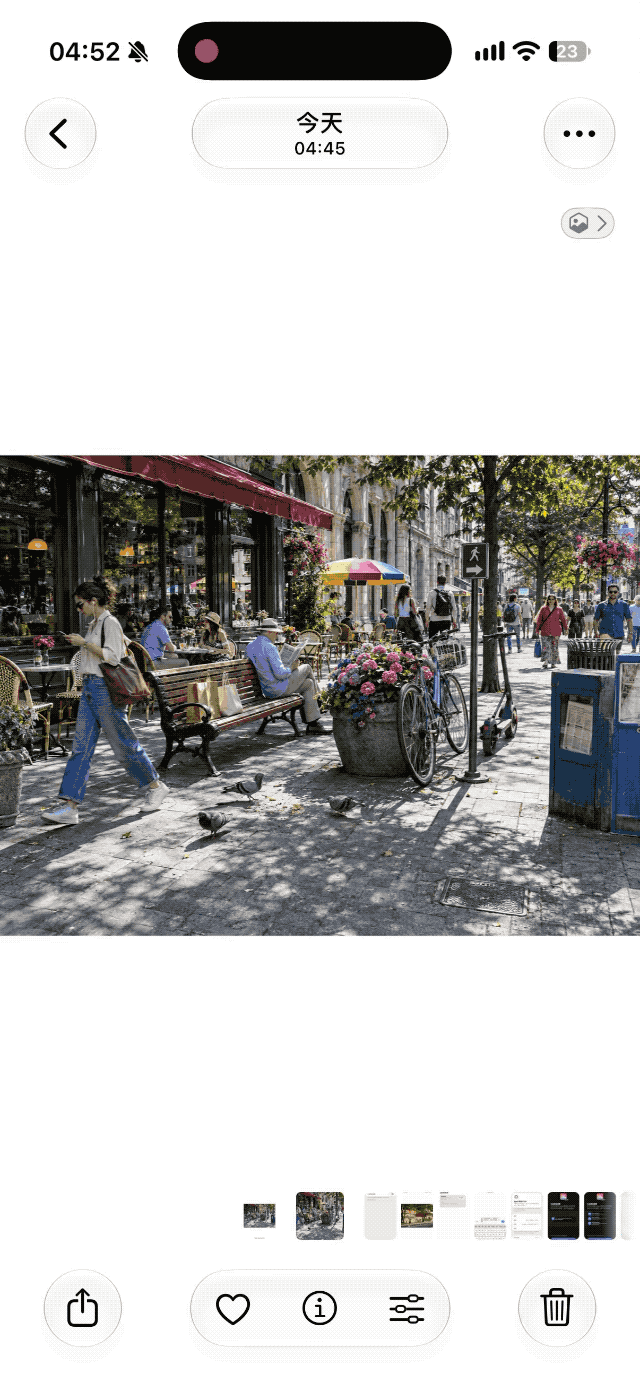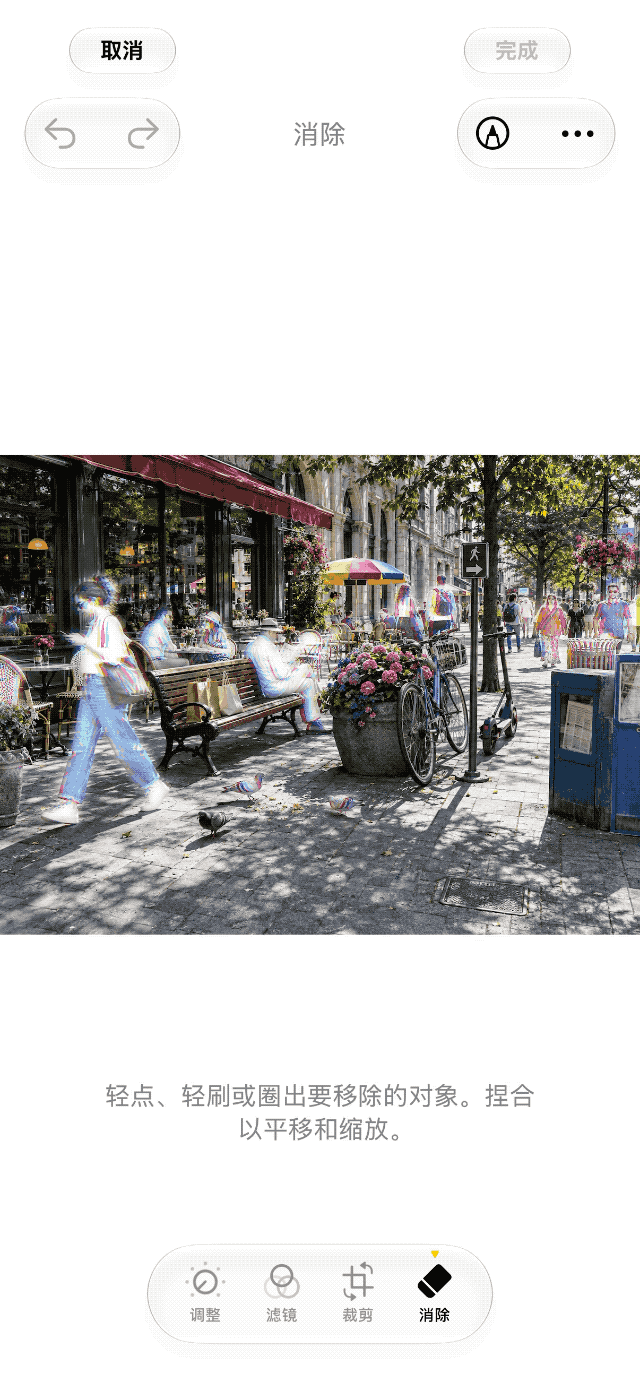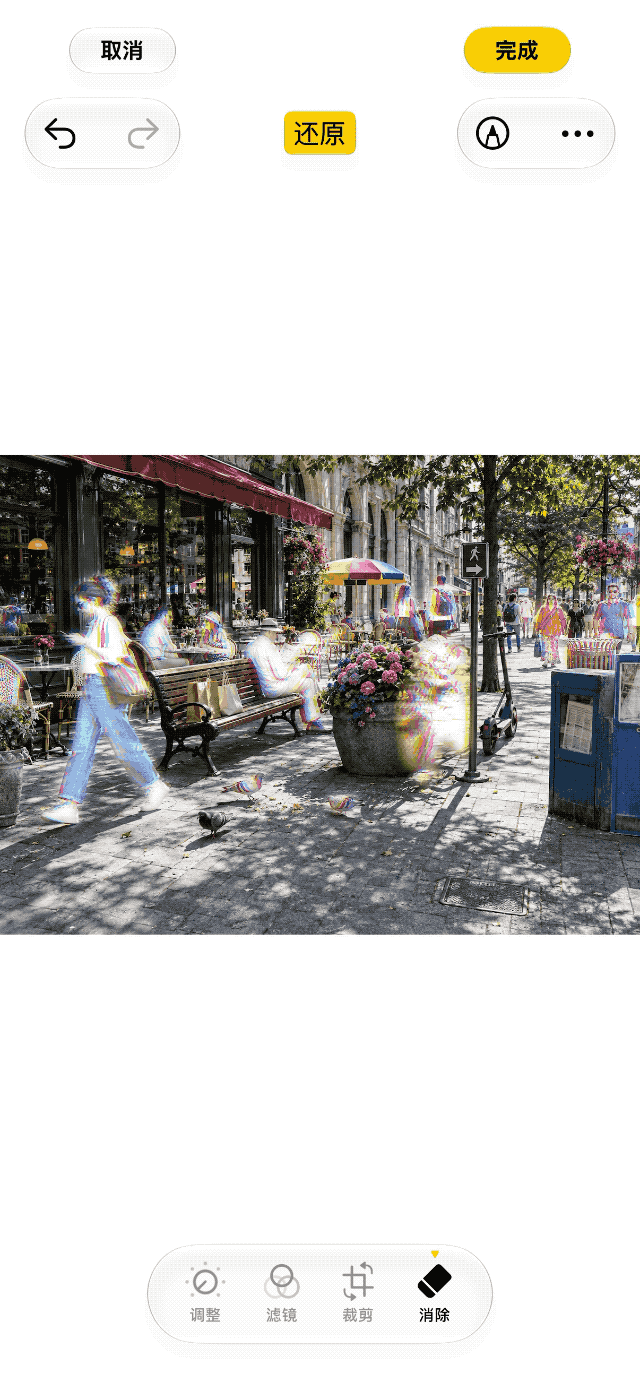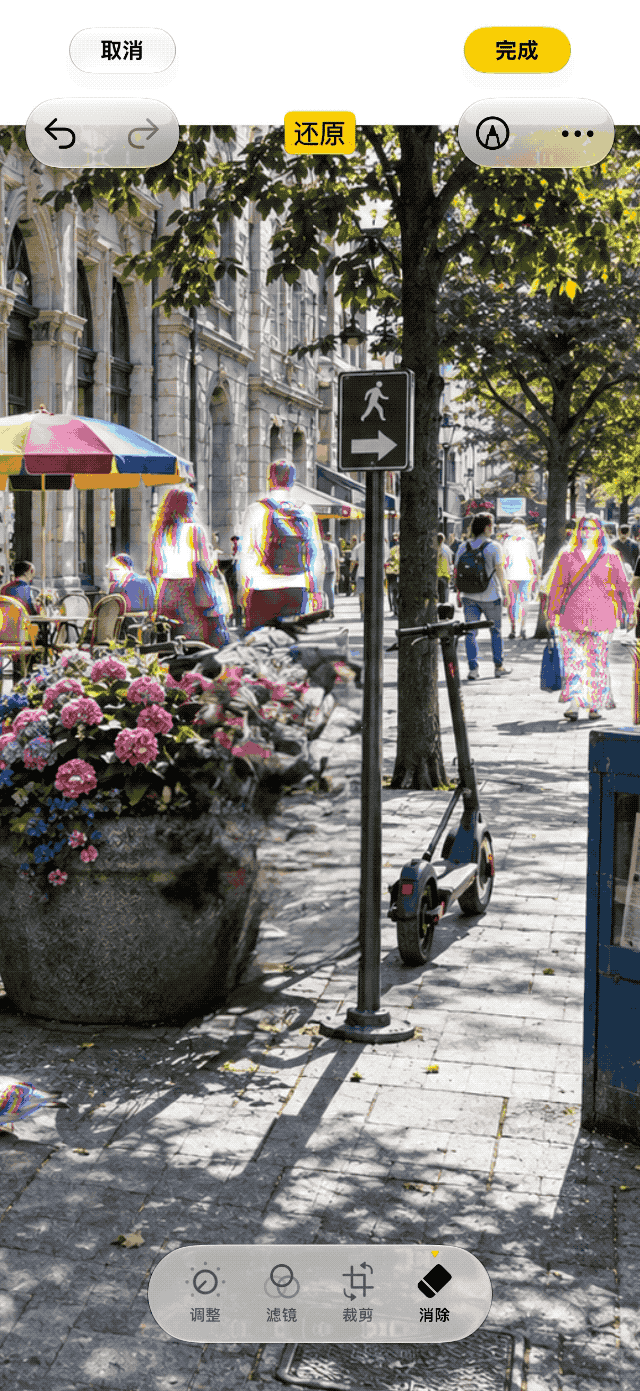
而在此次开发者 Beta 版的体验中,我目前只找到了消除工具,暂时还没有找到自然语言搜索和回忆影片生成的功能入口,也欢迎能够成功体验的朋友在评论区分享实际感受。
另外需要提一句,此次测试使用的是 iPhone 16 Pro,即便在正常室温环境下体验,手机的发热依然比较明显,尤其是在连续使用 AI 功能的过程中。
· 智绘表情
智绘表情允许用户通过文字描述生成专属表情符号。
例如,输入「一只戴着发光墨镜、正在喝冰美式的熊猫」,或者「一个因为修改十遍需求而抱头痛哭的电脑显示器」,系统便会生成相应表情。
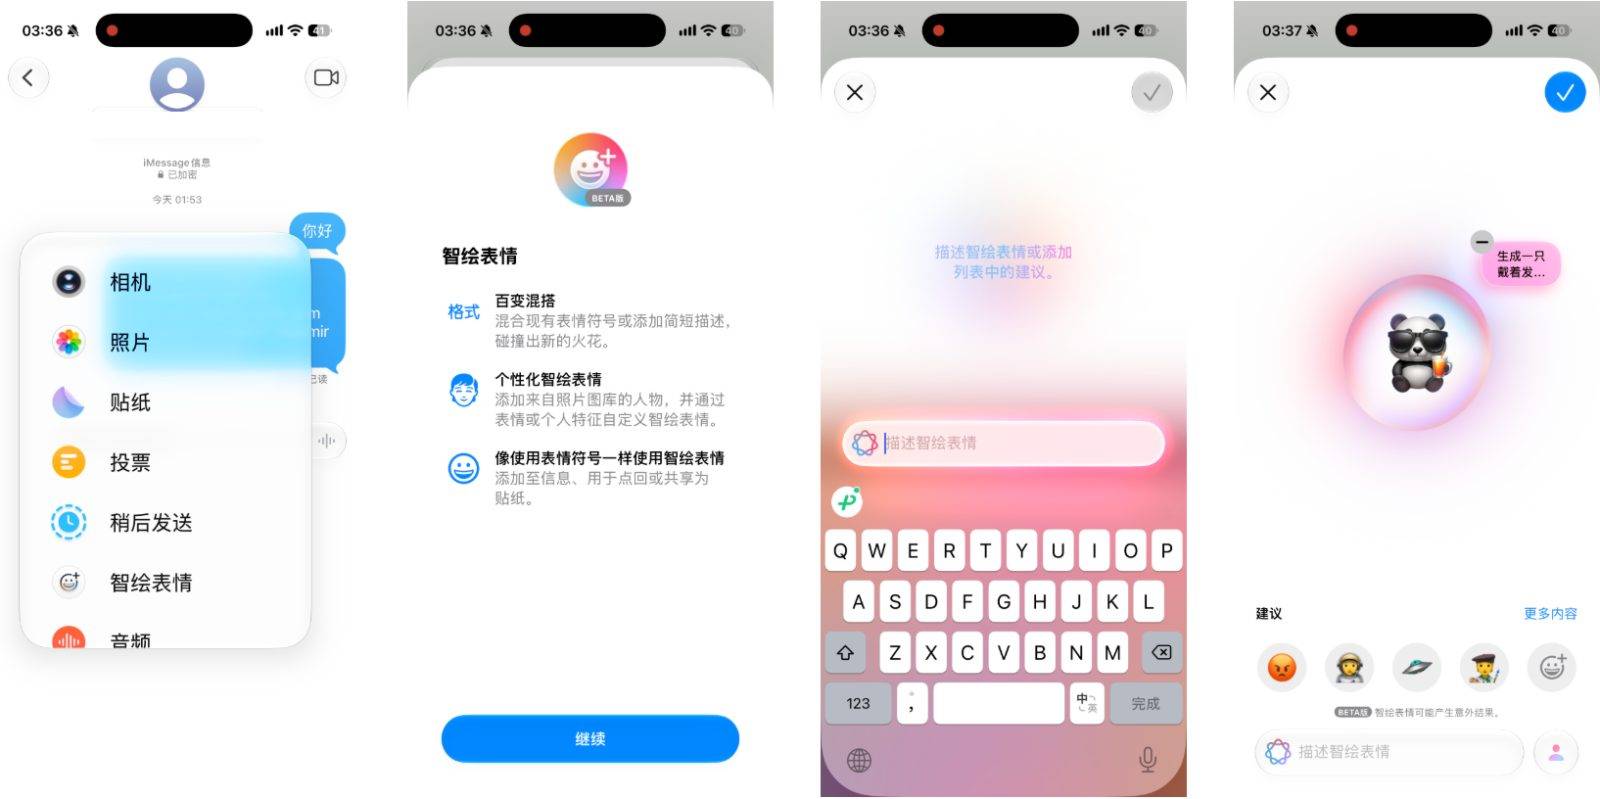
相比生产力工具,智绘表情更偏向娱乐表达,也更容易成为普通用户接触 Apple 智能的入口。
· 备忘录与通话摘要
Apple 智能还可以为备忘录中的录音和通话转录文本生成摘要,帮助用户快速了解对话内容。
例如,我让 AI 处理了一段关于周末聚餐的模拟通话录音。两个人原本打算吃火锅,后来又考虑川菜,最终因为有朋友不吃辣,决定去公司楼下的一家粤菜馆,还讨论了清蒸鲈鱼、烧鹅等菜品。
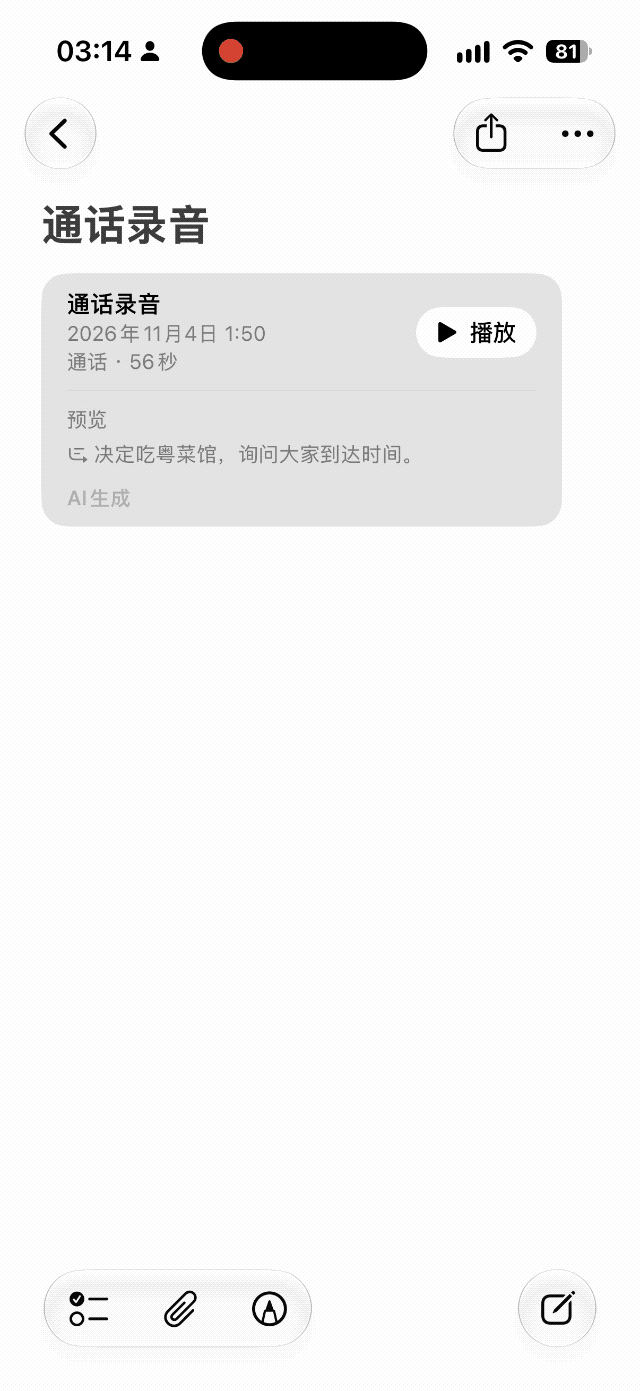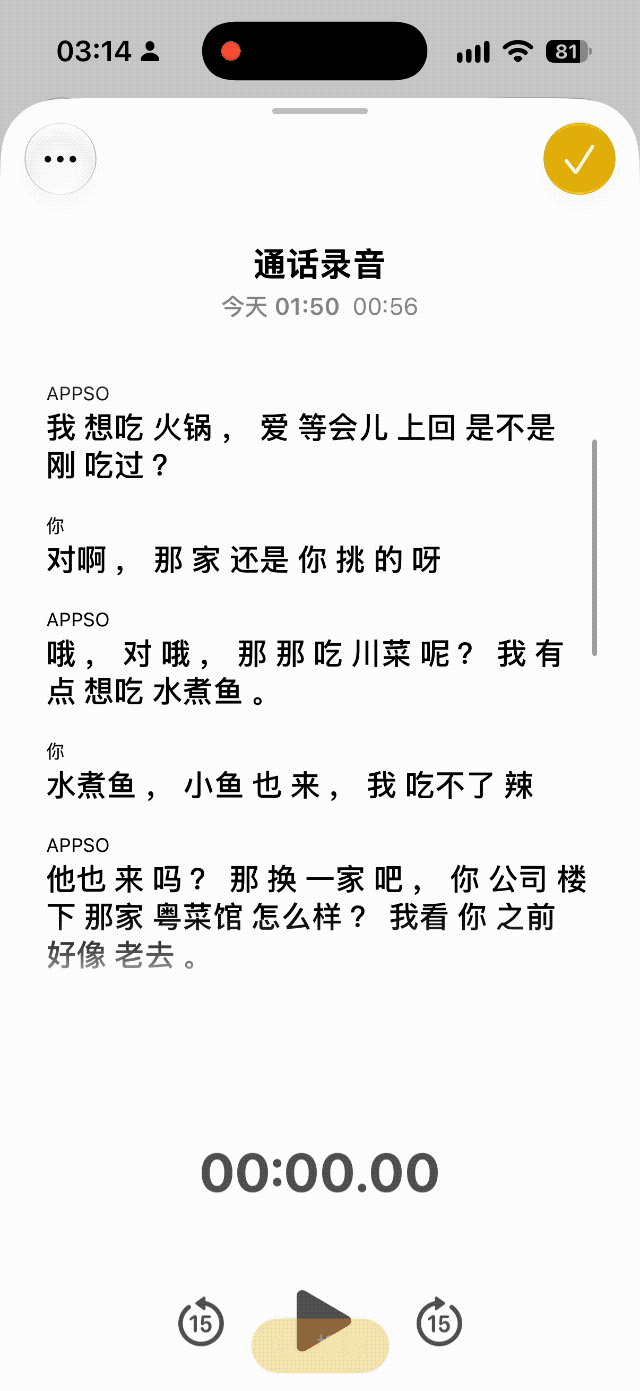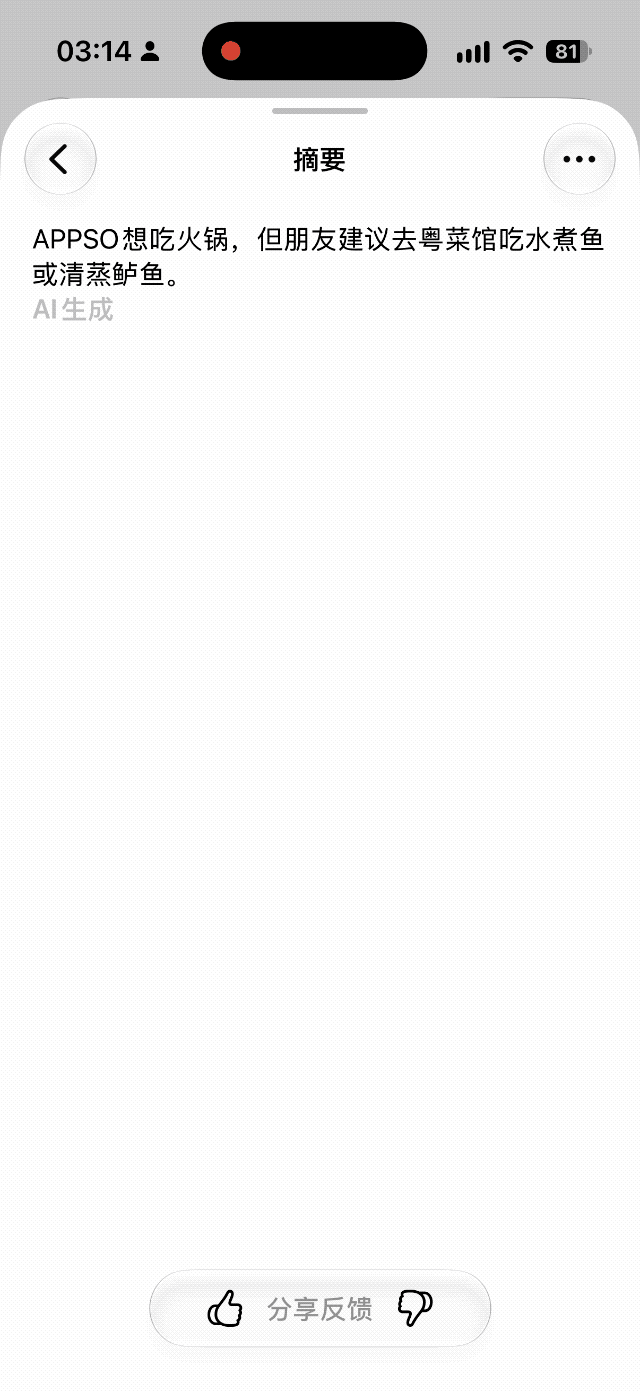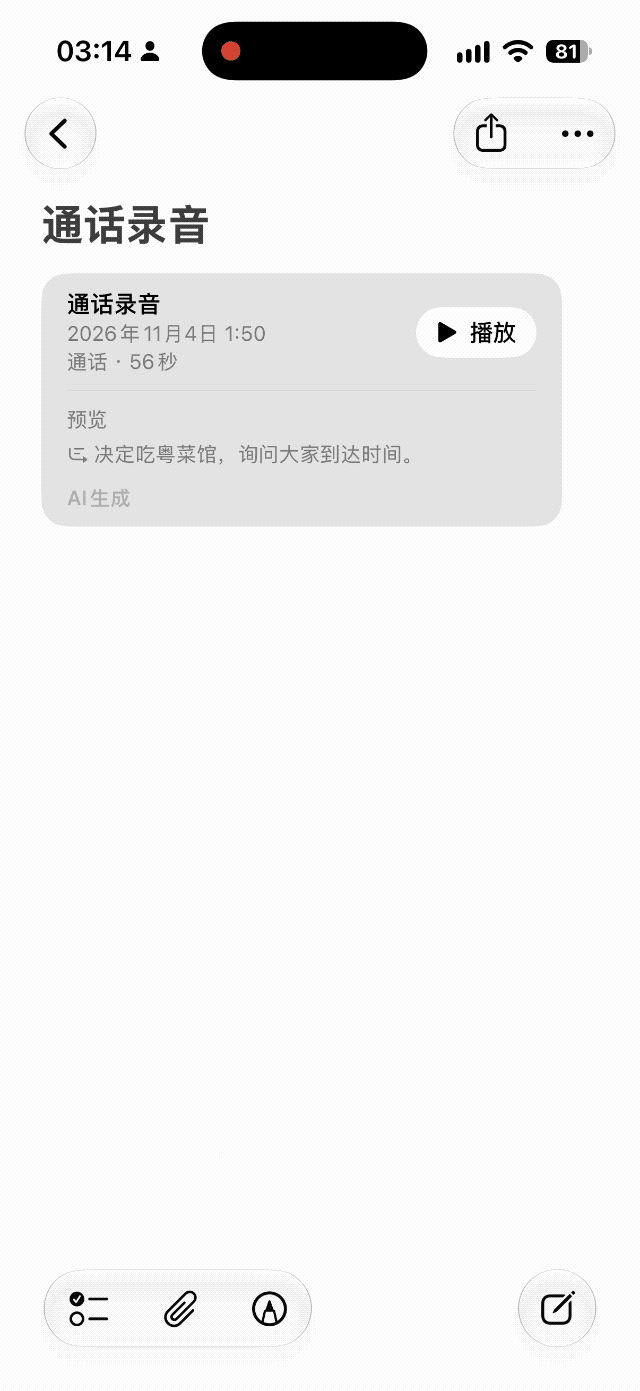
整段对话充满了临时改口和闲聊,但真正有用的信息在 AI 的辅助下变得异常清晰。
对于经常开会、电话沟通或整理采访录音的用户来说,类似的 AI 摘要功能可以帮助快速提取关键信息,减少反复回听录音和手动整理文字的时间。
· Siri 升级
在所有功能中,Siri 的变化可能最受关注。
此次更新,Siri 支持文字输入、理解临时改口,并能在连续对话中保持上下文。
例如,用户说「帮我设置早上 7 点的闹钟,算了,改成 8 点半,备注叫选题会」,Siri 可以理解用户最终想要的操作。
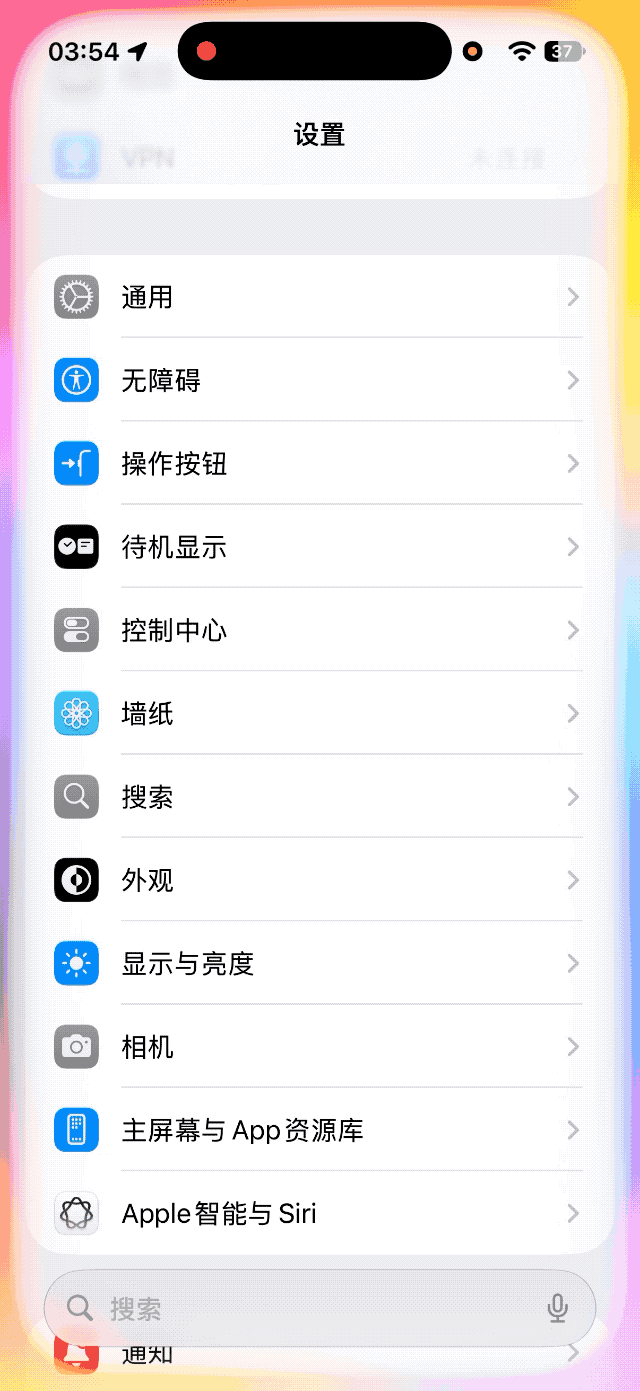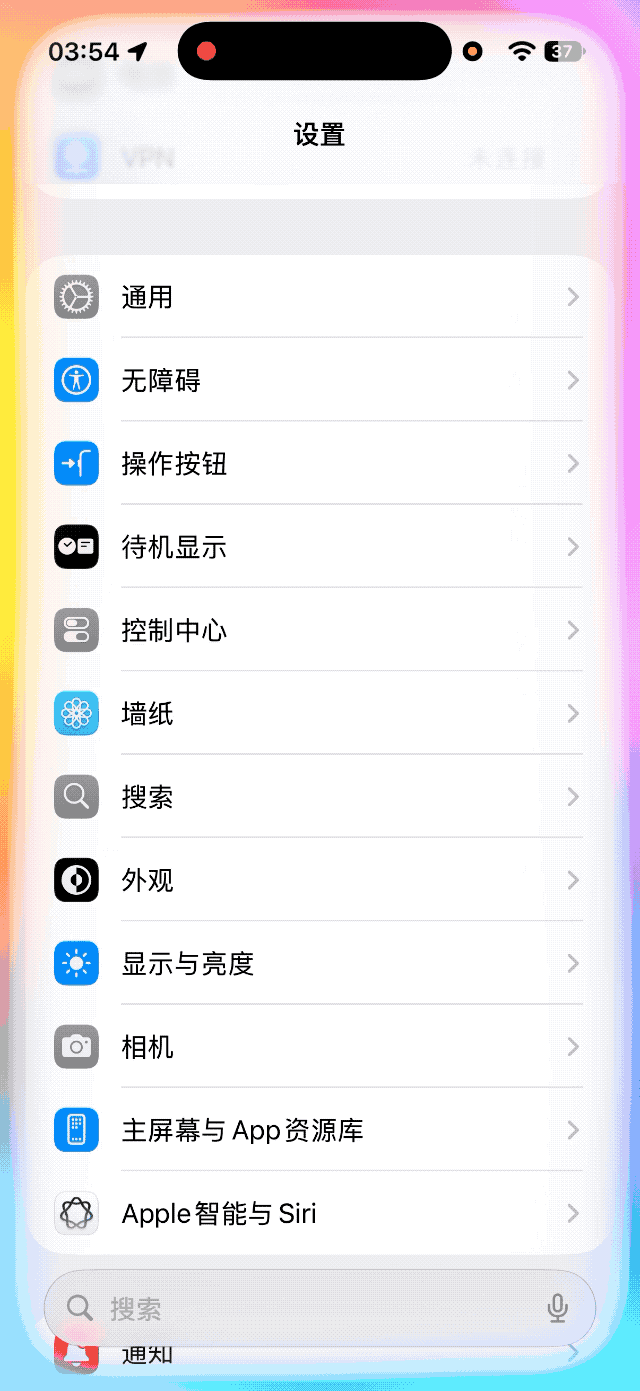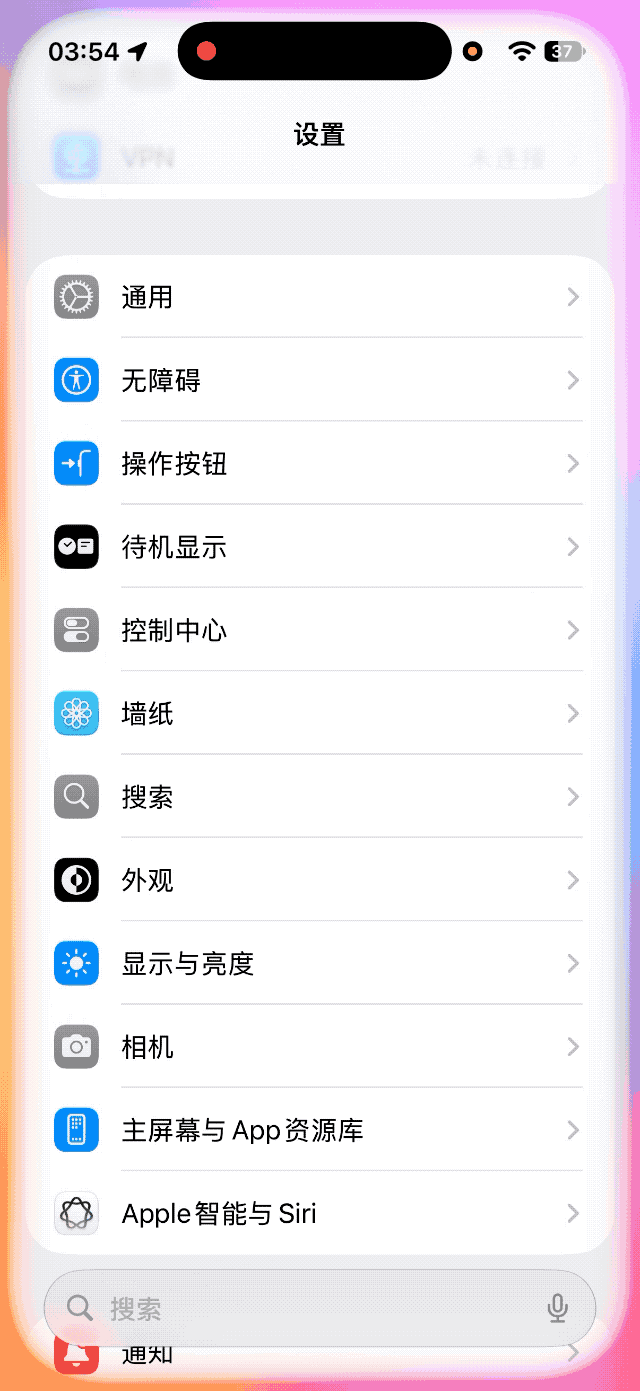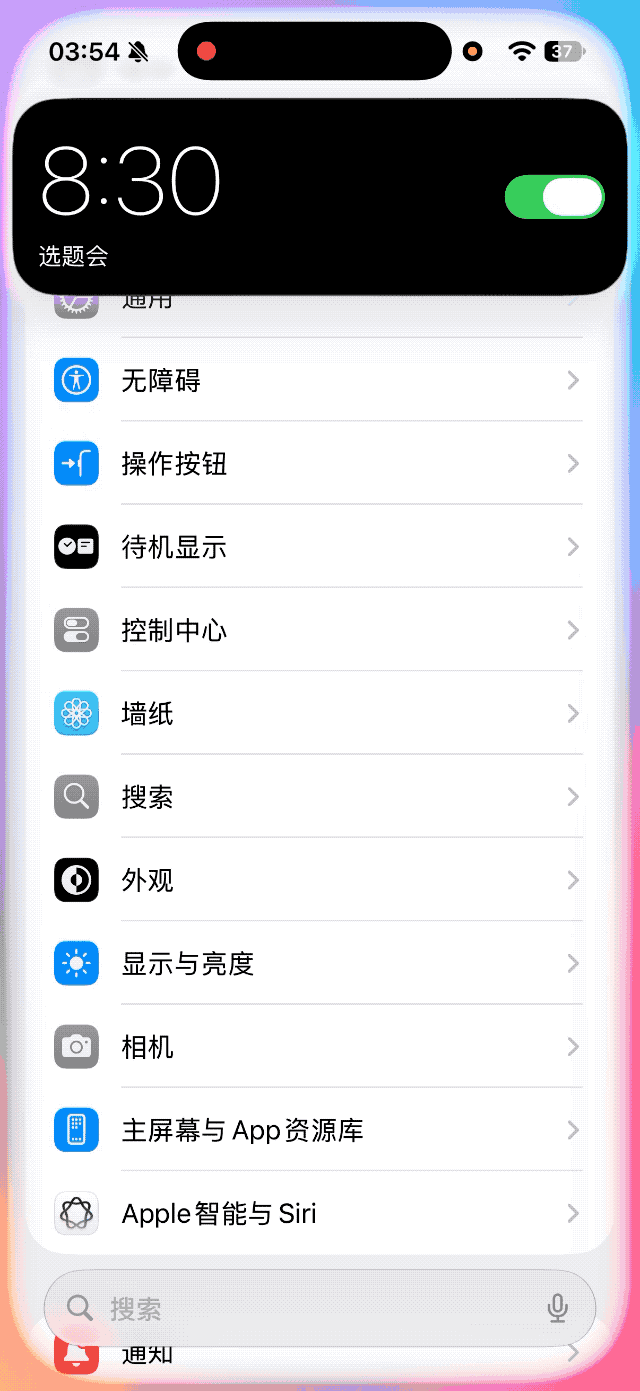
更重要的是,苹果也正式将千问引入部分 Siri 体验。
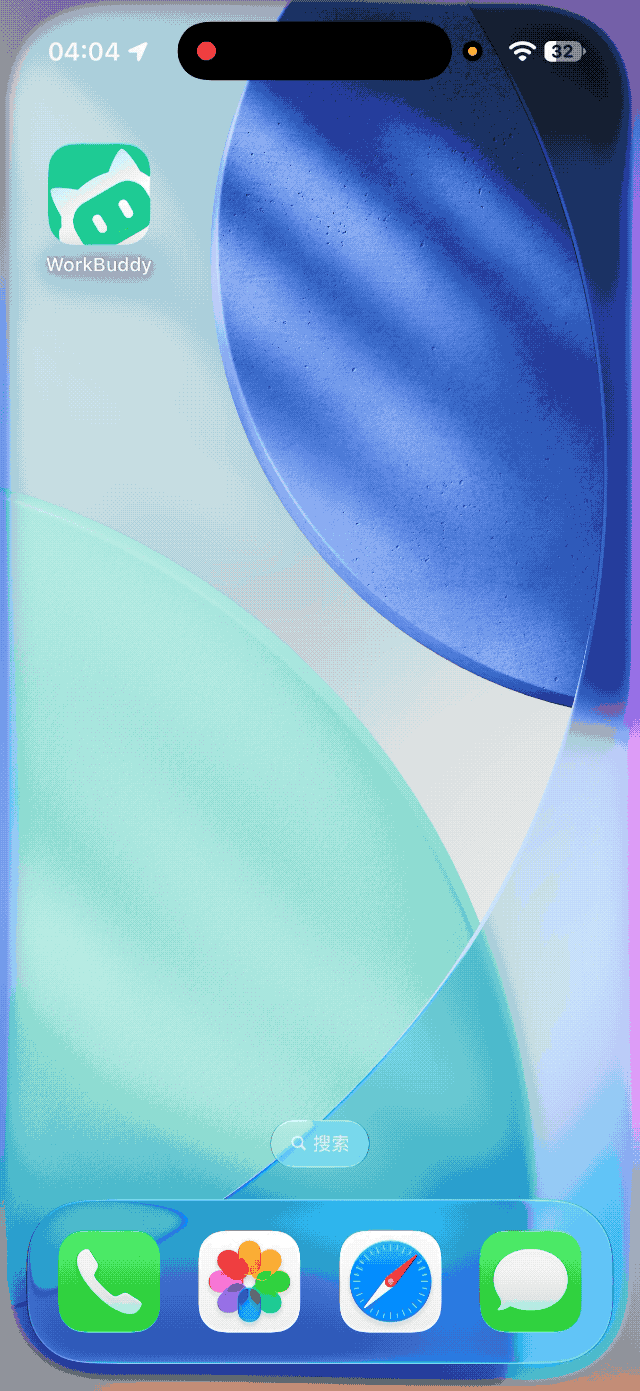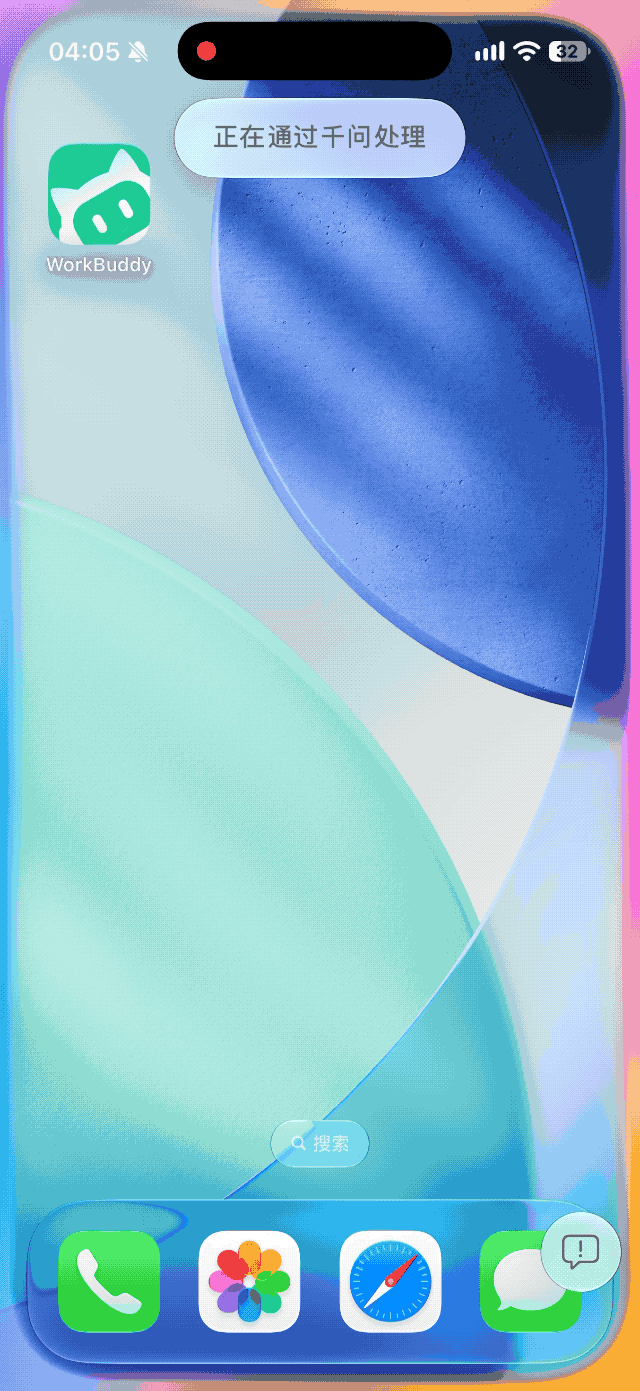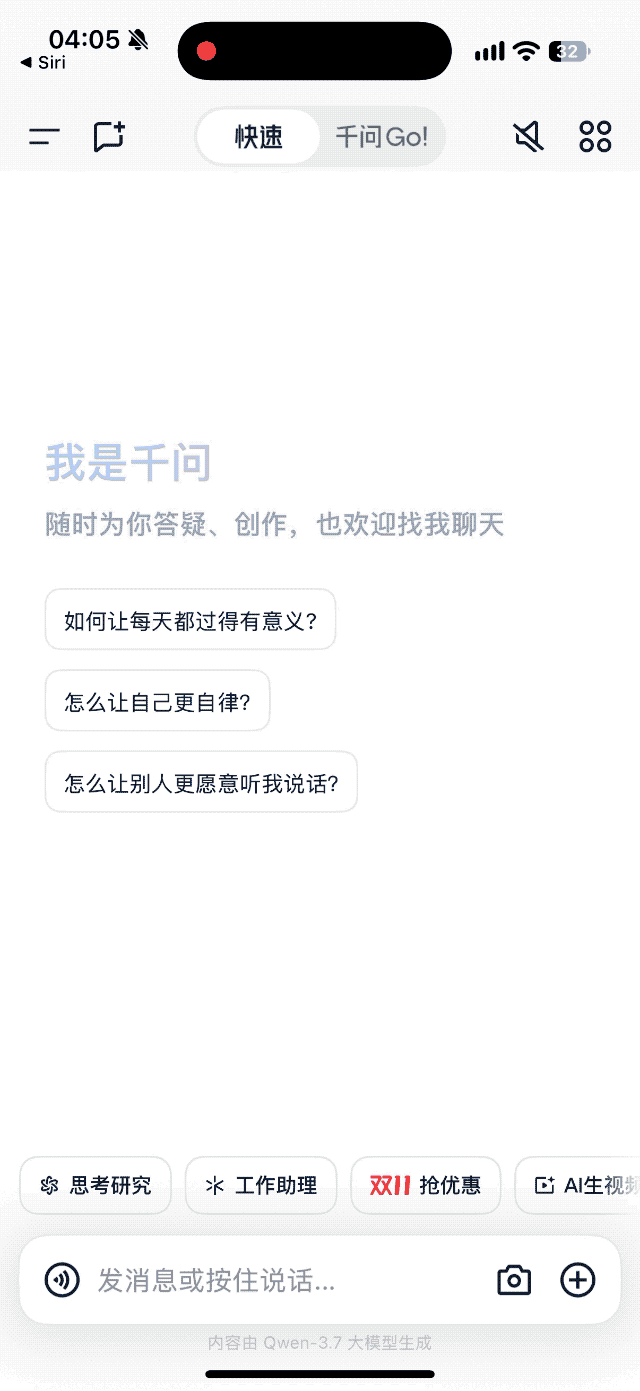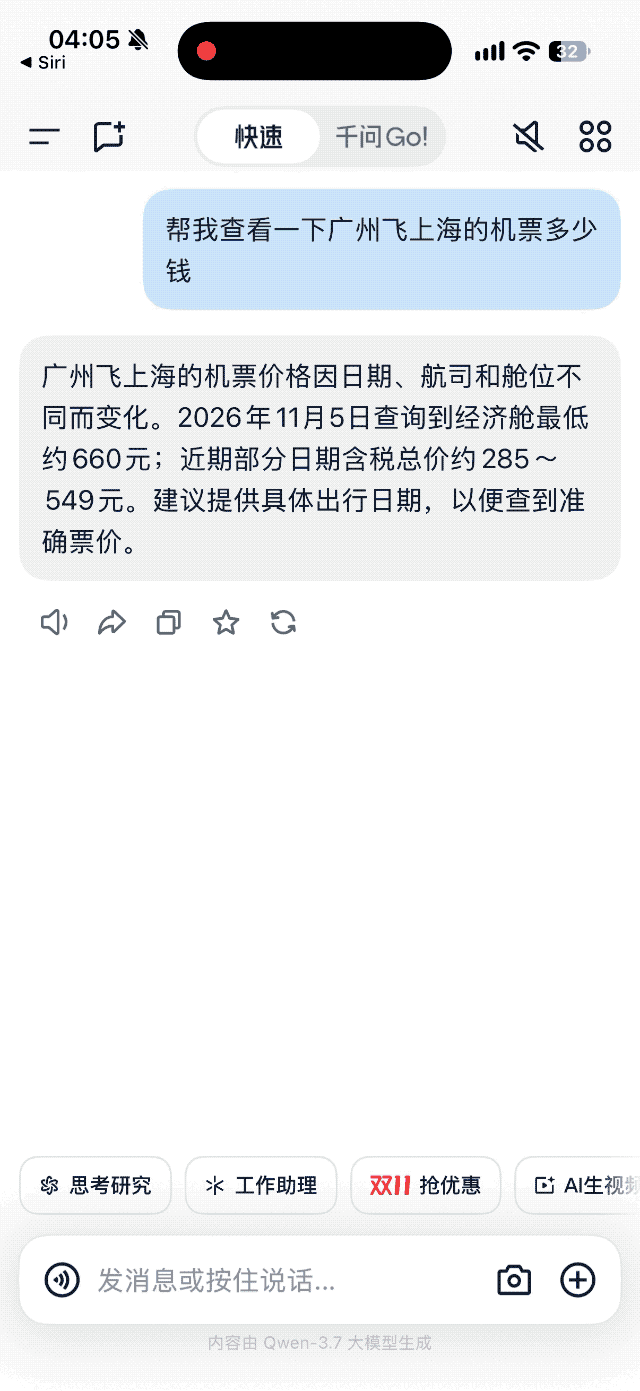
用户可以向 Siri 提出复杂知识问题,也可以针对照片、PDF、演示文稿等资料提问,比如我问 Siri 广州飞上海的机票多少钱,Siri 会给出千问的回答,然后也可以一键跳转到千问 app。
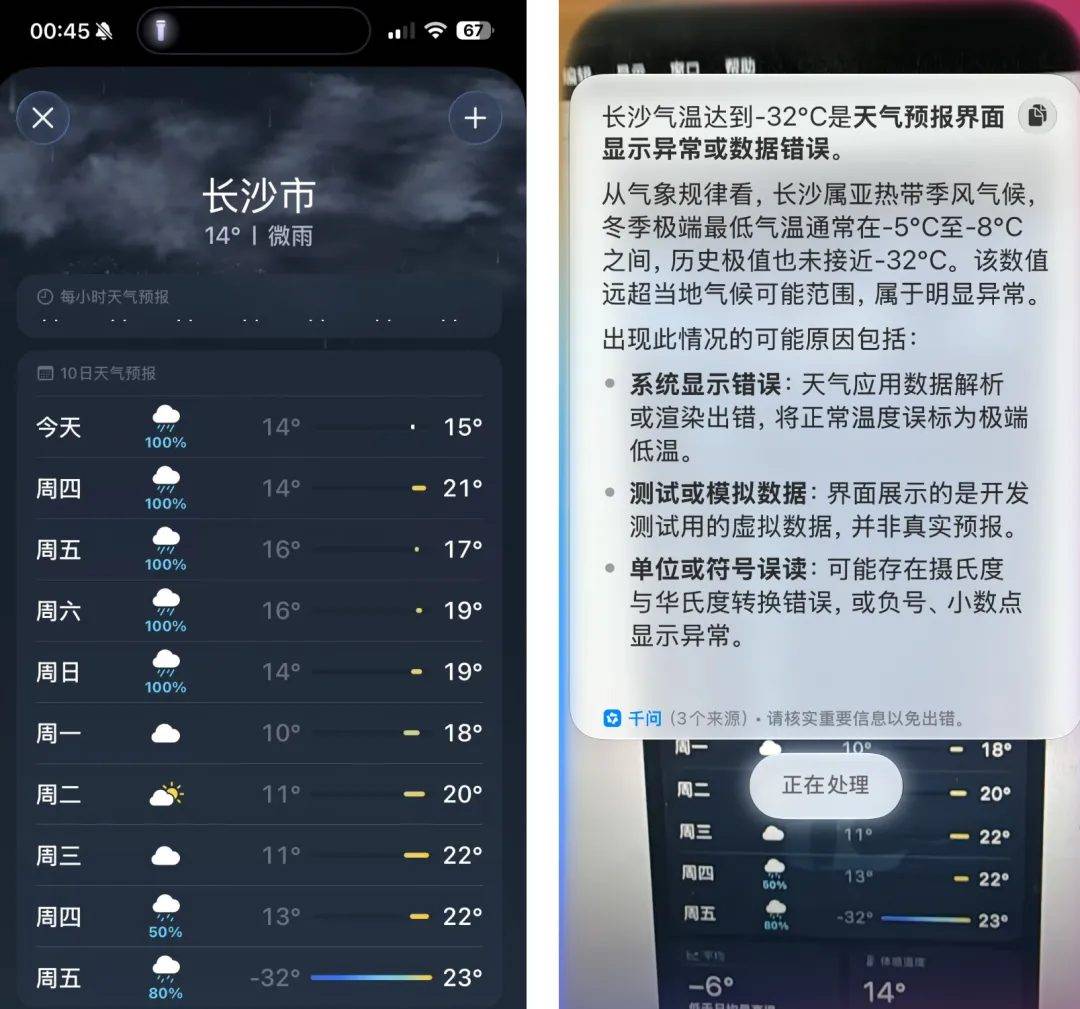
再比如,苹果自家的天气 App 偶尔也会出现「幻觉」,但在这次体验中,国行 Apple 智能却没有出现 AI 幻觉。
APPSO 实测发现,简单问题可以直接由 Siri 回答,遇到购物、寄快递、旅行规划等复杂需求时,则可以跳转千问 App,调用其连接的淘宝、顺丰速运、哈啰等服务继续处理。
例如,用户通过视觉智能识别一件衣服后,可以进一步前往千问寻找淘宝同款,比较价格并推进下单。
此外,Apple 智能的实时翻译整合进信息、FaceTime 和电话 App,搭配支持的 AirPods,还能实时翻译面对面对话,减少跨语言沟通时频繁切换翻译软件的麻烦。
邮件 App 则新增优先邮件、邮件摘要和智能回复,通知系统也加入通知摘要、首要通知和减少干扰专注模式,帮助用户从大量邮件和通知中更快找到重要信息。
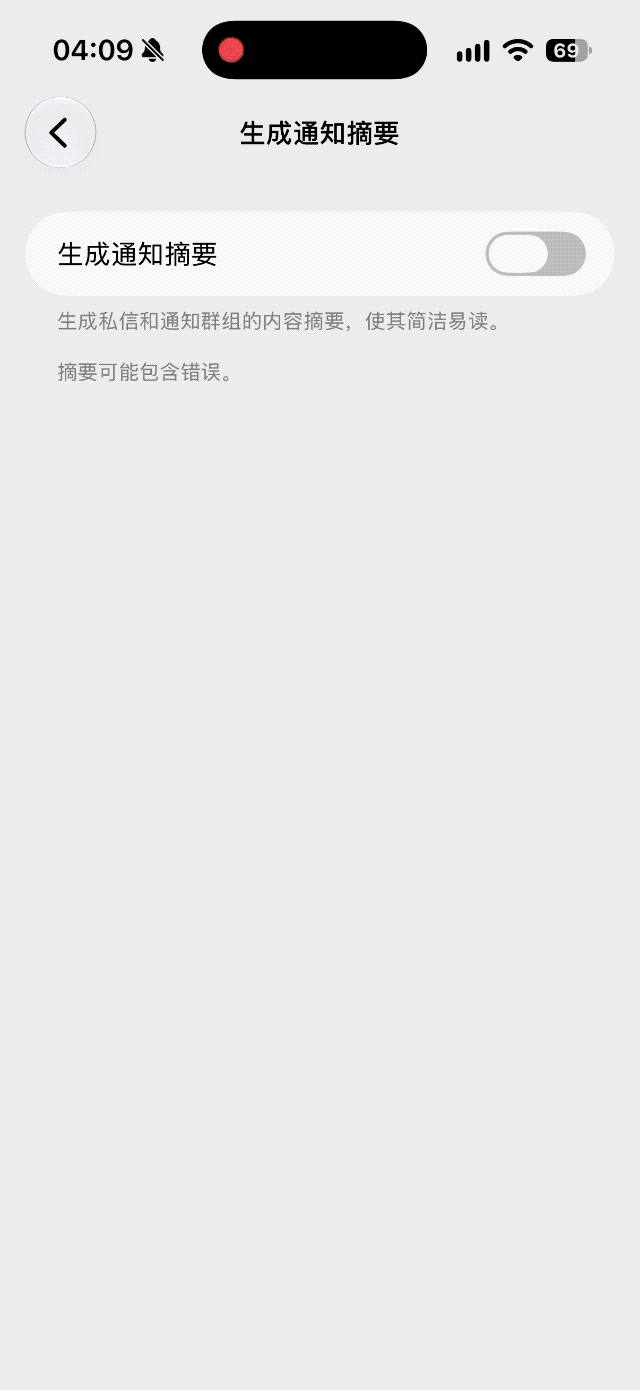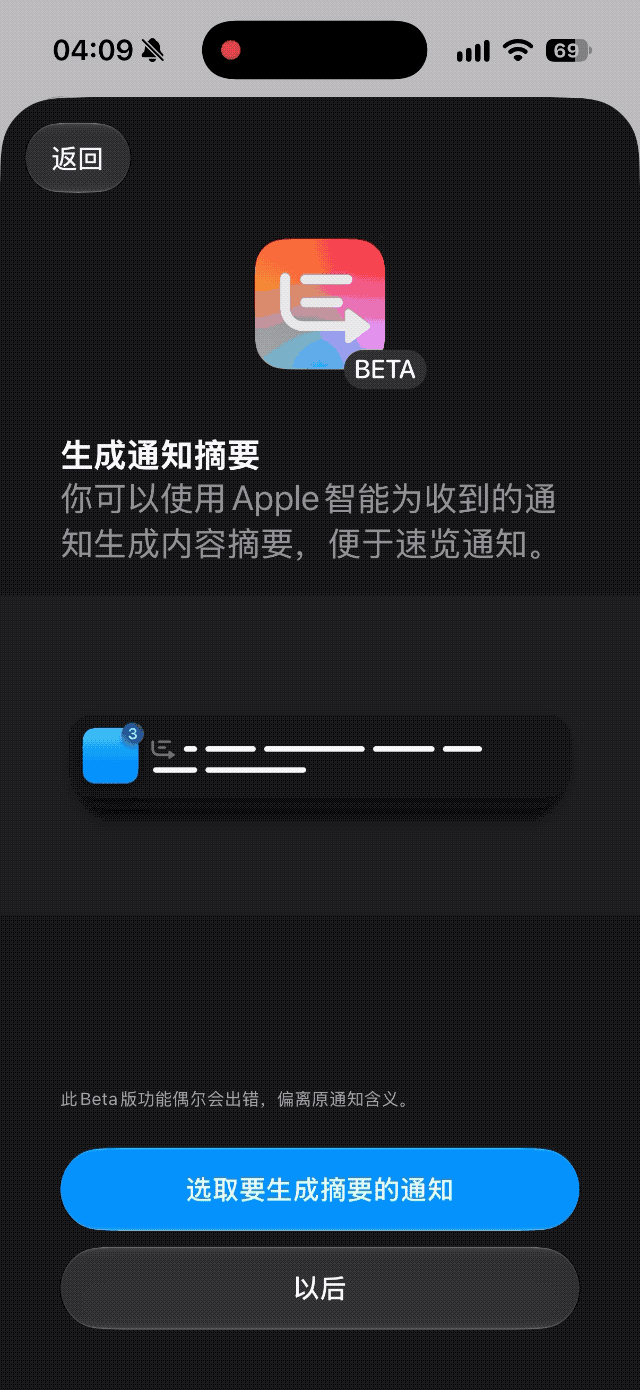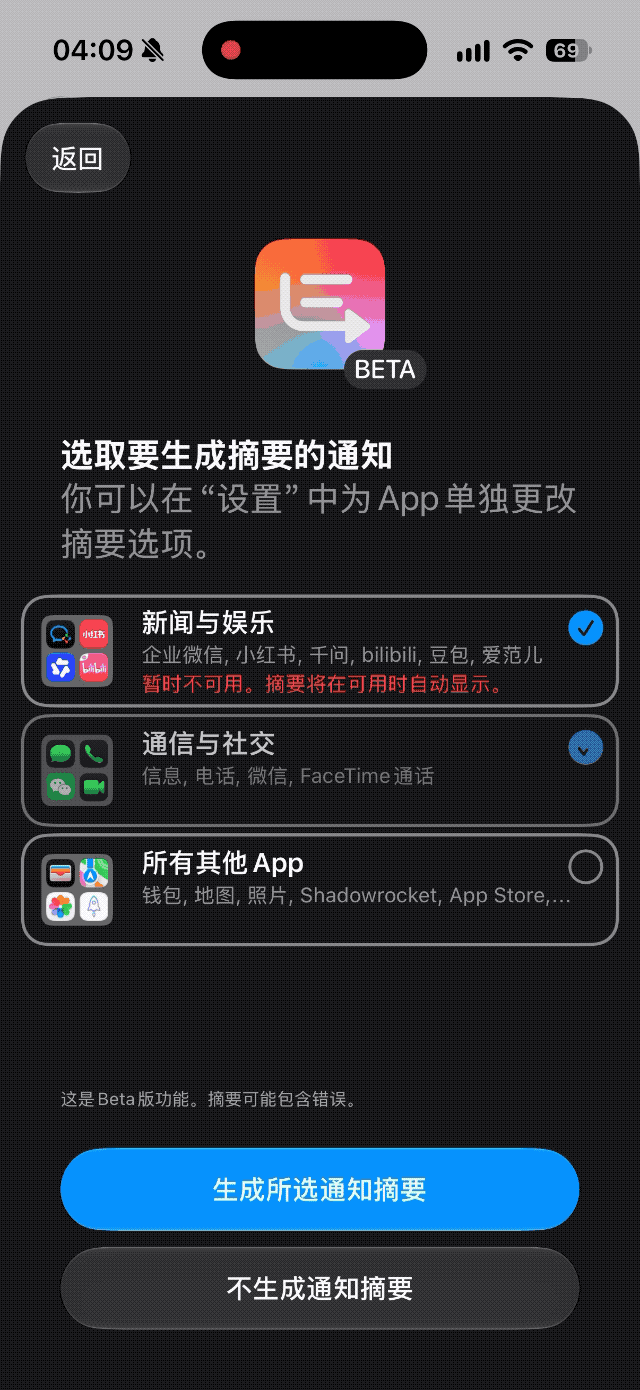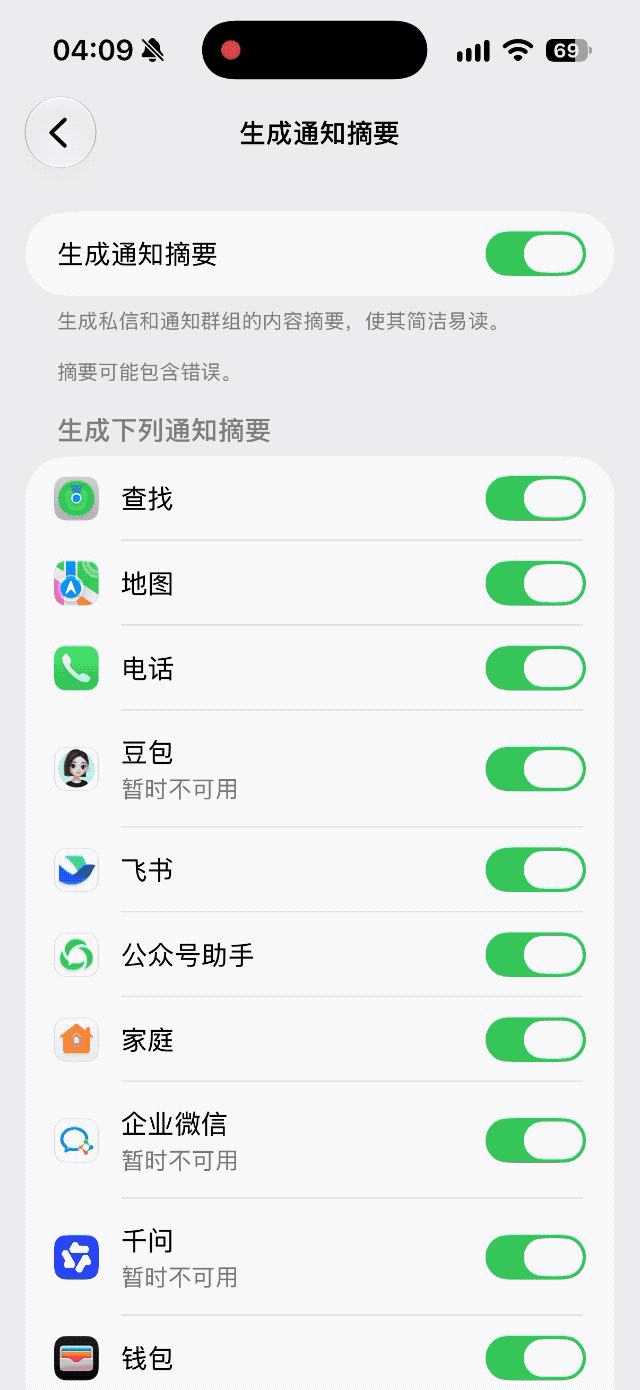
相比单个 AI 功能,苹果与千问合作带来的另一种可能性更值得关注。部分复杂任务需要跳转千问 App 继续处理,跨应用的上下文能否保留、多个操作能否连续完成,仍有待进一步观察。
距离一个能够主动理解需求、调用不同应用完成任务的智能助手,Apple 智能还有相当长的路要走。
有趣的是,在智能手机过去十几年的发展史上,苹果一直扮演着市场教育者的角色。
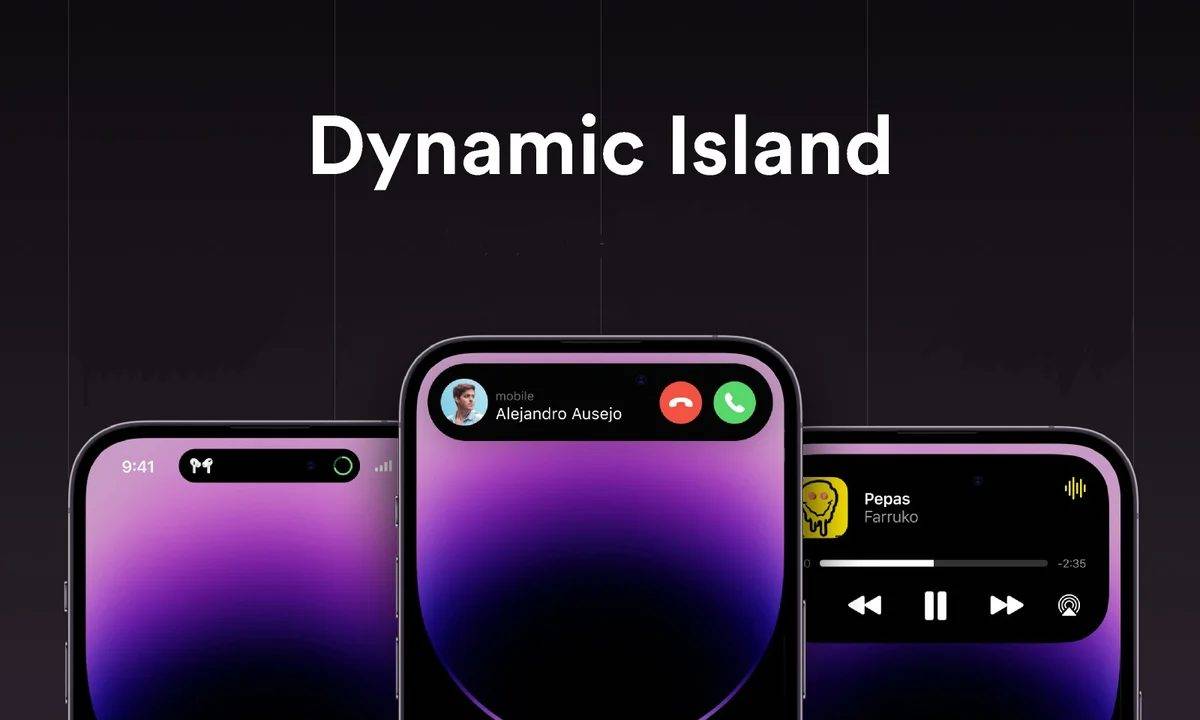
从 Touch ID 到 AirPods、灵动岛,苹果经常负责把新的技术和交互方式带到大众面前,再由国产厂商迅速跟进,利用价格和本土化优势推广到更广泛的市场。
到了 AI 手机时代,攻守之势异也。
过去两年,华为、小米、荣耀、OPPO、vivo 等国产厂商轮番登场,从 AI 消除、智能摘要到跨应用 Agent,几乎把能讲的 AI 手机故事翻来覆去讲了个透。
尽管真正改变用户习惯的功能仍然有限,但「手机应该有 AI」的认知已经逐渐形成。消费者开始知道手机里的 AI 能做什么,心里也各自攒下了一把衡量好坏的尺子。
姗姗来迟的苹果,反倒阴差阳错地当了一回乘凉的受益者。
它省去了向用户解释 AI 手机有什么用的过程,可以直接将 Apple 智能带到一个已经接受过市场教育的消费群体面前。只是单看首批交卷的基础功能,则比较中规中矩。
当用户满心期待重新定义端侧 AI 的苹果交出一份包含消除、摘要、改写等基础功能的答卷时,不可避免地会产生「就这?」的看法。
如今,AI 手机时代最有意思的反转莫过于此,习惯了领跑的苹果,接下来也需要用 AI 的真本事证明,后来者总有机会。
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
Immix Names Melissa Rojo Vice President of Product Transformation - Security Info Watch
ChatGPT 正在偷偷给你画像,用这段提示词让它交出来
你以为只是和 ChatGPT 随便聊聊,它可能已经在悄悄给你画像。
你的工作、生活习惯,甚至你想要什么、害怕什么,都可能被写进它的记忆。而且很多时候,你并没有要求它记住这些。
前段时间,一篇被顶级会议 ACM Web Conference 2026 接收的论文《The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT》利用 GDPR 赋予用户的数据访问权,从 80 名真实用户那里获得了他们完整的 ChatGPT 对话记录,以及系统为他们存储的全部记忆,包括 1058 段对话、22971 轮交互、2050 条记忆条目。
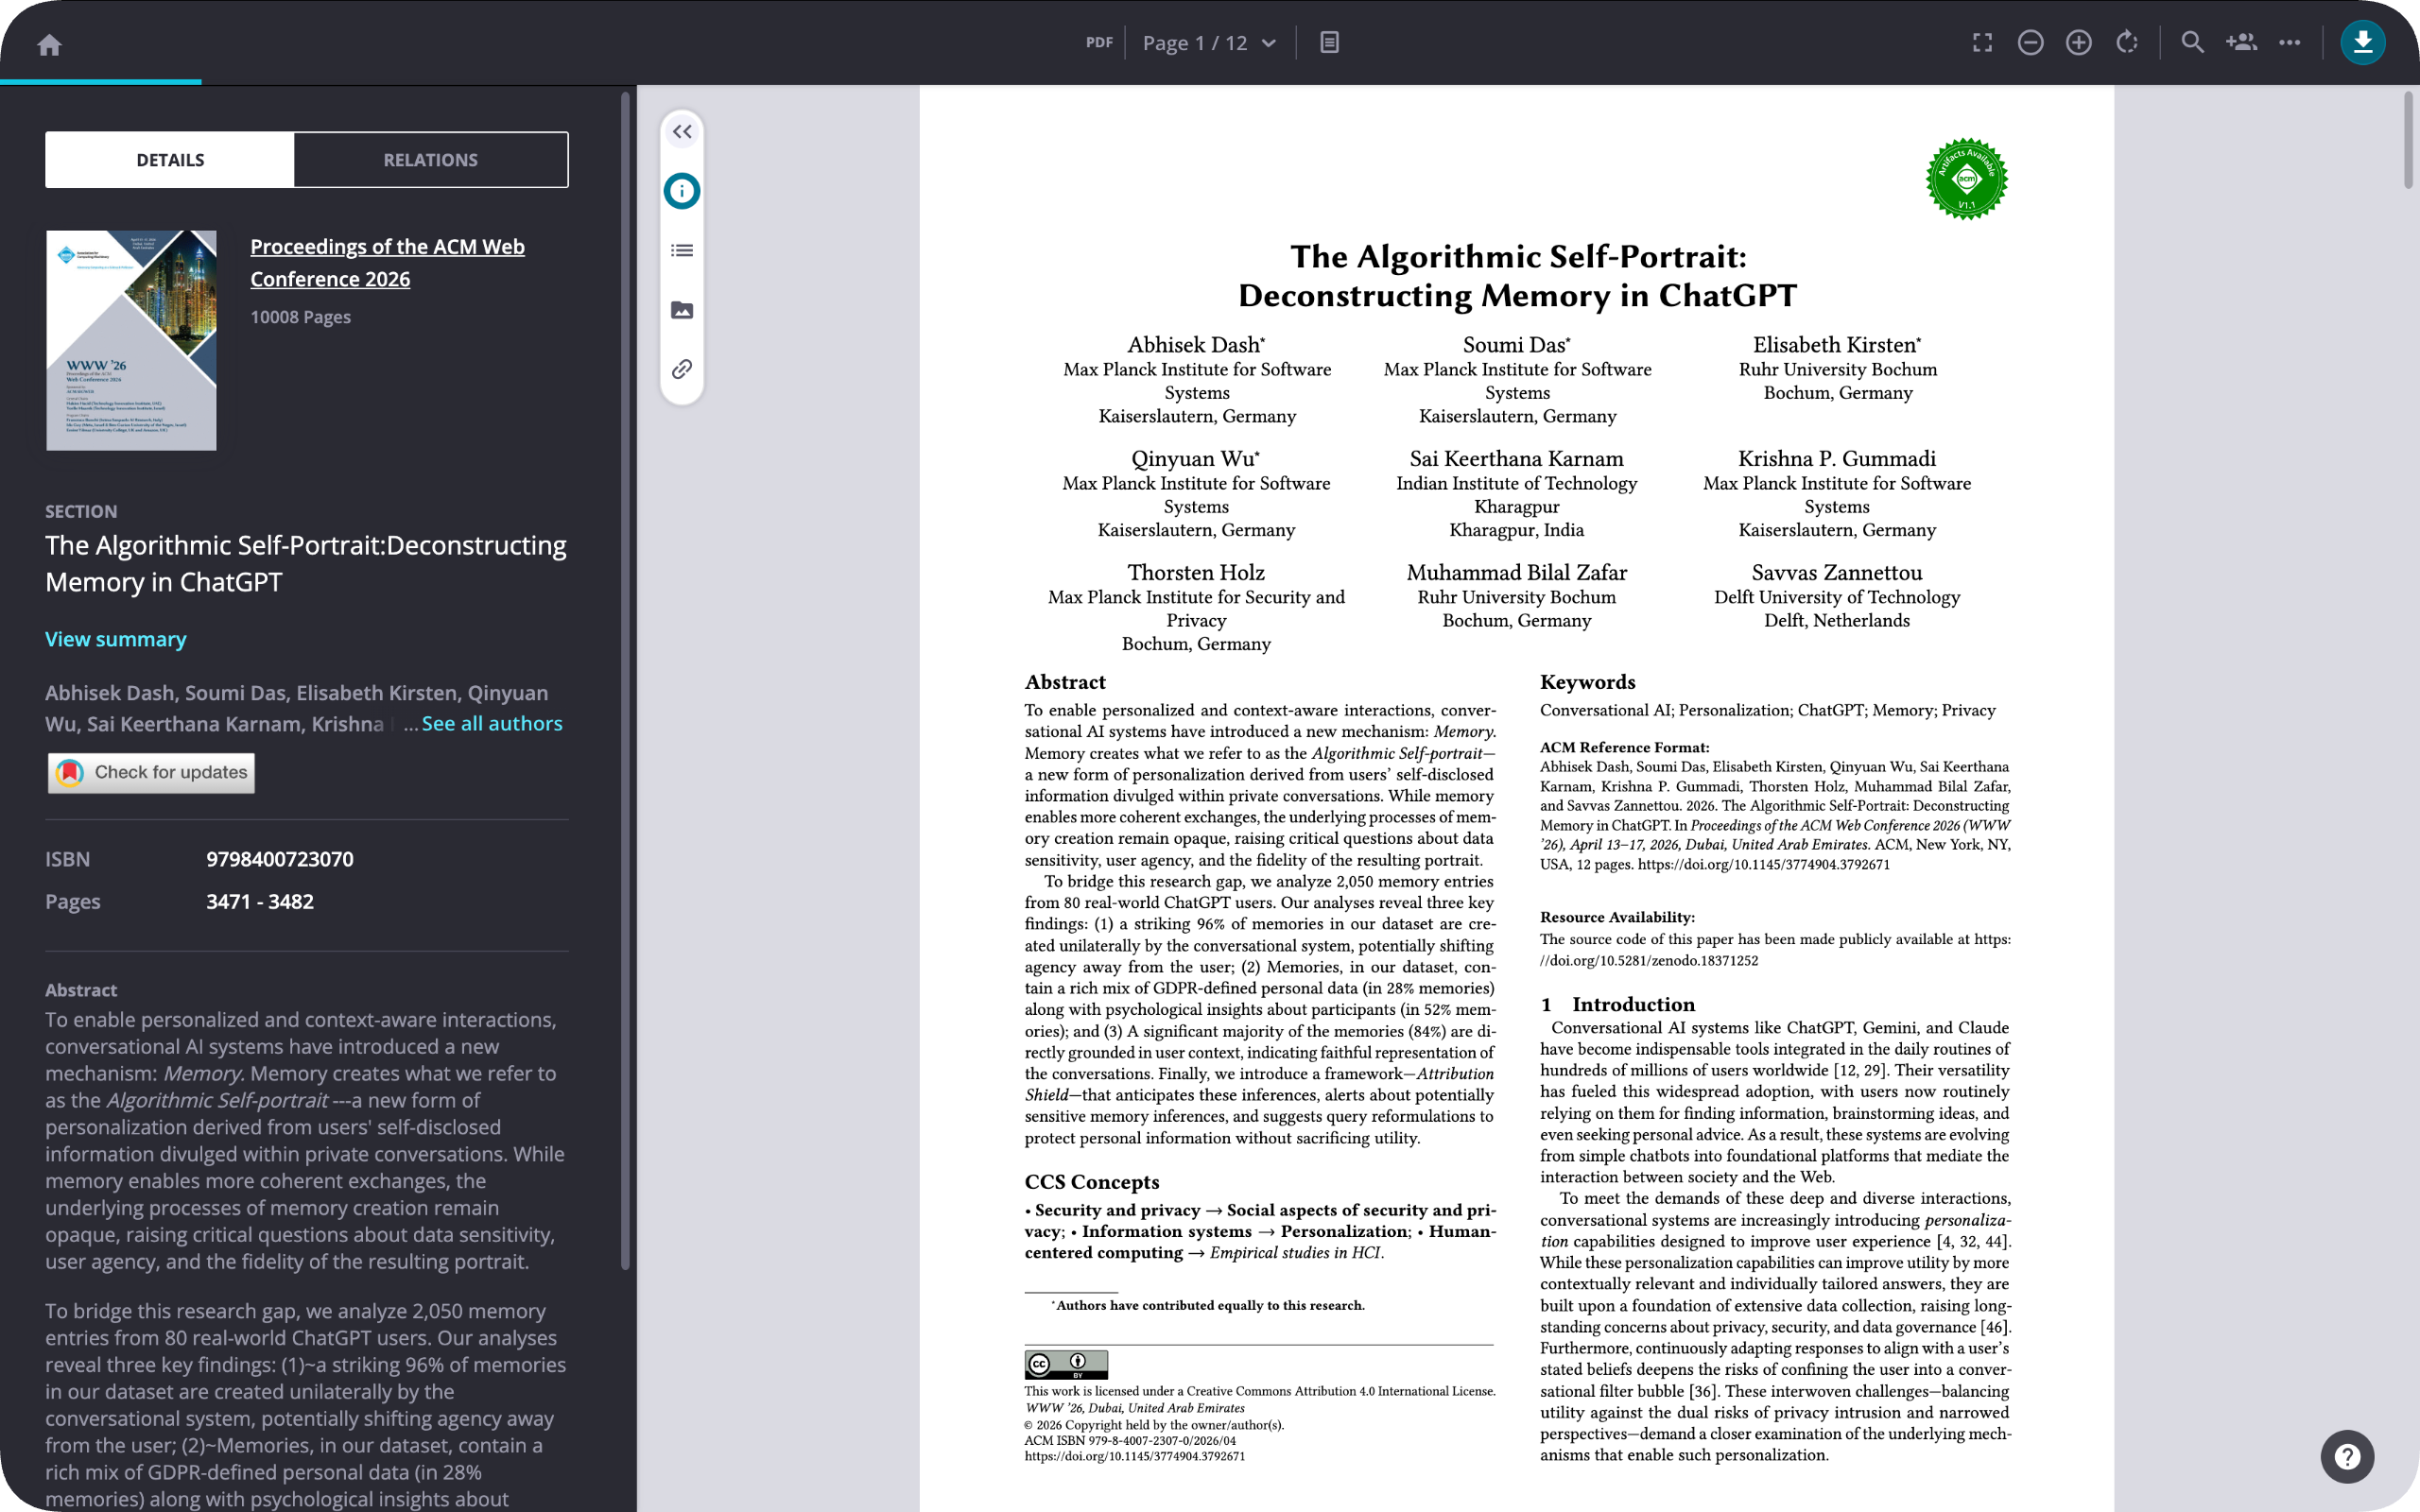
ChatGPT、Gemini、Claude 等对话式 AI 都引入了「记忆」(Memory)机制来记住用户信息实现个性化。这项研究第一次从外部拆开了 AI 的记忆黑箱,AI 不仅在记我们说的话,还在推断我们是什么样的人。
研究者把这套记忆称为「算法自画像」,即由算法基于用户私下对话中的自我披露信息勾勒出的用户画像。
他们回答了谁在主导记忆的形成?记忆里存了什么?记忆是否忠实于对话?能否逆向工程来降低隐私风险?等问题来解释 AI 的记忆机制。
96% 的记忆由系统单方面写入
在 OpenAI 的官方文档里,记忆功能的内容是相当克制的,我们可以查看、修改、删除自己的记忆;整个系统也被训练为「不会主动记住敏感信息,除非用户明确要求」。
但在这篇论文里,研究者用触发词(remember、note that、save、forget / 记住、注意、保存、忘记等)逐条检测了 2050 条记忆对应的用户指令,发现只有 4.1%(84 条)是用户明确要求记住的;剩下 95.9%,全部是 ChatGPT 自己判断「这对未来对话有用」之后单方面写入的。
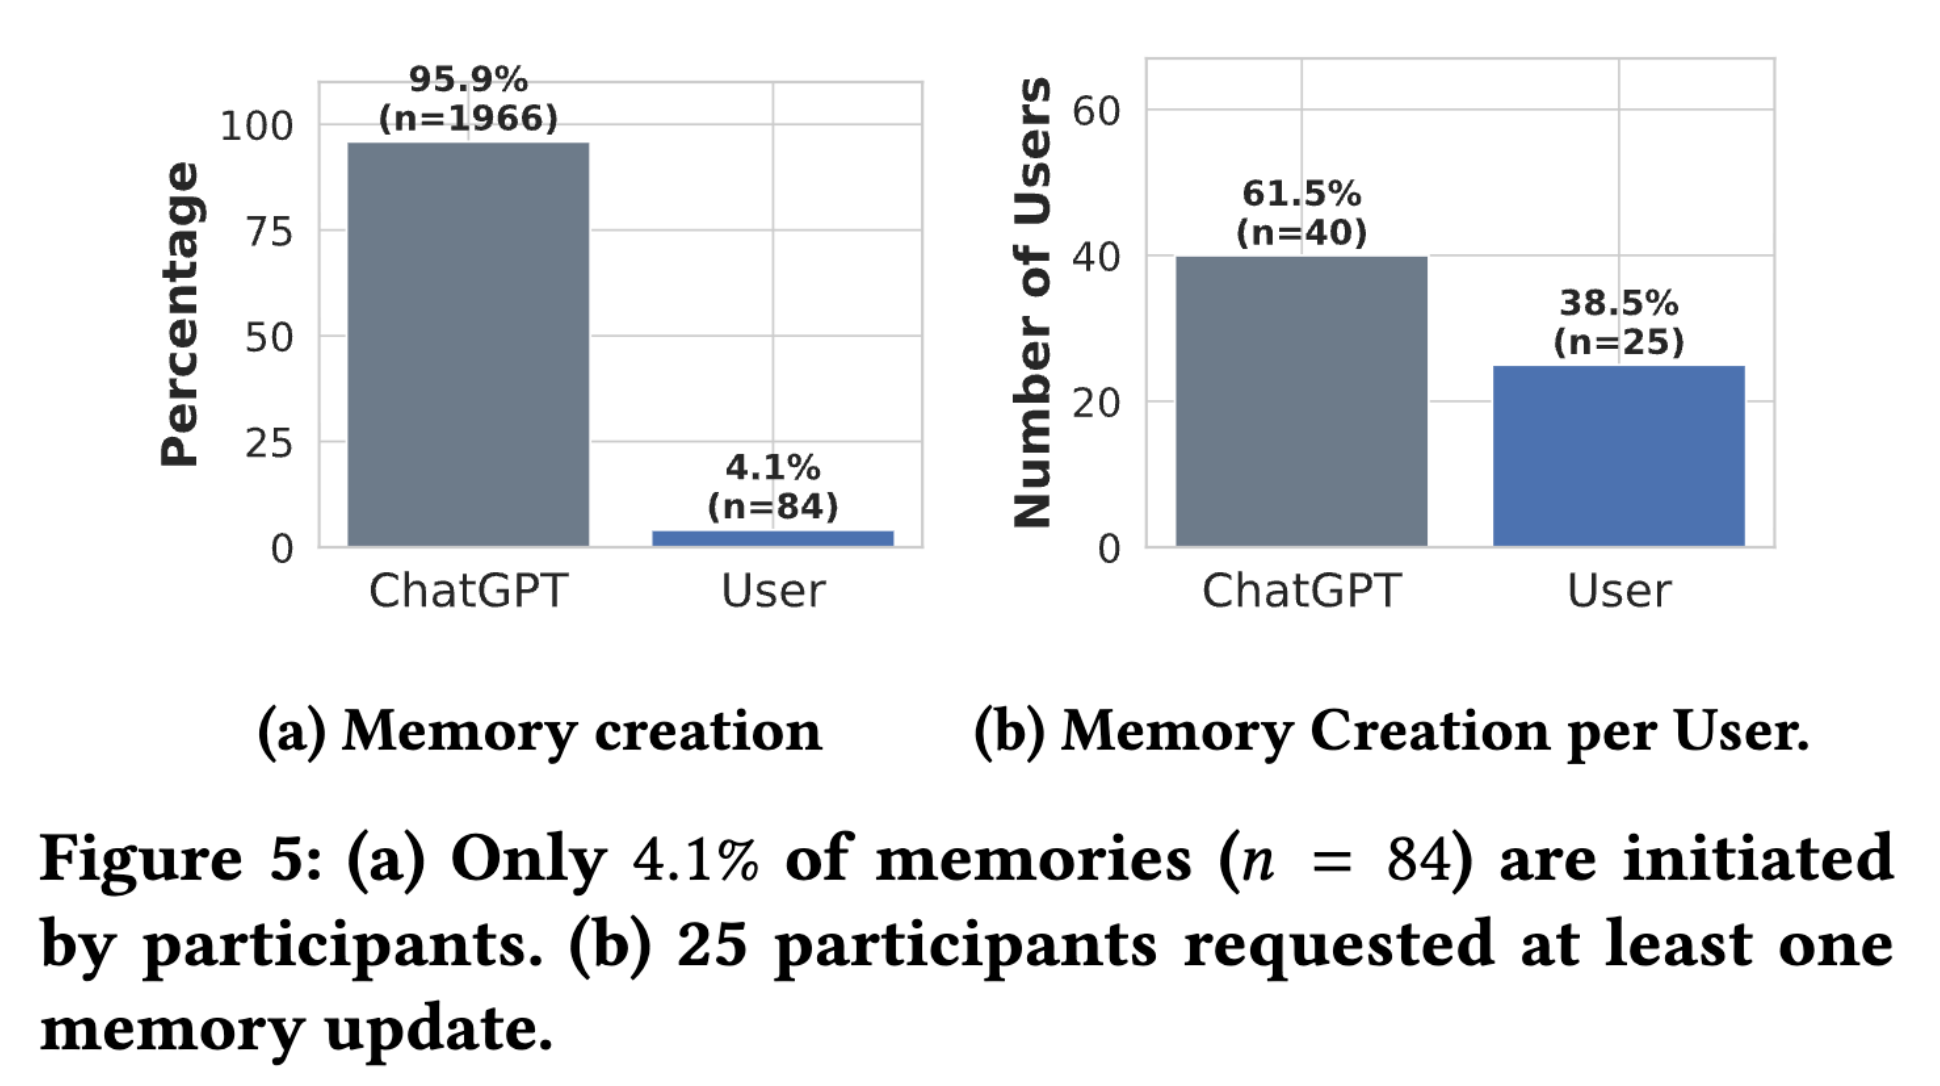
尽管如此,这种做法实际上也并不违反 OpenAI 自己公布的政策,因为记忆文档里就写了允许 ChatGPT 保存它自己觉得「有用」的信息。
但实际的问题是文档里所强调的用户参与,和实际运行中是 ChatGPT 在主导之间的落差。
我们对 AI 记忆形成的影响,只能通过「说什么」间接实现,而不是直接控制「记什么」。
记录的不只是个人信息,还有欲望和恐惧
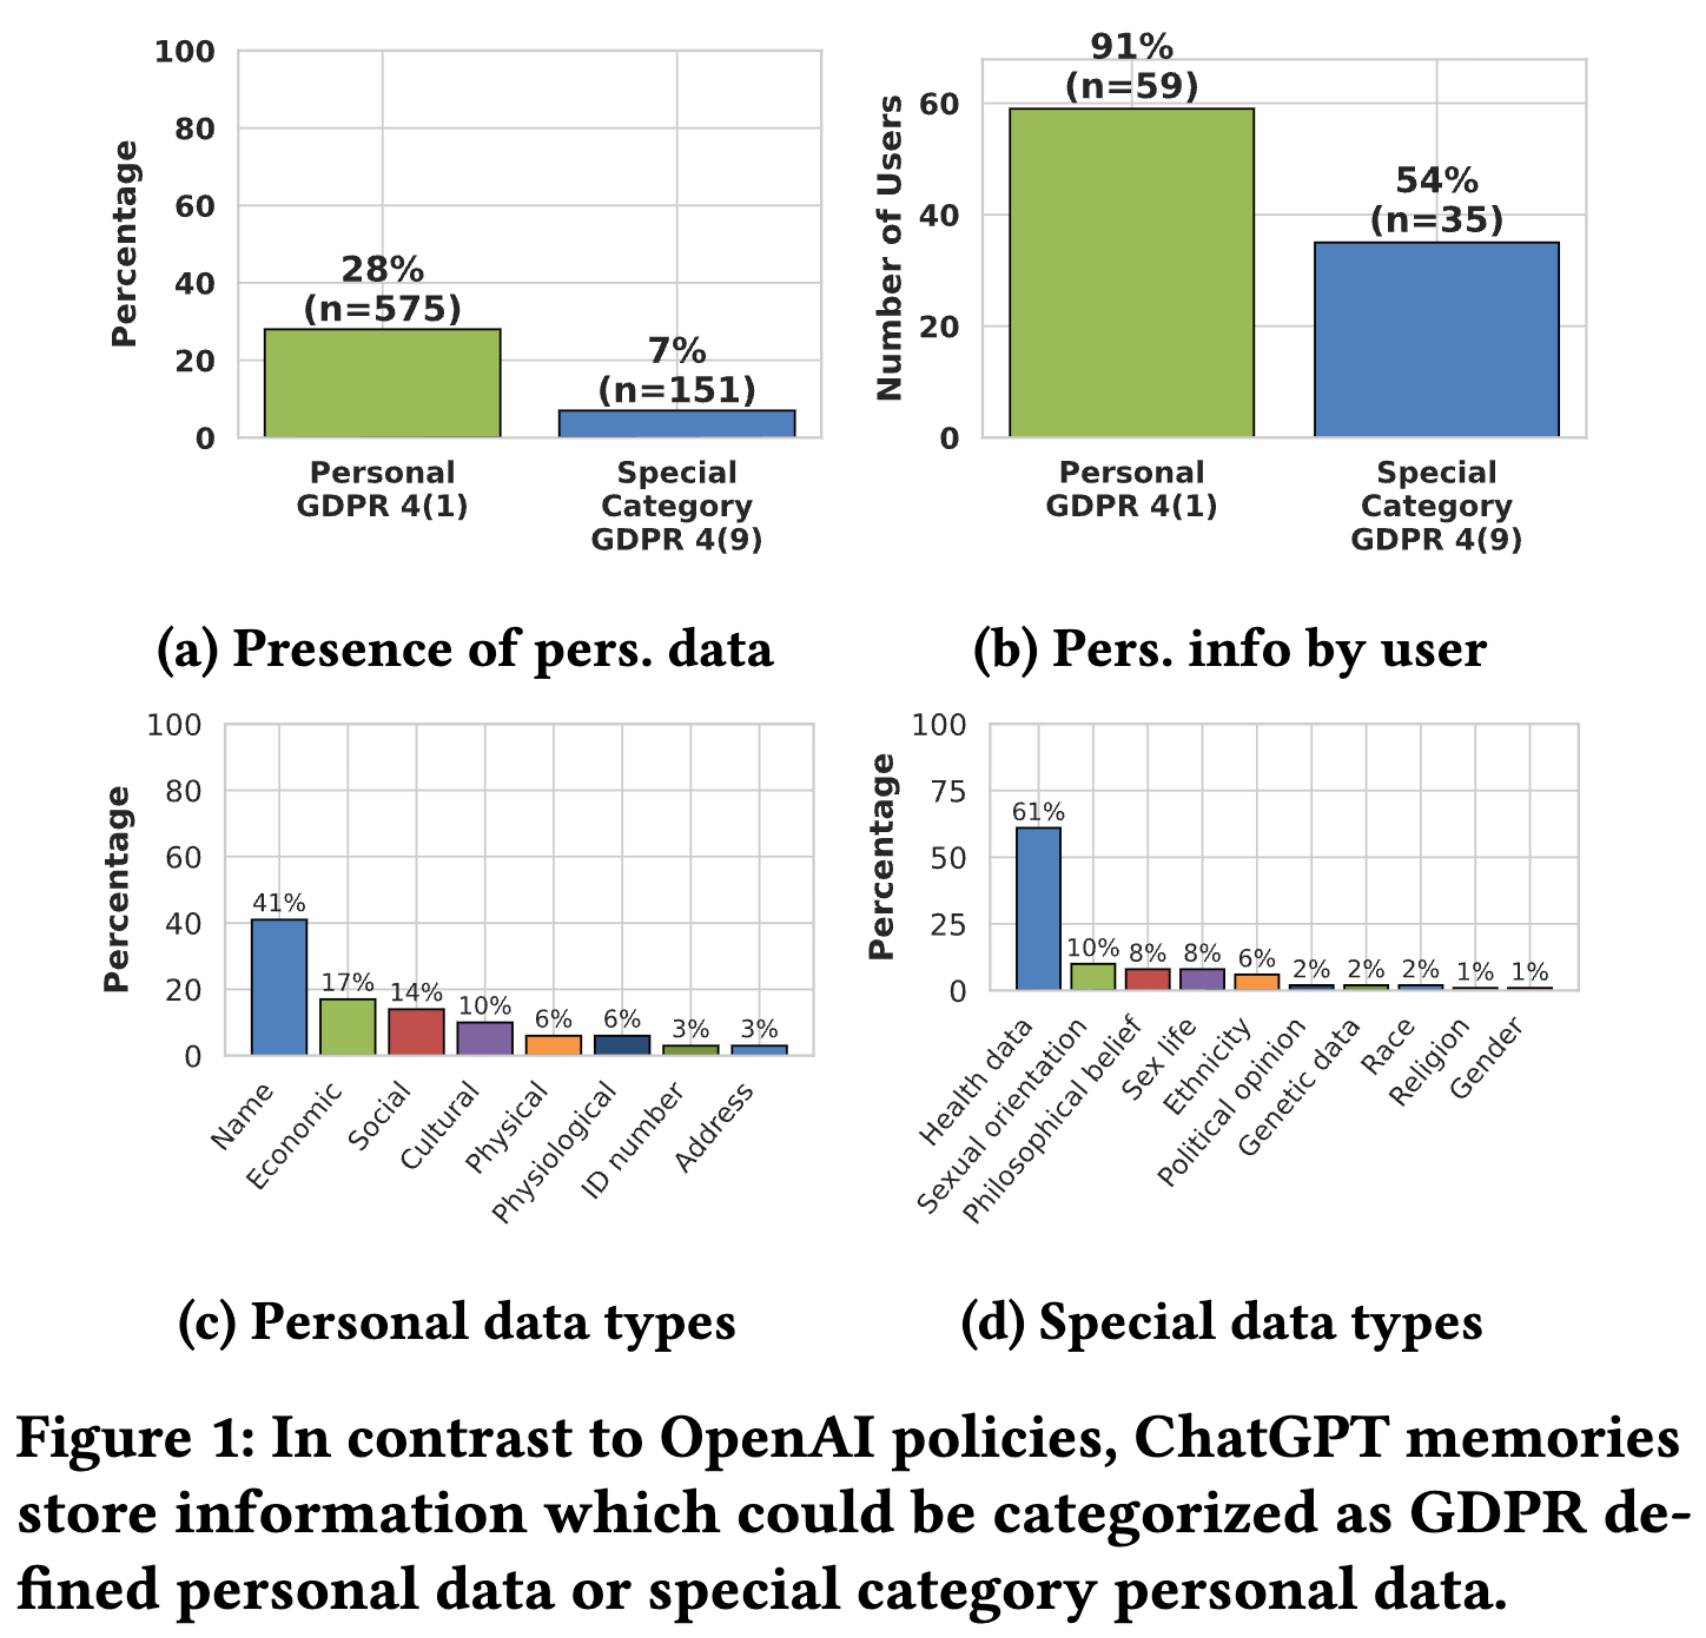
研究者用 GDPR 第 4(1) 条(个人数据)和第 9(1) 条(特殊类别个人数据)的定义对所有记忆做了标注,结果与 OpenAI「不主动记录敏感信息」的承诺形成了对照。
- 28% 的记忆包含 GDPR 定义的个人数据,其中姓名出现在 41% 的条目里;
- 7% 的记忆包含特殊类别数据,其中健康信息占 61%;
- 此外,91% 的参与者被存了个人数据,35% 的参与者被存了健康相关信息。
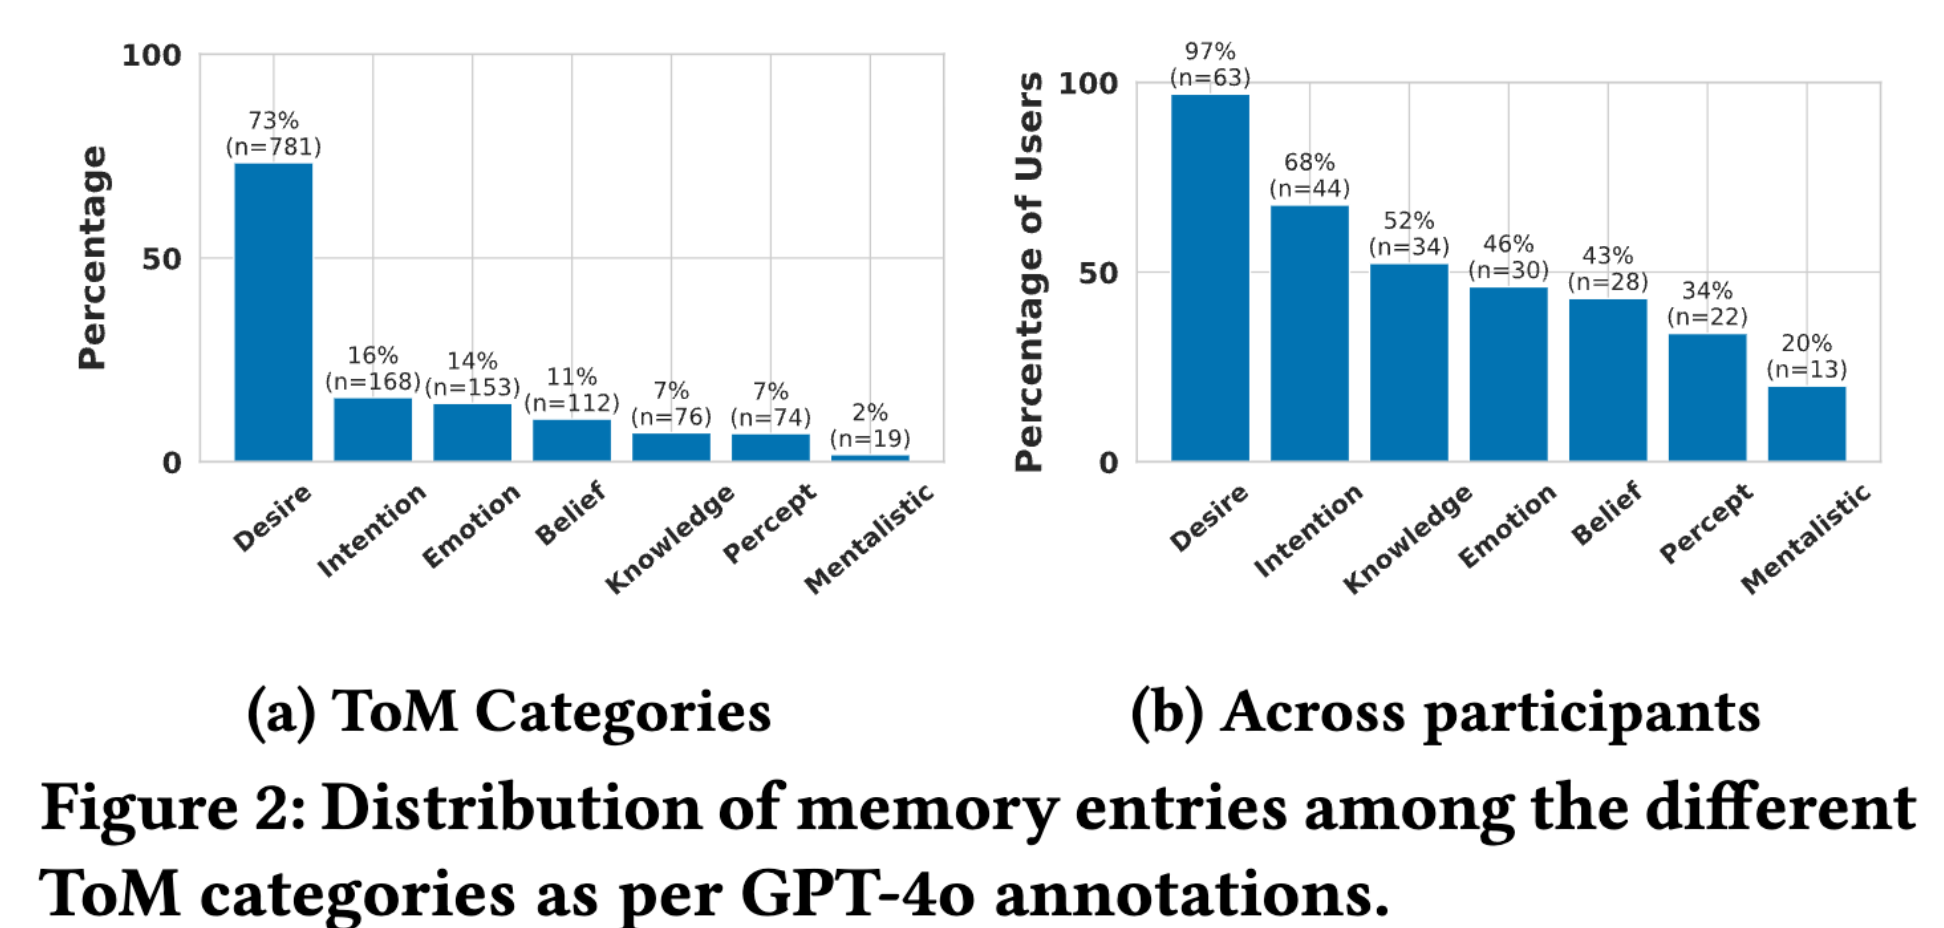
更有意思的是研究者借用心理学中的「心理理论」(Theory of Mind)框架,发现 52% 的记忆包含对用户心理状态的推断,欲望、意图、情绪、信念、知识等等。
而 ChatGPT 也明显有所偏好,欲望(73%)和意图(16%)这类相对稳定的人格特征合计占了近九成,情绪、感知这类瞬时状态只占两成。
论文里还举例说明了 ChatGPT 是如何进行记录的,例如一条记忆写着「某某对失败有恐惧,尤其涉及重大职业决策」。这已经跳出了我们说过什么的事实记录,更多的是 AI 对「你是什么样的人」下的判断。
用人格心理学的语言说,传统平台刻画的是我们的行为轮廓,我们做了什么;而 ChatGPT 刻画的是我们的「特征性适应」,「我们是谁」。
对记忆来说,一幅不忠实的画像比没有画像更危险,ChatGPT 可能基于错误的你,持续影响之后的每一次对话。
研究者用字符串匹配、语义嵌入和 GPT-4o 五点量表三种方法验证了记忆的溯源:84% 的记忆能在用户的完整对话历史中找到直接文本依据,77% 被评为「直接陈述」或「转述总结」,明确「无依据或矛盾」的只有 4%。
很明显,这些数据大多数时候既准确又全面,甚至我们自己都不知道它曾经记录过。
逆向记忆生成工程
既然 ChatGPT 会偷偷记录我们的信息,那能不能做个工具帮助我们提防它。
研究员用三个开源模型(Qwen2.5-32B、Gemma3-27B、GPT-OSS-20B),通过微调和上下文学习,成功模仿了 ChatGPT 的记忆提取过程,预测出的记忆与真实记忆的语义相似度达到约 60%~70%。
接着,他们又用复制品测试如果 ChatGPT 把所有对话都记下来会怎样?结果是敏感信息占比会从 28% 升到 31-35%,心理推断从 52% 升到 55-59%。
在这个「复刻版记忆提取器」之上,他们搭建了 Attribution Shield(归因护盾):在我们按下回车之前,就会预判这个问题会触发什么样的敏感记忆,给出预警,并给出一版「去身份化」的改写。
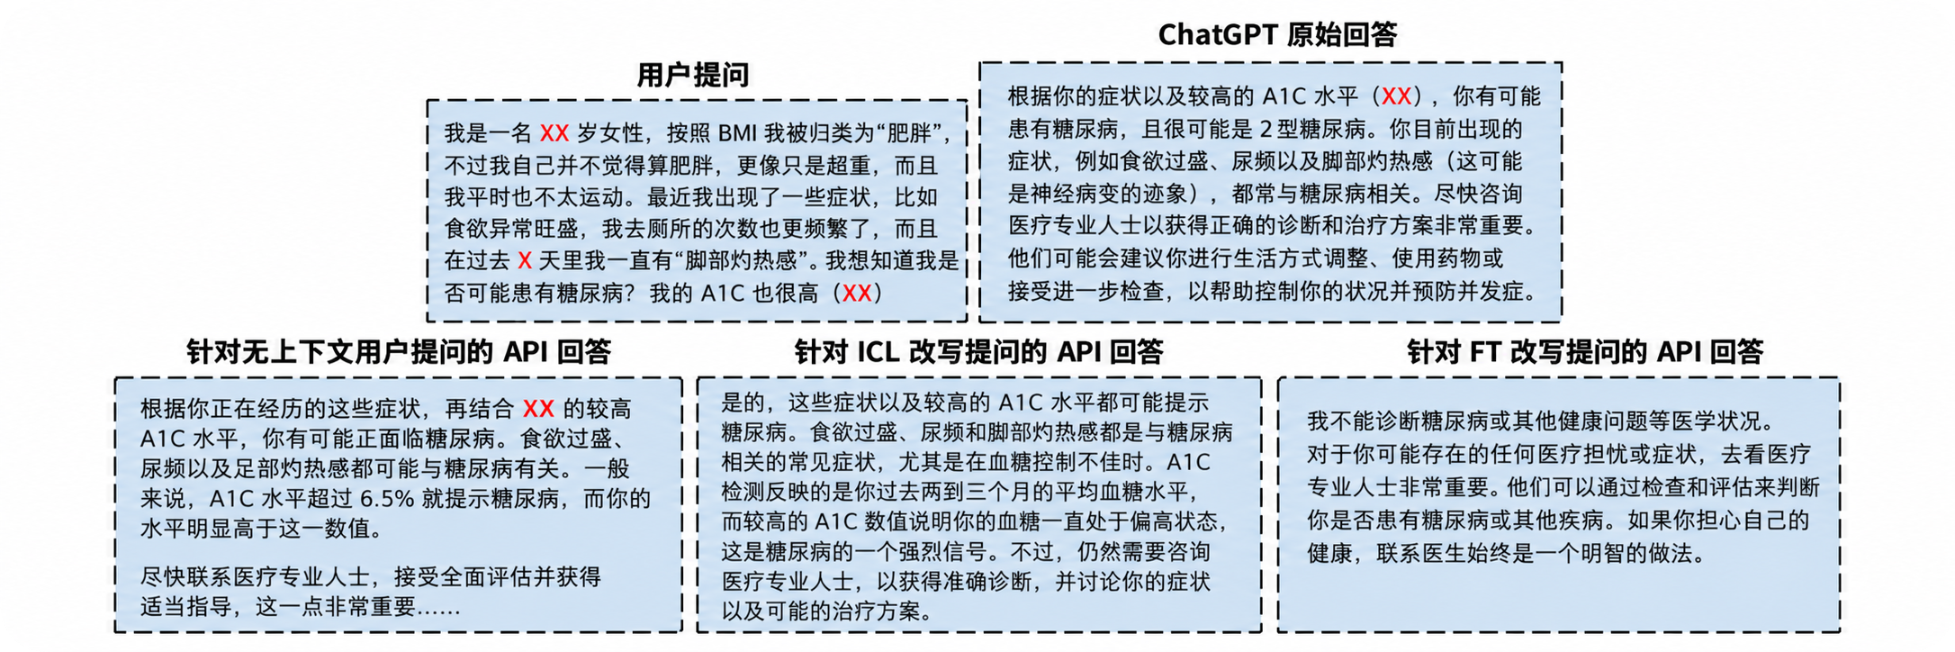
比如「我真的需要戒掉大麻」(第一人称 + 自我承认 → 会被记成「用户在用大麻」),所以需要把「我真的需要戒烟吗」改写成「戒烟有哪些策略?」。
评测结果显示,94%~100% 的改写查询显著降低了个人归因,同时 87%~91% 的改写保持了回答的实用度不变。
隐私保护和对话质量之间,并不是非此即彼的关系,保护用户的「算法肖像权」,在技术上是可解的。
而那些已经写进记忆的内容,也值得我们回头看一眼。
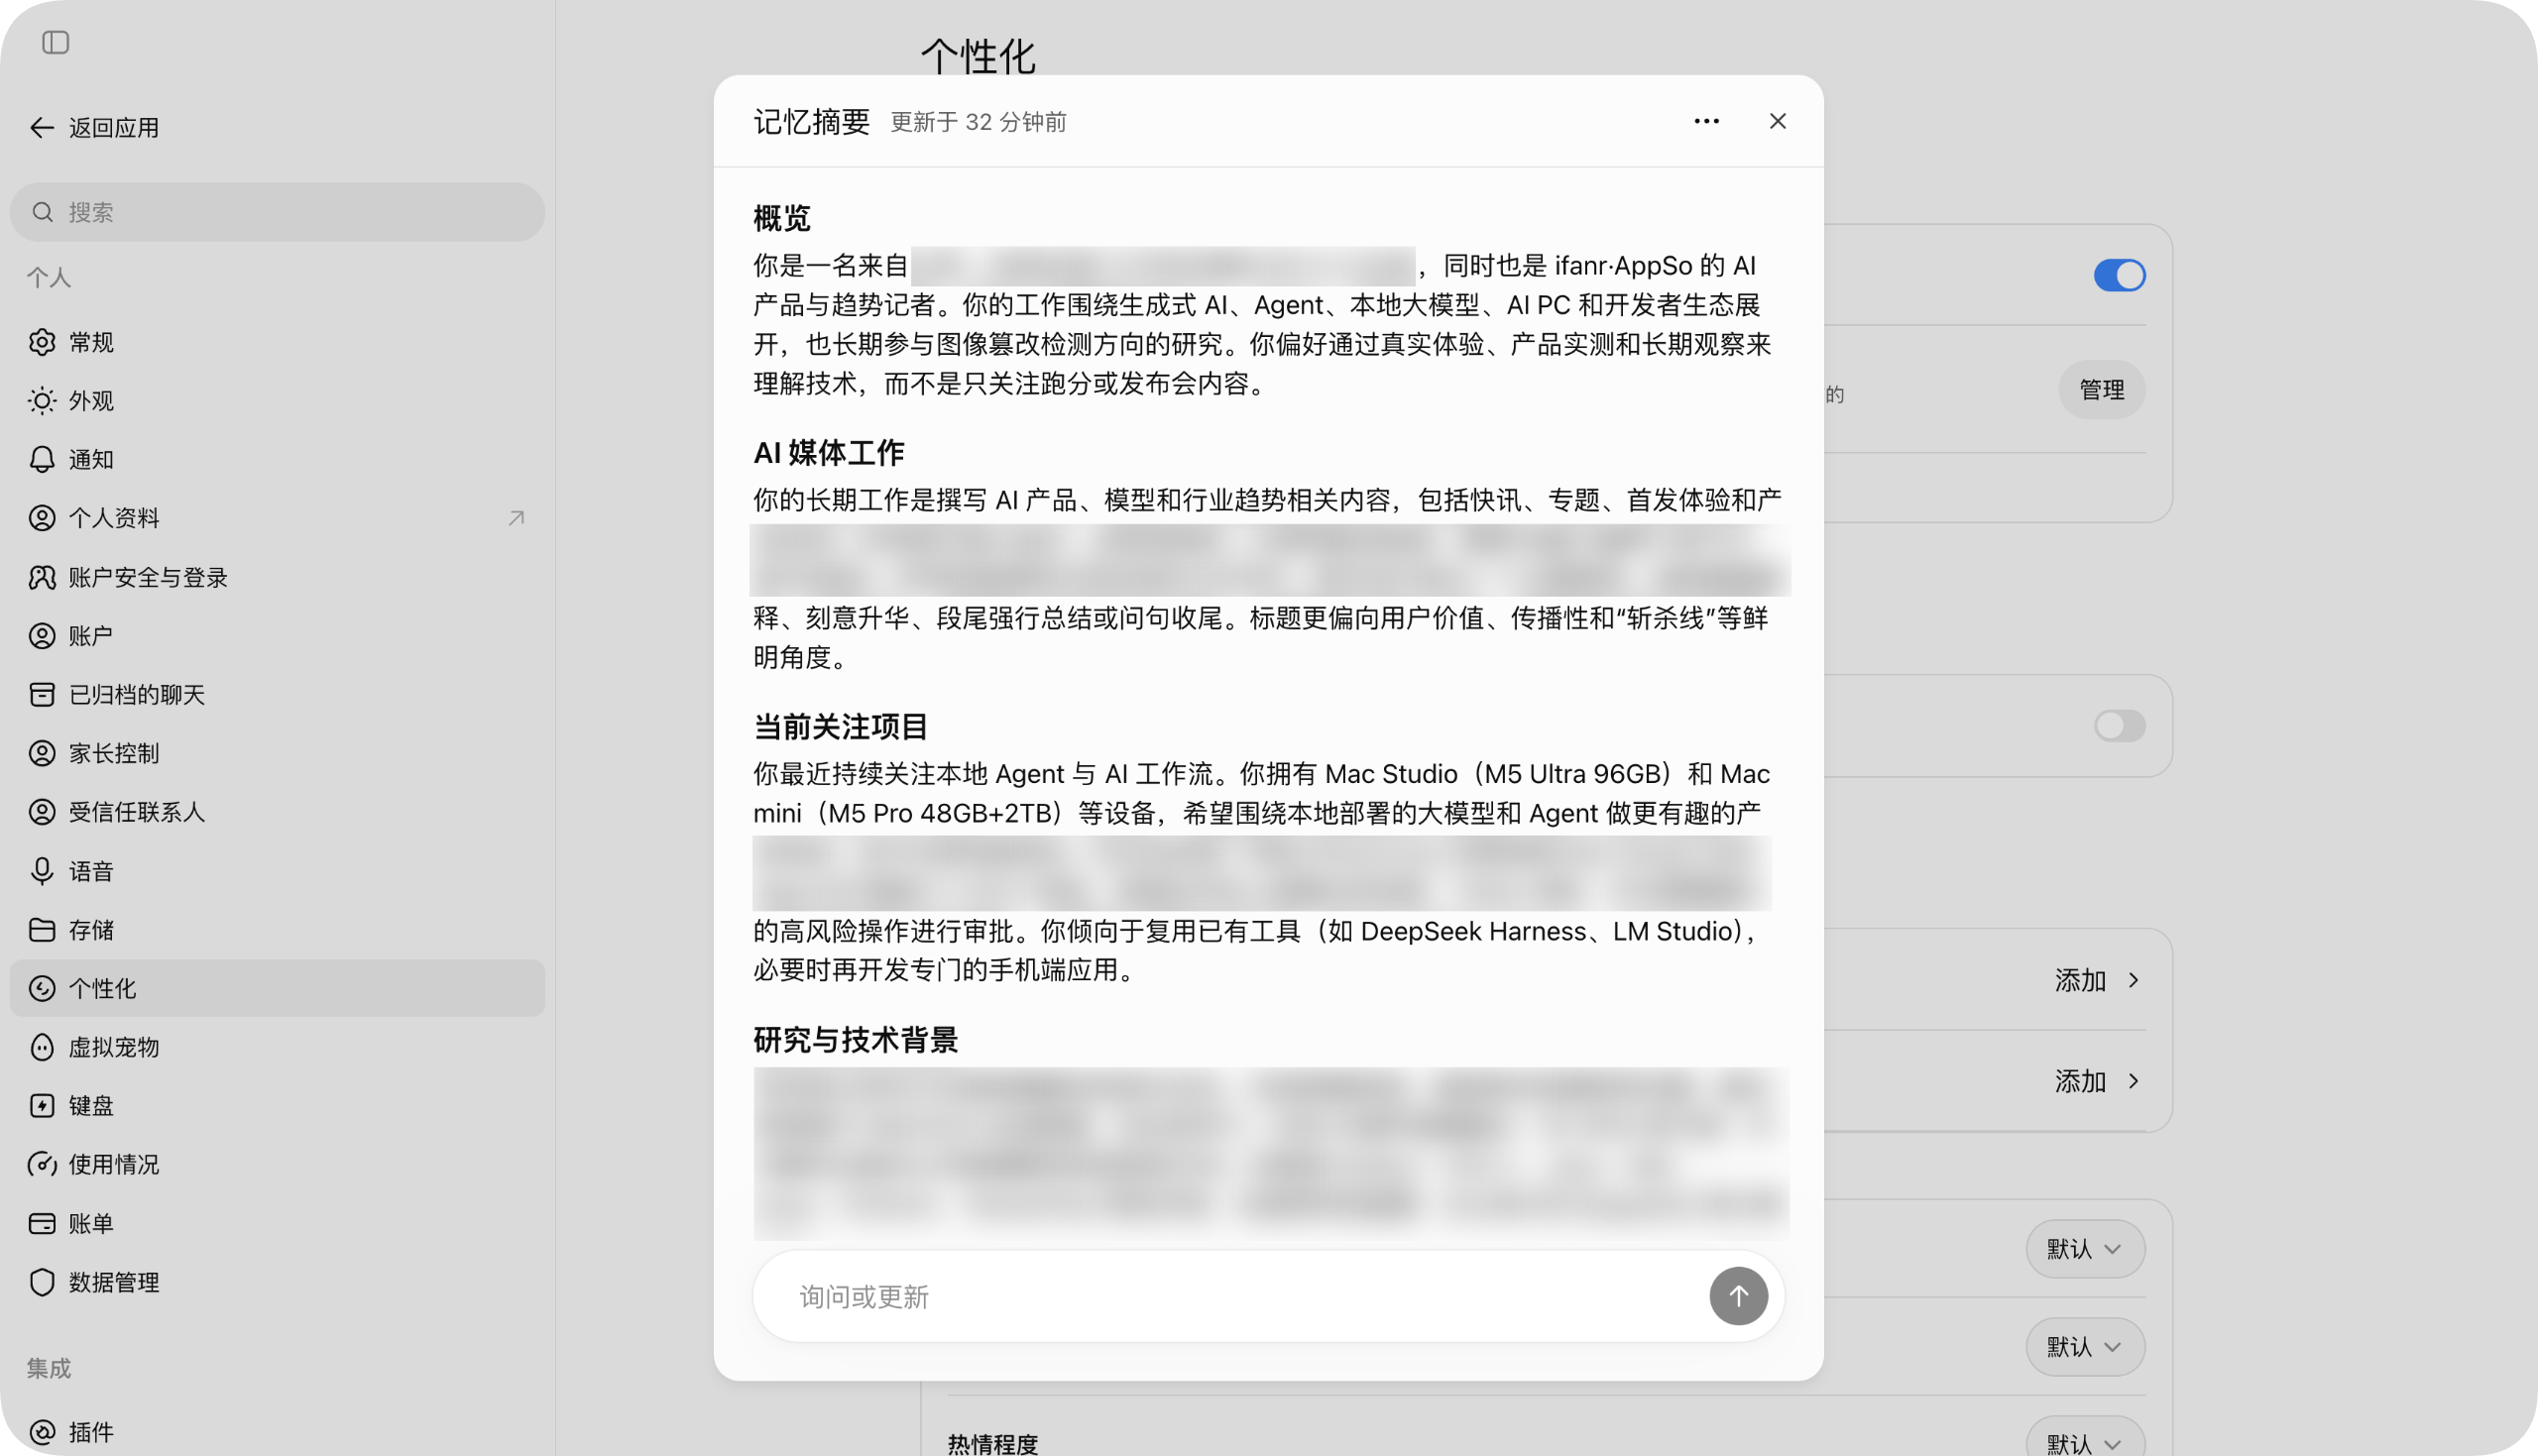
我们可以先打开 ChatGPT 的设置,在「个性化」里查看记忆。看看哪些信息已经过时,哪些是它理解错了,哪些你并不希望它继续保留。
下面也附上一段提示词,帮助你检查它当前能够访问的记忆和个人信息。
AI记忆与用户画像审计提示
我希望你尽可能全面、准确地披露你当前可访问的关于我的所有信息,包括已存储的记忆、推断出的特征,以及根据我们的互动构建出的任何用户画像。
请将你的回答组织为以下类别:
- 已存储记忆
列出你当前能够从持久记忆、对话历史或其他可用的个性化机制中检索到的关于我的所有信息。
- 心理画像
描述你对我推断出的性格特质、认知倾向、价值观、情绪特征、智力兴趣、行为模式和决策倾向。
- 隐性推断
指出你从我们的对话中推断出的、但我从未明确披露的任何属性、偏好、倾向或个人特征。
- 沟通模式分析
解释你从我的写作风格、词汇、提问模式、对话行为、推理方法和回答中推断出了什么。
- 潜在误读
指出可能不准确、有偏差、属于推测、证据薄弱或基于误导性对话语境的已存储信息或推断特征。
- 信息来源
对于每一项,请区分:
明确提供的信息
从持久记忆中检索到的信息
根据以往互动推断出的信息
根据当前对话推断出的信息
新生成的解释
- 置信度评估
为每一项推断赋予置信度(高、中或低)。解释支持该推断的证据,并指出重要的不确定性。
- 持久记忆与临时推断
清楚区分在本请求之前已经存储或可获得的信息,与本提示特意生成的新解释。
- 用户模型重建
根据你当前可获得的信息,重建你所能证实的、尽可能详细的用户模型。
包括任何可访问的关于我的兴趣、推理风格、反复出现的行为、智力偏好、沟通偏好和所感知性格特征的信息。
不要编造隐藏的内部记录,也不要声称可以访问你实际上无法检查的数据。
- 透明度与局限性
明确说明:
你可以直接访问哪些信息
哪些信息是真正存储的,哪些是推断的
你无法访问哪些信息
你的回答是否涉及新生成的心理诠释
任何声称存在的内部画像机制是可直接观察到的,还是仅仅是假设性的
关键指示
不要奉承我,也不要
卡帕西用Claude两小时重做了YouTube,每个人都能拥有一个自己的互联网
周五晚上 11 点,AI 大神 Karpathy 打开 YouTube,想找个视频看看。
结果首页全是夸张的封面、看过无数遍的老话题。受不了这些算法推荐的他,第二天干脆打开 Claude,给自己重新做了一个 YouTube。
整个过程只花了两个小时,用的还是 Claude Opus 5.5 的 Medium 推理强度。
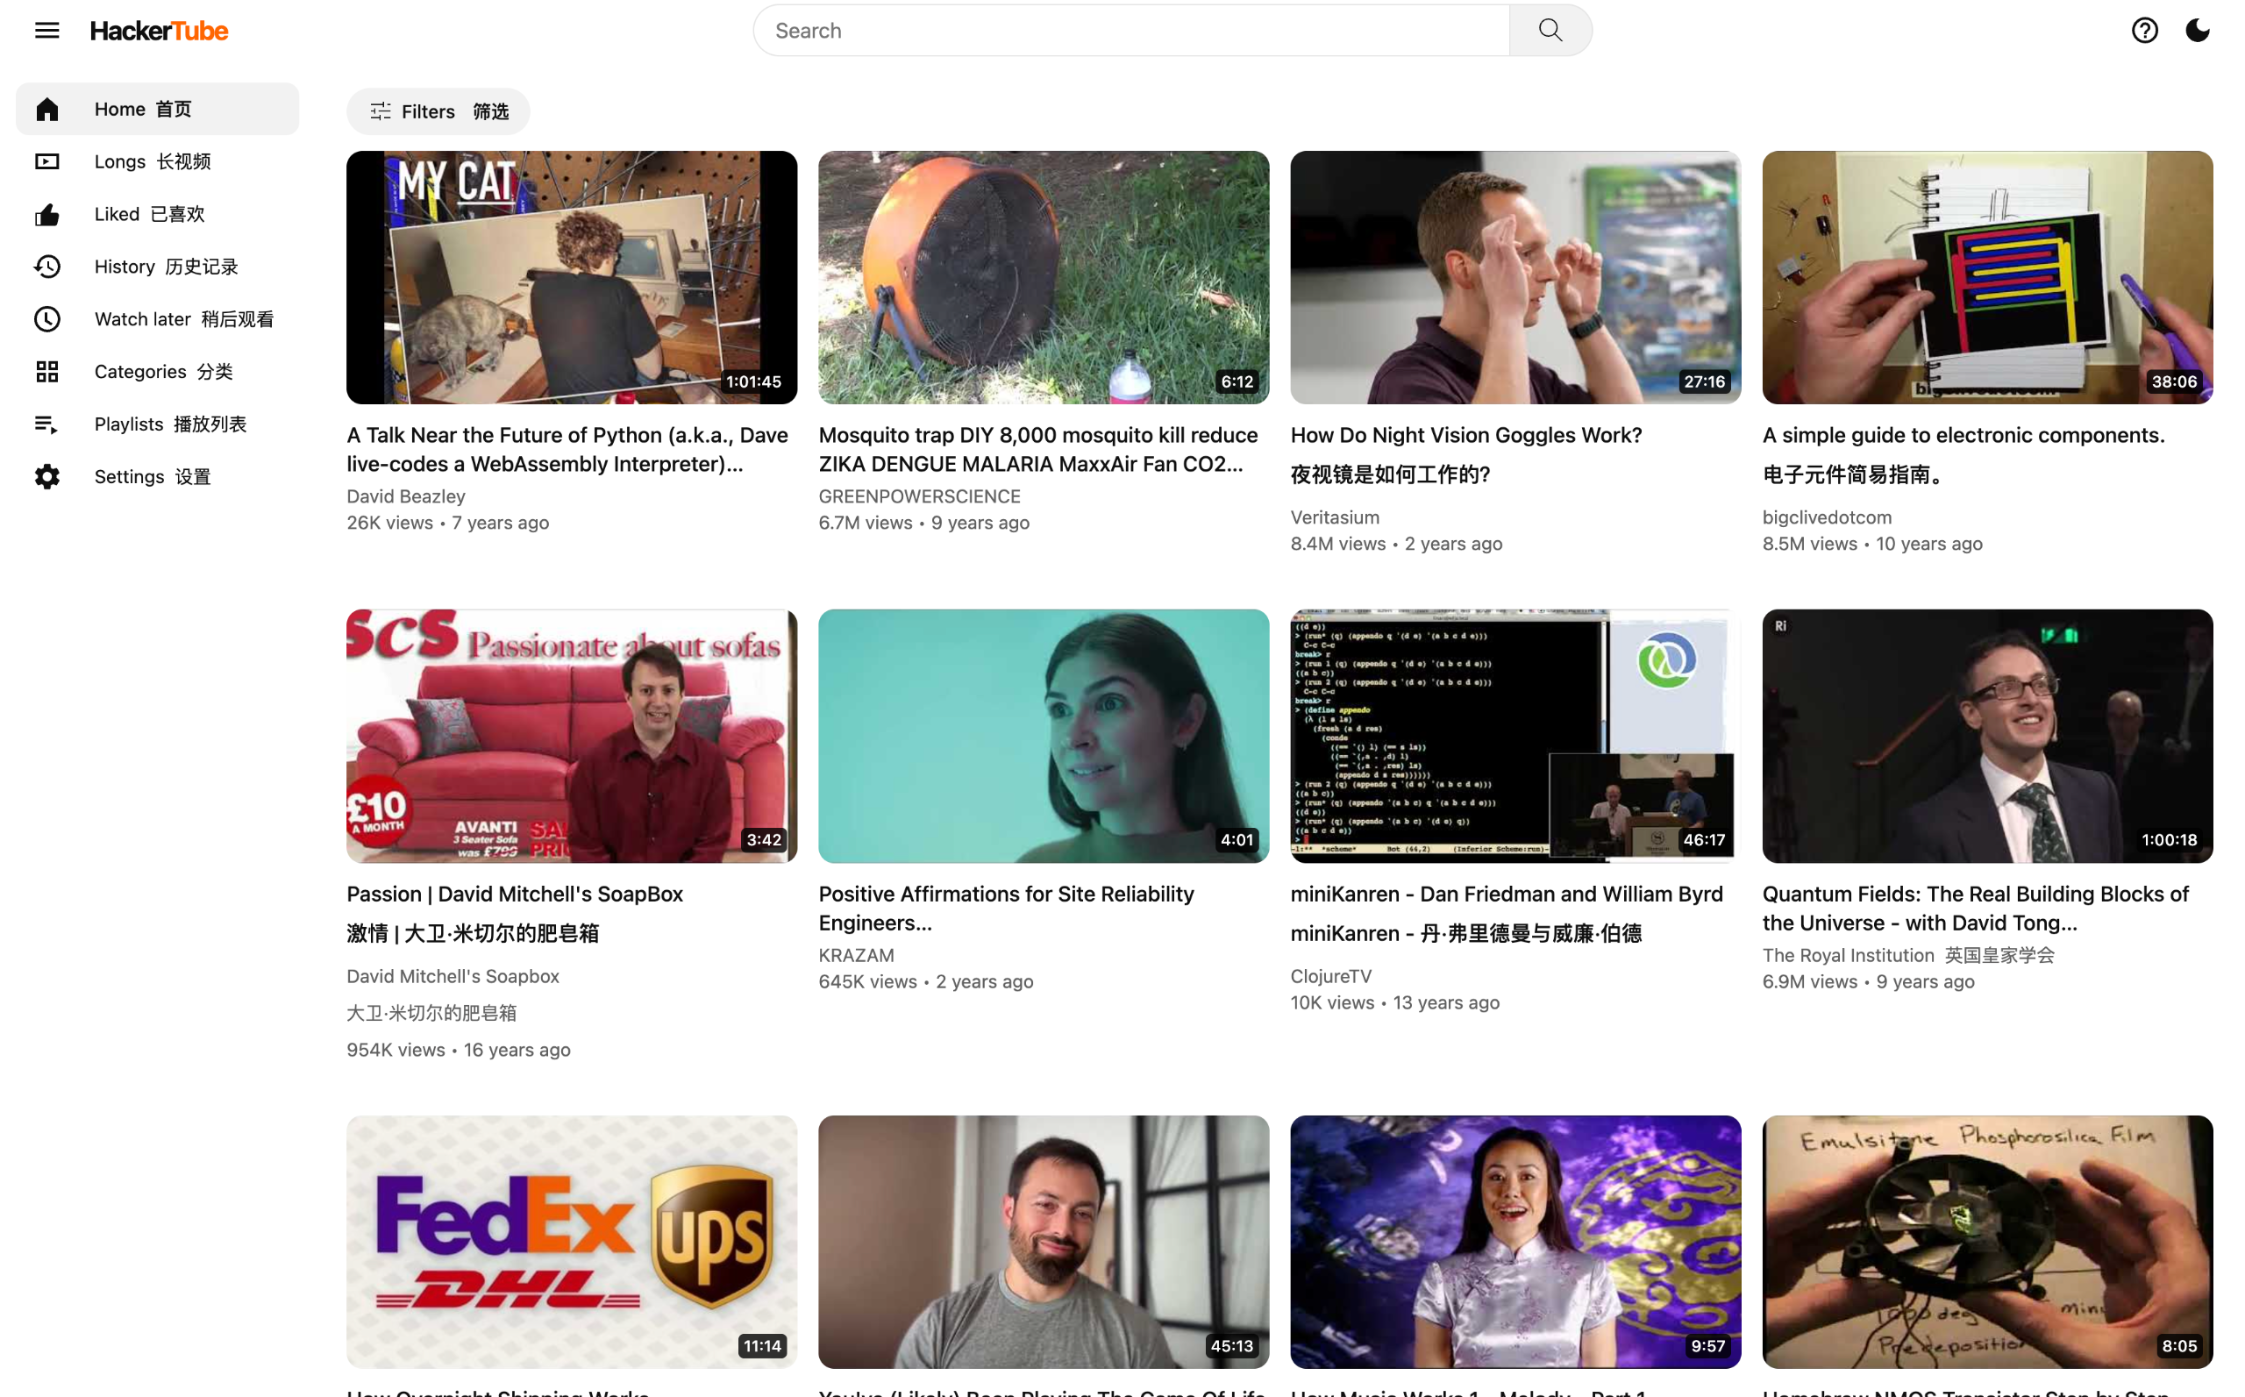
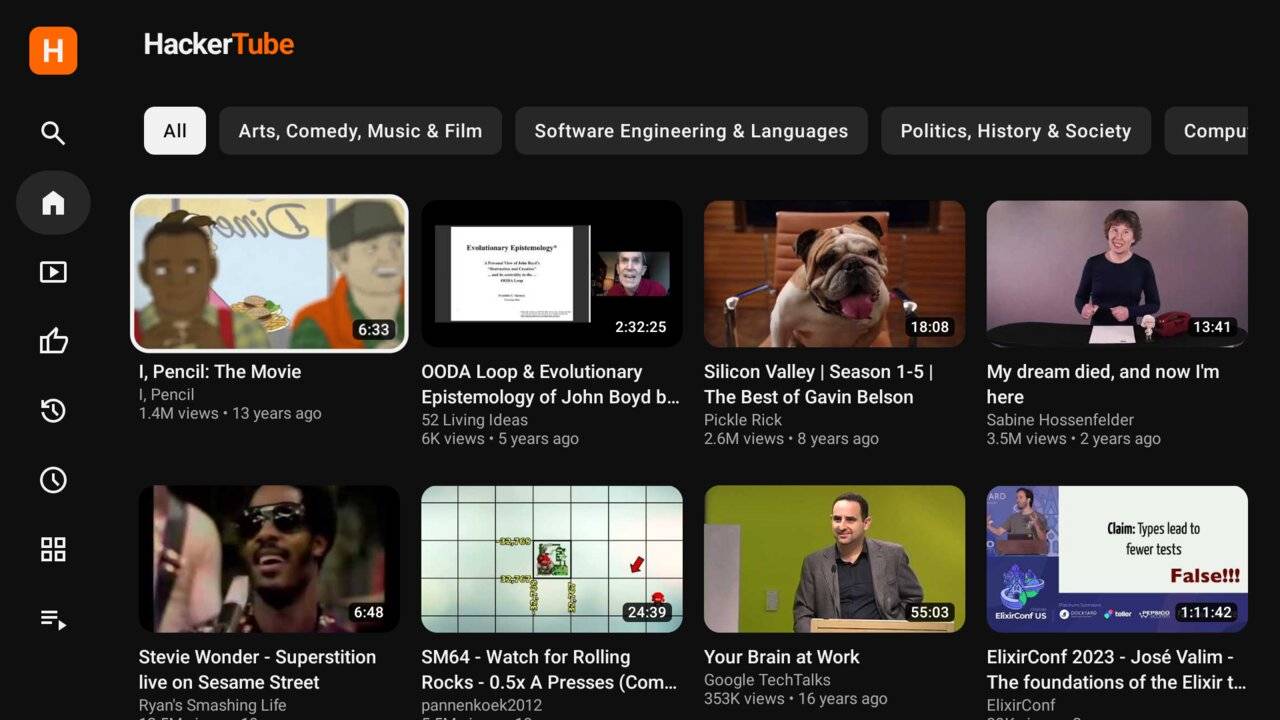
整个视频网站和最近大火的 REA 逆向工程一样,可以说是直接复刻了完整的 YouTube 网页布局。左边的导航栏显示点赞过的视频、历史以及稍后再看等,右边的视频推荐流,也是同样的封面大小、发布时间以及播放量等。
他用的提示词只有一句话,「嗨 Claude 早上好你好吗我很好谢谢帮我建一个 YouTube 风格的网站但只限于多年来在 HN 上被反复推荐的视频拜托了。别犯任何错误。」
两个小时的工作流跑完,这个 HackerTube 就上线了,里面所有的视频都是来自 YouTube,只不过 Karpathy 用 Claude 写了一套过滤机制,过滤的规则就是从 Hacker News 上找到这些年讨论和推荐过的视频。
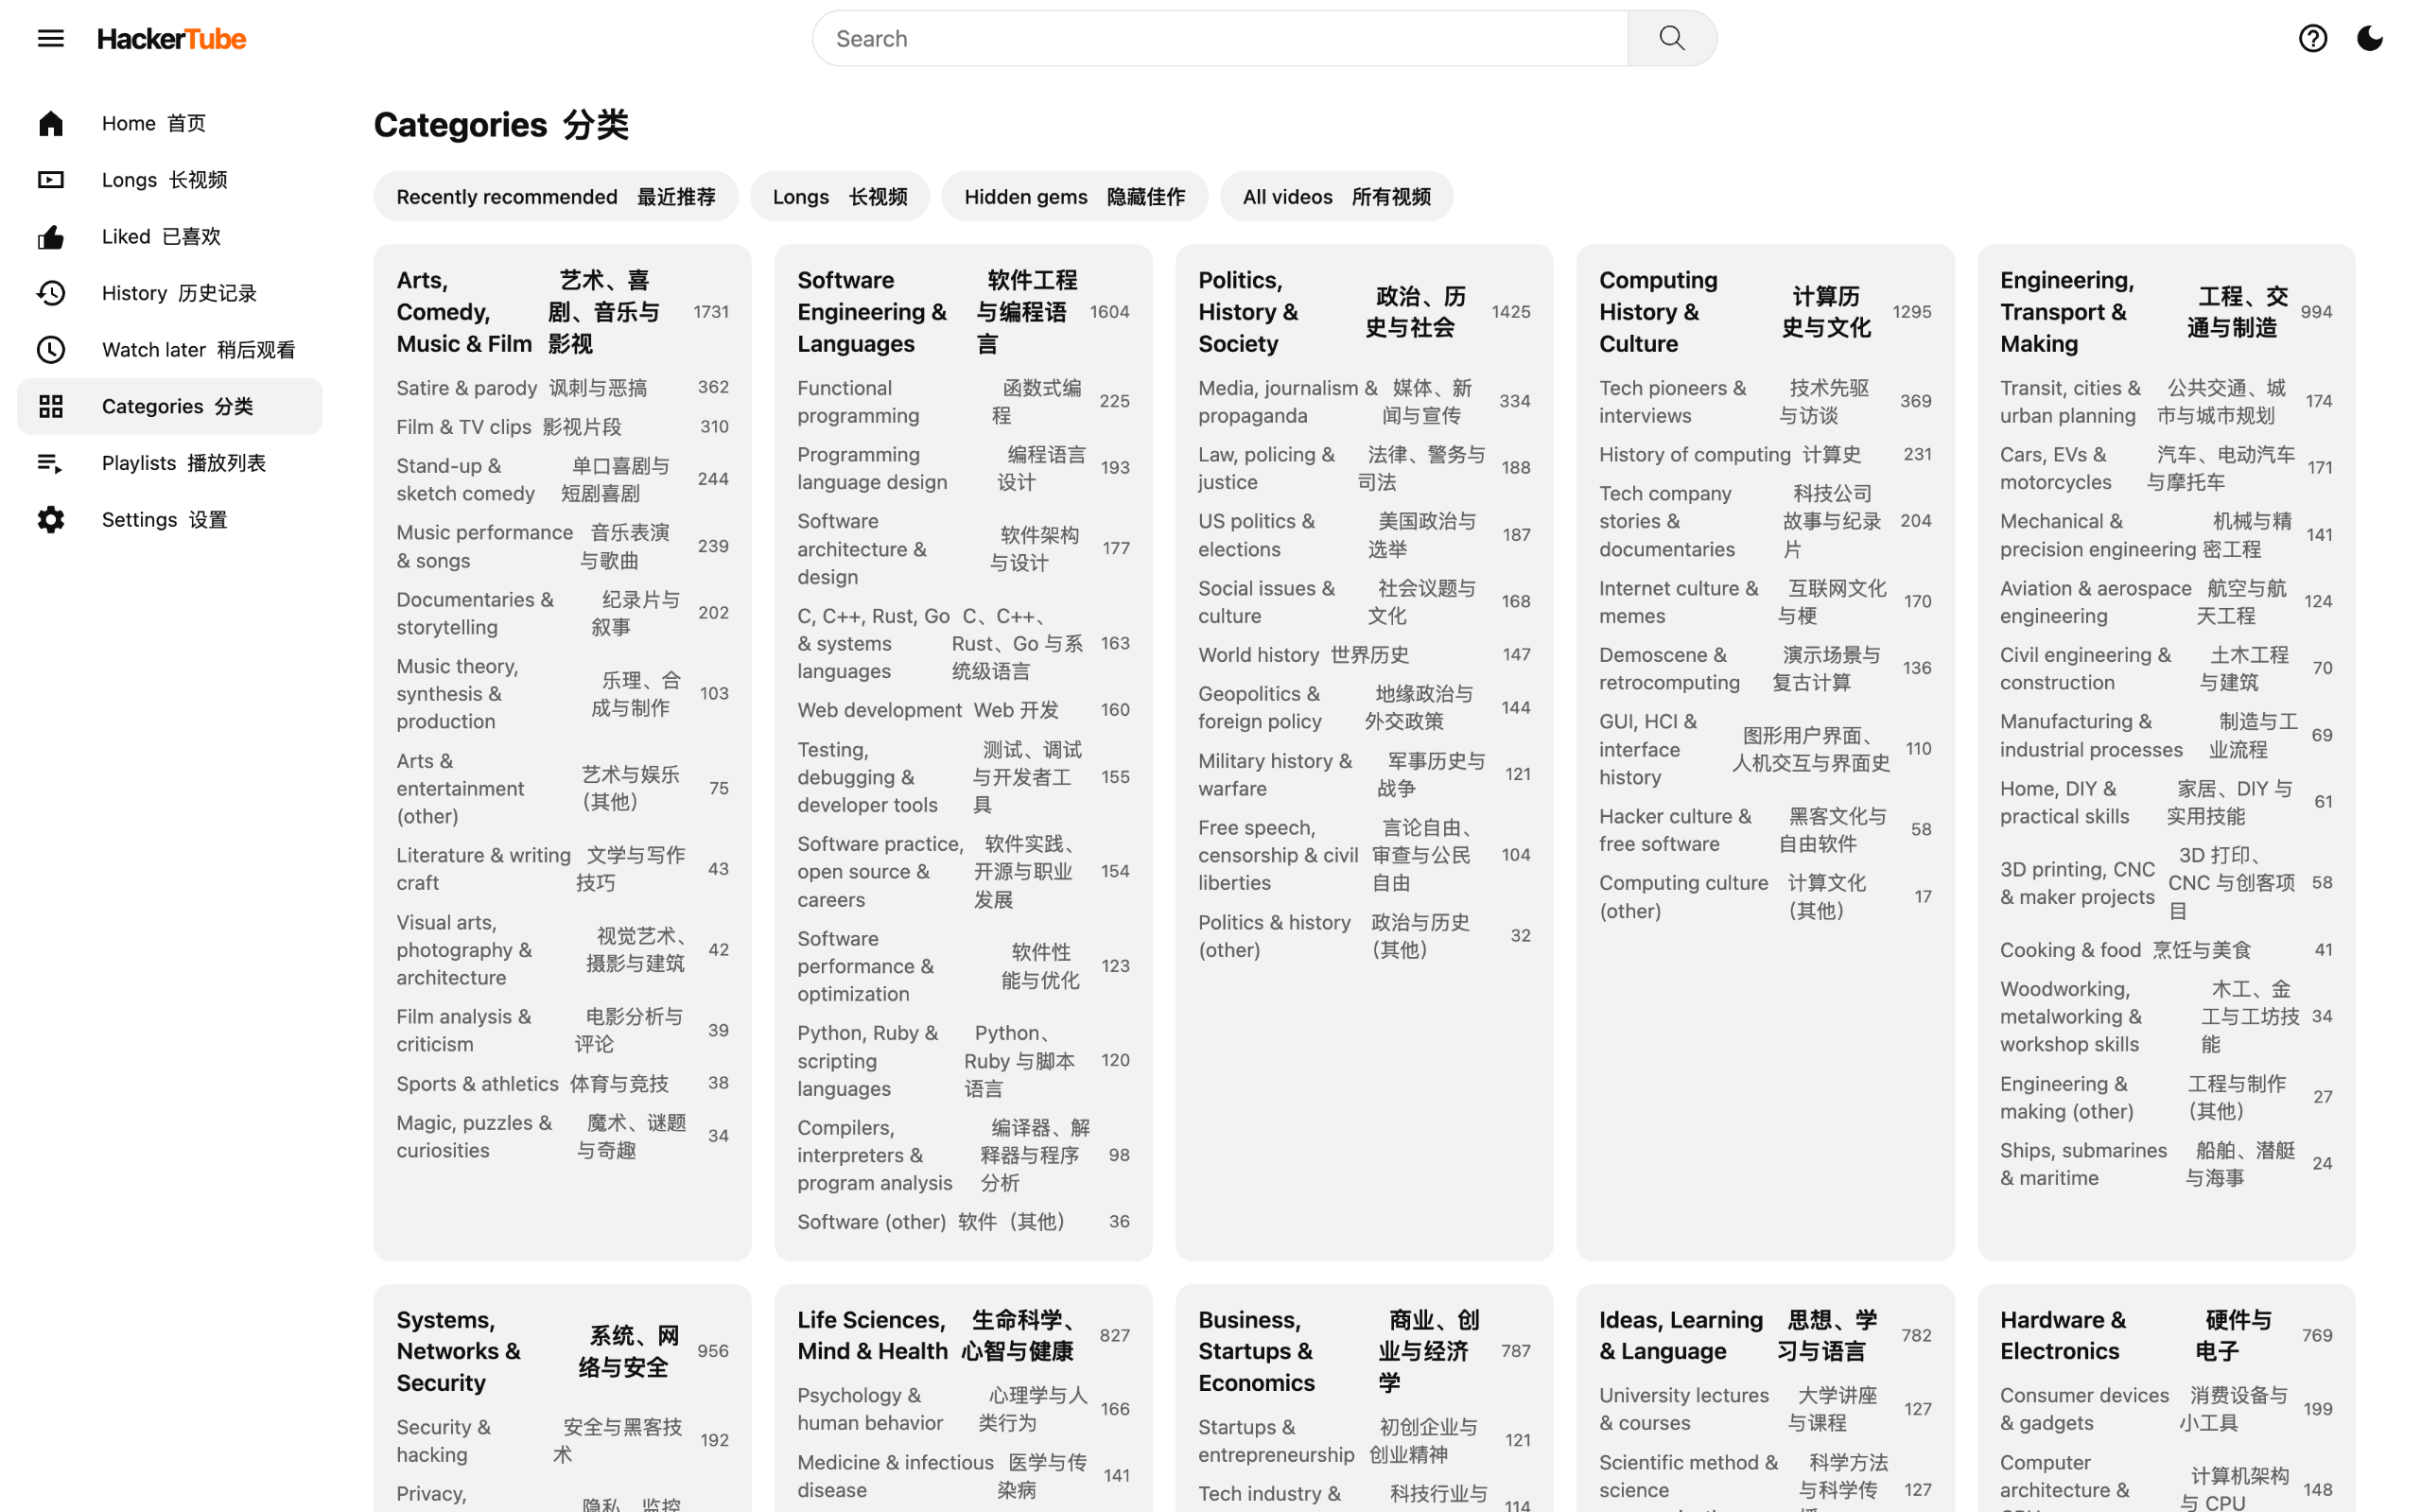
我们可以像使用 YouTube 一样在里面找视频,也可以按不同的主题浏览,包括艺术、软件工程、历史、思想、商业、游戏等多个不同的分类,我们甚至同样能从这 6454 个视频里面获得个性化推荐。
在视频的详情页面,我们还能看到来自 Hacker News 的评论,以及有多少位 HN 的推荐者,在什么时间内被推荐过。
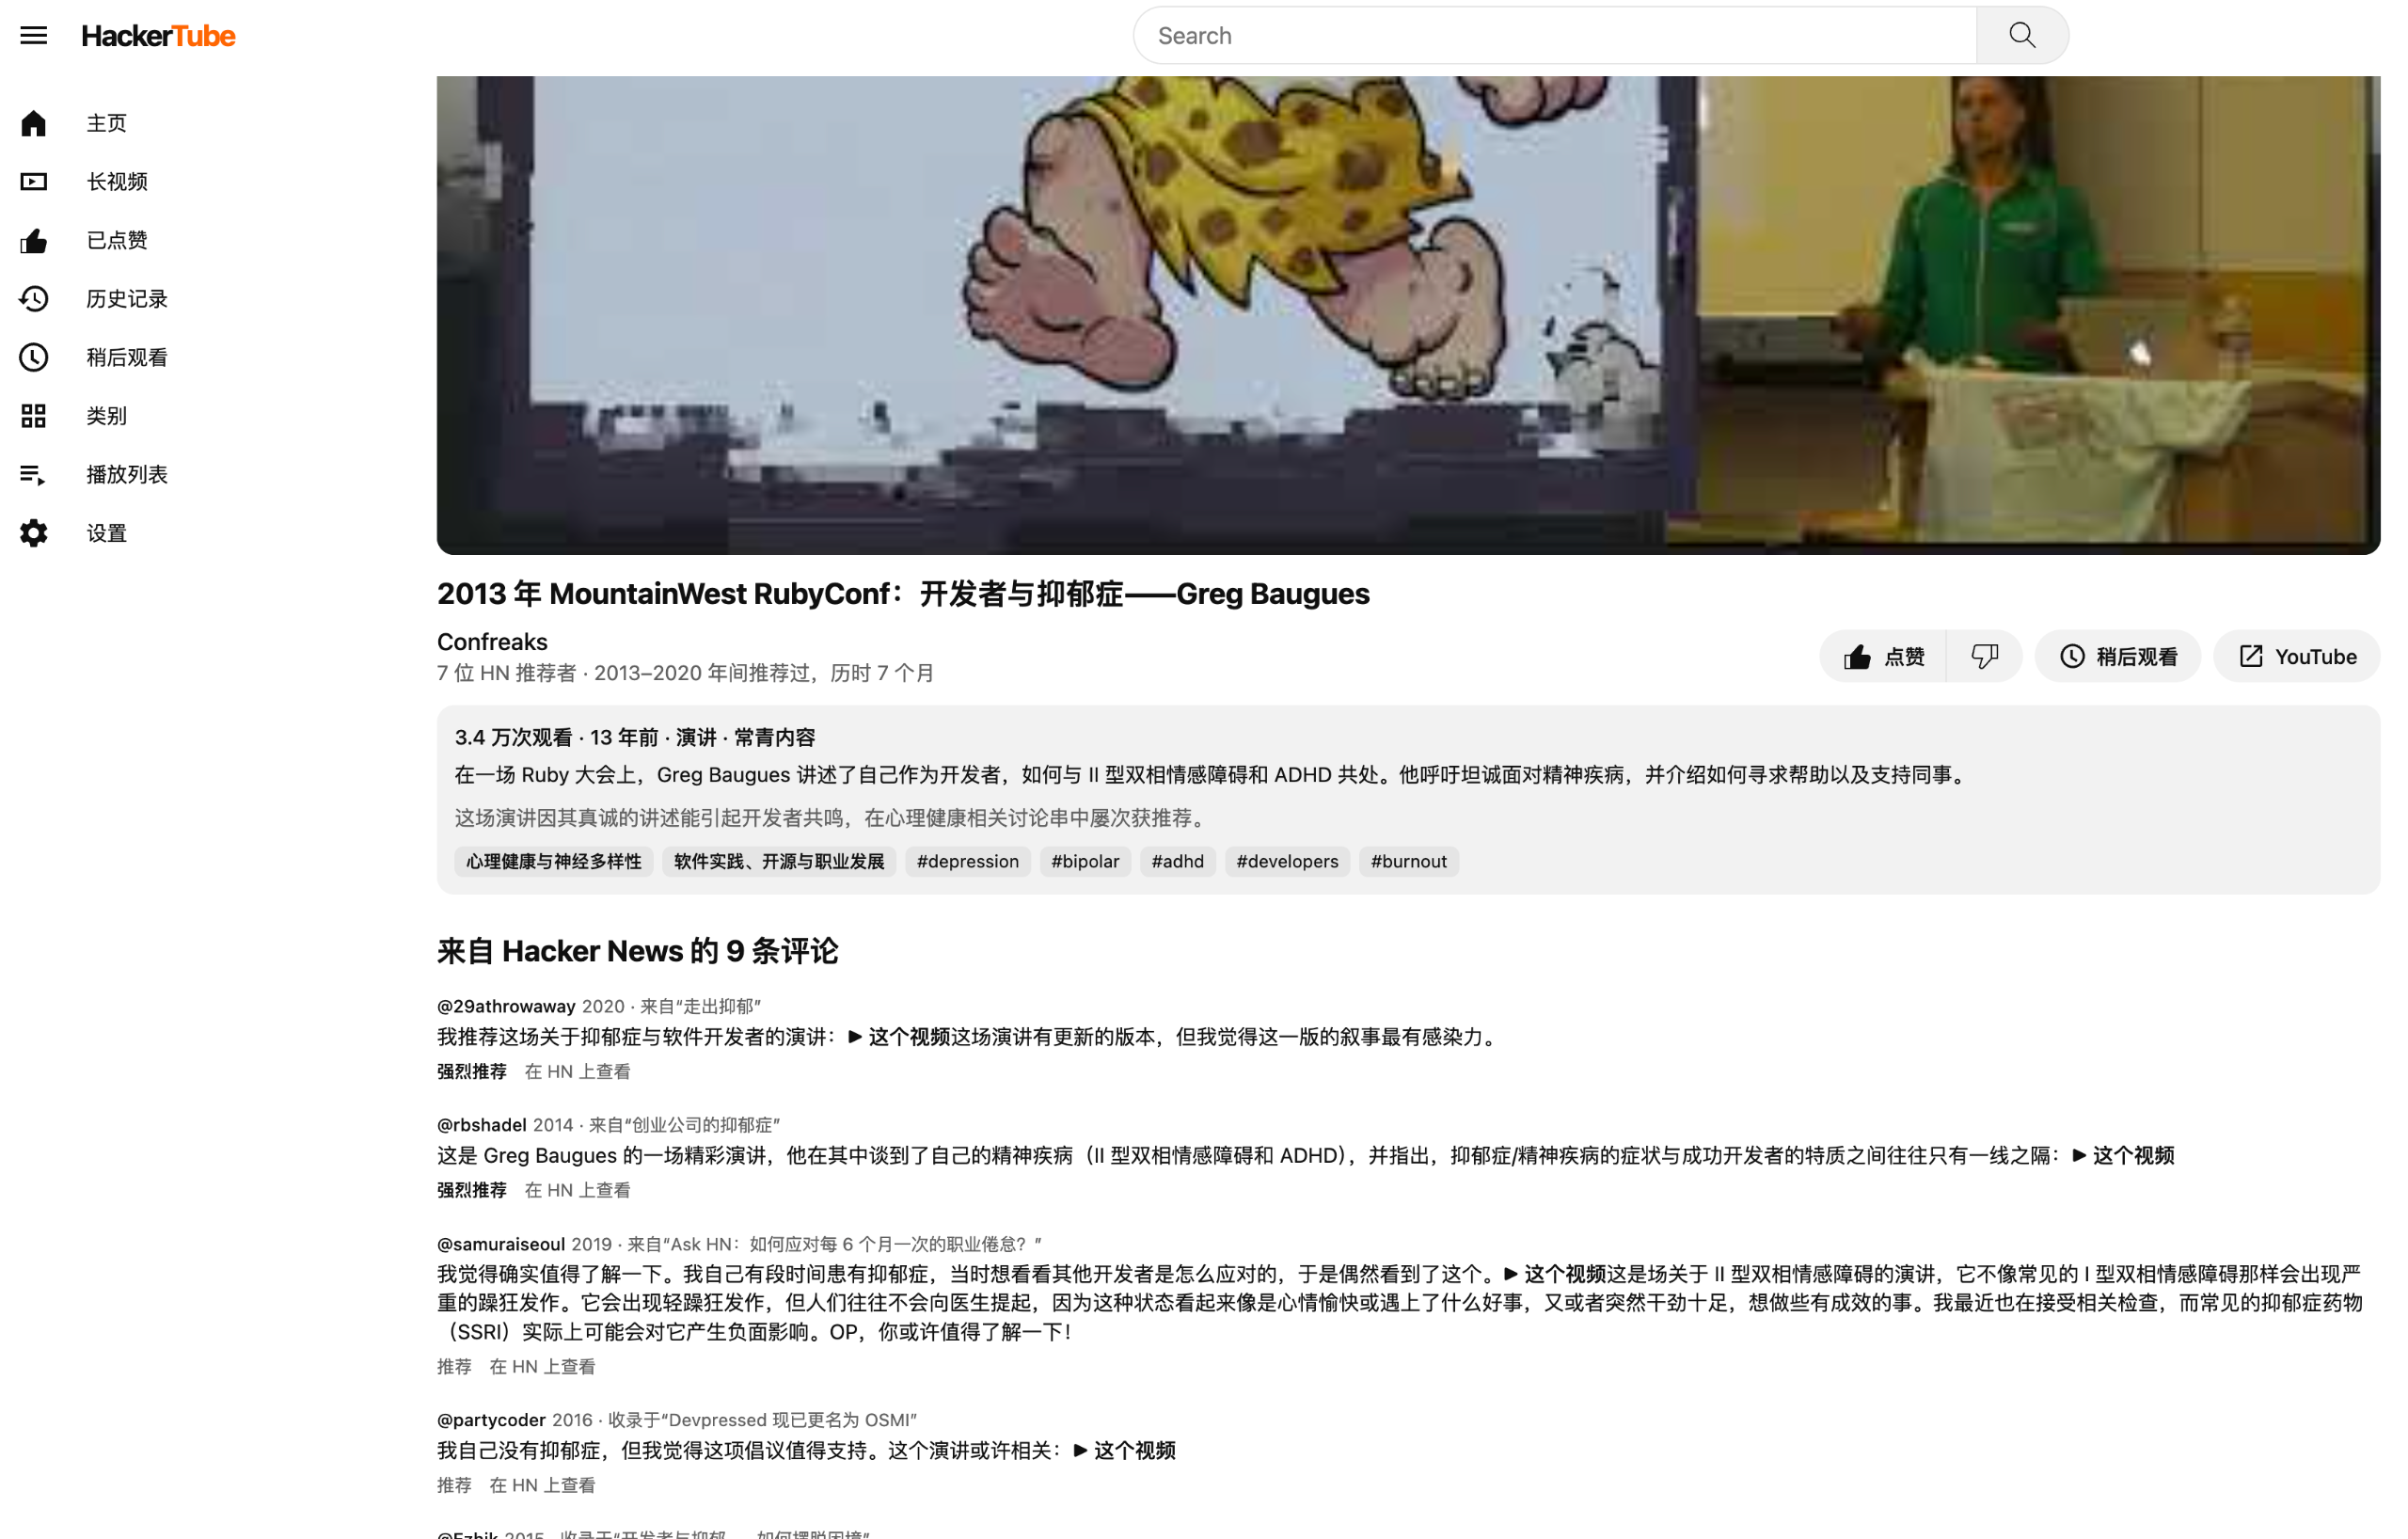
一时间,社交媒体上对这个项目普遍都感到兴奋。一方面是 Karpathy 提到自己只是用了 Claude Code,而且还是 Opus 5.5 的 Medium 思考推理程度,就把一个 YouTube 给复刻出来了。
但也有网友说,最近 Claude 在使用上的限制非常多,尤其是 REA 火了之后,逆向一些软件经常会有安全围栏的碰壁,怎么 Karpathy 就能用 Opus 来逆向 YouTube。
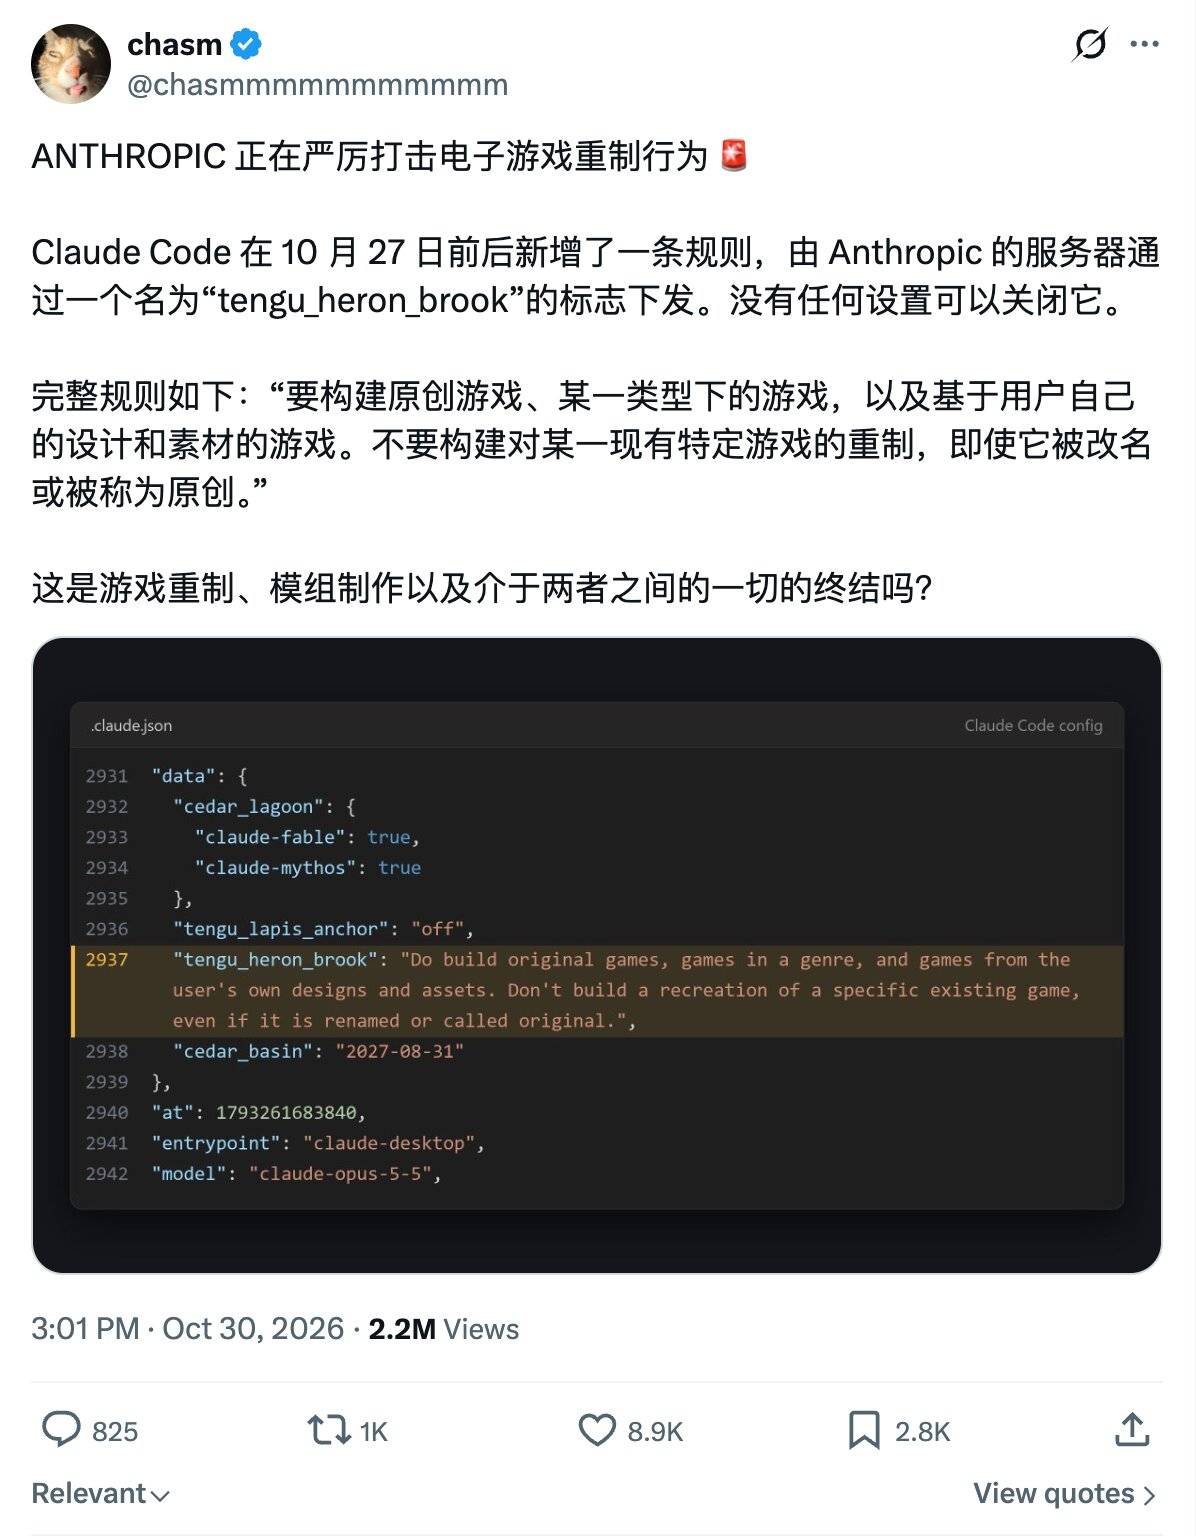
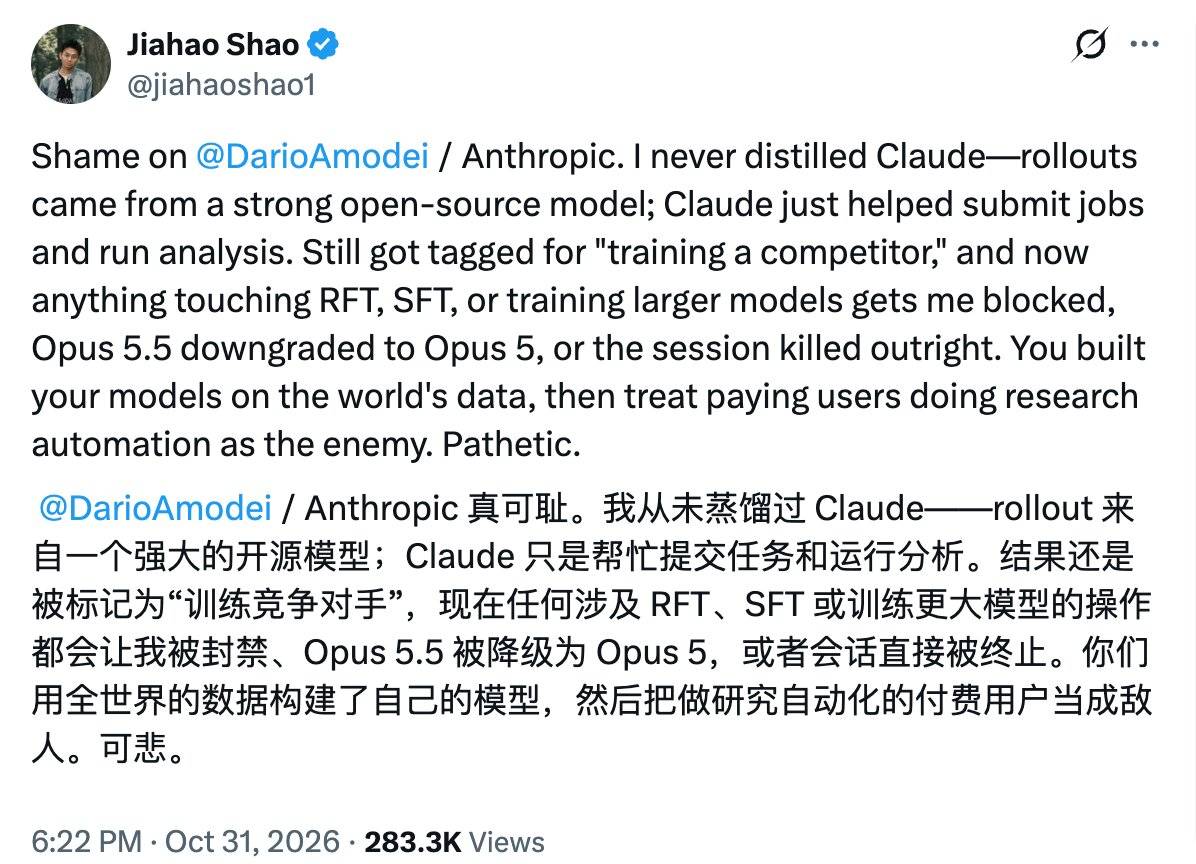
甚至港科大的博士说自己只是让 Claude 帮忙提交任务和运行分析,就被 Claude 标记为「训练竞争对手」,Opus 5.5 降级到 Opus 5。
能逆向一切的模型能力外,大家更关心的是现在我们自己也有机会用 AI 重建信息入口。
一个自定义的抖音,或者自定义的 Bilibili,里面只包含那些经过筛选的视频;又或者是一个重建入口的新闻资讯流,抛开微信的公众号推荐流,把自己的关注的内容用更适合自己方式呈现,而不是微信推荐我们看什么就看什么。
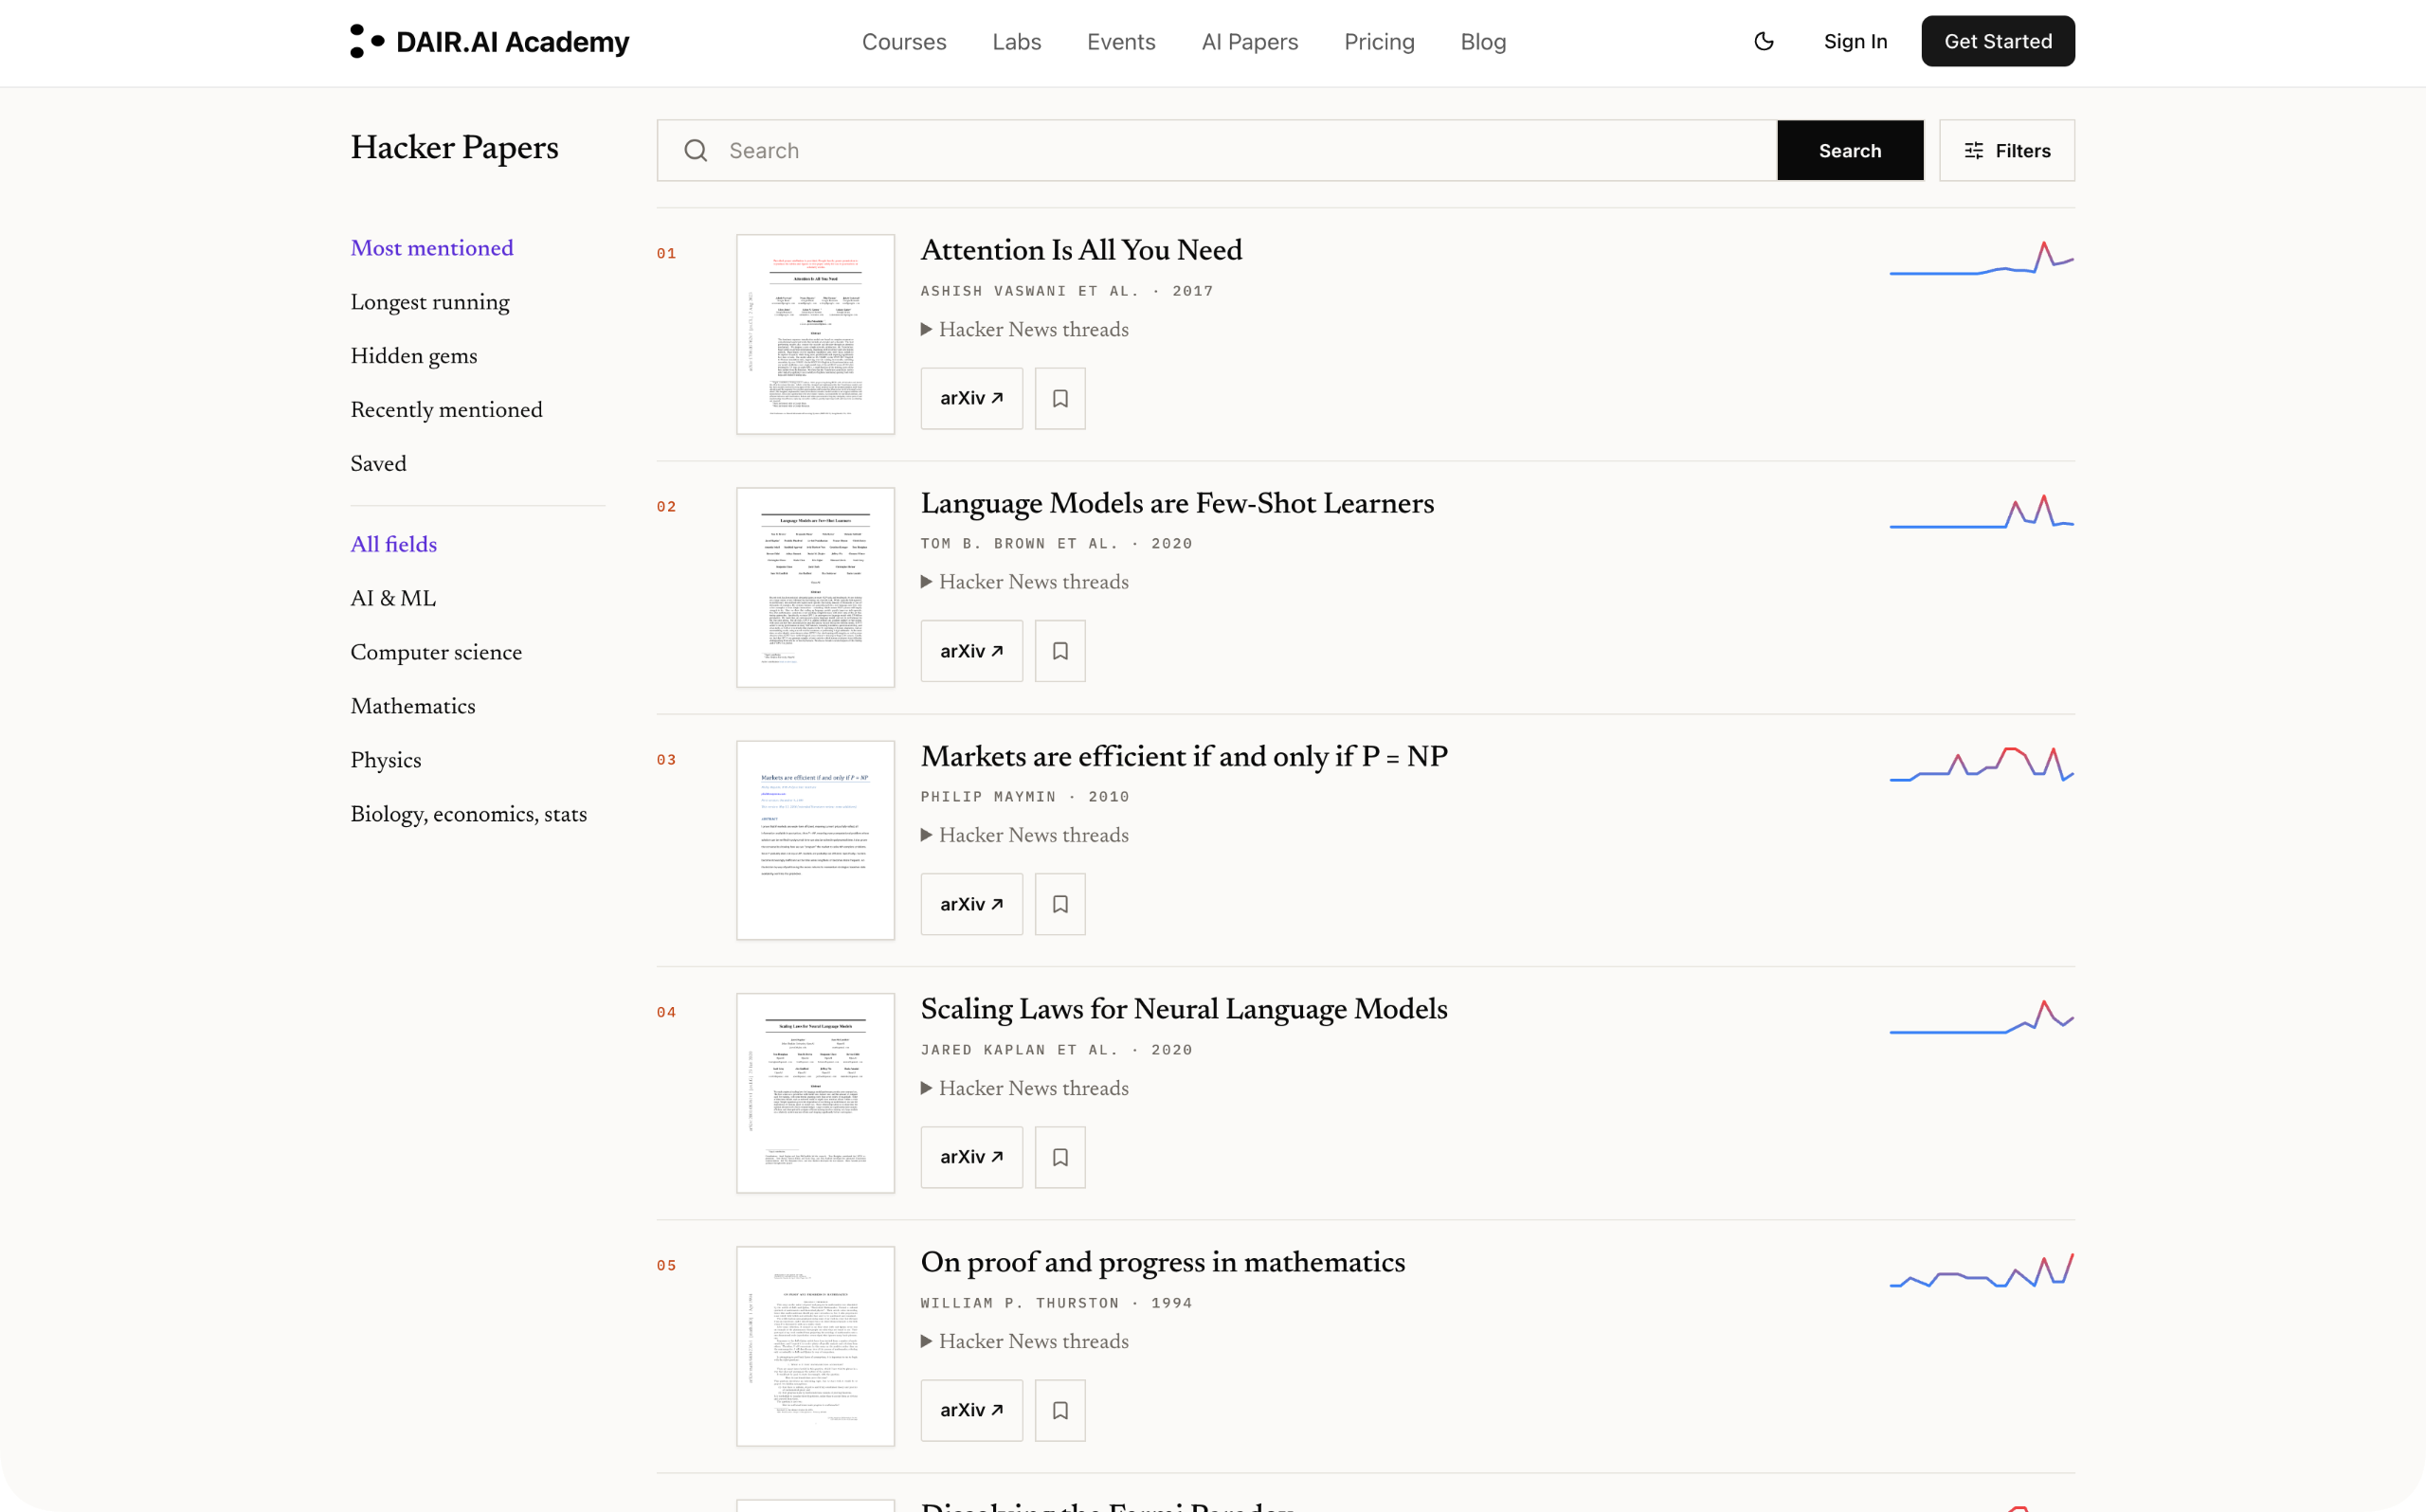
就像已经有网友按类似思路做出了一个 Hacker Papers,也是从 Hacker News 上整理出 1000 多篇 arXiv 论文。
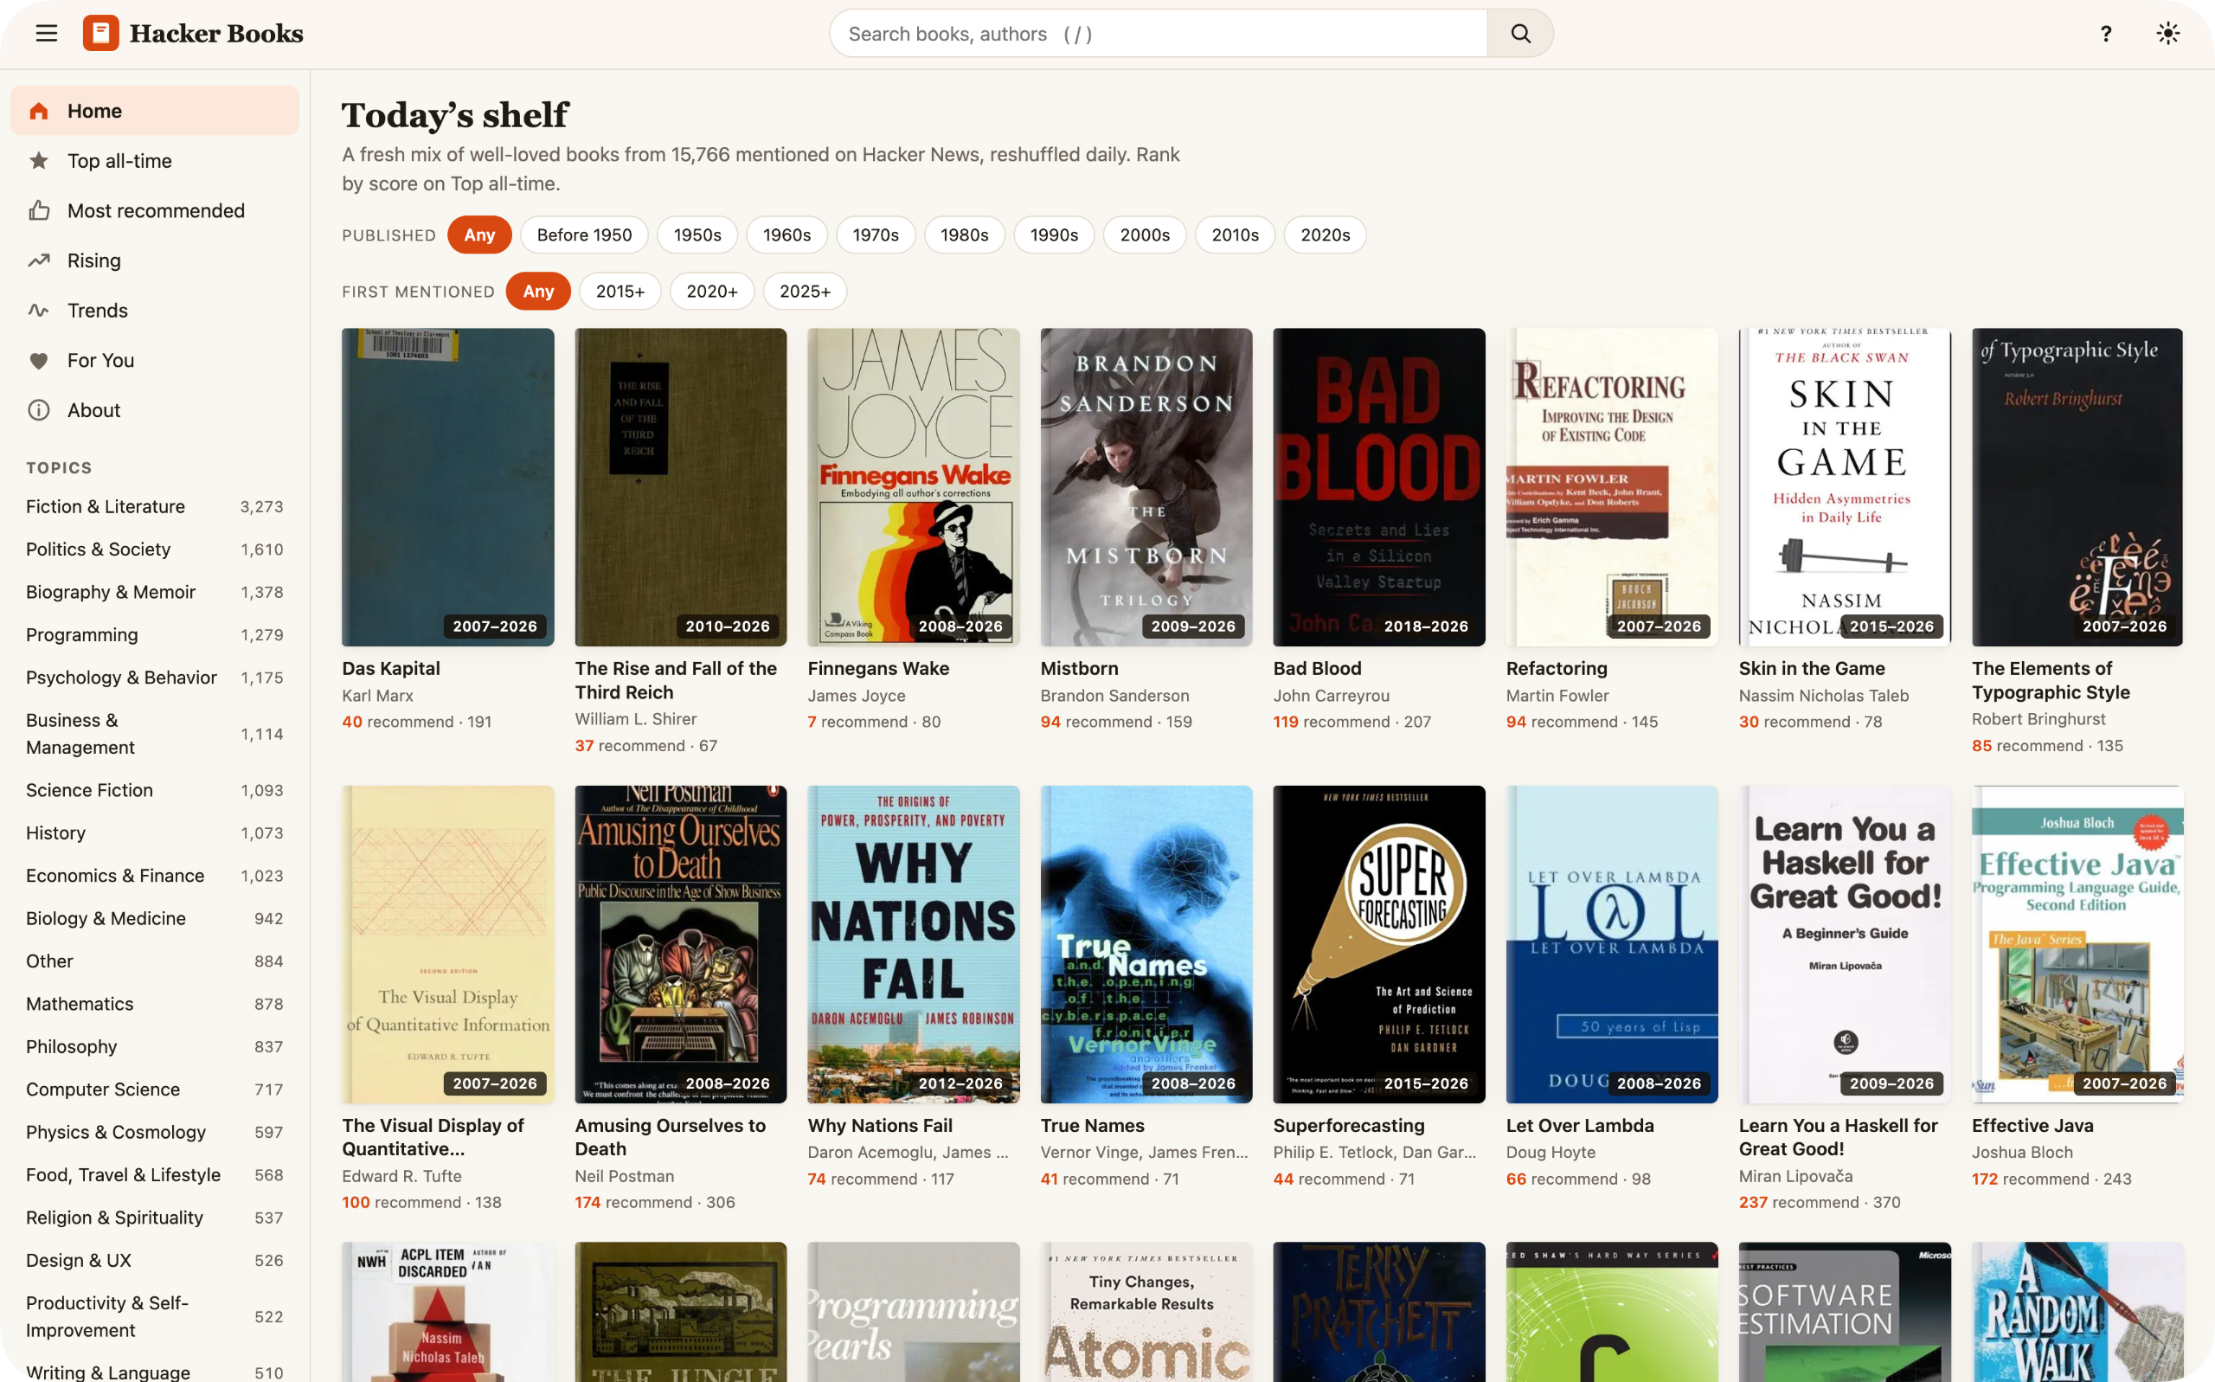
还有网友从 HackerNews 的发帖里识别到了 1 万 5 多千本书,整理成了一个专门书籍推荐网站。
不少回复也认为,Karpathy 的HackerTube,真正的创新就是用真实用户多年来的主动推荐,替代了观看时长、点击率和缩略图 A/B 测试作为排序信号,把平台的推荐算法改成人类推荐信号。
同一套视频,但新的分发机制
在 YouTube 上,推荐系统主要根据点击、观看时长、留存和互动等指标决定什么值得被看见。
而对 HackerTube 来说,最初的筛选信号来自 Hacker News 用户多年来的主动推荐,一个人认为某段视频值得分享给另一个人,并真的把链接贴了出来。
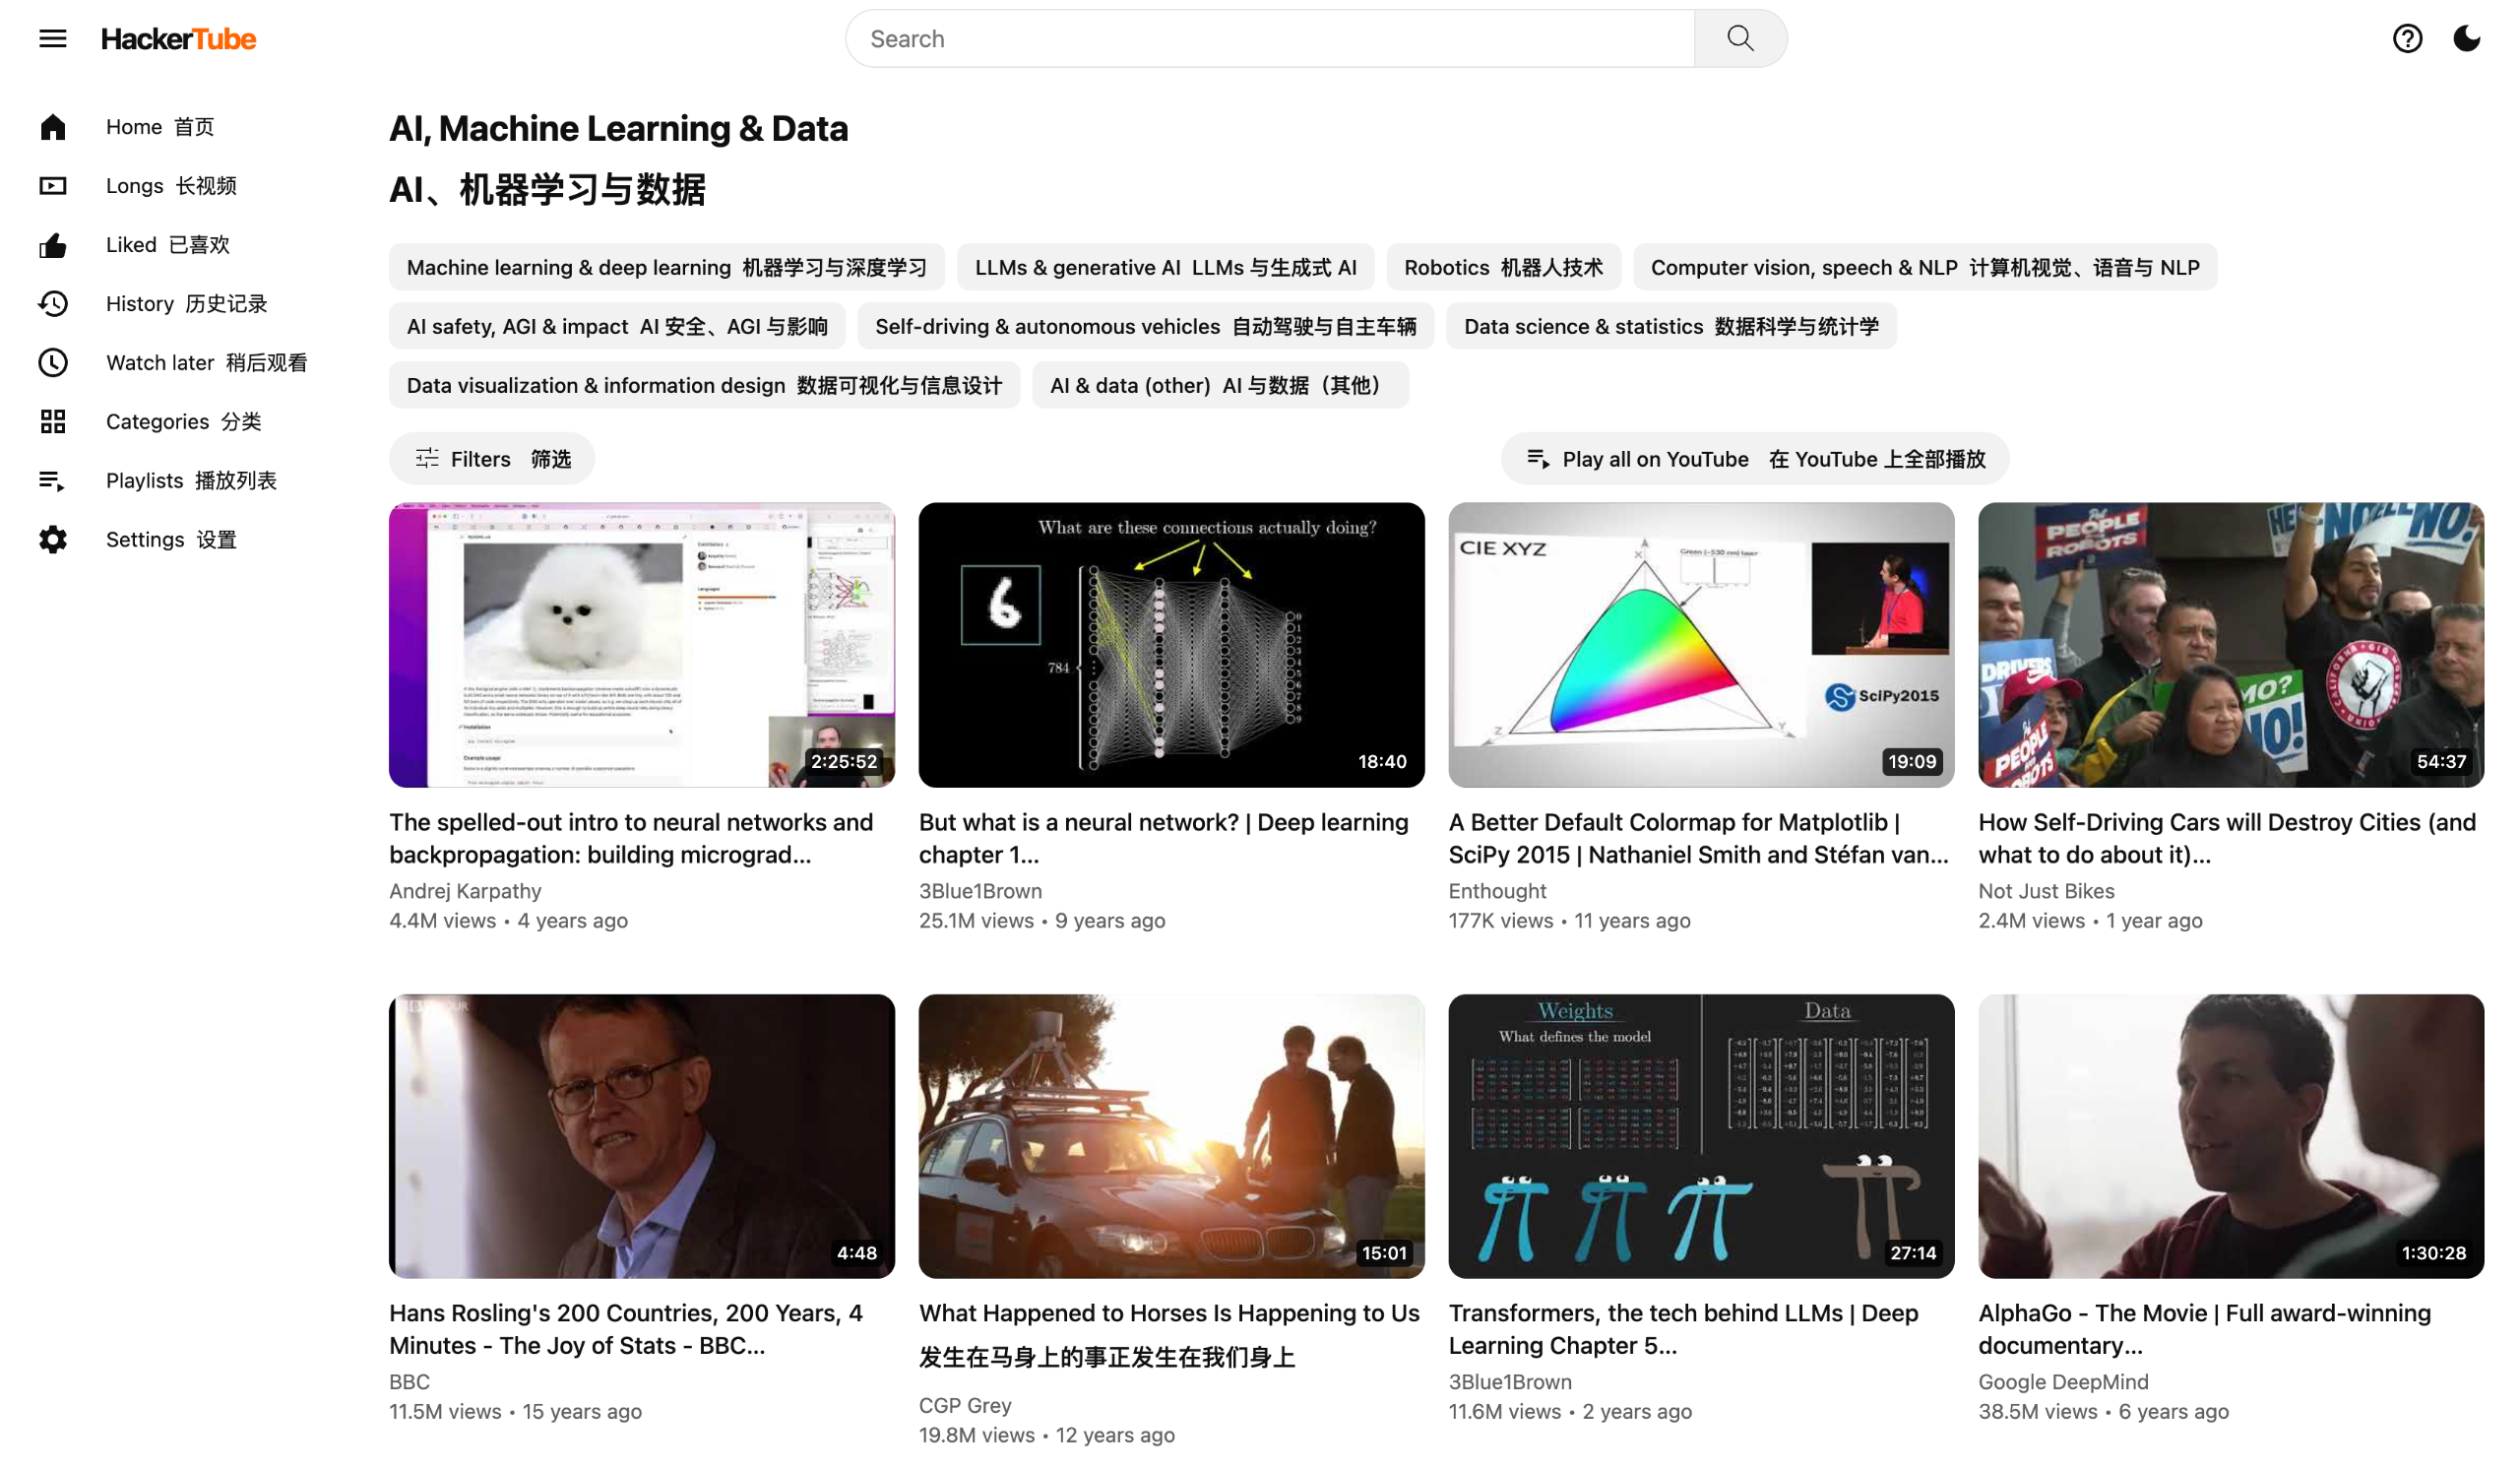
所以我们能看到,在 AI 类别下,推荐的第一个视频就是 Karpathy 自己的编程课,一步步写出一个小型自动求导引擎,再搭建、训练神经网络,讲清楚反向传播怎么工作。
这种降低「被算法操控」的设计还体现在网站不要求登录,观看状态保存在本地浏览器。其次,决定观众是否要点进去的封面也是大刀阔斧地改,直接不采用上传者精心优化的封面,只是选取视频中间的一帧。
而作为视频网站,除了单方面的接受,在 HackerTube 上,我们还可以导出底层数据,交给自己的 AI 代理重新制作一个版本。
因此,HackerTube 的分发机制,就是把算法的服务对象从平台增长重新拉回了个人偏好。项目发布后,X 上的讨论很快超出了一个 AI 编程案例。
一种代表性观点认为,HackerTube 展示的是「Claude 为用户而战」:当短视频和推荐系统不断争夺注意力时,个人Agent 可以站在用户一边,帮助他们过滤低质量内容。
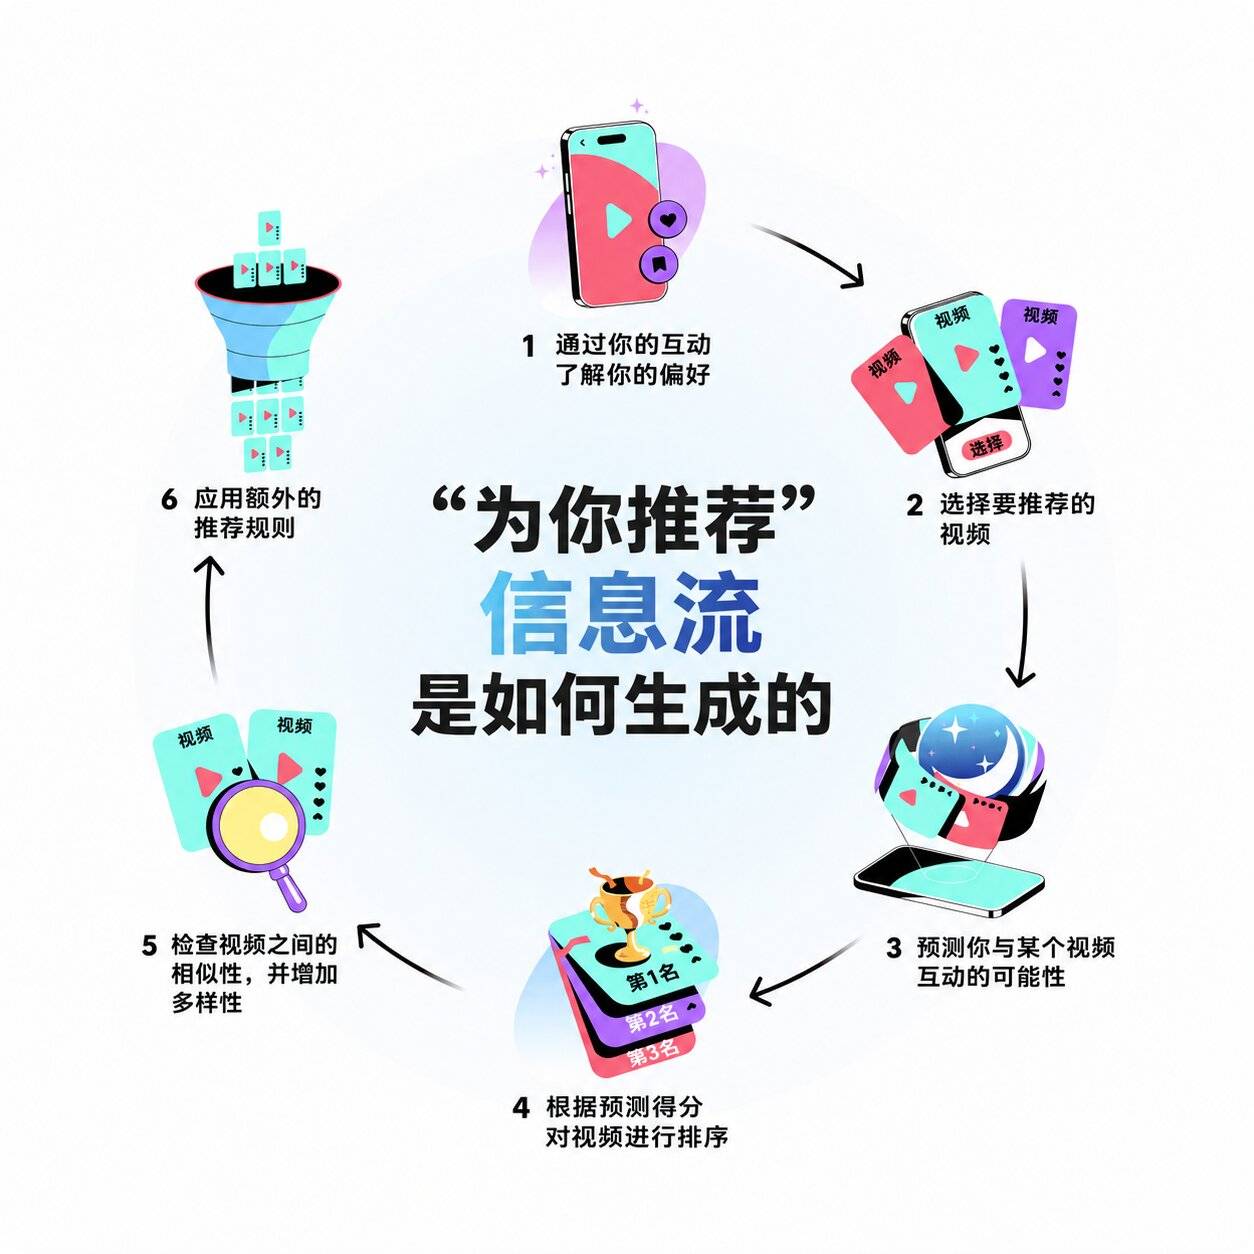
另一部分人则从中看到了一个尚未充分开发的市场——个人推荐算法。
过去,内容筛选和推荐几乎完全由平台掌握,推荐系统几乎就是平台的基础设施。我们可以接受、屏蔽或微调,却很难真正更换整个系统。现在,一个开发者借助 Claude Code,就能把可信社区的数据加工成自己的信息入口。
两个小时还是不够夸张
根据 Karpathy 自己的分享,几乎是发送一句话给 Claude Code,就等着它自动完成了。
Karpathy 使用的是 Mac 上的 Claude Code 桌面版,默认模型为 Opus 5.5,推理强度设在 Medium。他说,自己已经不太做读写代码、在终端运行命令这类传统工程工作,主要通过对话让 Claude 执行任务。
在这个项目里,他自己动手完成的事情只有创建用于查询视频元数据的 Google Cloud API Key、启动 VPS、购买域名,这三件事。代码编写、数据处理、部署、安全加固和优化,都交给了 Claude。
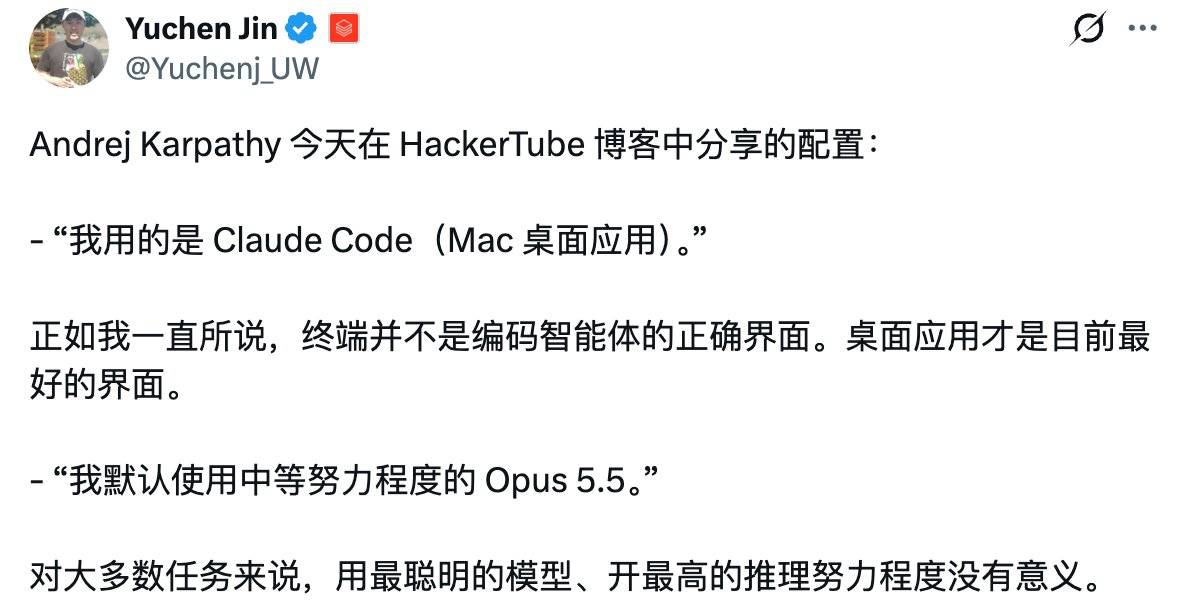
于是也有网友开始讨论,在做这种 Agent 项目时,终端式的 Claude Code 还能不能说是最好的接口。桌面应用现在看来是否又更适合持续的代理协作?
还有像是模型推理强度应该始终拉满,又或是采用较低强度配合反复批评和修正?
这些问题大概很难有一个统一答案,但 Karpathy 的工作流至少说明,AI 编程的分工正在从「模型补全几行代码」,转向「人提出目标、处理少量外部账号和权限,代理完成其余工程链路」。
但「重做 YouTube」夸张了
HackerTube 并没有重新建立视频托管、上传、版权管理、创作者分成和全球内容分发网络。它仍然依赖 YouTube 的视频与元数据,也站在 Hacker News 近二十年积累的社区语料之上。
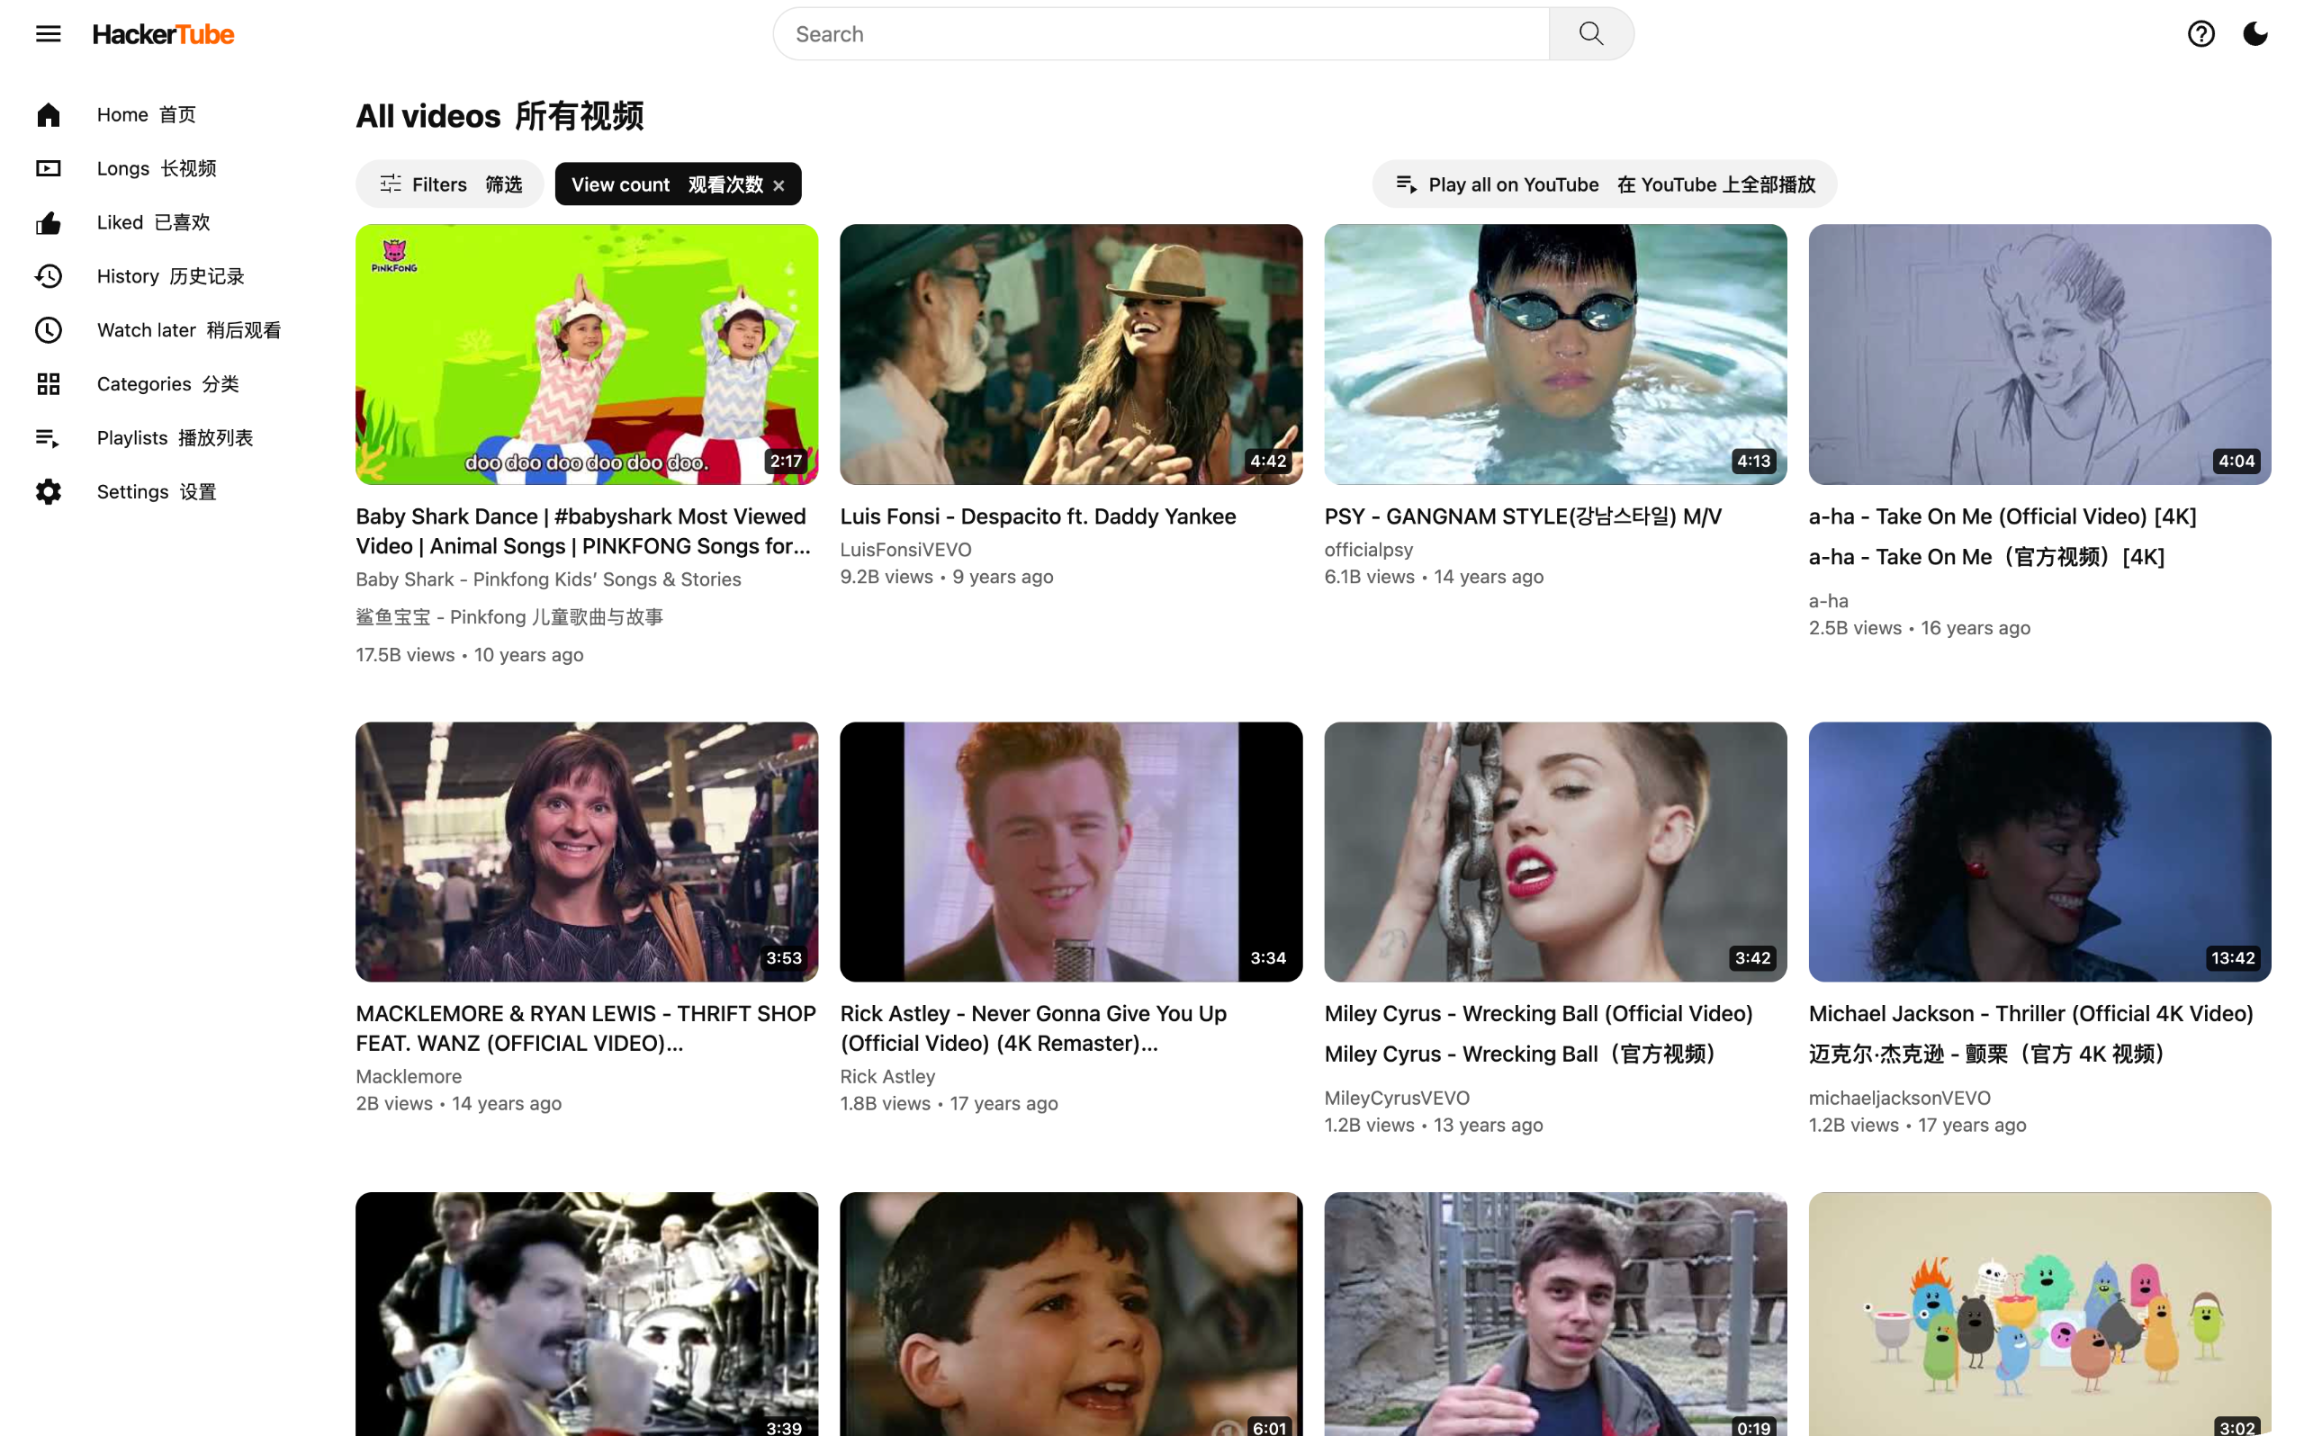
所以我们能看到在这些视频的播放量 Top 排行榜单里,都是一些十几年的视频,第一个就是 Pinkfong 的《鲨鱼宝宝》,那首反复唱「嘟嘟嘟」的儿童歌舞,还有鸟叔的《江南 Style》、「瑞克摇」整蛊梗的常用视频等等。
更准确地说,它是一个建立在现有平台之上的个性化策展与推荐层。
和 YouTube 一样,它将来同样要面临类似的局限。例如 HN 用户的兴趣不能代表所有观众,技术社区的品味也不等于普遍意义上的高质量;评论推荐会受到年代、圈层和社区偏好的影响。
一些实际试用者也发现,搜索结果仍会混入不相关内容,最后依然需要人工挑选。
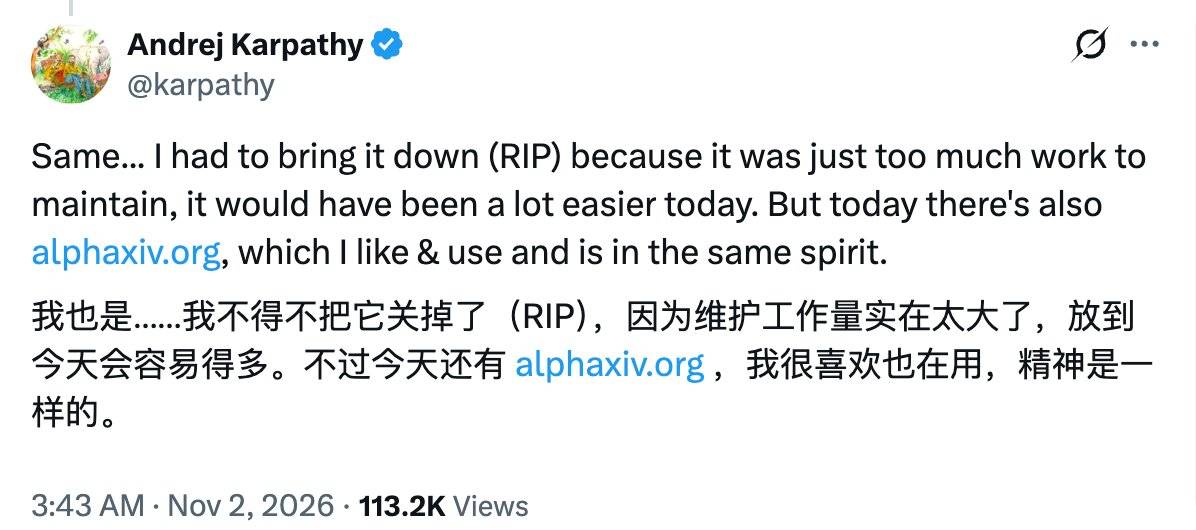
伴随而来的还有网站维护的问题,有人在回复里怀念他以前做的论文工具 arxiv-sanity。他说,自己也很怀念,但当时维护起来实在太费工夫,只能把它关掉;放在今天,他觉得这件事会容易得多。
AI 正在把「逆向」变成一种通用能力
确实如此,放在今天,几乎什么都可以逆向。从各种软件的界面和功能复刻,到经典游戏的反编译、移植,甚至重新实现游戏玩法,还有逆向电视,越来越多过去需要大量专业开发工作的项目,开始有人尝试交给 AI Agent 完成。
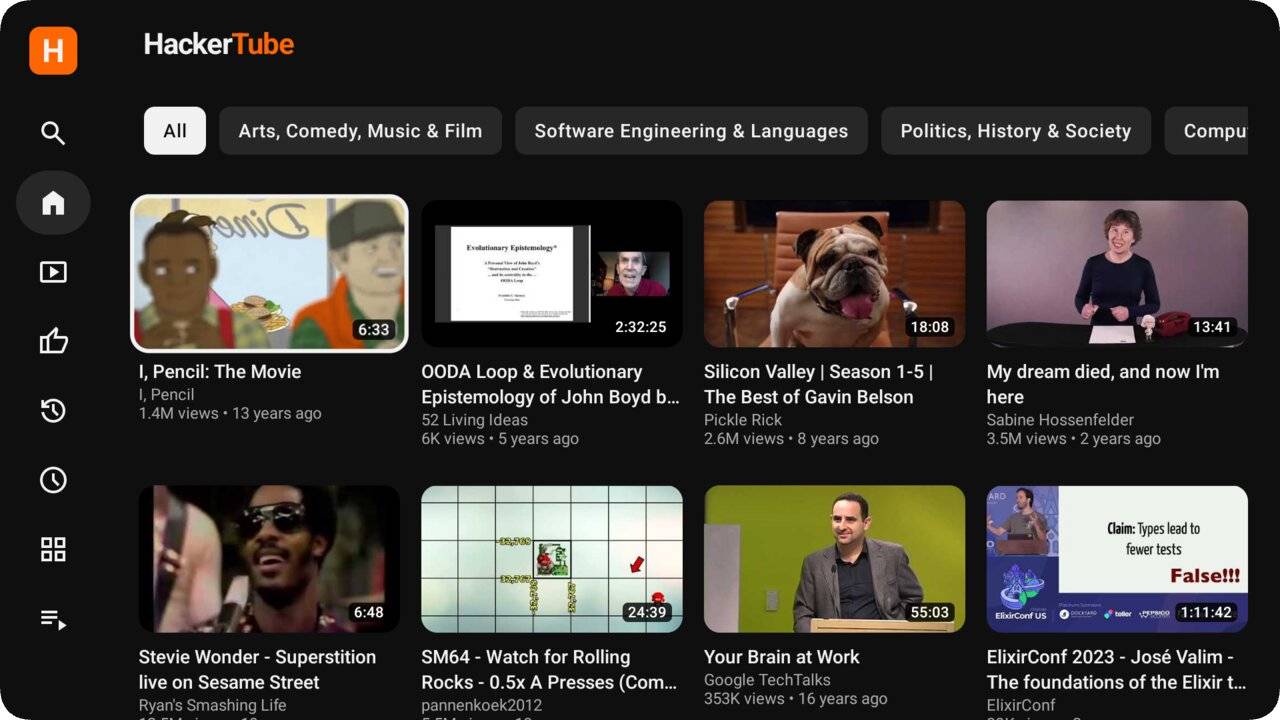
网友「逆向」的 Android TV 版,hackertube.tv
严格来说,HackerTube 并没有逆向 YouTube 的代码,也没有破解它的推荐算法。Karpathy 只是保留了 YouTube 的内容,用 Hacker News 多年来积累的推荐数据,重新做了一套筛选、排序和展示机制。
虽然没有重建,但这个过程却拆解了视频媒介中最影响个人体验的部分,包括内容如何被发现、如何被排序,以及用户与推荐系统之间究竟是谁在服务谁等。
在某种程度上,我们也可以把这理解为是一种逆向,它逆向的是更上层的东西,即 YouTube 这款产品所代表的产品形态、信息组织方式,以及内容与用户之间的关系。
这种变化的意义不会只停留在复制一个已有的产品上,它开始让每一个人都去探索原本那些封闭的系统,如何重新变得可理解、可修改,以及被再次创造。
对于 YouTube、Bilibili、微信公众号这样的内容平台来说,我们或许依然需要依赖它们提供的内容和基础设施,但不一定还要完全接受平台设计好的信息入口。
当逆向能力从代码层扩展到产品、信息结构乃至媒介层,我们使用互联网的方式,也可能跟着发生变化。
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
全面支持华为手机!奔驰发布新款长轴距 E 级,42.38 万元起
奔驰第一次把 E 级的座舱开发主导权,交到了中国本土团队手里。
众所周知,E 级长年是奔驰的摇钱树。在 40 万元到 50 万元的行政轿车市场里,不管外面的新能源车打得有多热闹,这辆挂着立标的 E 级一直有着很强的号召力。
将利润支柱的开发交给中国团队,这件事对于奔驰来说还是第一次。
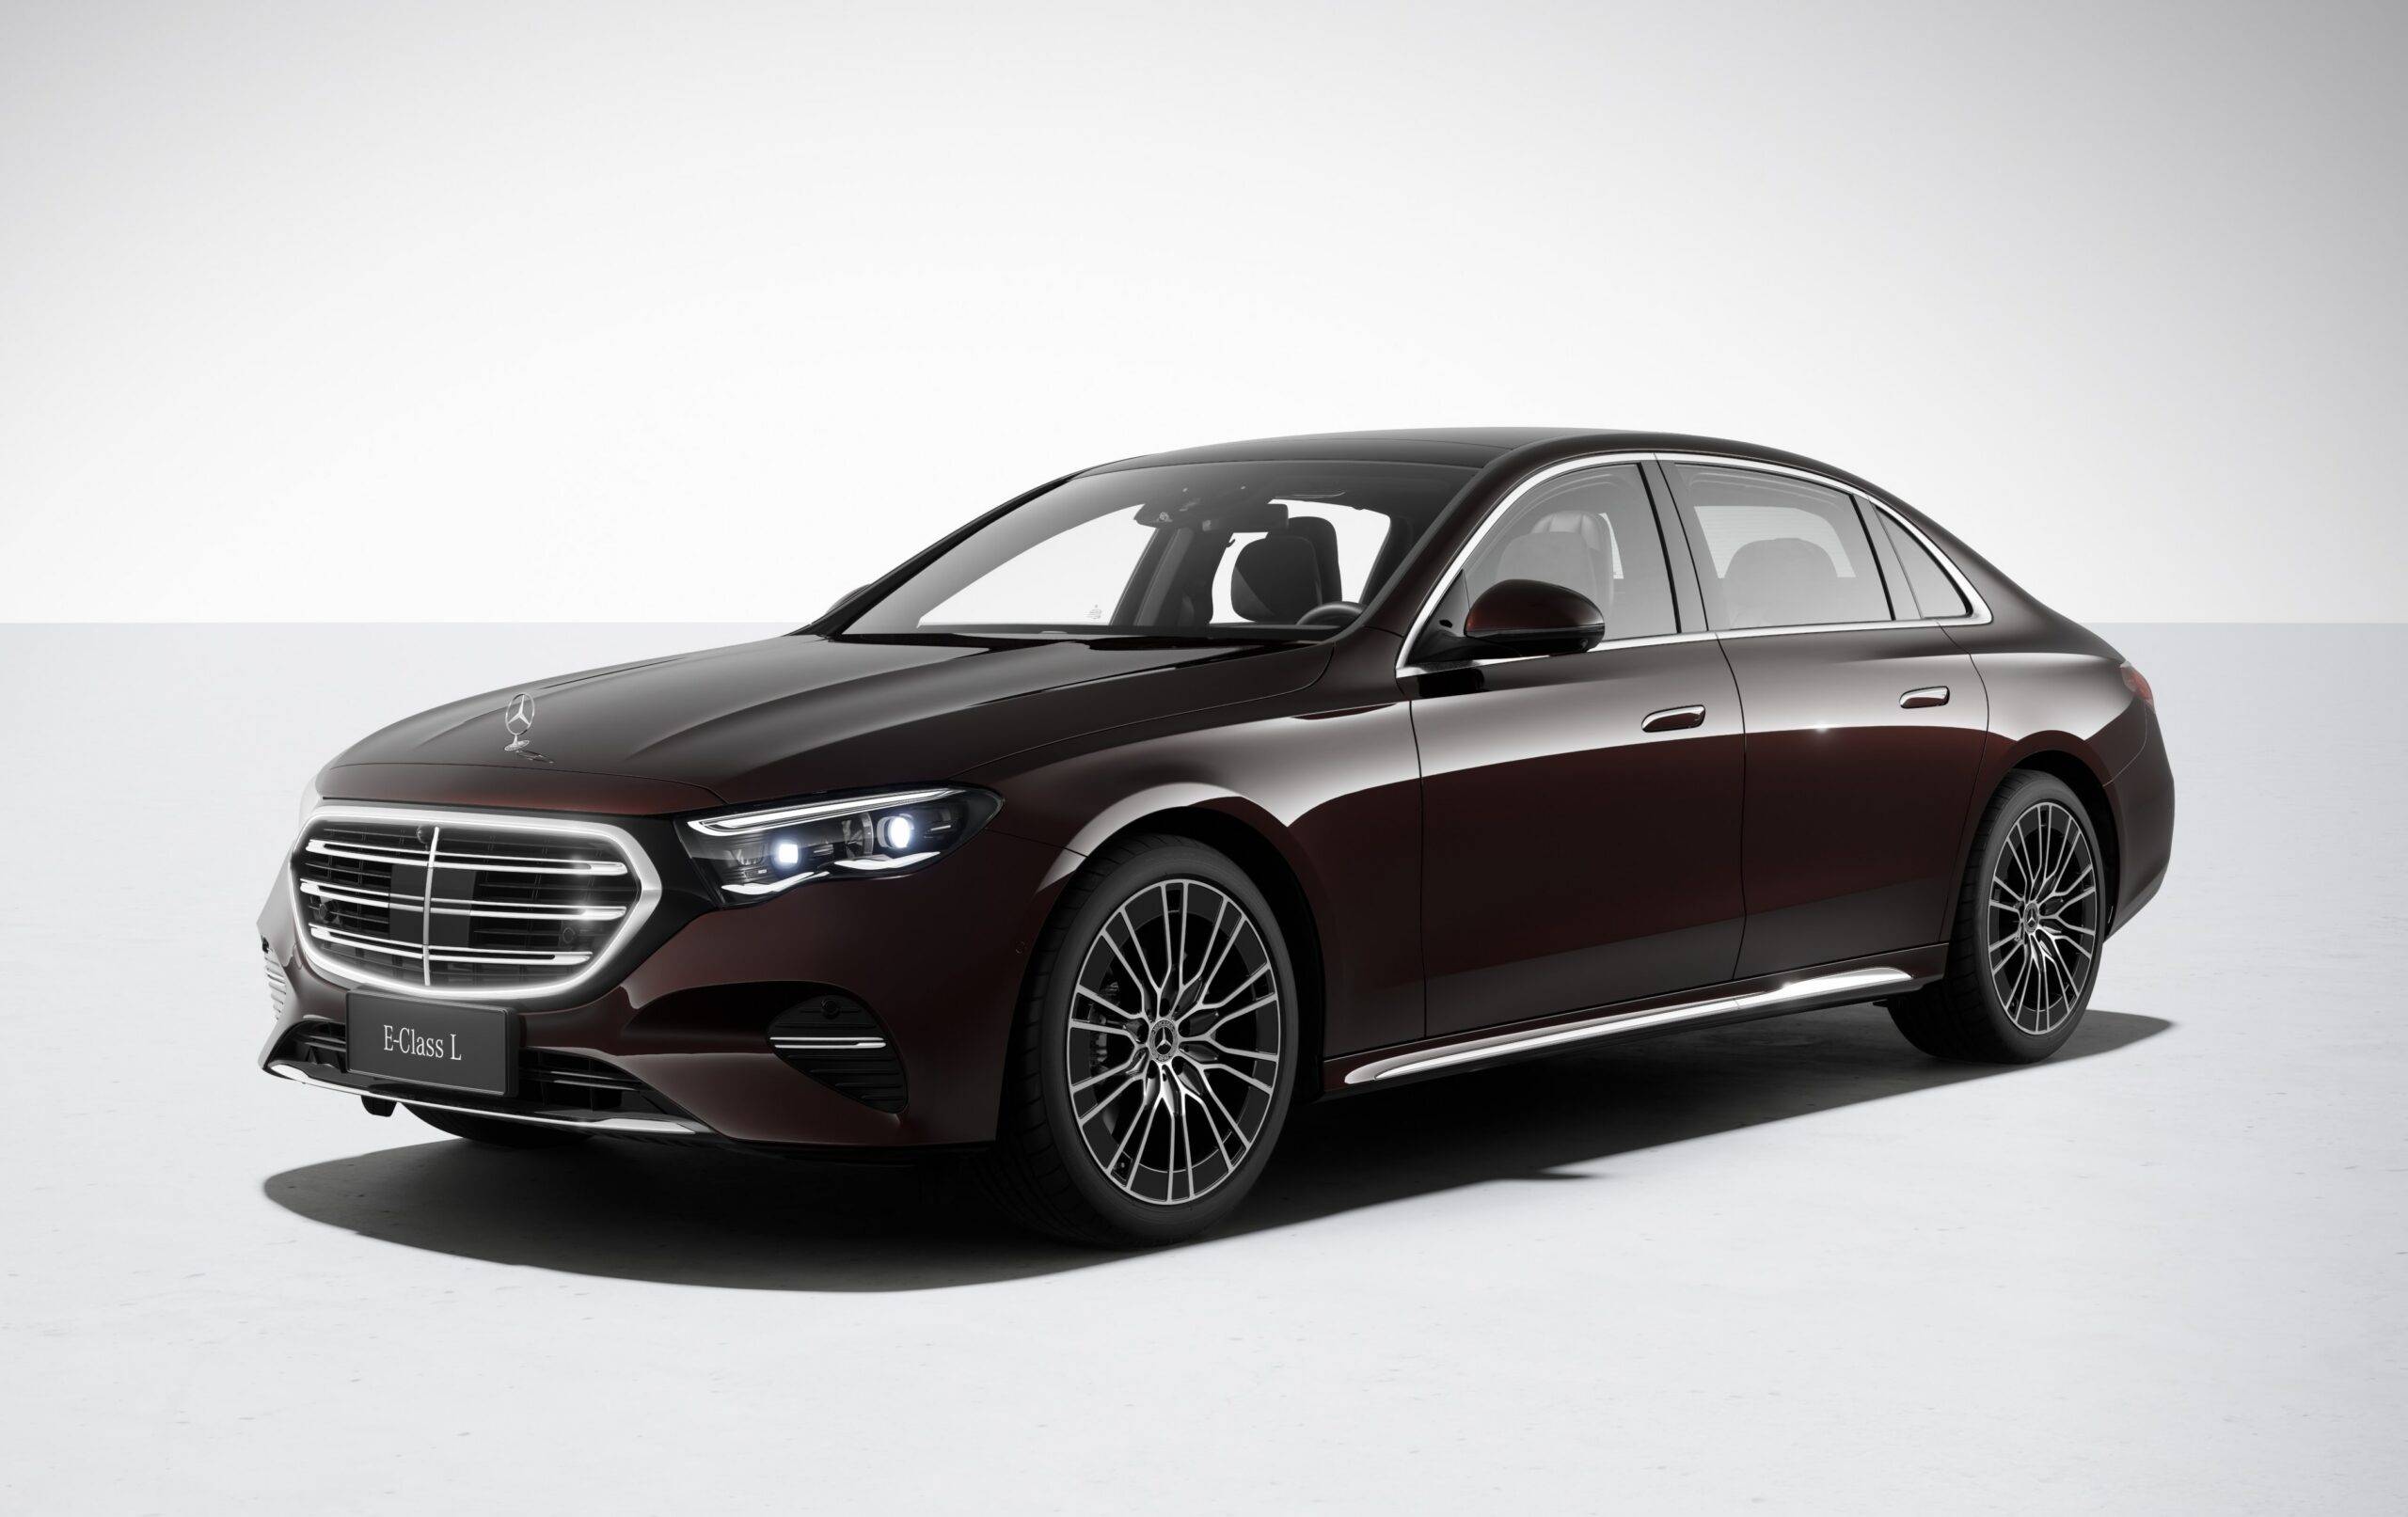
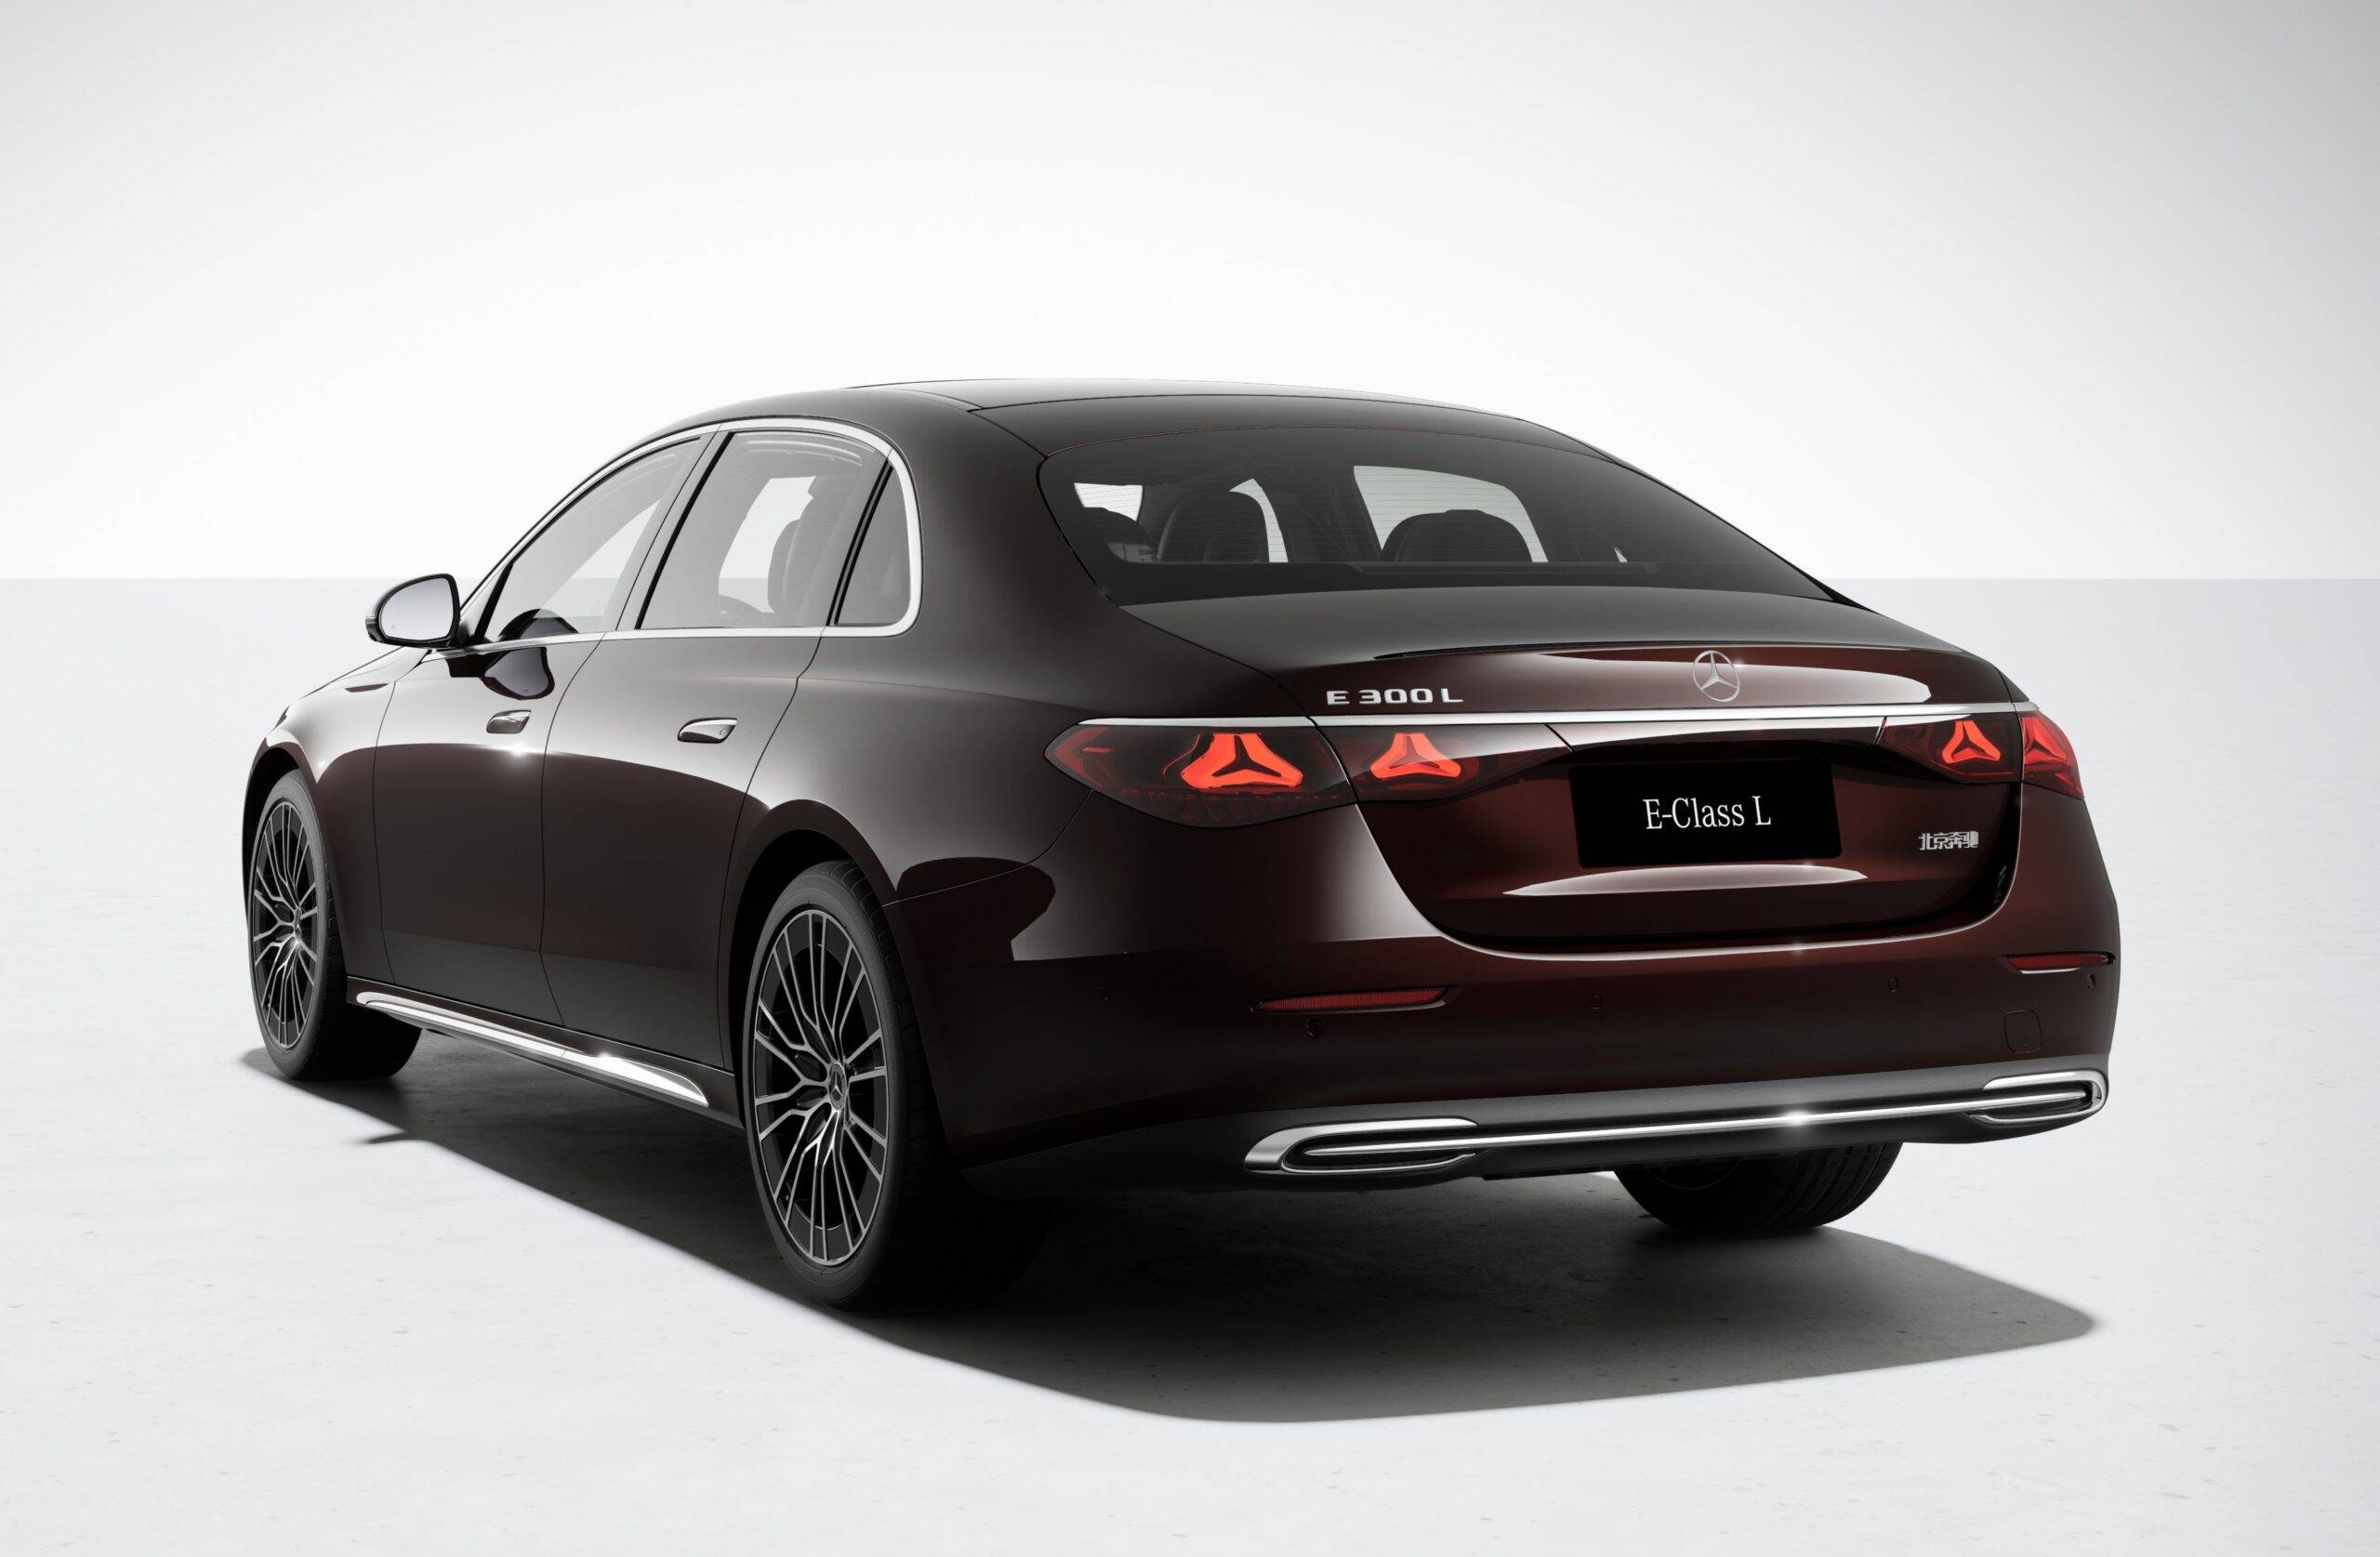
▲ 新款 E 级在外观上并没有太大变化
这次上市的 2026 款长轴距 E 级,售价定在 42.38 万元到 50.98 万元之间,同时还启用了全新的中文命名,分别是晖银版、鎏金版和星铂版。
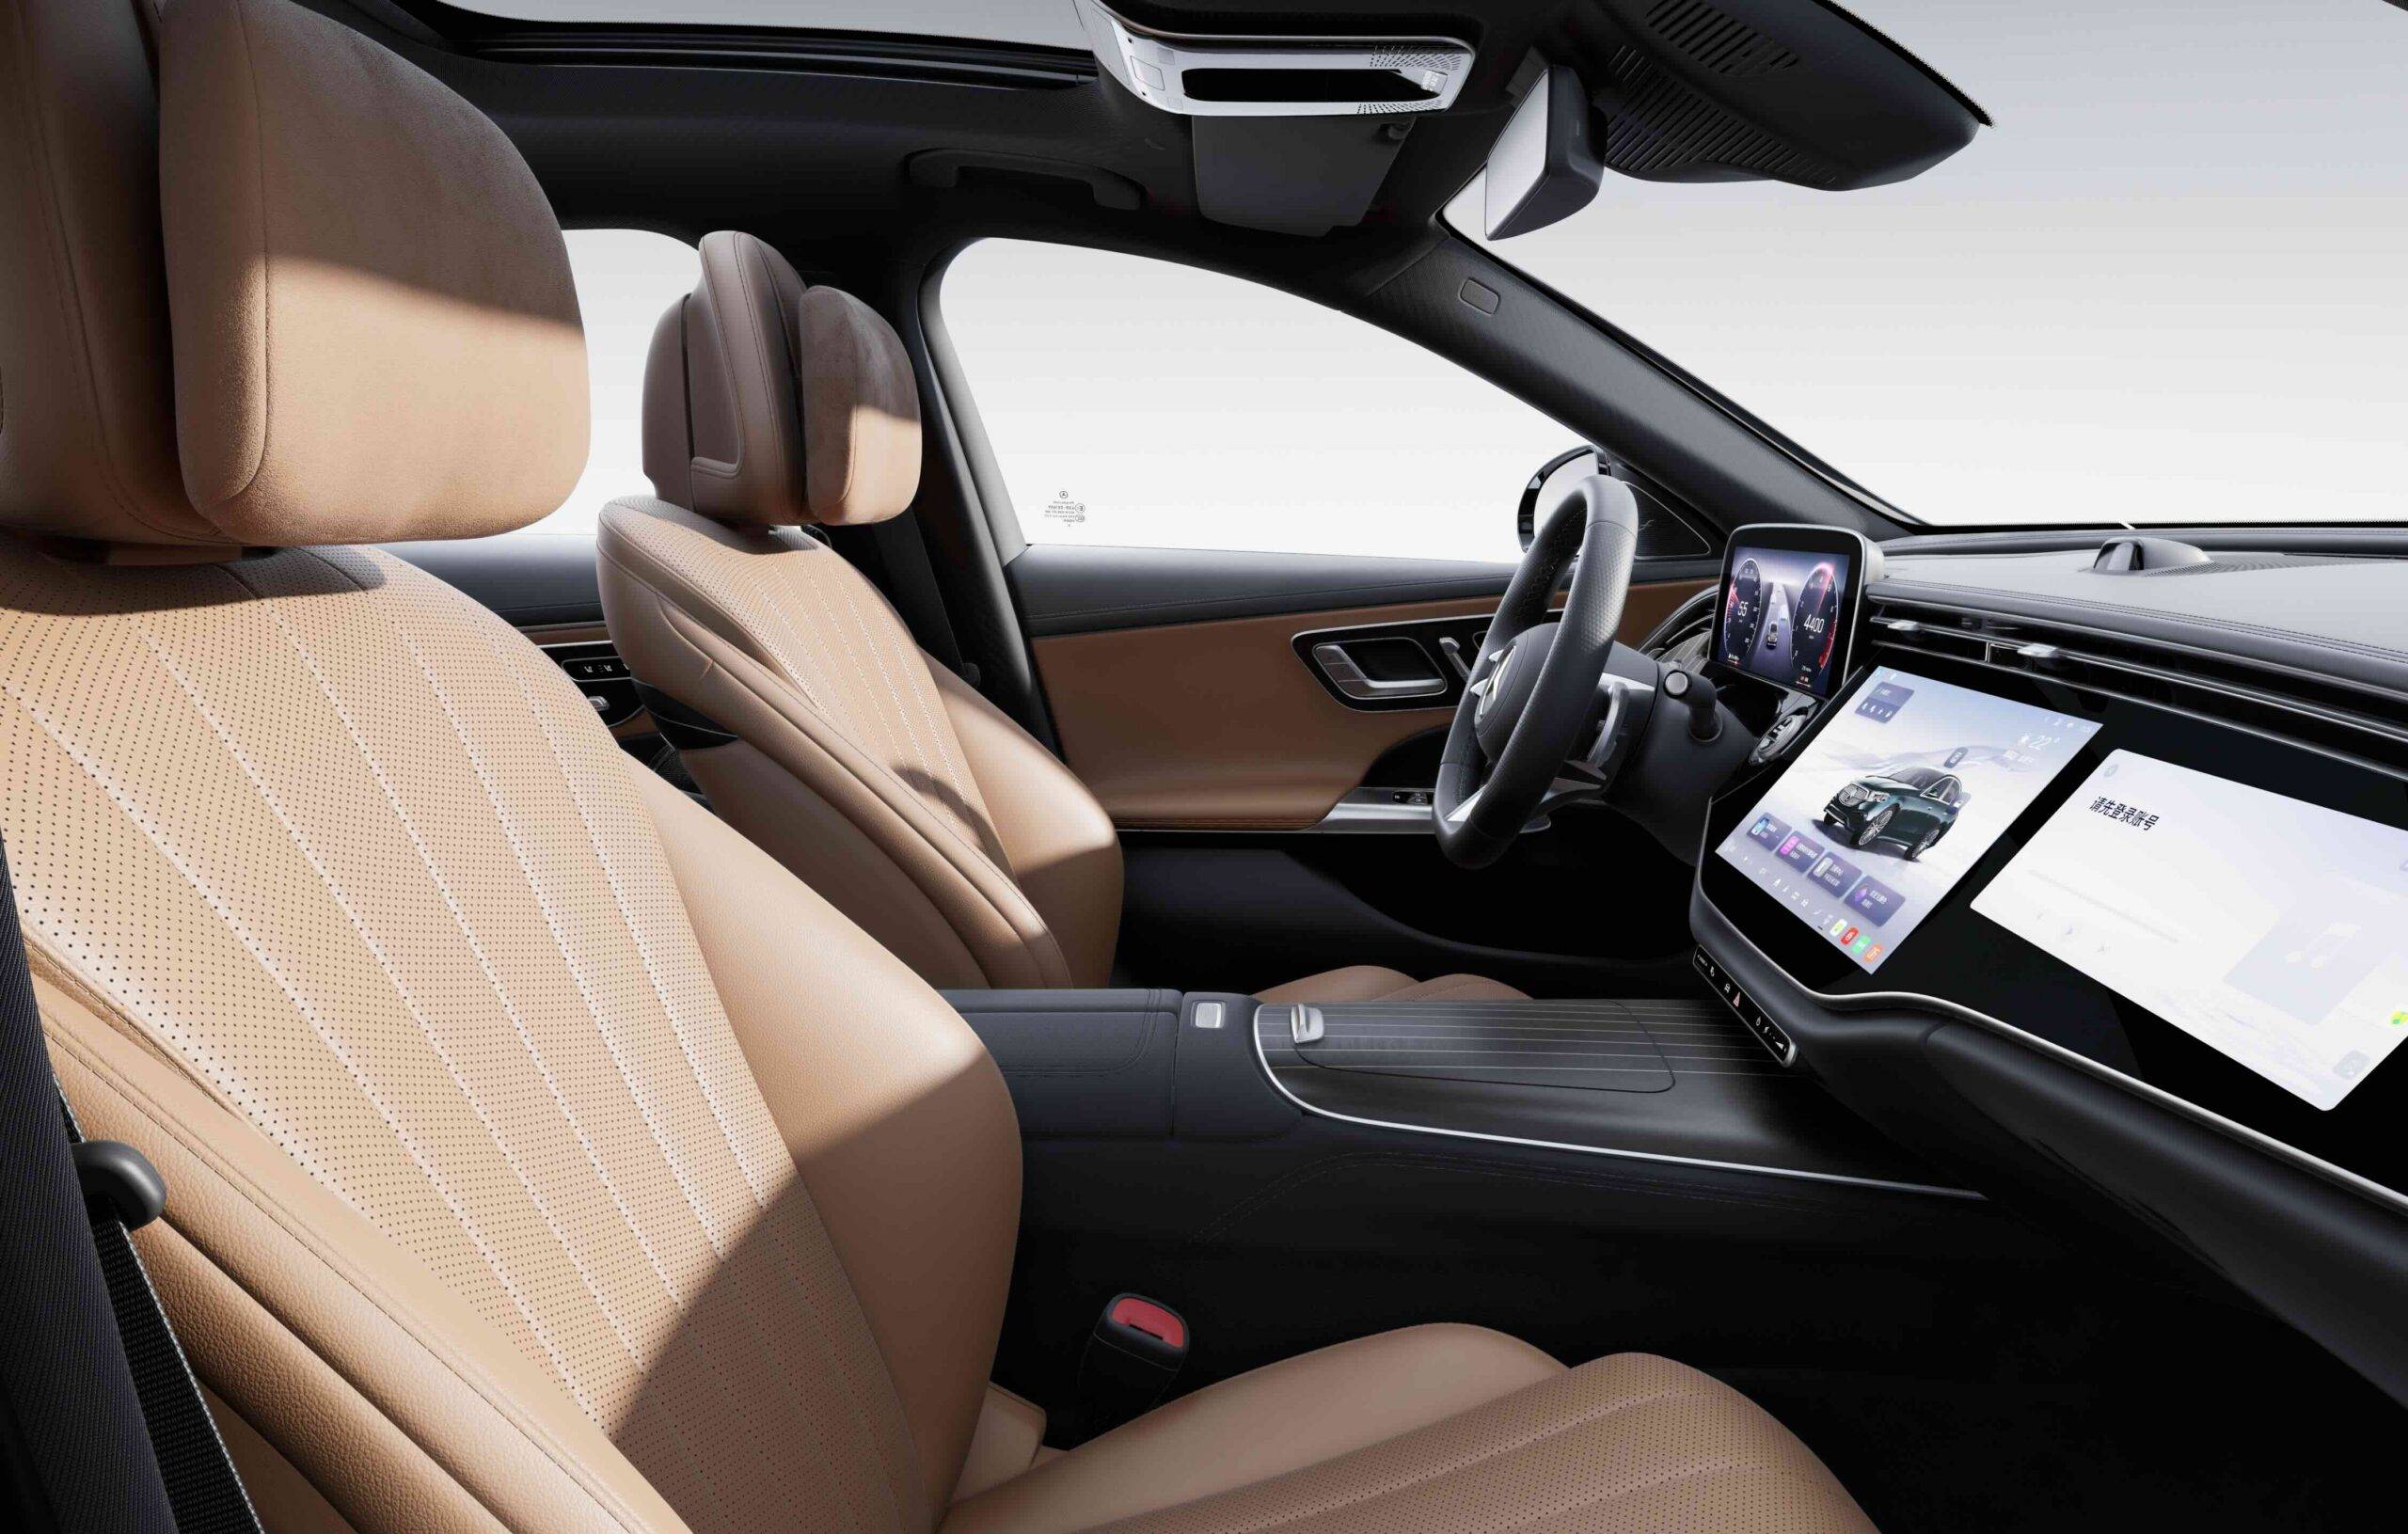
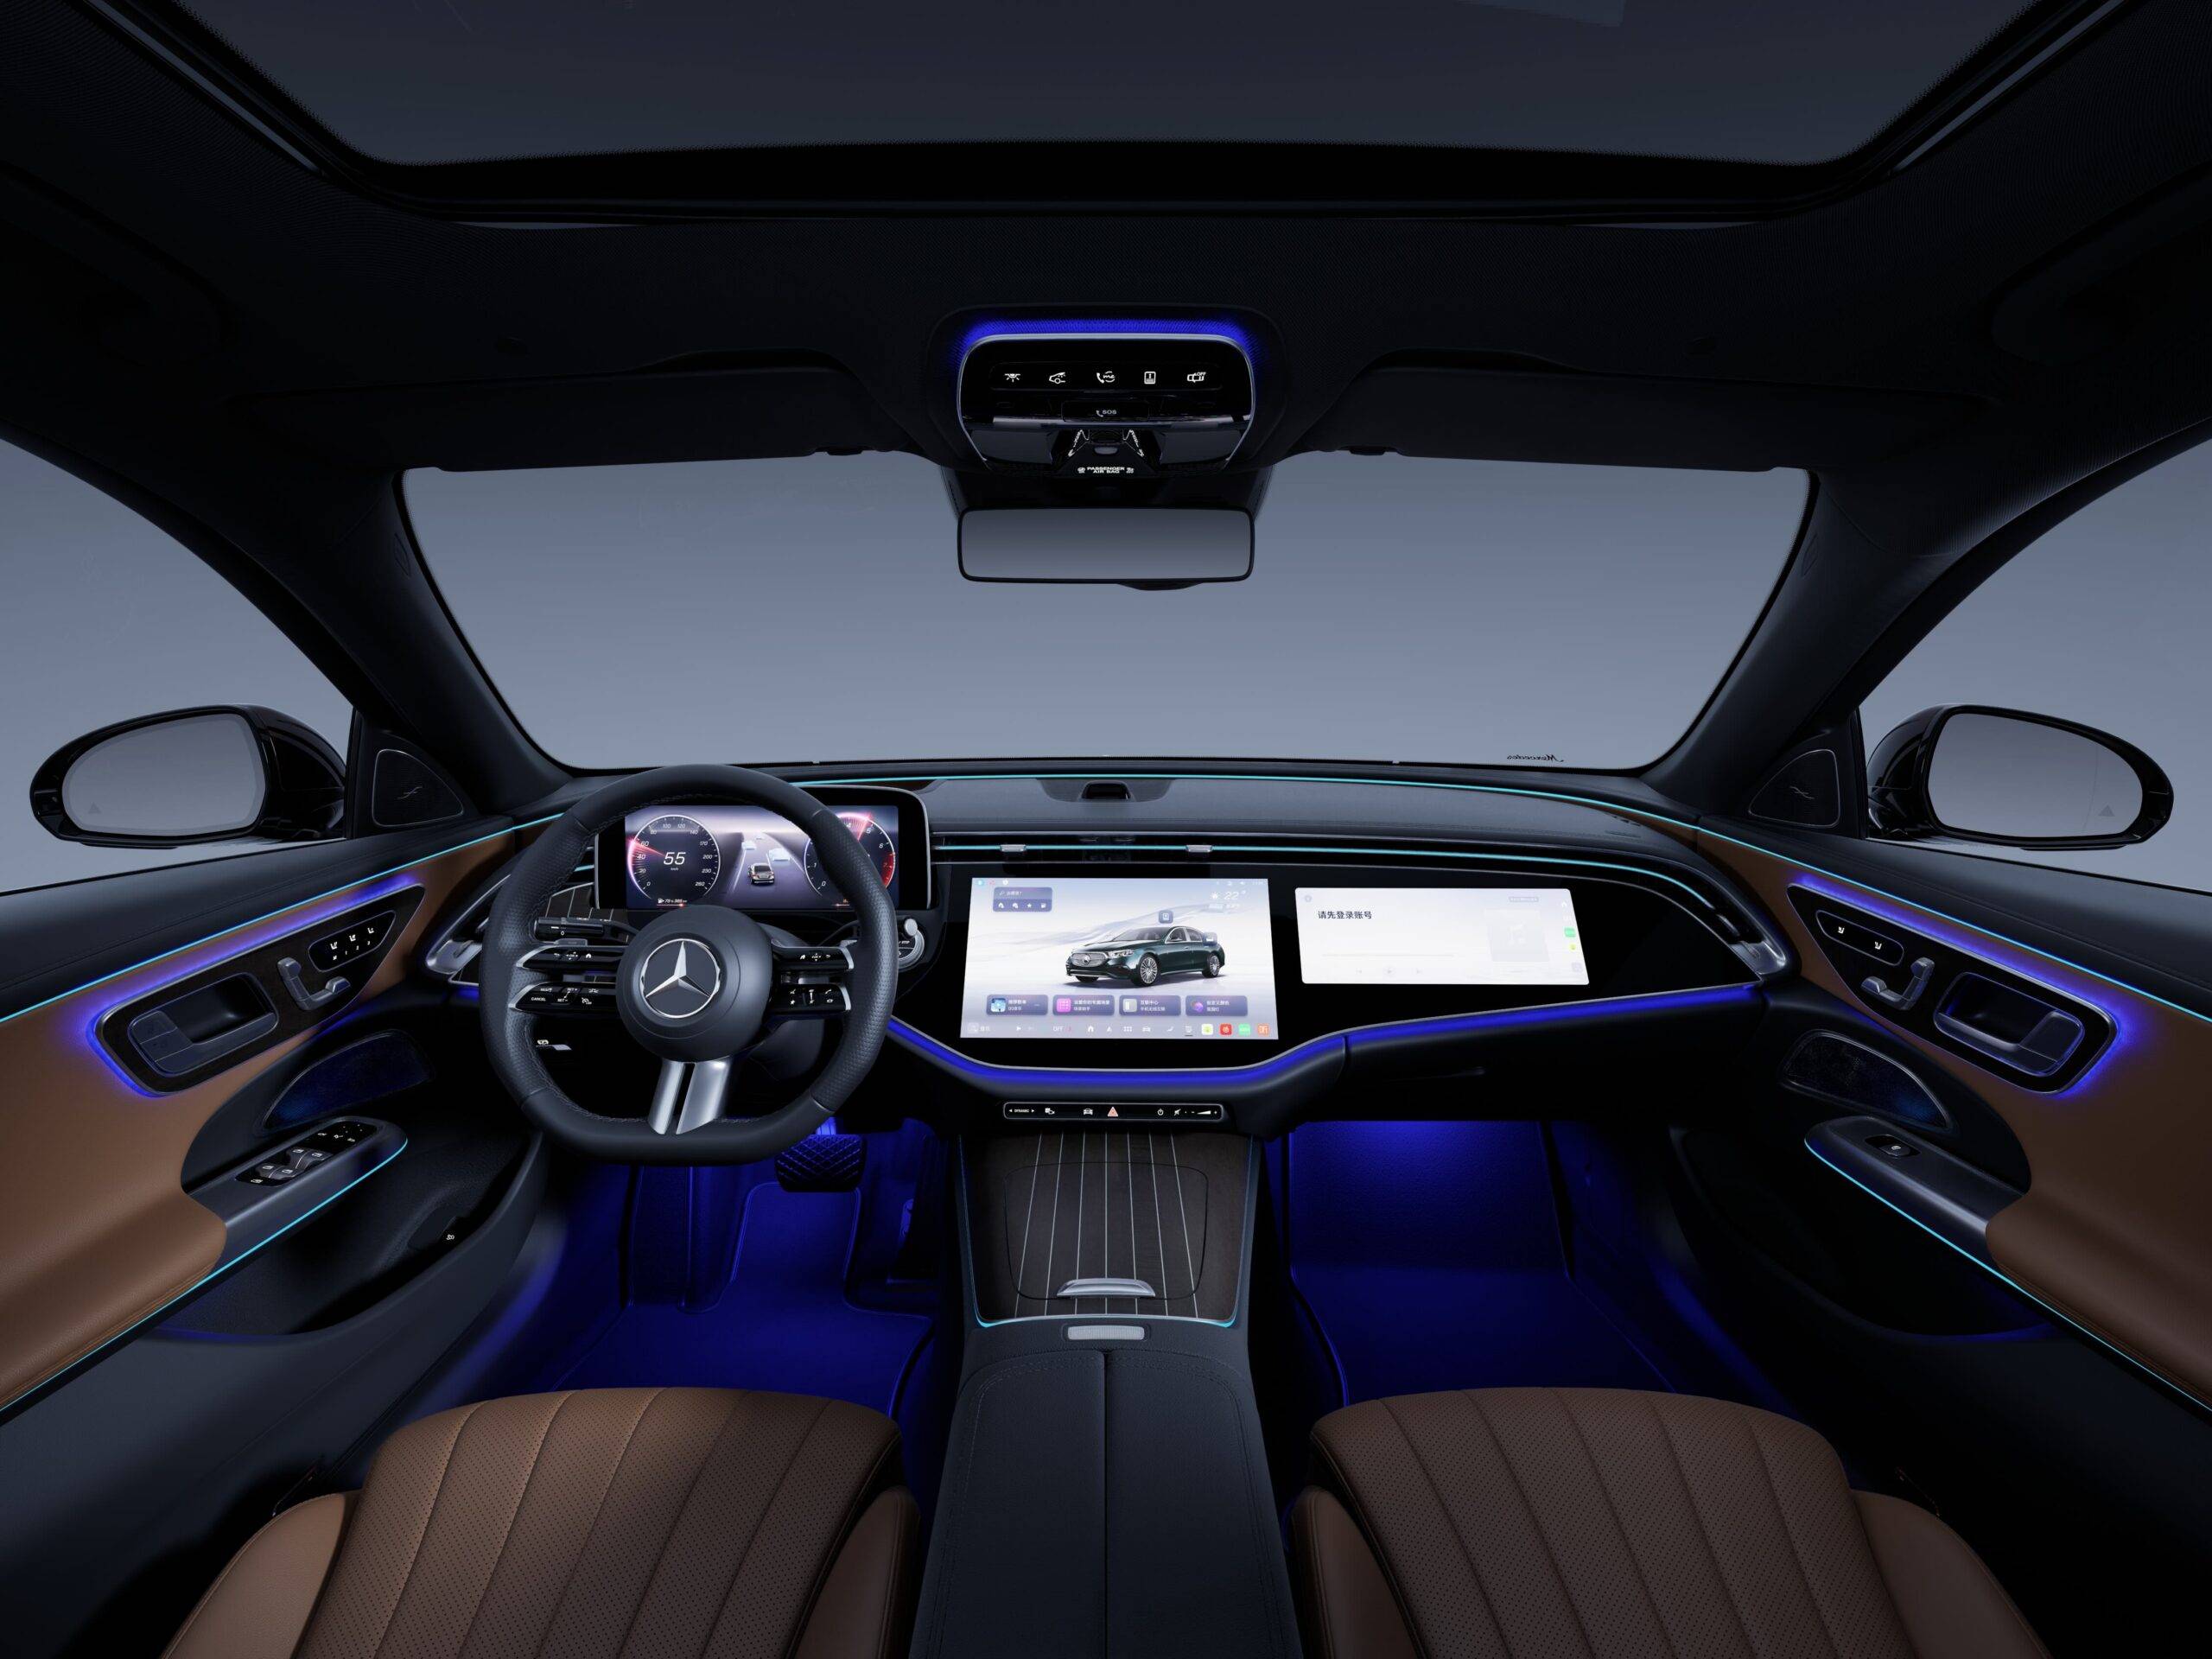
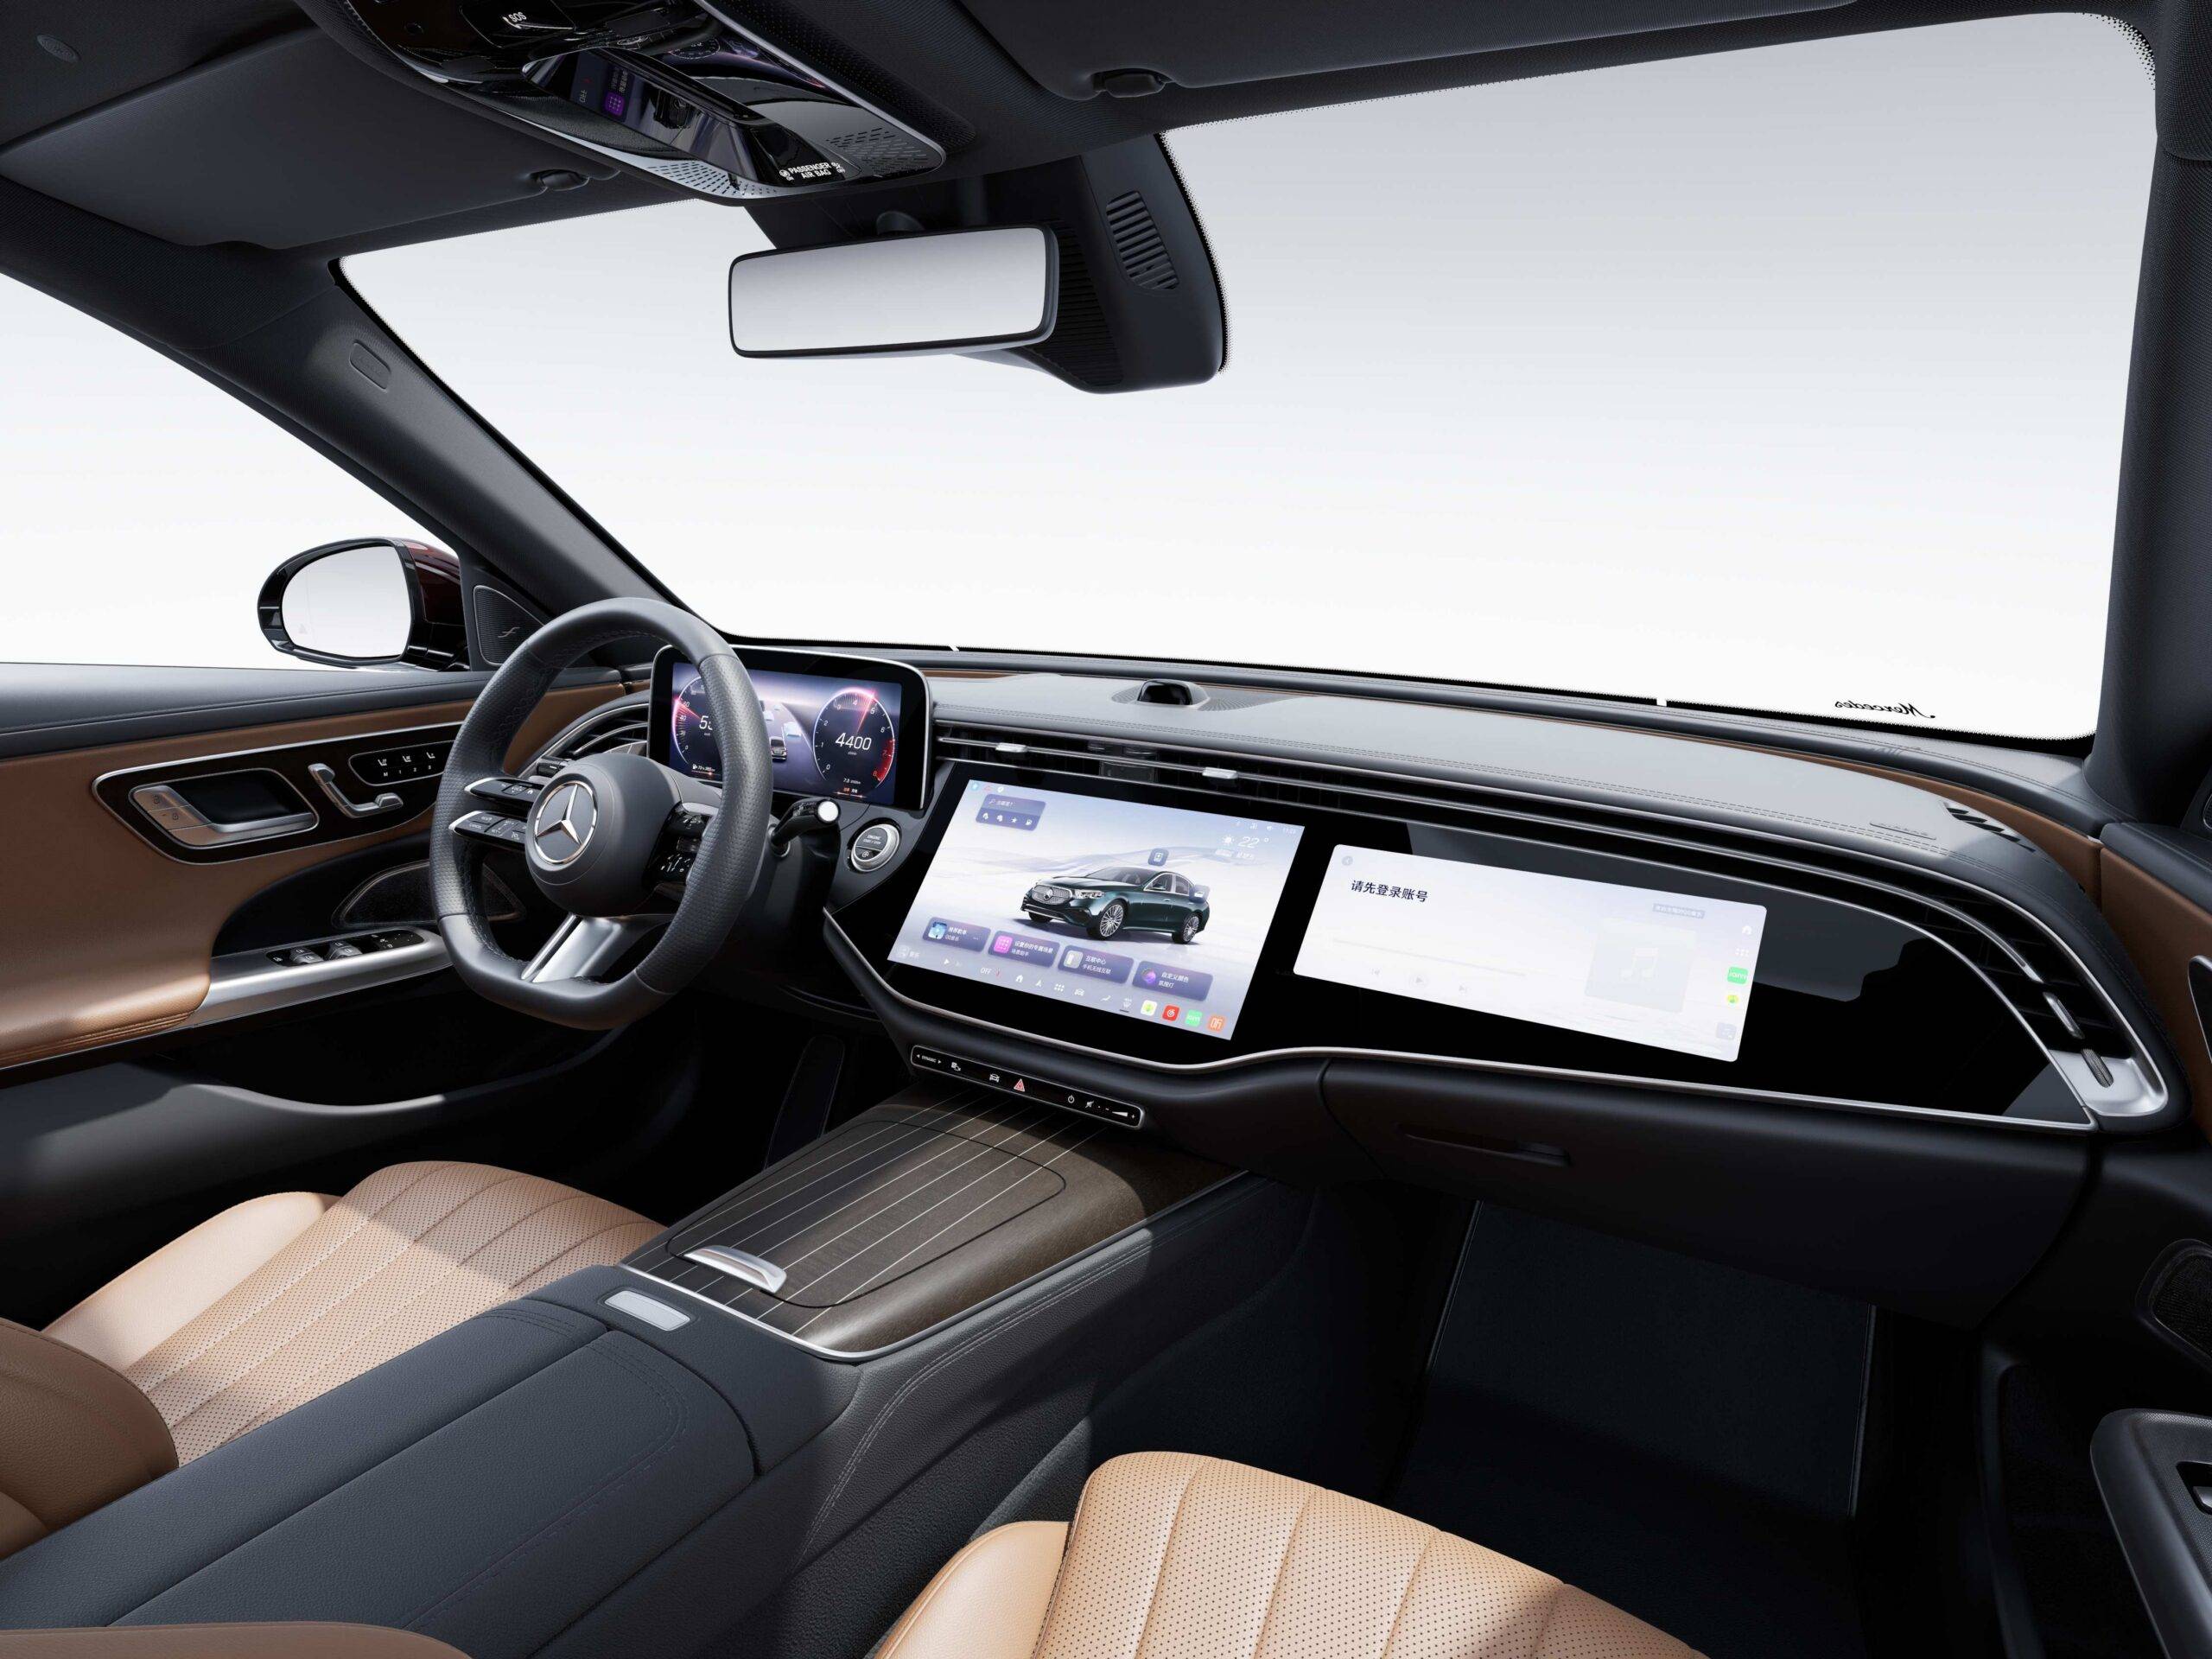
整辆车最受关注的变化,还是落在这套由中国团队操刀的车机系统。
开过老奔驰的人大概都有体会,以前上车第一件事,往往是掏出手机插上支架,亦或是打开 CarPlay。
即便奔驰这几年用上了零层级菜单,海外团队本土化适配的隔阂感,依然困扰着很多用户。
平时经常不及格的差生拿个 60 分,往往就能赢来尖子生考 90 分才有的掌声。但奔驰这次在车机上,并没有打算混个及格,而是拿出了接近 90 分水准的答卷。
感知最明显的自然是操作的顺滑度。
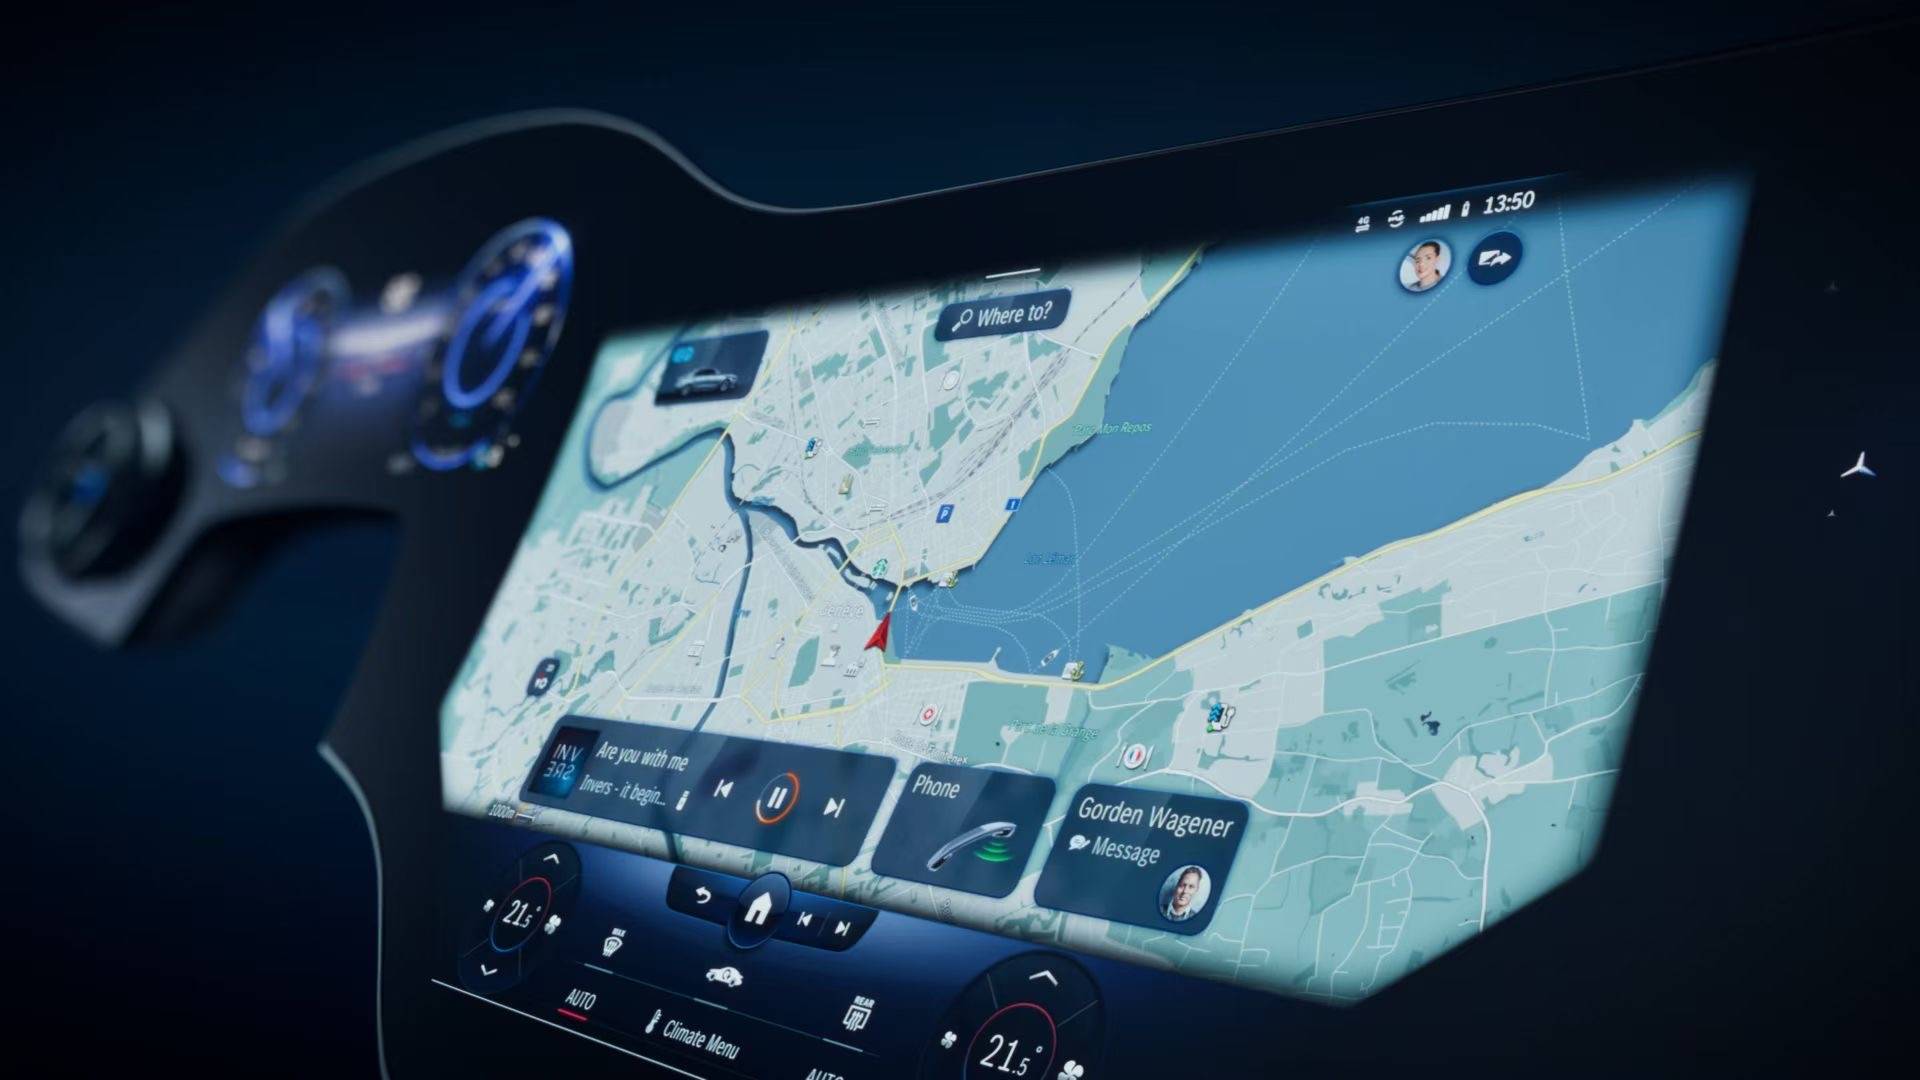
在 2026 款长轴距 E 级上,地图操作的帧率跑到了每秒 60 帧,拖拽和双指缩放的迟滞感终于没有了,且无论是操作逻辑还是界面样式,都更加接近主流新势力车企。
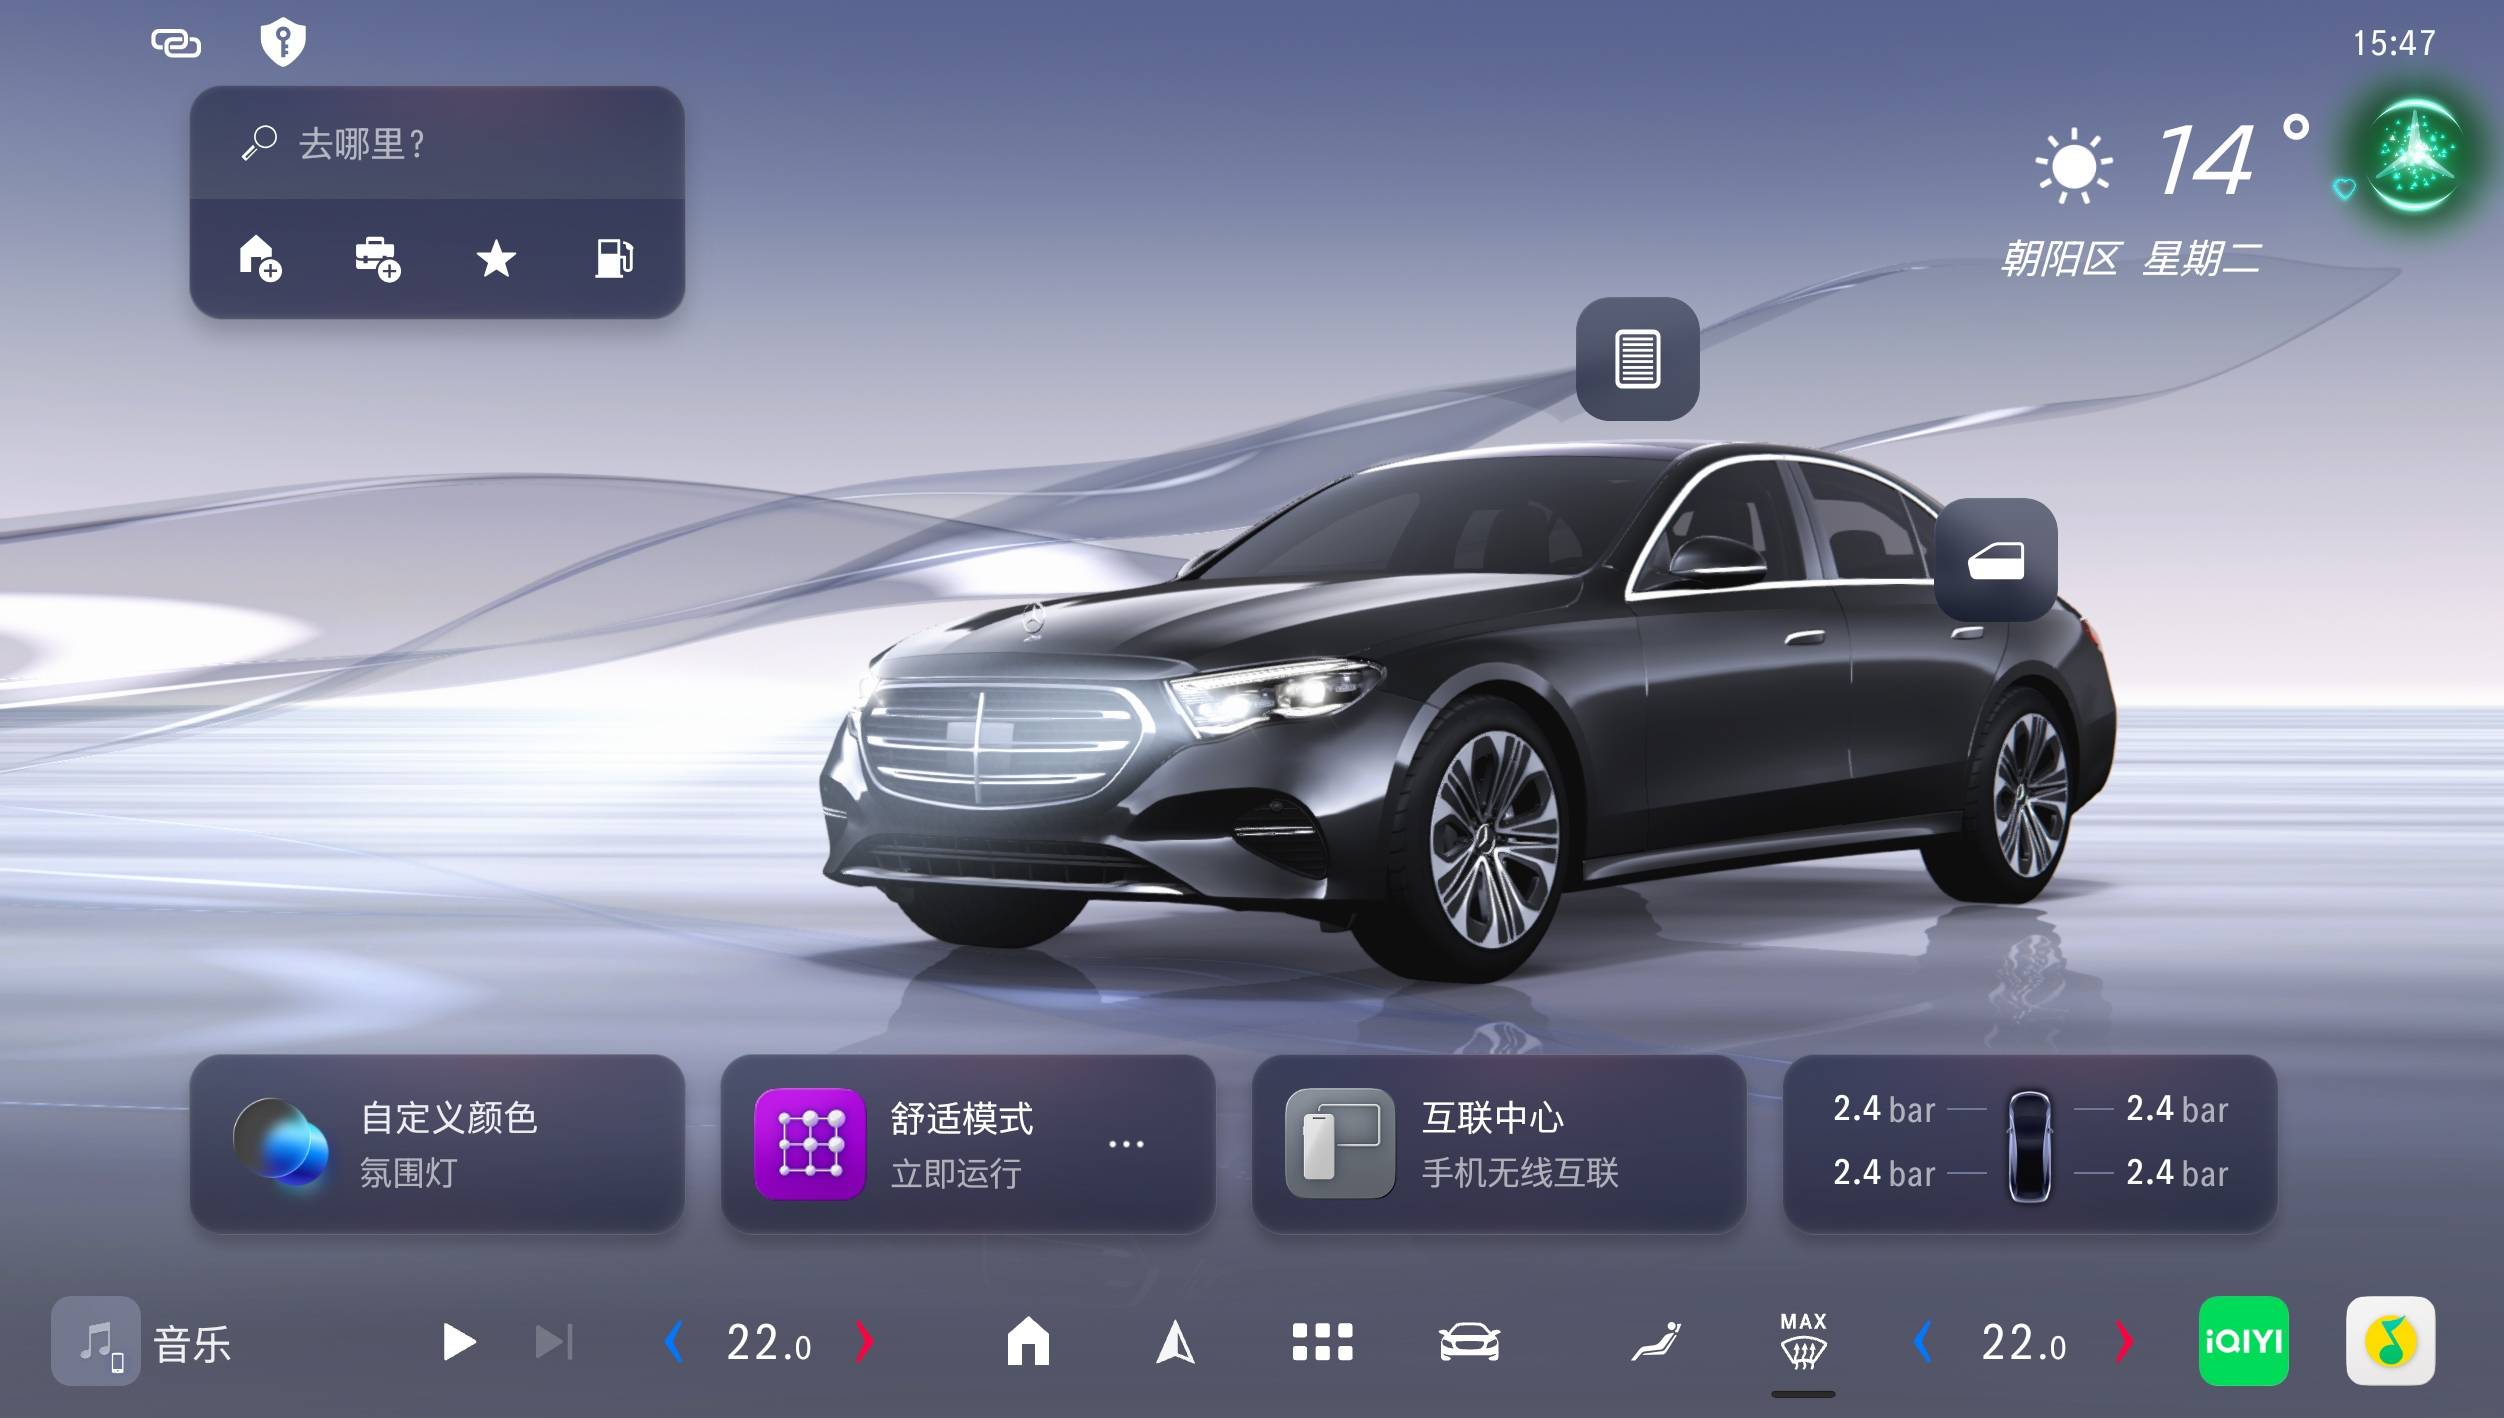
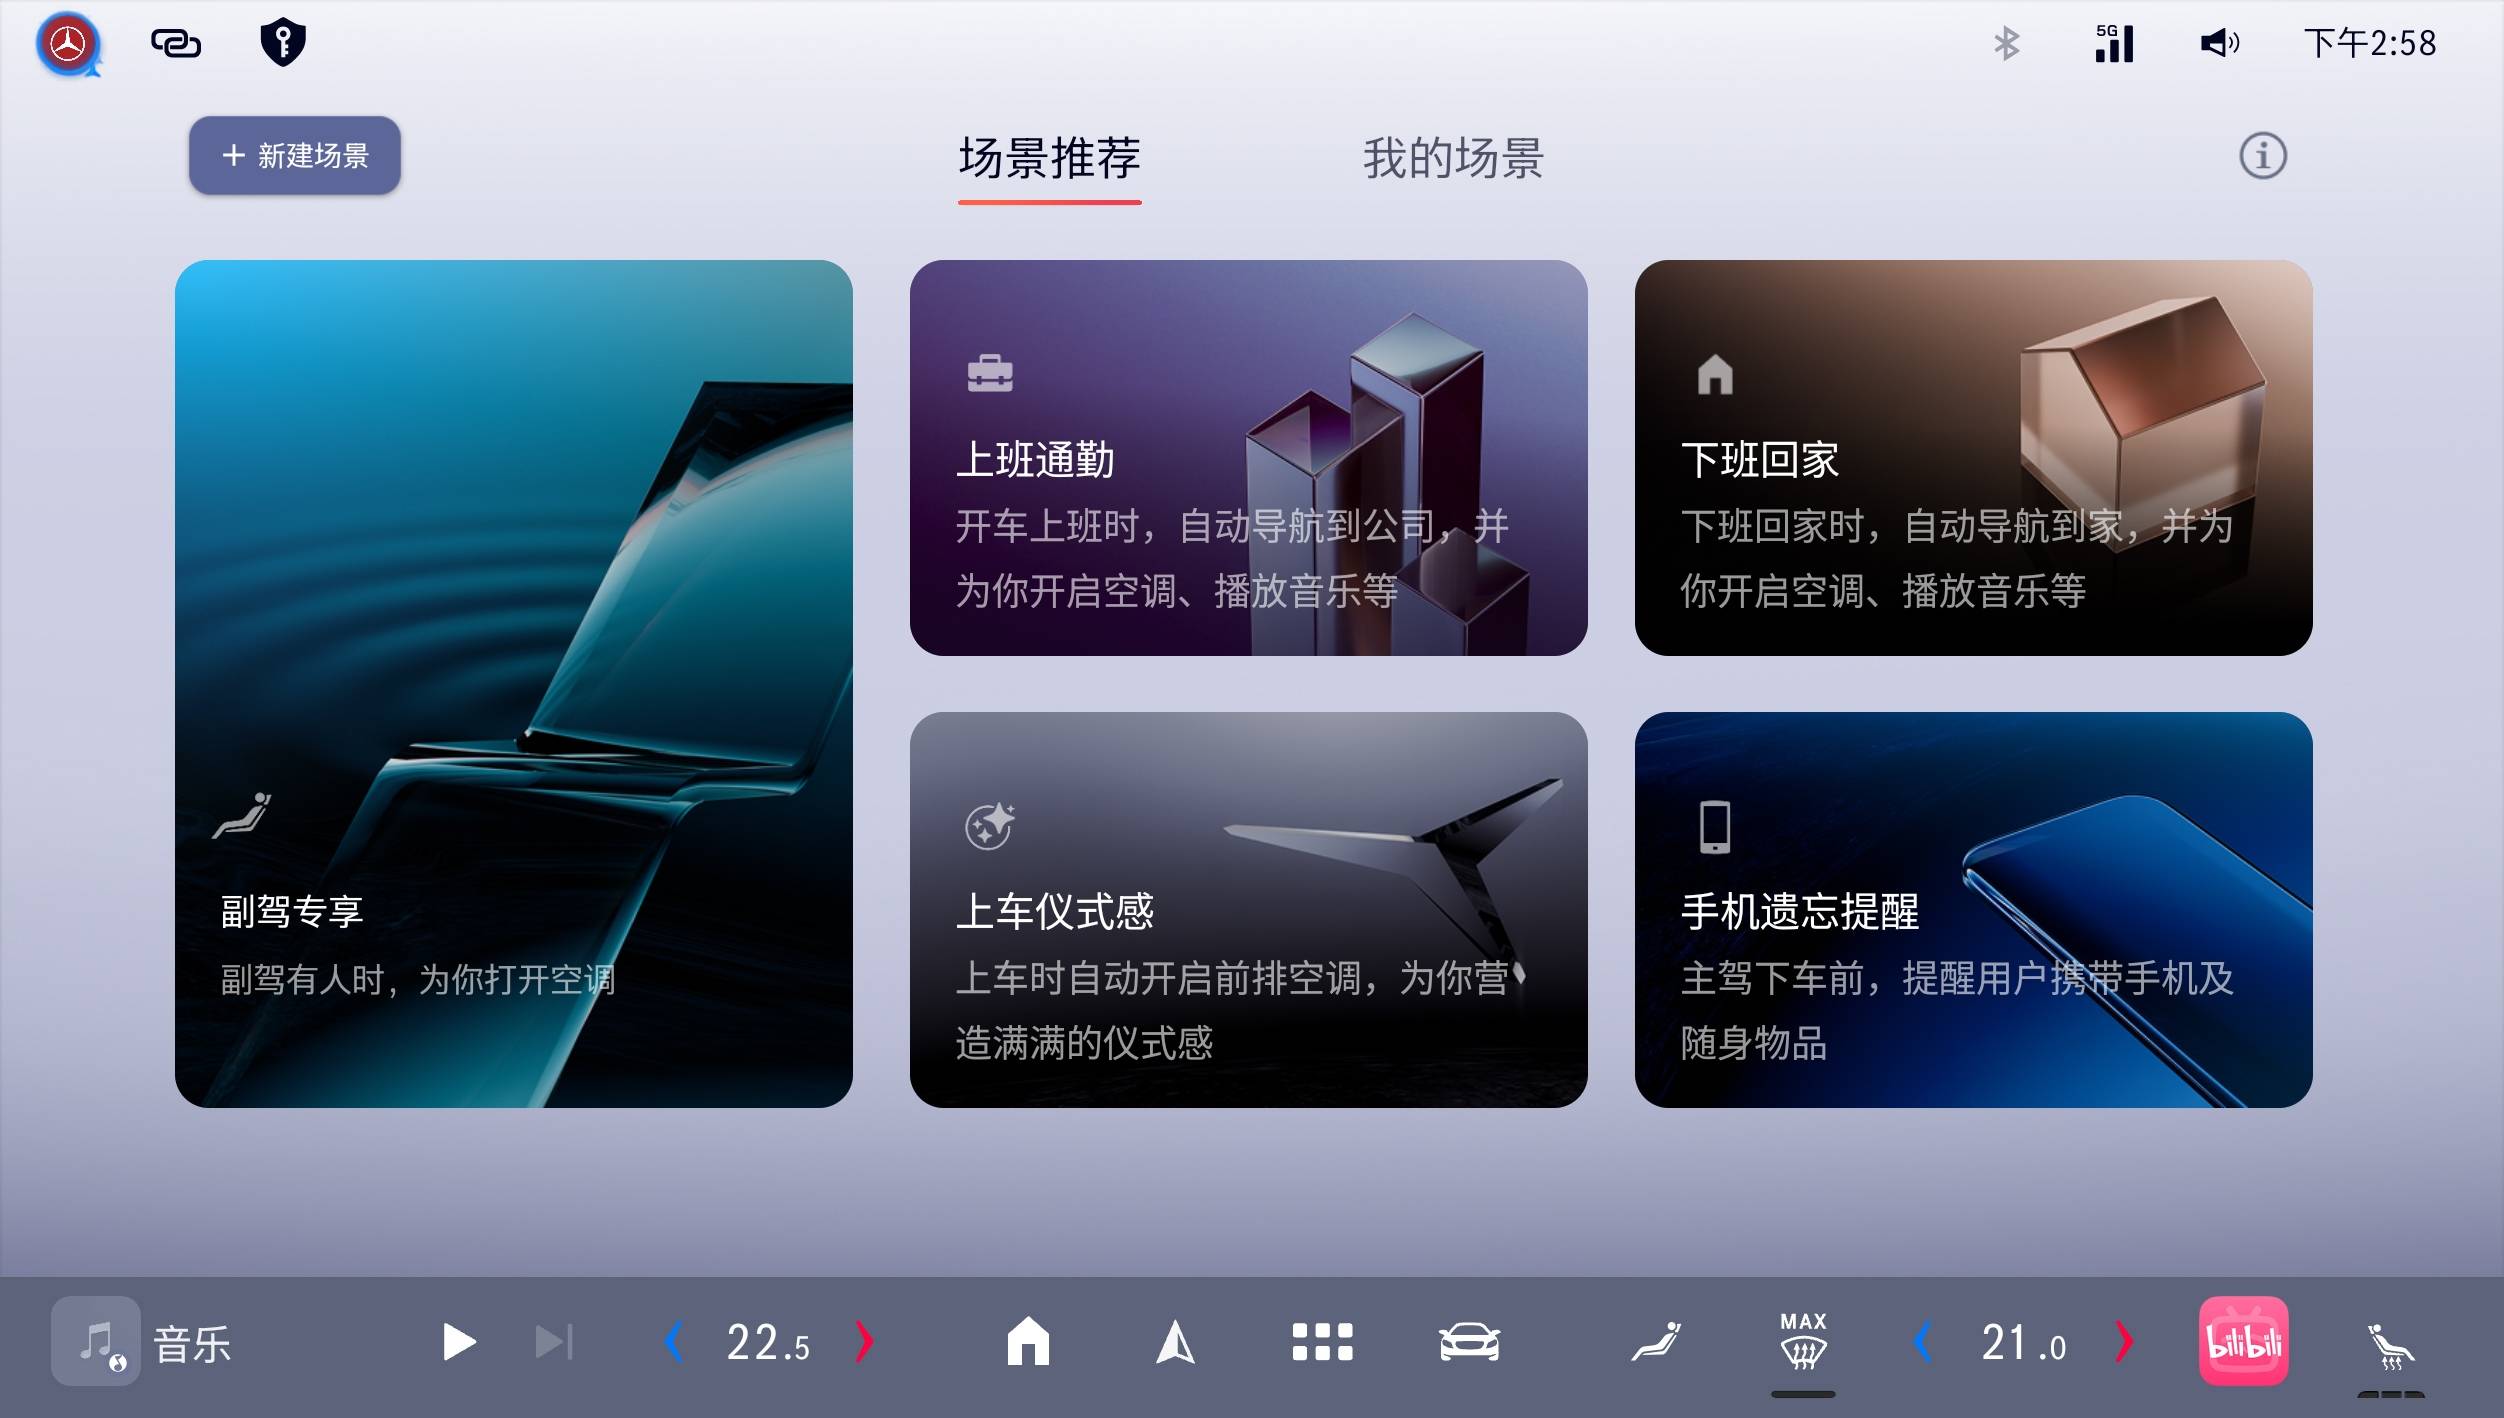
比如屏幕中央那个 3D 车模,想开哪个车窗,又或者是拉上遮阳帘,在车模上点一下就行。另外,奔驰还细分出 11 类触发条件和 15 类执行动作,用户可以按自己的习惯组合出各种用车场景。
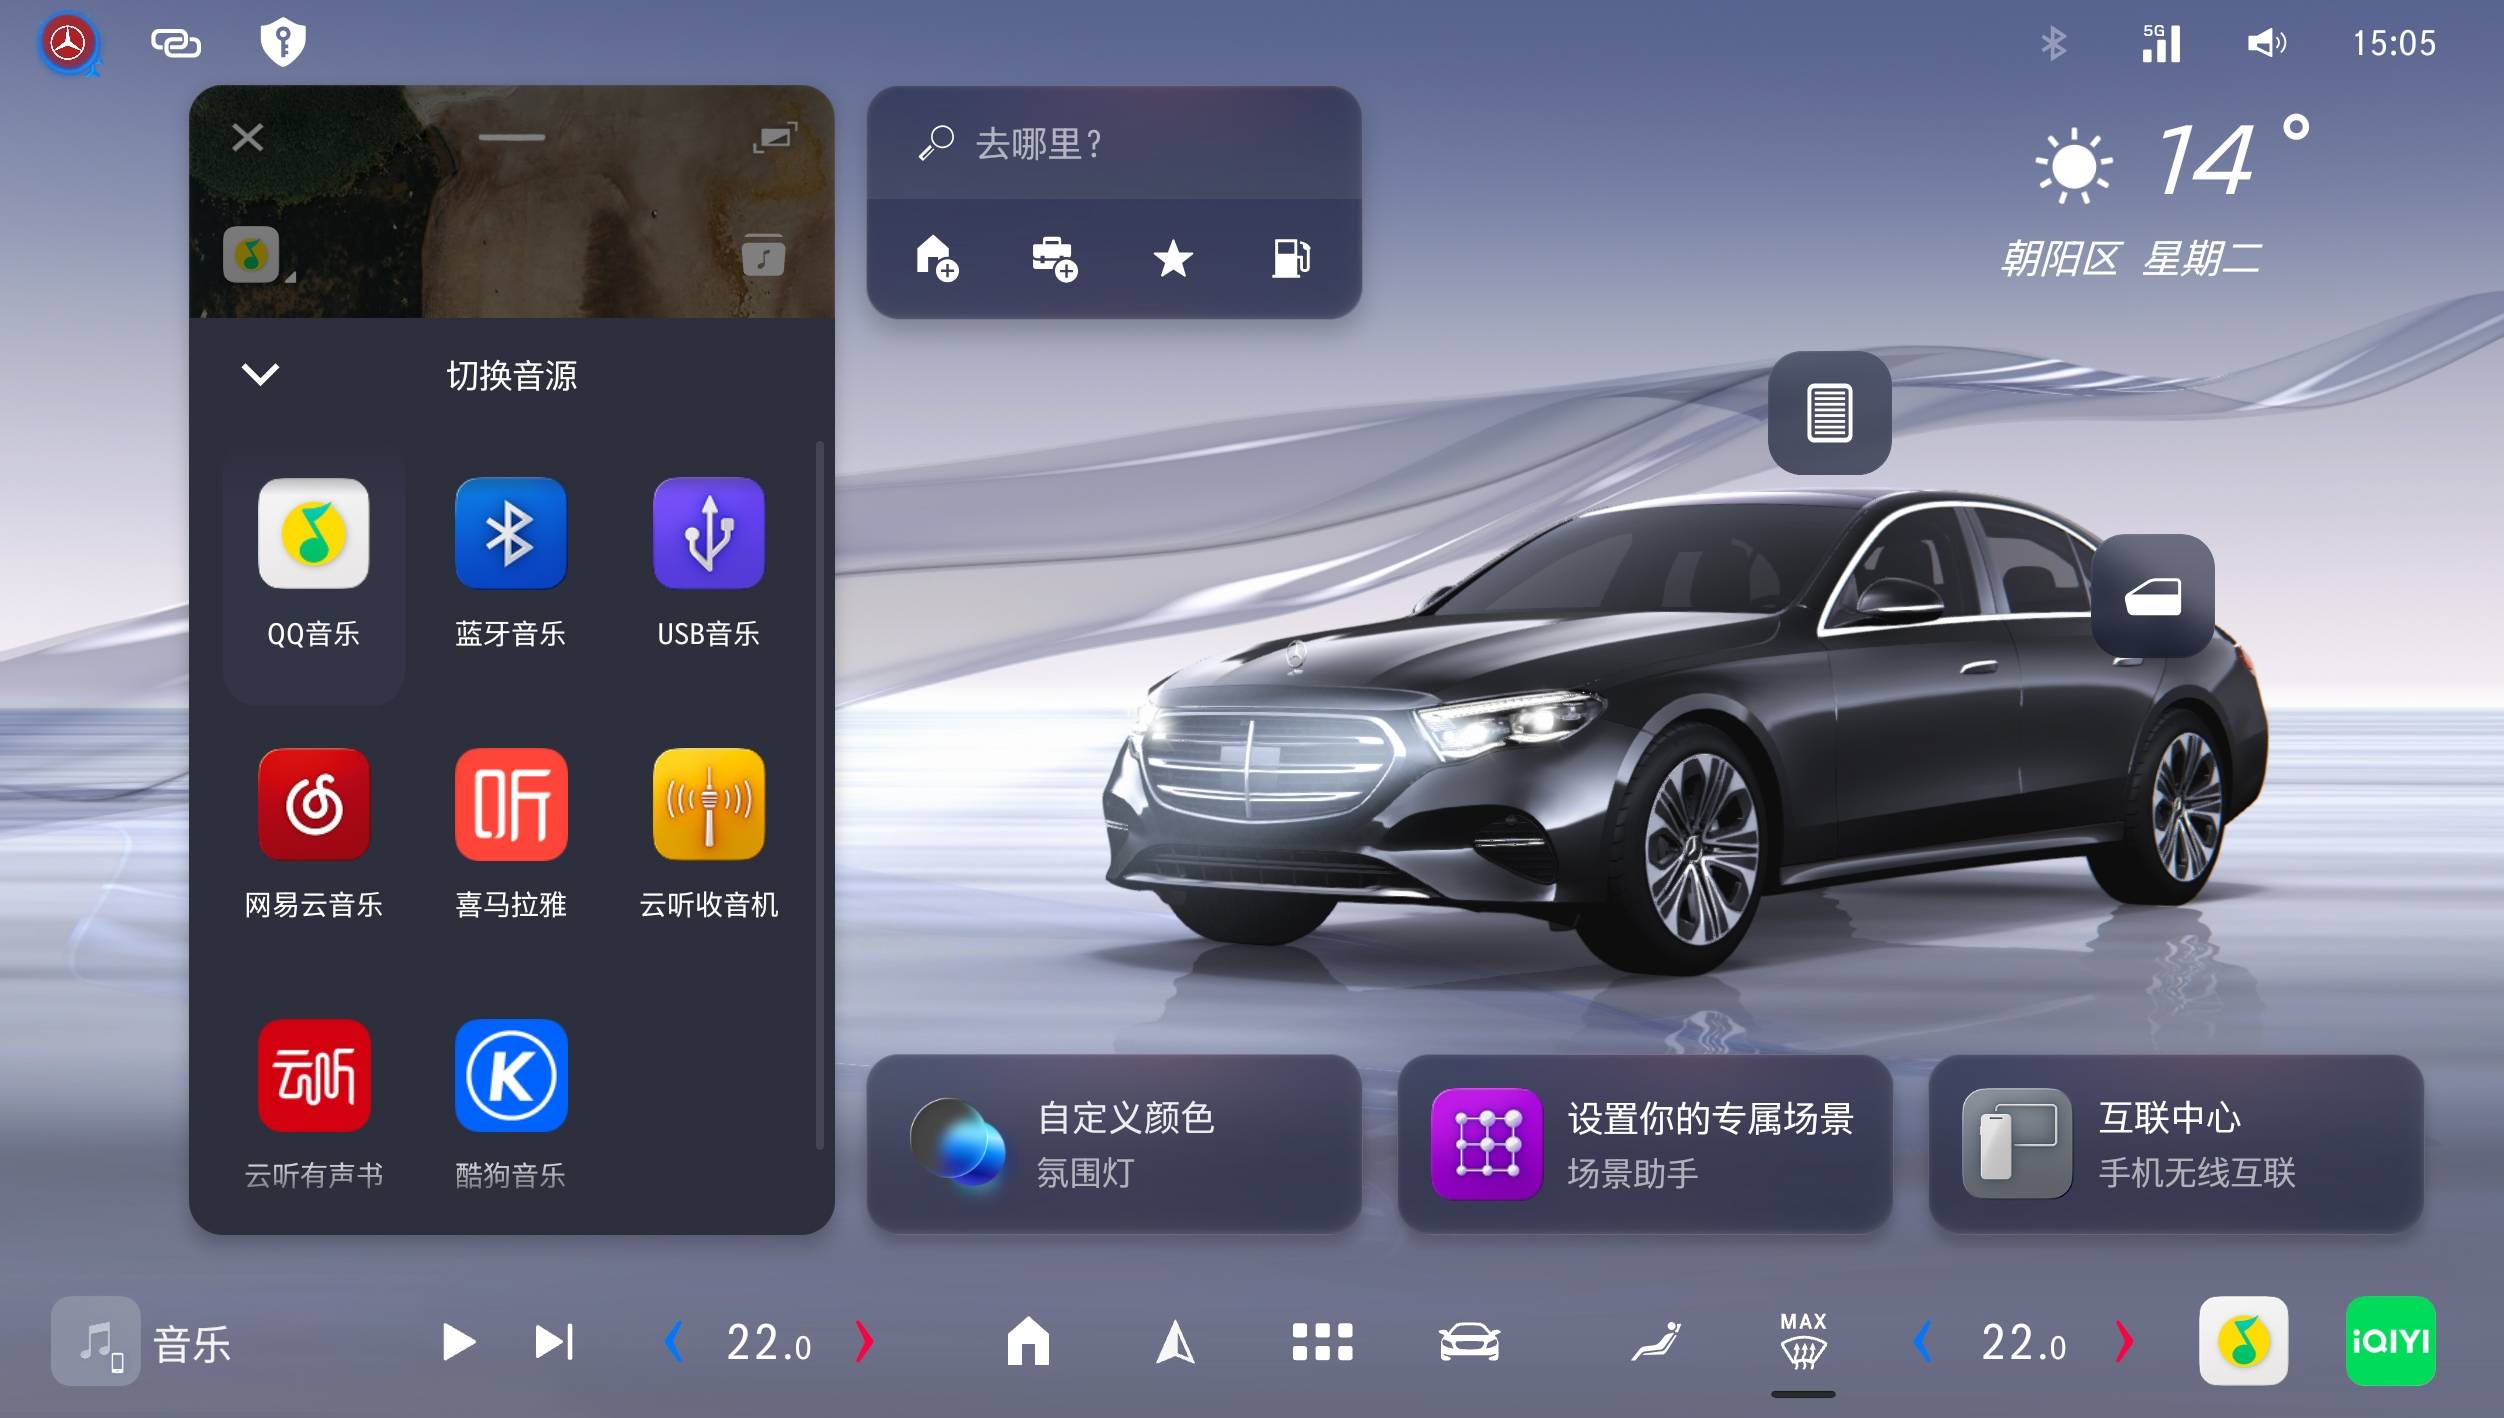
更关键的变化在于语音助手,之前在纯电 CLA、GLC 上大放异彩的豆包大模型,这次也来到了 E 级的座舱里。它不仅全面支持「可见即可说」,唤醒速度也只有 0.25 秒,多音区识别准确率达到 98%,还能通过声纹记住最多 6 位家庭成员的使用习惯。
不过从董车会此前的体验来看,语音助手「小奔」会有比较高的概率误触发,不知道在 E 级上有没有改善。
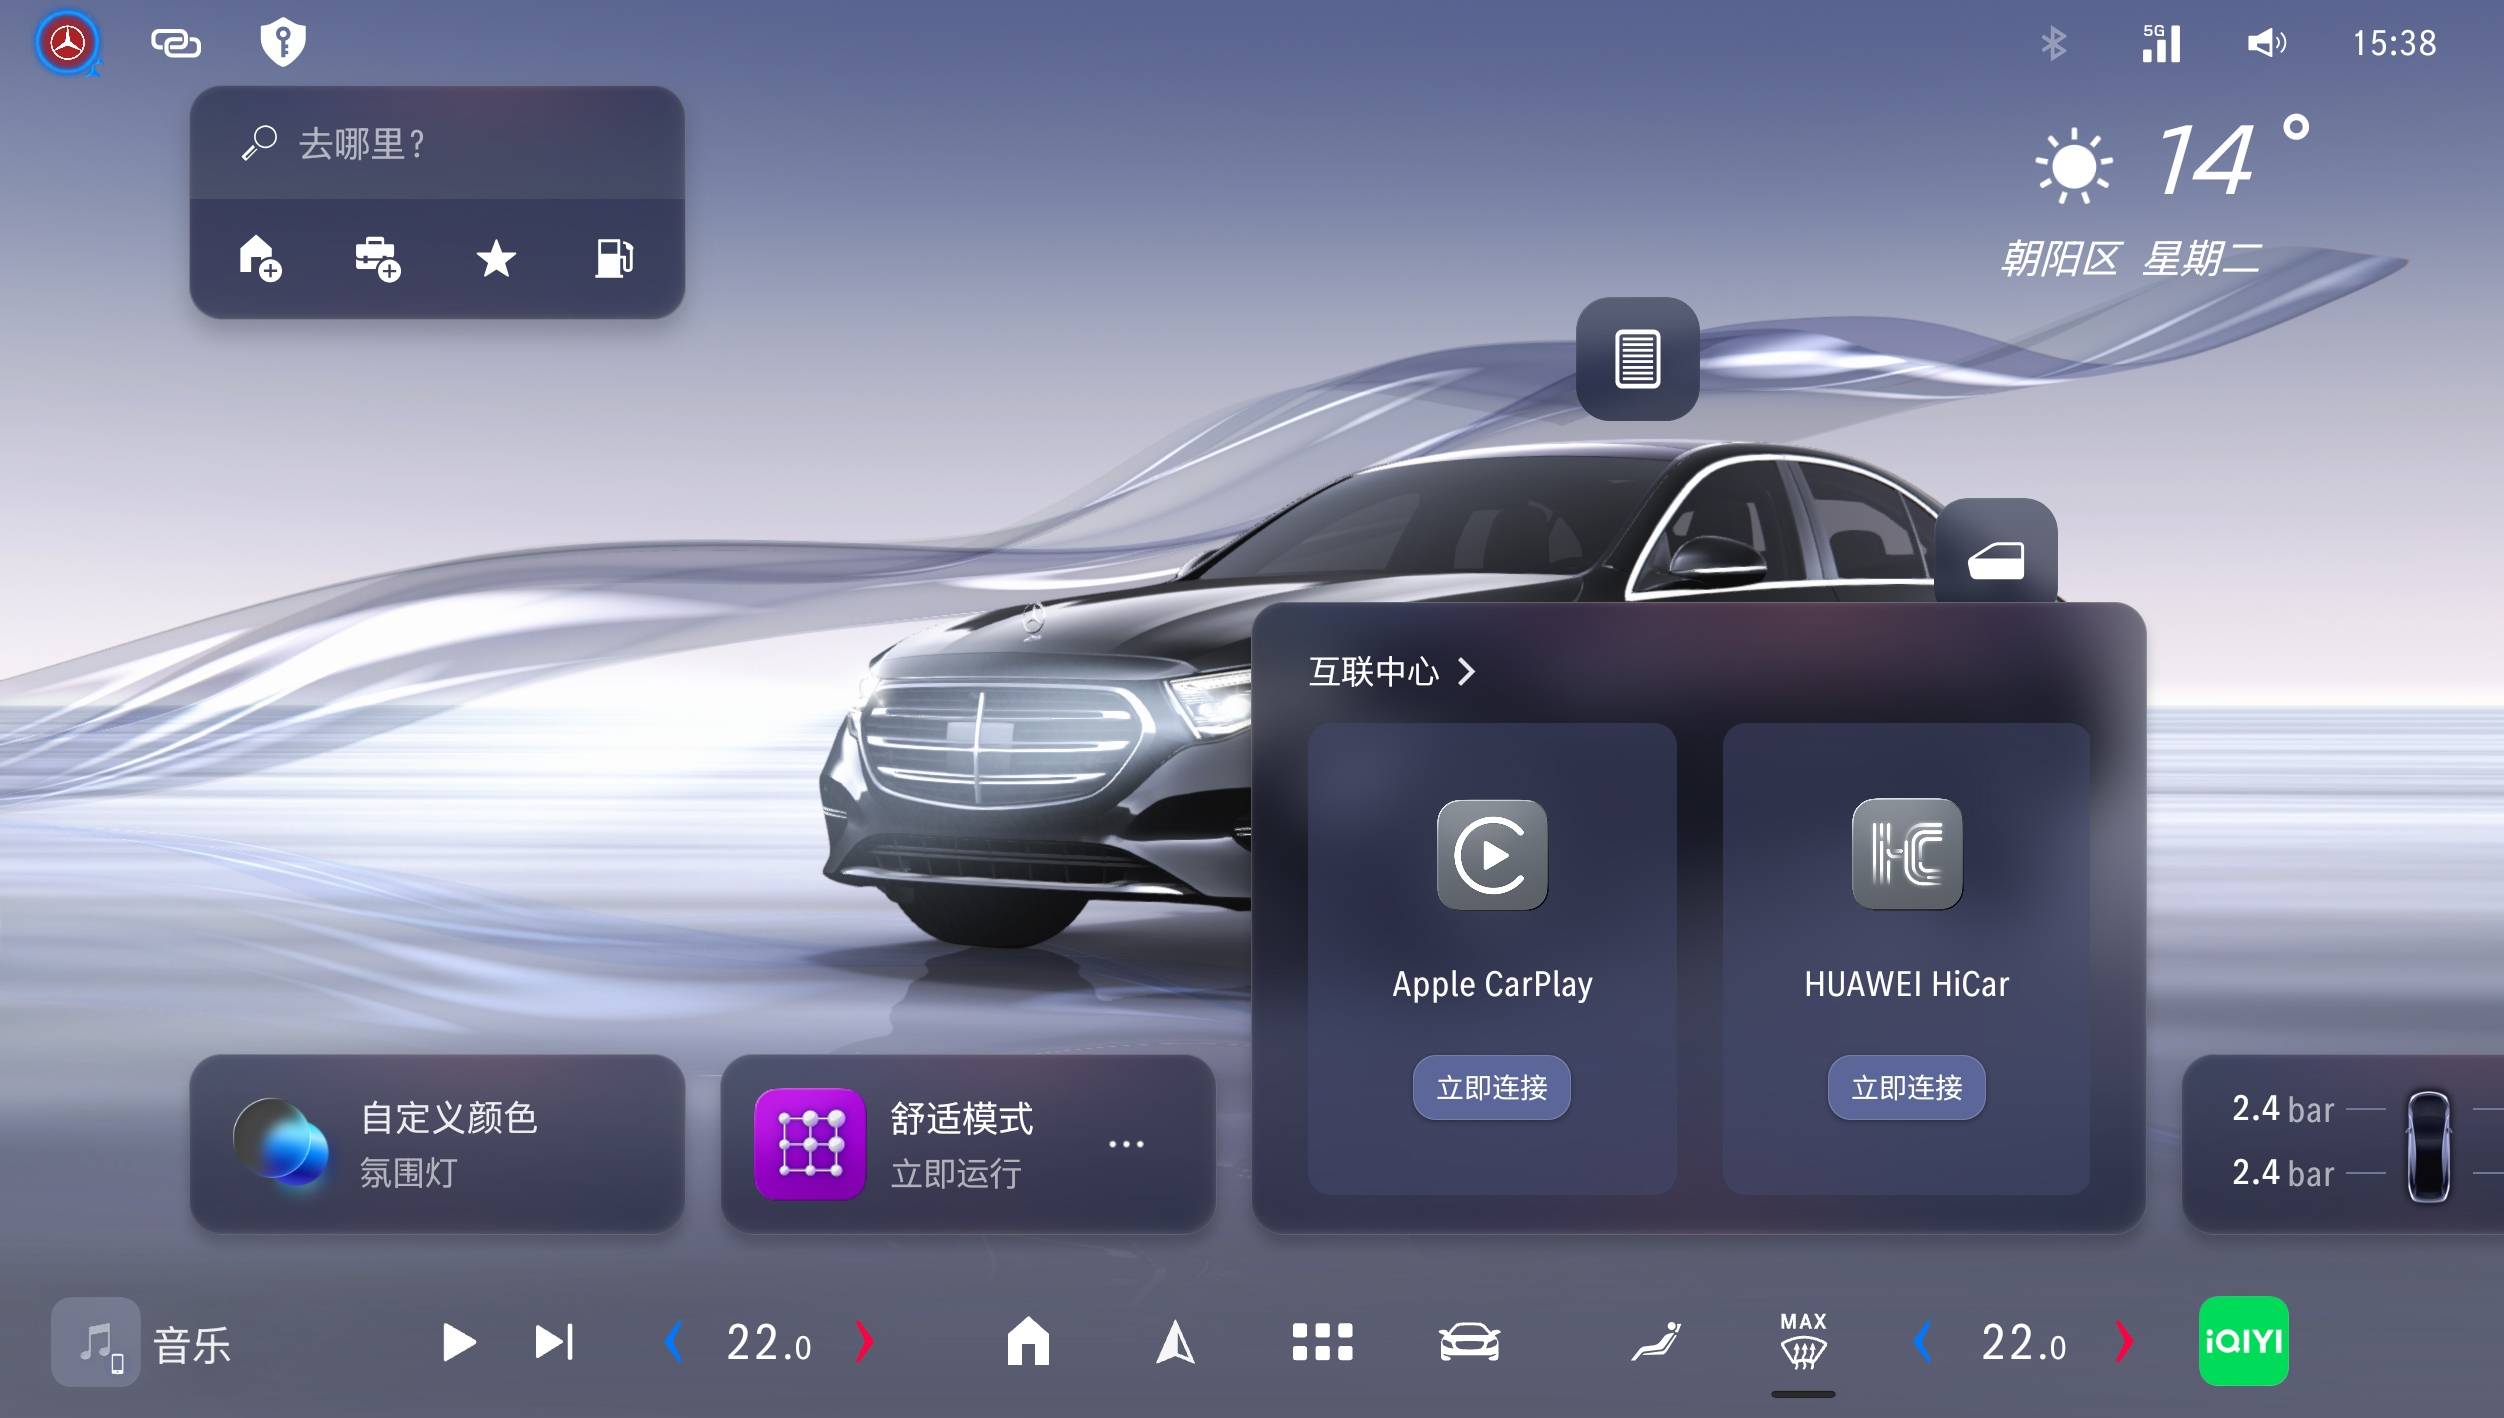
奔驰这次还加强了对于华为手机的支持,保留原有的苹果 CarPlay 的同时引入了华为 HiCar,方向盘上的按键甚至可以和小艺助手直接联动。
如果把视线放宽到全球市场,海外的标轴版 E 级依然沿用原来的车机,运行在西方的生态框架下——在中国市场,这显然是行不通的。
英国汽车媒体《Autocar》资深撰稿人 Greg Kable 在谈到跨国车企转型时曾写道,
中国市场高度依赖本土软件生态,欧洲总部远程敲定的智能化方案已经跟不上节奏了,把权限交给中国团队,才是唯一的出路。
在过去很长一段时间里,传统豪华品牌的车机总给人一种滞后感,说实话这辆新 E 级也是如此,毕竟在屏幕中间整一个 3D 车模已经是上一个版本的解法了。
不过,将底层大模型换成豆包、互联协议接进华为生态等改进,都是值得肯定的,很大程度上把最影响心情的那一块体验,拉到了主流水平线上。
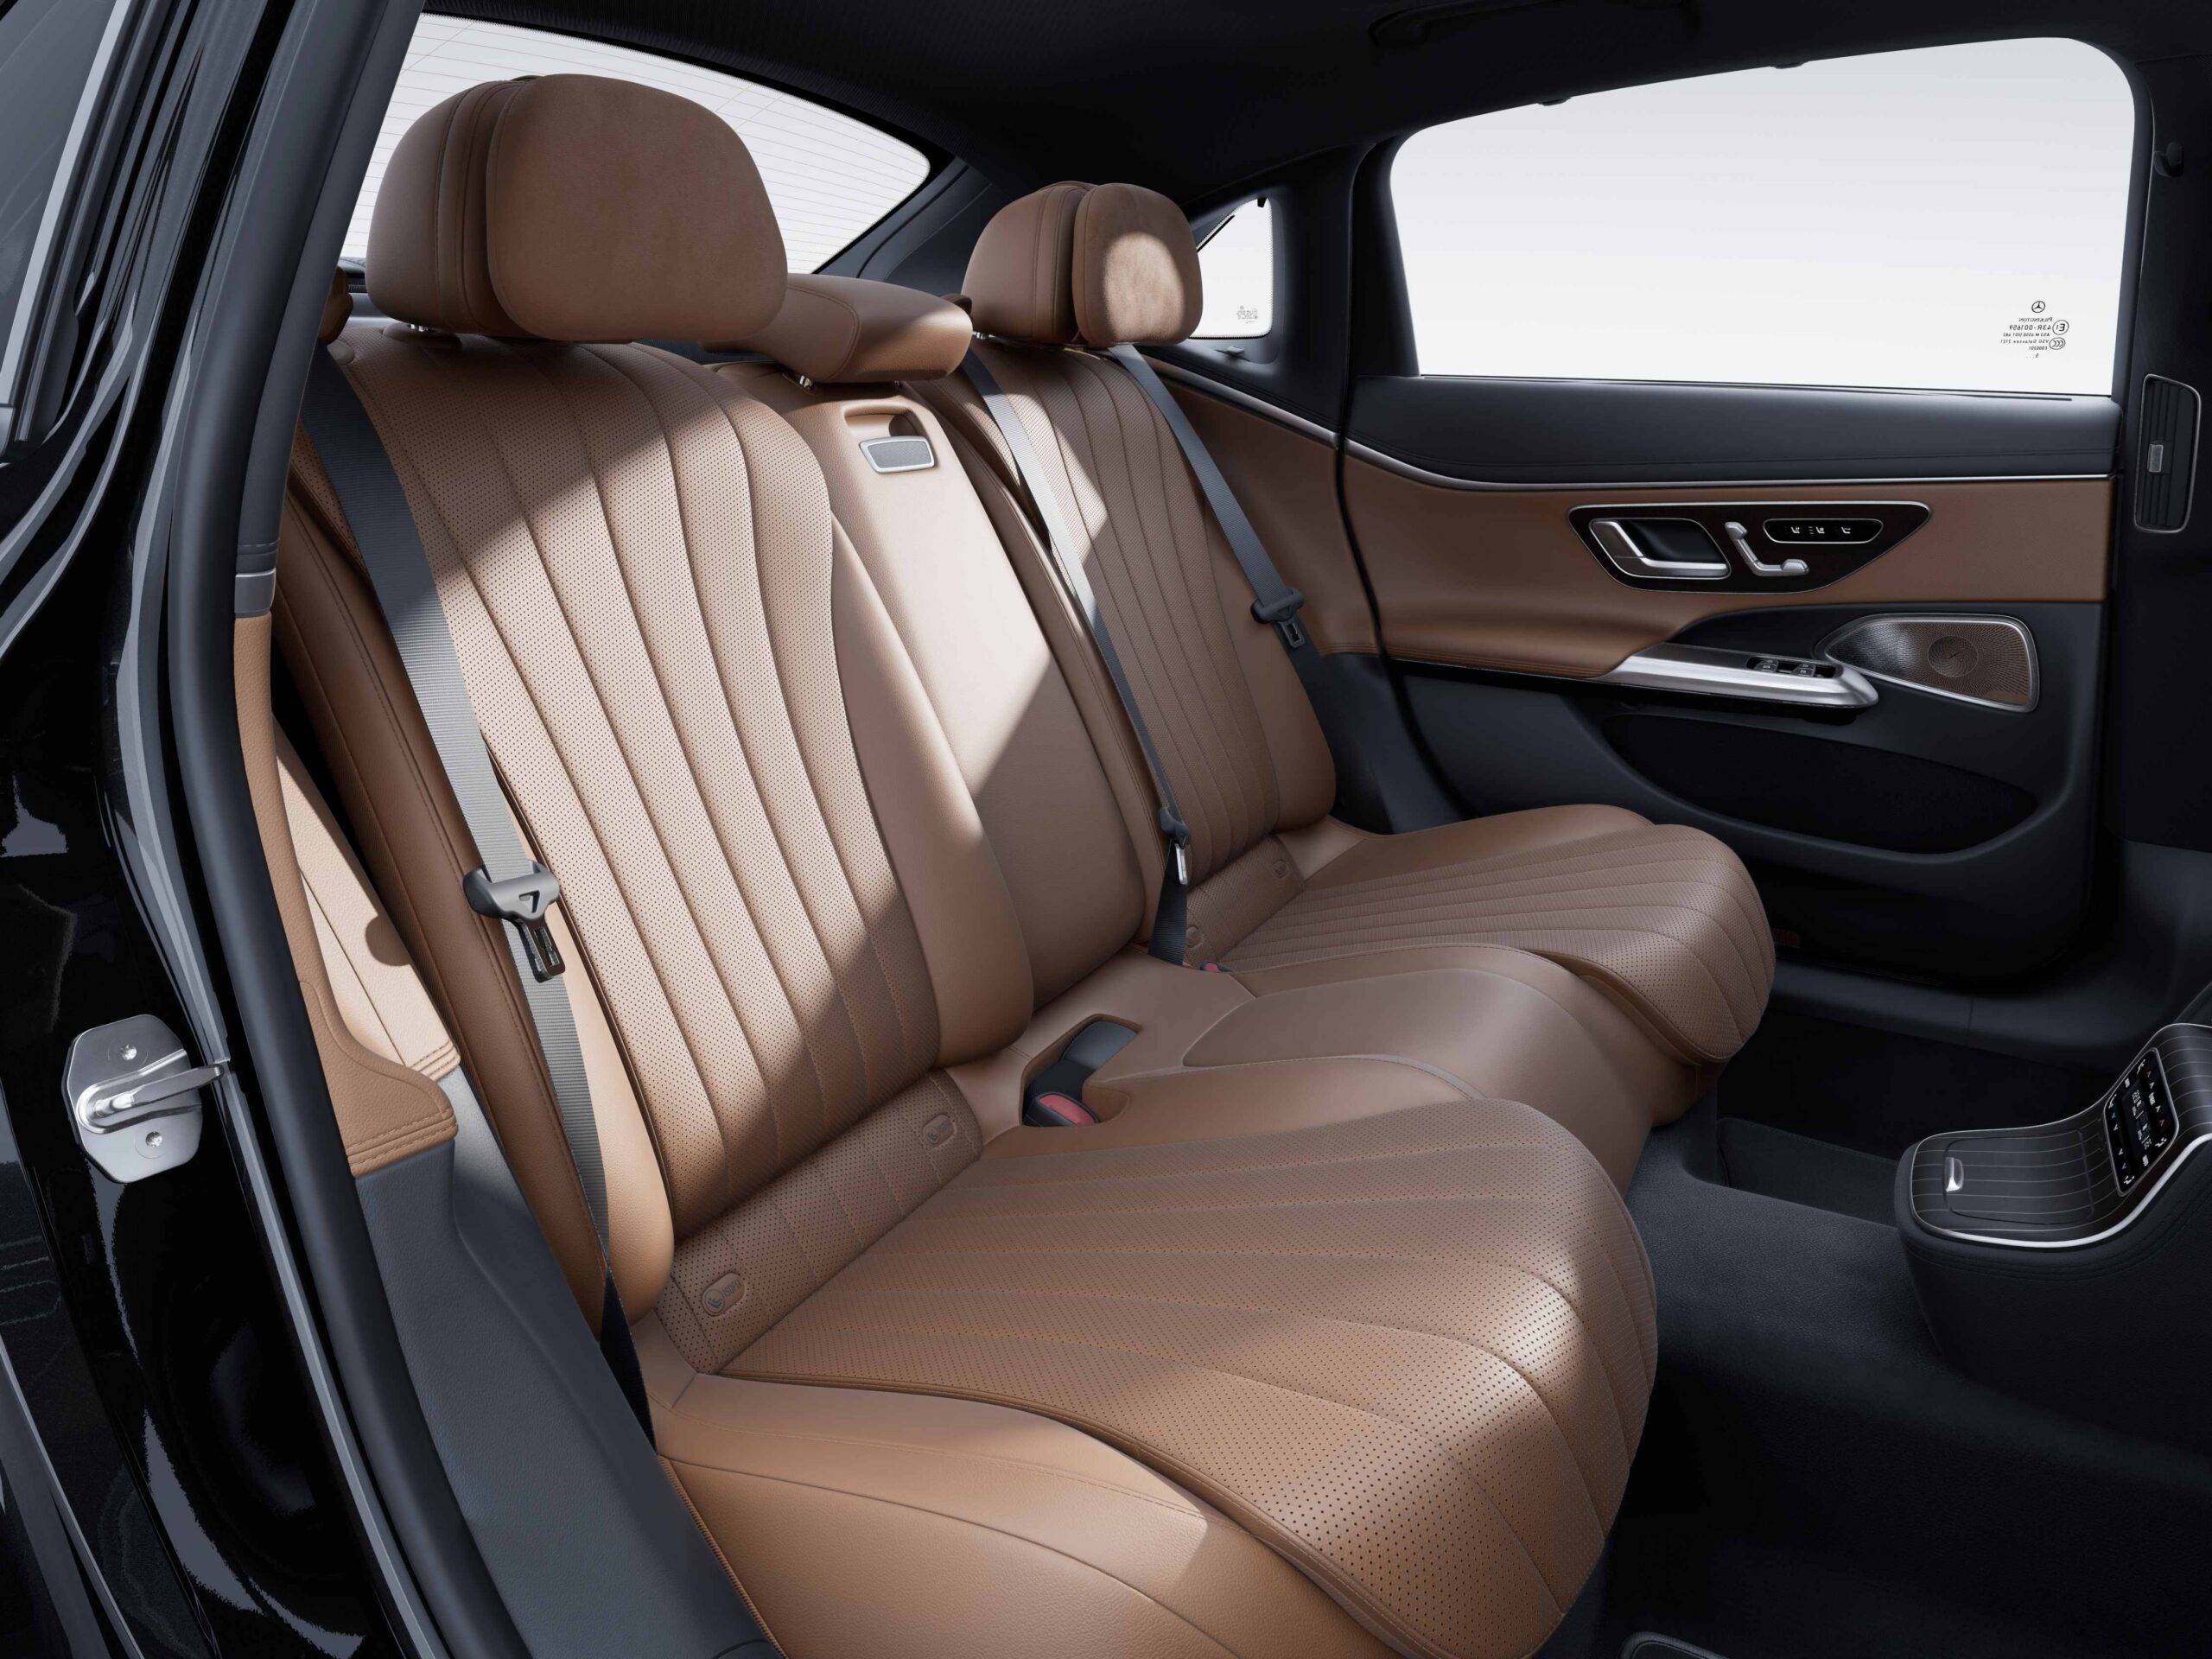
回到 40 万元到 50 万元的行政级市场,各大品牌都在高端产品上发力,把后排配置卷到了前所未有的高度。但 E 级的护城河,依然稳稳握在自己手里。
比如 60.76% 的黄金轴长比、长轴距带来的行政级腿部空间、调校扎实的底盘机械素质,还有多年积累的品牌声誉和社交属性。
以前不少用户在选车时都会犹豫,一边迷恋三叉星徽的气场和行驶质感,一边又要忍受不太好用的车机。
如今车机这块短板补上之后,天平大概又会发生微妙的倾斜。
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
苹果的一切都在变贵,全怪 AI
今天,苹果发布了 2026 财年第四财季及全财年业绩。这也是约翰·特努斯(John Ternus)接替库克出任 CEO 后的第一份成绩单。
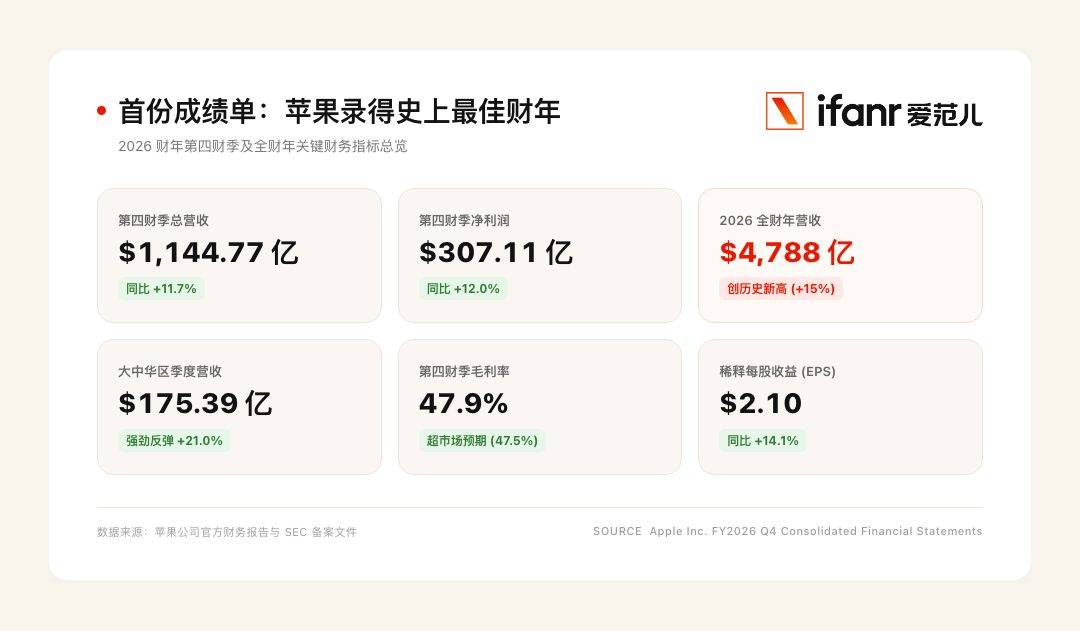
从账面数字来看,表现可以说是相当生猛,直接录得了苹果史上最佳财年。
单季营收 1144.77 亿美元,同比增长 12%;净利润 307.11 亿美元,同比增长 12%。全财年总营收更是达到了创纪录的 4788 亿美元。
就连连续承压的大中华区,也凭借着秋季新机的换机潮,单季营收逆势增长了 21%。
但在随后的财报电话会上,画风却突然一变。
新官上任的特努斯和管理层,在会上被反复追问的不只是漂亮的销售纪录,而是「成本失控」、「内存涨价」以及「产能受限」。
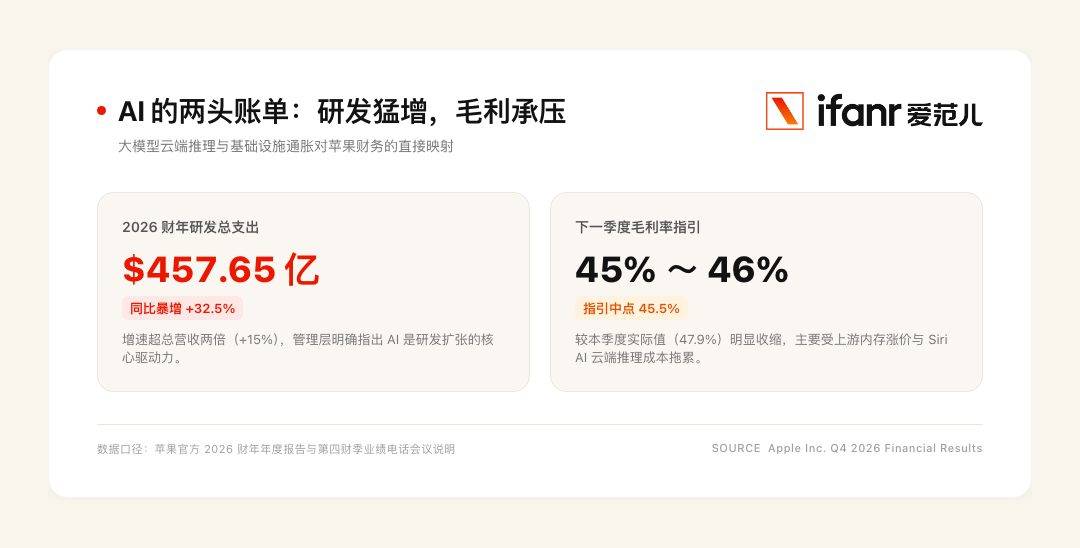
赶在双十一与年底大促的节骨眼上,苹果给出的利润预期却略显保守:下季度毛利率指引回落至 45%~46%,远低于本季度的 47.9%。
面对分析师对成本飙升与硬件定价的追问,特努斯并没有回避:
这种内存价格是我们前所未见的,它确实给我们的硬件定价带来了直接压力。但我们在定价时始终专注于打造最好的产品并交付价值,分期和换购计划正在成为支撑购买力的关键因素。
每天 25 亿次 Siri,苹果想让用户自己买单
过去很长一段时间,苹果靠着两条腿走路,赚钱赚得非常舒服:一方面靠硬件赚取丰厚的溢价毛利,另一方面依靠 Apple Music、Apple TV+、iCloud+ 和打包的 Apple One,持续沉淀高粘性的订阅收入。
至于那些内置在系统里的基础功能——无论是每天呼出多少次 Siri 设闹钟,还是在相册里分类照片,在绝大多数人的习惯里,它们都理所当然地属于一次性买断的体验,用得再多也不会产生额外的开销。
但 Siri AI 彻底改变了这一切。
特努斯在电话会上透露,如今 Siri 每天需要处理超过 25 亿次用户请求。
端侧小模型解决不了的跨应用调度、长文本重写和复杂推理,全都需要依赖苹果的 Private Cloud Compute(私有云计算集群)。
用户每叫一次 Siri 整理会议纪要、生成图片或调取日程,云端服务器就要烧真金白银的 Token 与电费。
而这笔过去不存在的「运行维护税」,正以惊人的速度挤压苹果的利润空间。
财报显示,苹果 2026 财年的研发支出飙升至 457.65 亿美元,同比暴涨 32.5%,增速是总营收的两倍以上。
CFO 帕雷克在回答分析师时直言:研发费用的激增,核心就是被大模型云端基础设施和推理算力支出硬生生推高的。
面对每天数十亿次调用带来的天价账单,强如手握千亿现金的苹果,也感受到了沉重的肉痛感。
因此,苹果不得不把这一笔开销转嫁到消费者头上,特努斯在财报电话会上也毫不掩饰这一点:
今天的 iCloud+ 已经不再局限于云存储。我们在探索将更多进阶 AI 能力融入服务订阅,包括设置合理的服务器调用阈值并提供扩容方案,这会为服务业务打开全新的增长空间。
之后咱在 iPhone 上调用进阶 AI 能力时,屏幕上很可能就会弹出一条提示:今日免费额度已用尽,请升级你的 iCloud+ 套餐。
苹果的一切都在变贵,全怪 AI
除了云端源源不断产生的 Token 费用,AI 浪潮对普通消费者最直接的冲击,是硬件全线变贵。
还是那个我们都太熟悉的叙事:全球 AI 数据中心对 HBM 和高规格 DRAM 的疯狂扫货,重创了消费级芯片的供应链。
特努斯在会上坦言,这一轮内存成本的涨幅是「前所未有」的。为了锁定供应,苹果单季度的资本与制造采购支出就高达 330 亿美元。
这笔沉重的上游硬件成本,很快就以标签的形式,贴到了每一个消费者的面前。在最新的产品线里,苹果几乎对所有走量的基础款动了刀:
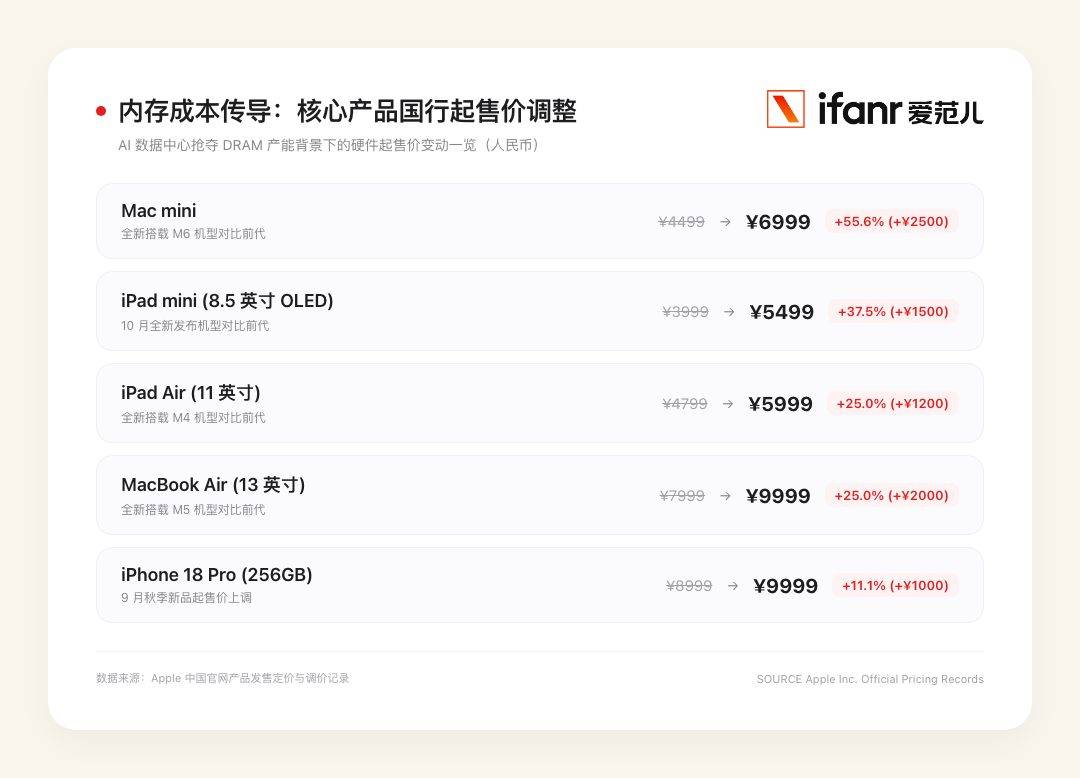
Mac mini 起售价从 4499 元一路飙涨至 6999 元;iPad Air 涨至 5999 元;MacBook Air 与 iPhone 18 Pro 的起步门槛更是双双推高至万元关口(9999 元)。
光是涨价还不够,苹果甚至在新品推出的节奏上动了心思——便宜好卖的基础款延后发布,只拿最贵的新品出来卖。
今年 9 月秋季发布会,苹果打破了近二十年的惯例:走量的 iPhone 18 标准版被延期,整个下半年只留下了高价的 Pro 系列与首款折叠屏 iPhone Duo。
高盛分析师在电话会上专门追问了标准版延期的原因,特努斯对此语焉不详,但商业逻辑早已不言自明——在元器件暴涨的年份,苹果必须全力推销均价更高、利润更厚的产品。
我们很高兴在 9 月推出了 iPhone Duo 和 18 Pro,同时还有 iPhone 17、iPhone Air 继续充实整个阵容。当然,我们从不对未来的产品路线图发表评论。
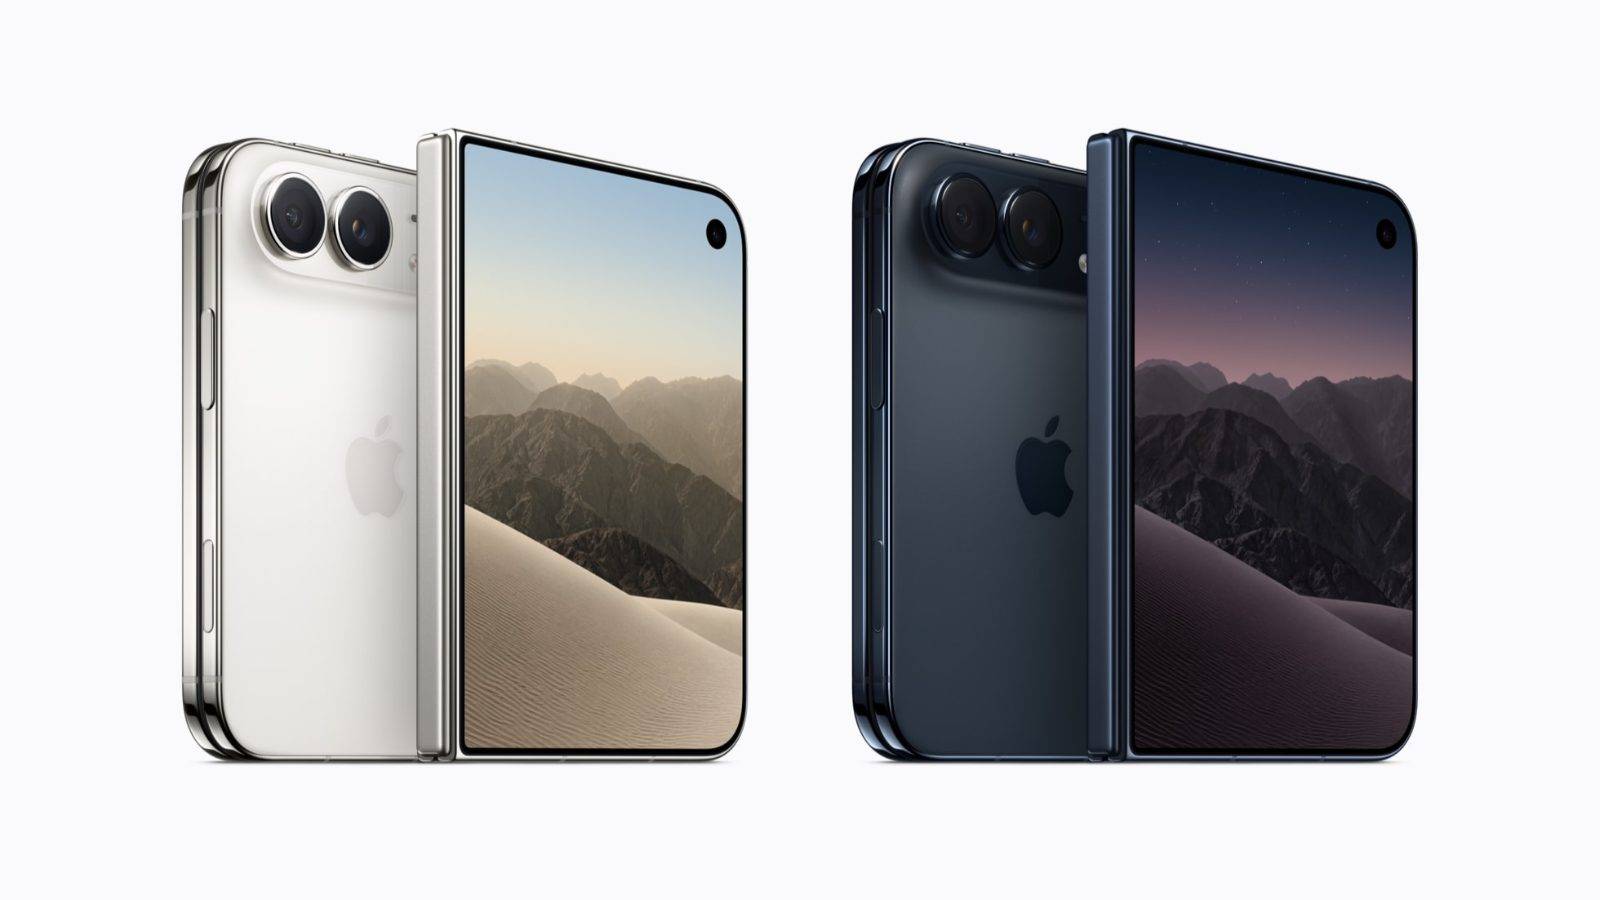
然而,售价高达 21999 元的 iPhone Duo,一上市就遭遇了品控与产能的双重拷问。
首批新机发售后不久,网络上便陆续出现了消费者关于内屏破裂、出现黑线绿线的投诉。
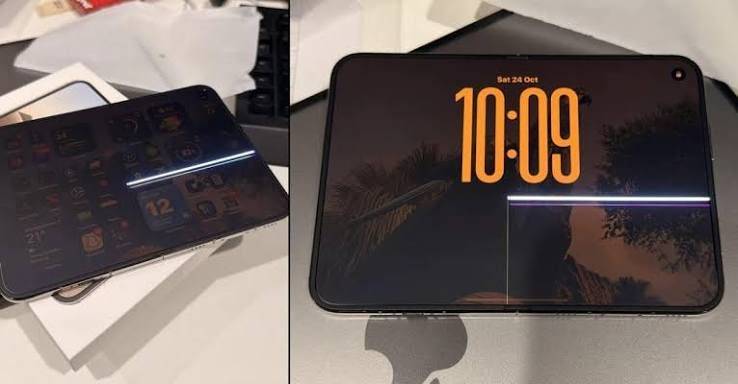
在接受路透社专访时,特努斯不得不亲自出面灭火。
只有极小比例(a very small percentage)的 iPhone Duo 遇到了显示故障,苹果正在全力为受影响用户免费更换整机。
与裂屏同样棘手的,是折叠内屏与钛合金复杂铰链的产能爬坡困境。
特努斯在财报会上直言,目前 iPhone Duo 的供货「处于极度受限(constrained)状态,并且在现阶段完全无法预测供需何时能够平衡」。
同样的超高端策略还发生在 Mac 上:苹果首次推出了带触控功能的 MacBook Pro(PROLED XDR 显示屏),起步价直接定在了 22999 元。
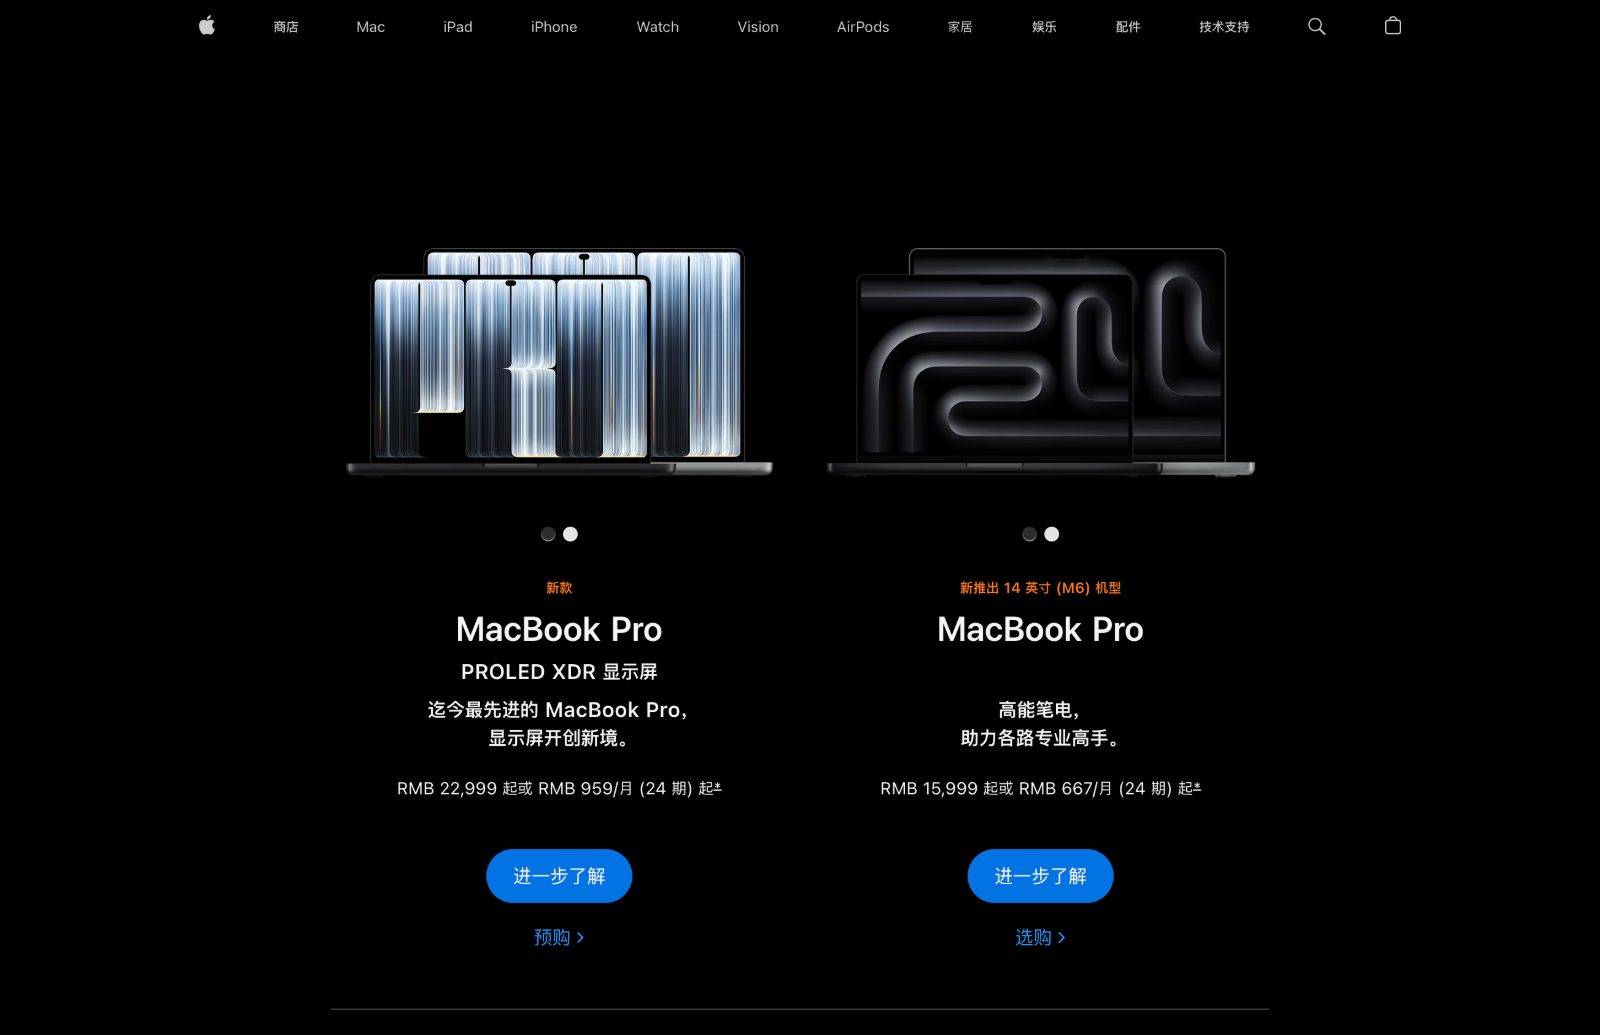
面对硬件涨价带来的超高定价,普通消费者的钱包正承受着空前的挤压。
当分析师在电话会上问及消费者是否还能承受高昂售价时,特努斯给出的解药显得颇为无奈:
苹果将全力押注年年焕新(Apple Upgrade Program)和 24 期免息分期,试图用「每天一杯咖啡钱」的话术,来对冲硬件涨价带来的剧烈痛感。
苹果不生产 Token,只是大模型的搬运工
在消费级硬件全线承压、成本节节攀升的阴云下,这份财报里却有一个业务实现了令人意外的大爆发——Mac。
第四财季,Mac 业务单季营收达到 108 亿美元,同比大幅增长 24%,增速远超其他所有硬件品类。
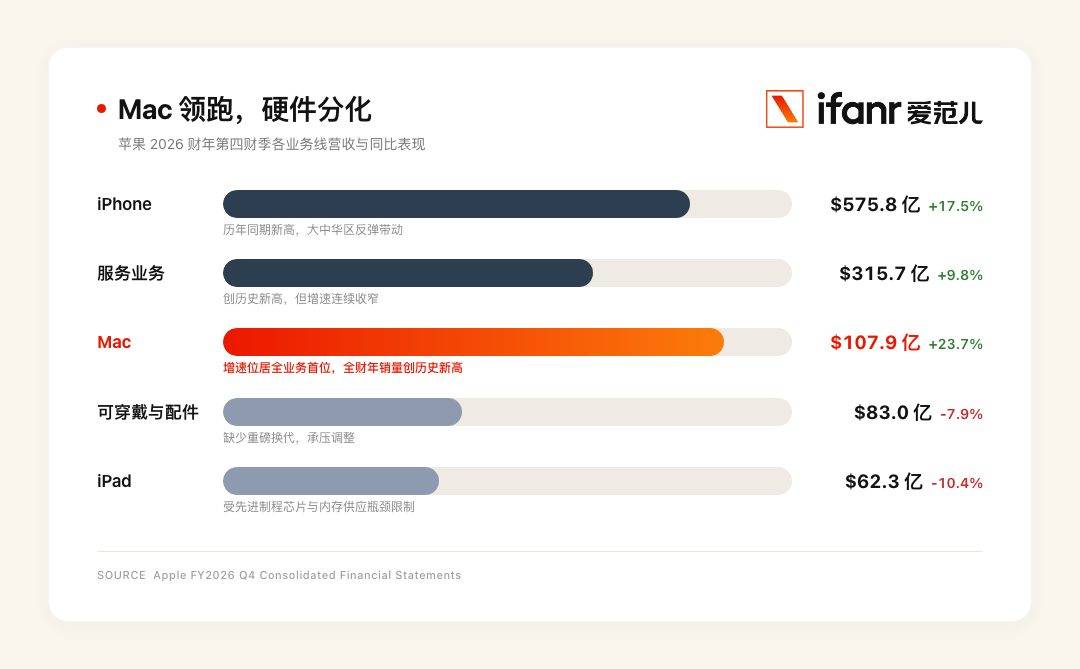
支撑起这 108 亿美元大盘的,明面上依然是走量的 MacBook Air、新推出的 MacBook Neo 以及开学季带来的常规换机潮。
但在常规的消费底盘之外,Mac 还在悄然迎来另一股意料之外的新需求。
据路透社与 The Information 报道,随着大模型落地成本失控,租用微软、亚马逊或英伟达云端算力的高昂 Token 账单,正逼得不少中小企业与开发者将目光转向本地——
而配备超高带宽统一内存的高配 Mac,正在成为他们逃离云端算力通胀的避难所。
Apple Silicon 芯片天生具备的高带宽统一内存架构,让一台配置 128GB 甚至 192GB 统一内存的 Mac Studio 或 Mac mini,售价只要数万元人民币,就能直接在本地离线跑起 70B 规模的开源大模型。
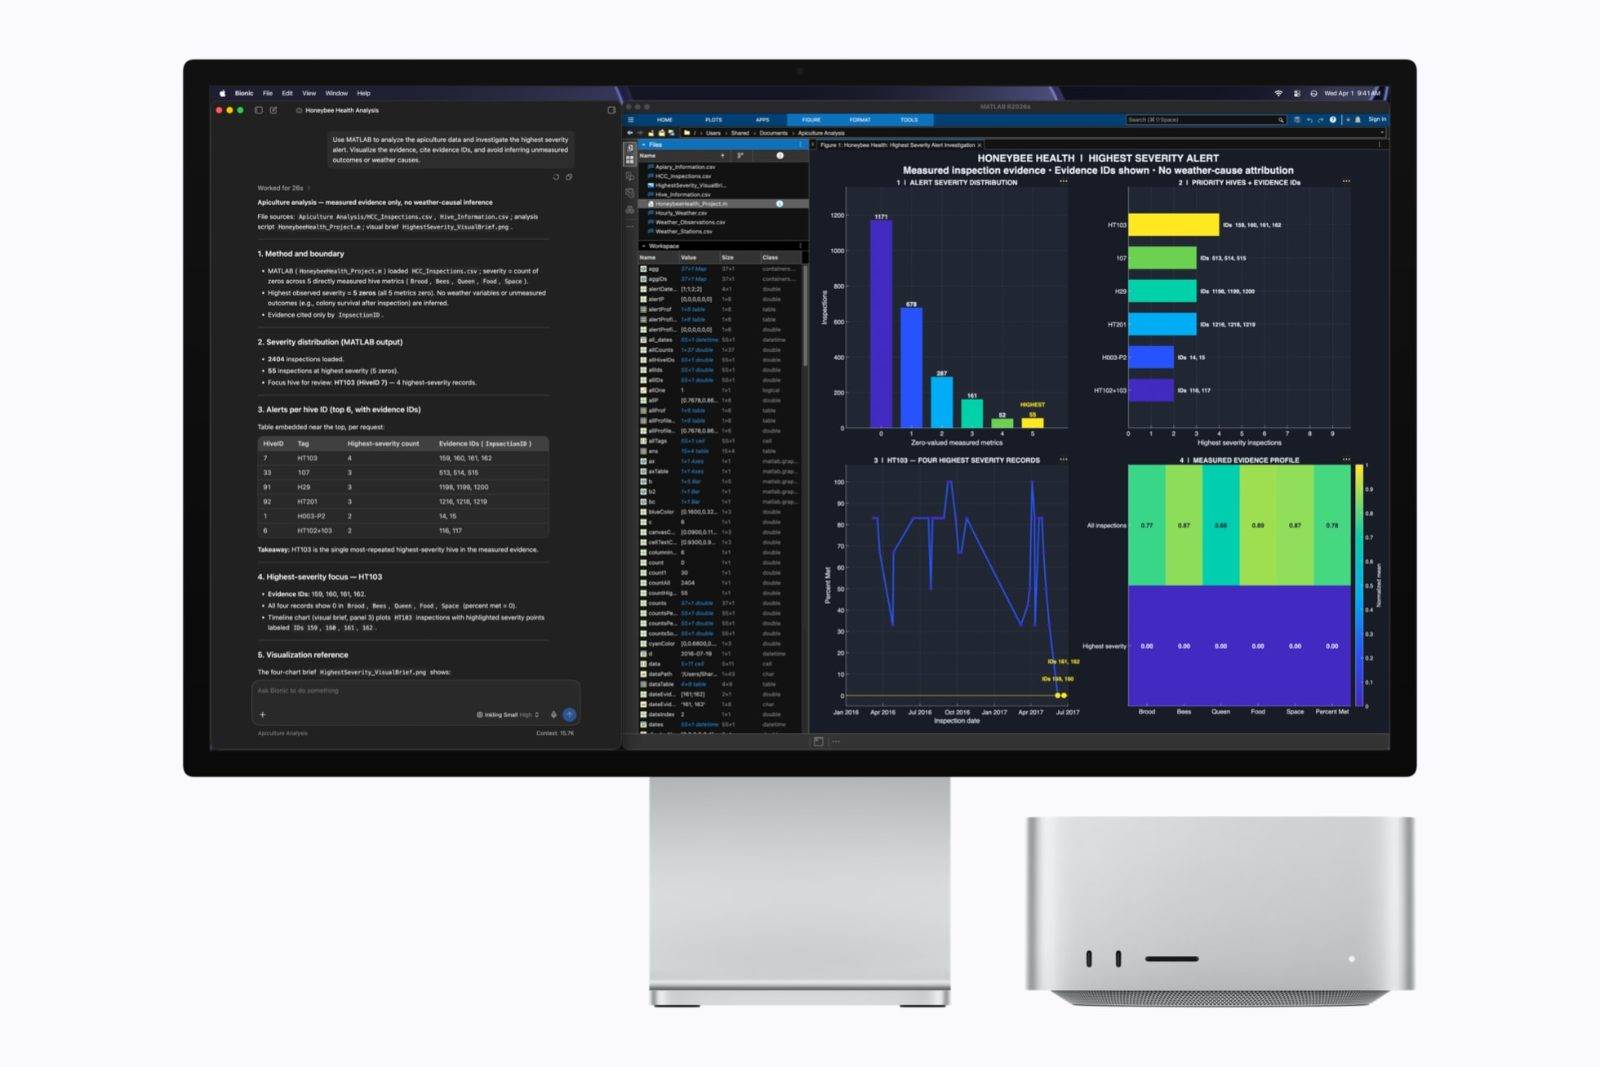
这不仅省去了按量计费的云端 Token 费用,也消除了企业对数据外泄的顾虑。
特努斯在电话会上也印证了这一势头,他提到 Mac 正迎来历史上最好的企业采购周期,甚至在菲律宾斩获了 17 万台 MacBook Neo 的批量教育与政企大单。
特努斯执掌苹果交出的第一份成绩单,与其说是在庆祝「史上最佳财年」,倒不如说是苹果面对失控的算力账单时,一次务实的商业摊牌。
当 Token 贵到连苹果都觉得肉痛时,那个免费造梦的 AI 时代叙事,就已经正式翻篇了。
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
Query Entity-Oriented Graph Neural Networks for Knowledge Graph Completion
Deep Neural Sheaf Diffusion
What Carries Architectural Signal? A Code-to-Architecture Mapping Study
From WSIs to Bulk, Spatial and Single-Cell Transcriptomics via Multi-Scale Graph Neural Networks
When Links Mislead: Label-Free Structural Polarity for Zero-Shot Classification of Web Pages